

XTuner:InternLM 团队开源的高效大模型微调与超大规模 MoE 训练引擎|部署与使用全指南
项目仓库: https://github.com/InternLM/xtuner
开源协议:Apache 2.0 · 交付形态:PyPI 包 xtuner ·
定位:高效 LLM 微调工具链,V1 版本面向超大规模 MoE 训练 ·
支持模型:Intern S1 / Intern VL / Qwen3 Dense & MoE / GPT OSS /
DeepSeek V3 / Kimi K2 · 硬件:NVIDIA GPU(FP8 / BF16)与华为 Ascend
NPU(BF16) · 模型分发:Hugging
Face、ModelScope、OpenXLab、WiseModel
官方维护状态说明:XTuner 由上海人工智能实验室 InternLM 团队维护;2025 年 9 月发布 XTuner V1,定位为"面向超大规模 MoE 模型的下一代训练引擎"。本文信息取自官方 README;具体微调配置与命令以官方文档与仓库
examples/目录为准。
1 项目简介
XTuner 是 InternLM 团队开源的大模型微调工具链,早期以低显存微调 QVQ、Llama、InternLM 等 Dense 模型著称;V1 版本重新定位为面向超大规模 MoE 模型的训练引擎,支持从 200B 到 1T 参数的 MoE 预训练、指令微调与强化学习。其核心思路是通过 Dropless 训练策略减少专家并行维度,配合显存优化与 DeepSpeed Ulysses 序列并行,在不复杂扩展的前提下训练超大 MoE。
非官方 / 第三方边界声明:XTuner 代码 Apache 2.0;所训练的上游模型(InternLM、Qwen、DeepSeek、GPT OSS、Kimi 等)按各自许可使用。本文不提供训练数据,数据准备需自行合规。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | XTuner(PyPI 包 xtuner) |
| 仓库地址 | github.com/InternLM/xtuner |
| 项目定位 | 高效 LLM 微调工具链;V1 面向超大规模 MoE 训练 |
| 开源协议 | Apache 2.0 |
| 最新版本 | V1(2025/09 发布) |
| 支持模型 | Intern S1、Intern VL、Qwen3 Dense / MoE、GPT OSS、DeepSeek V3、Kimi K2 |
| 硬件支持 | NVIDIA GPU(FP8 / BF16);Ascend NPU(BF16) |
| 算法能力 | 多模态预训练、多模态 SFT、GRPO;规划中 MPO / DAPO / 多轮 Agentic RL |
| 推理集成 | LMDeploy 已对接;vLLM / SGLang 规划中 |
| 模型分发 | Hugging Face、ModelScope、OpenXLab、WiseModel |
1.2 适用场景
- 希望用单卡或少量 GPU 对 7B–70B Dense 模型做指令微调、LoRA / QLoRA 实验。
- 团队需要在千卡集群上训练 200B–1T 规模 MoE 模型,且希望减少专家并行复杂度。
- 需要做多模态预训练 / SFT(视觉语言模型),或基于 GRPO 做强化学习。
- 希望在 NVIDIA GPU 与华为 Ascend NPU 之间复用同一套训练配置。
1.3 能力边界(官方口径)
- V1 重点面向 MoE 训练;Dense 模型微调能力延续早期版本,详见仓库
examples/。 - GPT OSS、DeepSeek V3、Kimi K2 的 Ascend NPU 支持仍在开发中(🚧)。
- 推理引擎目前官方对接 LMDeploy;vLLM / SGLang 为路线图项。
- 强化学习算法目前已实现 GRPO,MPO / DAPO / 多轮 Agentic RL 为 Coming Soon。
2 功能特性
2.1 Dropless 超大规模 MoE 训练
- 可扩展但不复杂:200B 规模 MoE 无需专家并行即可训练;600B 仅需节点内专家并行。
- 更优并行策略:相比传统 3D 并行,专家并行维度更小,Dropless 训练更高效。
- 最大 1T 参数:支持 MoE 训练到 1T 参数规模。
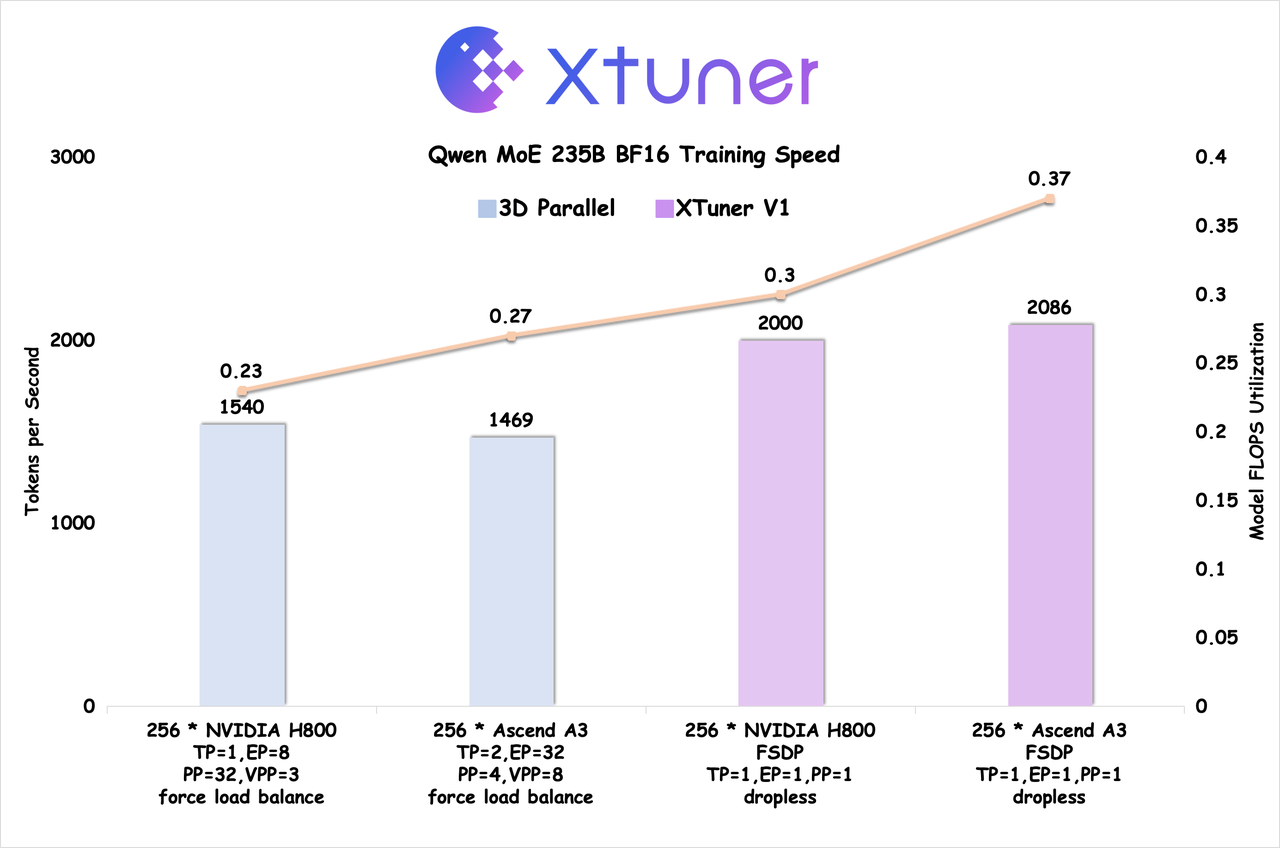
- 性能突破:在 200B 以上 MoE 规模上,FSDP 训练吞吐首次超过传统 3D 并行方案。
2.2 长序列支持
- 200B MoE 在 64k 序列长度下无需序列并行即可训练(通过显存优化)。
- 完整支持 DeepSpeed Ulysses 序列并行,最大序列长度可线性扩展。
- 长序列训练中即使专家负载不均也能保持稳定。
2.3 硬件覆盖
- NVIDIA GPU:FP8 与 BF16 双精度支持。
- 华为 Ascend:BF16 支持;官方称在 Ascend A3 Supernode 上训练效率超过 NVIDIA H800。
2.4 算法路线图
| 算法 | 状态 |
|---|---|
| 多模态预训练 | ✅ 已实现 |
| 多模态监督微调 | ✅ 已实现 |
| GRPO(Group Relative Policy Optimization) | ✅ 已实现 |
| MPO(Mixed Preference Optimization) | 🔄 规划中 |
| DAPO(Dynamic Sampling Policy Optimization) | 🔄 规划中 |
| 多轮 Agentic RL | 🔄 规划中 |
2.5 数据准备与推理集成
3 官方界面预览
图 1 为官方 README 中展示的训练速度基准对比图;XTuner 为命令行训练工具,不提供图形界面。
4 官方跳转链接汇总
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库主页 | github.com/InternLM/xtuner | 源码、examples、README |
| PyPI | pypi.org/project/xtuner | 安装包 |
| Hugging Face | huggingface.co/xtuner | XTuner 发布的模型 |
| ModelScope | modelscope.cn/organization/xtuner | 国内模型分发 |
| OpenXLab | openxlab.org.cn/usercenter/xtuner | 上海AI实验室模型平台 |
| WiseModel | wisemodel.cn/organization/xtuner | 国内模型平台 |
| LMDeploy | github.com/InternLM/lmdeploy | 官方推理引擎 |
| GraphGen | github.com/open-sciencelab/GraphGen | 合成数据生成 |
| 中文 README | README_zh-CN.md | 中文版说明 |
| Discord | discord.gg/xa29JuW87d | 社区 |
5 前置要求与服务器配置
5.1 软件前提
- Linux(推荐 Ubuntu 20.04/22.04)。
- Python 3.10+。
- NVIDIA GPU + CUDA(FP8 需 Hopper 架构 H100 / H200 及以上;BF16 需 Ampere 及以上)。
- PyTorch(按官方文档推荐版本)。
- Ascend NPU 需配套 CANN 工具链与 Ascend PyTorch Adapter。
5.2 硬件建议(按场景)
| 场景 | 推荐配置 |
|---|---|
| Dense 模型 LoRA / QLoRA 微调(7B–13B) | 单张 24GB 显存 GPU |
| Dense 模型全参微调(7B–70B) | 多卡 A100 / H100 80GB |
| 200B MoE 训练 | 多节点 GPU 集群 |
| 600B–1T MoE 训练 | 千卡级集群(NVL72 / Ascend A3 Supernode) |
5.3 端口说明
| 端口 | 服务 | 用途 |
|---|---|---|
| 无 | XTuner 训练进程 | 训练任务本身不监听 Web 端口;配合 LMDeploy 推理时另起服务 |
6 方式一:pip 安装与微调
6.1 安装
pip install xtuner或从源码安装:
git clone https://github.com/InternLM/xtuner.git
cd xtuner
pip install -e .
6.2 准备数据与配置
XTuner 通过 Python
配置文件描述数据集、模型、并行策略与训练超参。具体配置示例见仓库
examples/ 目录(按模型分目录组织)。
# 查看可用配置(示例)
ls examples/
6.3 启动训练
XTuner 提供命令行工具(具体子命令以安装后 xtuner help
与官方文档为准)。典型流程为:
# 单卡 / 多卡训练(示例命令,具体以仓库 examples 为准)
xtuner train <config.py> --work-dir <output_dir>

# 多卡用 torchrun 或 deepspeed 启动
# torchrun --nproc_per_node=8 xtuner train <config.py> ...
本文未臆造具体子命令;安装后执行
xtuner --help与参考examples/内 README 获取最新命令。
7 方式二:源码与 LMDeploy 推理部署
7.1 训练后导出
微调完成后,将权重导出为 LMDeploy 支持的格式,再用 LMDeploy 启动推理服务。
7.2 LMDeploy 推理
# 安装 LMDeploy(见官方仓库)
pip install lmdeploy

# 启动 OpenAI 兼容服务(示例)
lmdeploy serve api_server <model_path>
8 配置项说明
XTuner 配置文件为 Python 模块,核心字段按官方文档与 examples 为准,常见维度包括:
| 维度 | 说明 |
|---|---|
model |
基座模型路径与加载参数 |
dataset |
训练数据路径、prompt 模板、pack 策略 |
parallel |
TP / PP / EP / Ulysses 序列并行度 |
precision |
FP8 / BF16 |
training |
lr、epochs、batch size、warmup、scheduler |
algorithm |
SFT / GRPO 等算法选择 |
完整字段以仓库
examples/与官方文档为准。
9 常用运维命令
# 查看 xtuner 版本与帮助
xtuner --version
xtuner --help

# 查看 GPU 占用
nvidia-smi

# 查看训练日志
tail -f <work-dir>/<job>.log

# 停止训练
# Ctrl+C 终止;如多卡可 pkill -f "xtuner train"

# 查看已保存 checkpoint
ls <work-dir>/
10 常见故障排查
- FP8 不支持:FP8 训练需 Hopper 架构(H100 / H200 / B200);Ampere 及以下请改用 BF16。
- Ascend 模型支持不全:GPT OSS、DeepSeek V3、Kimi K2 的 NPU 支持仍在开发中(🚧),请用 GPU 版本。
- OOM 显存不足:减小 batch size、开启梯度累积、使用 LoRA / QLoRA;长序列训练可启用 DeepSpeed Ulysses。
- 数据格式不匹配:参考
examples/内数据预处理脚本,按模型 prompt 模板组织。 - 专家负载不均:官方称长序列训练下 Dropless 策略可保持稳定;如遇不稳,按 README 建议调整并行度。
- 推理部署:训练后权重请走 LMDeploy 对接;vLLM / SGLang 为路线图项,暂不官方支持。
11 风险与合规说明
- 模型许可:XTuner 代码 Apache 2.0,但训练的上游模型(Qwen、DeepSeek、Kimi、GPT OSS 等)按各自许可;商用前须确认。
- 数据合规:微调数据须自行确保来源合法、不侵犯隐私与版权;合成数据请评估质量与偏见。
- 硬件依赖:FP8 训练锁定 NVIDIA Hopper;Ascend 支持仍在迭代。
- 版本演进快:V1 于 2025/09 发布,接口与示例可能快速变化,以官方仓库最新说明为准。
- 本文非官方文档:命令与配置以仓库
examples/与官方文档为准;本文未臆造具体训练子命令。