

OpenCompass:上海 AI 实验室开源的一站式大模型评测平台|部署与使用全指南
项目仓库: https://github.com/open-compass/opencompass
开源协议:Apache 2.0(按仓库 LICENSE) · 交付形态:PyPI 包
opencompass · 定位:覆盖 100+ 数据集的大模型评测工作台 ·
支持模型:DeepSeek、Qwen、GLM、Intern-S、Llama、Mistral、Kimi、MiniMax、OpenAI、Claude、Gemini、豆包、xAI
Grok 等 · 推理后端:HuggingFace、LMDeploy、vLLM、OpenAI 兼容 API ·
官方文档:opencompass.readthedocs.io
官方维护状态说明:OpenCompass 由上海人工智能实验室(OpenCompass 团队)维护,被 Meta AI 在 Llama 官方 "Get Started / Validation" 页面推荐;2026 年持续更新,已集成 VLMEvalKit、AgentCompass、OpenAI Responses API、LiteLLM 网关等。本文命令均取自官方 README。
1 项目简介
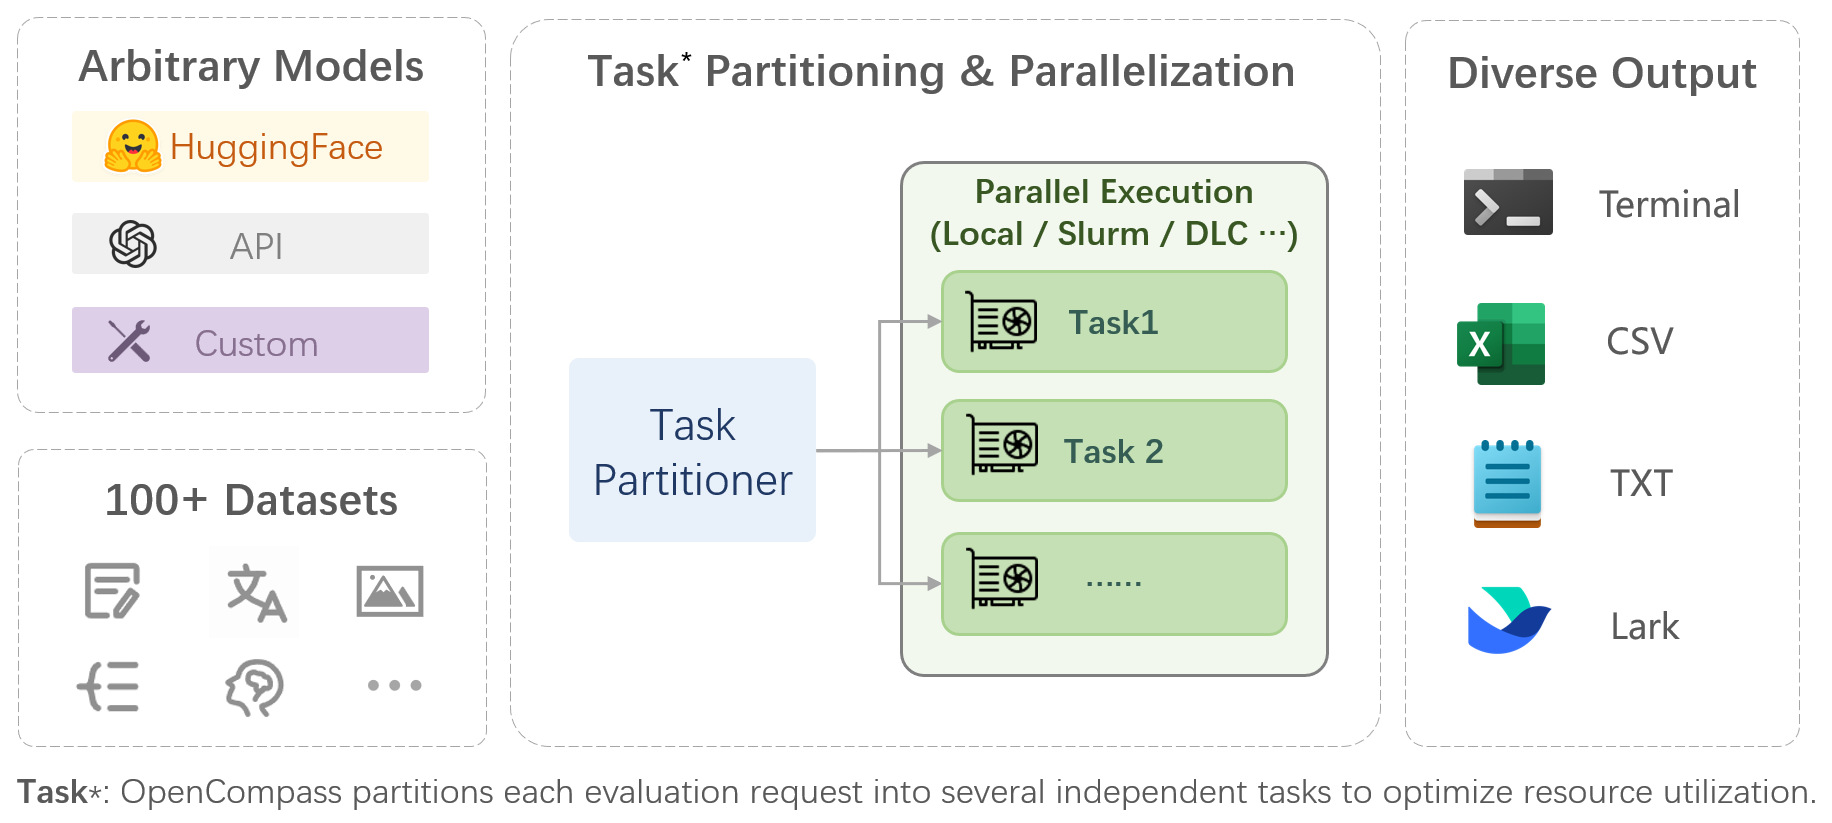
OpenCompass 是一个一站式大模型评测平台,覆盖知识、推理、代码、科学、语言、长上下文、安全等能力维度,集成 100+ 数据集。它提供从数据集与模型配置、推理、评估到结果汇总的完整工作流,支持本地开源模型与 API 模型,推理后端包括 HuggingFace、LMDeploy、vLLM,并可对接 OpenAI 兼容 API。平台支持零样本、少样本、思维链、规则判定与 LLM-as-judge 评估,任务可分区、并发与分布式执行。
非官方 / 第三方边界声明:OpenCompass 代码开源;被测模型权重与 API 服务归各厂商所有,调用 API 产生的费用与数据合规由使用者自行承担。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | OpenCompass(PyPI 包 opencompass) |
| 仓库地址 | github.com/open-compass/opencompass |
| 项目定位 | 大模型一站式评测平台 |
| 开源协议 | Apache 2.0 |
| Python 版本 | 3.12(常规 / full 安装);3.10(需 pyext 跑代码执行数据集) |
| 安装方式 | pip install -U opencompass;或源码
pip install -e . |
| 推理后端 | HuggingFace、LMDeploy、vLLM、API 模型 |
| 评估范式 | zero-shot、few-shot、CoT、规则、LLM-as-judge、CascadeEvaluator |
| 官方文档 | opencompass.readthedocs.io |
| 在线榜单 | rank.opencompass.org.cn |
1.2 适用场景
- 训练 / 微调团队需要在统一基准上对比不同模型或不同 checkpoint 的能力。
- 企业选型时需要在自有数据集上跑开源模型与商业 API 的横向对比。
- 研究者需要复现论文中的基准结果,并扩展自定义数据集与评估器。
- 多模态团队需要在同一工作流中跑文本与视觉-语言数据集(已集成 VLMEvalKit)。
1.3 能力边界(官方口径)
- 平台本身不训练模型;它负责驱动推理与评分,模型权重需自行准备。
- 代码执行类数据集(APPS、TACO、LiveCodeBench Code Generation)依赖
pyext,在 Python ≥3.11 下不可用,需 Python 3.10 环境。 - 不同推理后端依赖经常冲突,官方建议在各自虚拟环境中安装。
2 功能特性
2.1 一站式评测工作流
覆盖数据集与模型配置、推理、评估、结果汇总全流程;支持任务分区、并发执行与分布式执行,适应不同规模评测负载。
2.2 广泛模型与数据集覆盖
- 开源模型:DeepSeek、Gemma、GLM、Intern-S、Kimi、Llama、MiniMax、Mistral、Qwen
等,配置位于
opencompass/configs/models/。 - API 模型:OpenAI、Anthropic Claude、Google Gemini、字节豆包、xAI Grok 等;2026 年新增 OpenAI Responses API 与 LiteLLM AI Gateway。
- 数据集:100+ 数据集,覆盖知识、推理、代码、科学、语言、长上下文、安全;2025 年新增 SuperGPQA(285 个研究生学科)、Multi-IF 多轮指令、Intern-S1-Pro、SciReasoner 等。
2.3 多模态与 Agent 评测
- 已集成 VLMEvalKit,统一加载多模态数据集、走 OpenAI 兼容 API
推理、用官方 VLMEvalKit 指标评分(见
examples/eval_mmbench_vlmevalkit.py、eval_mmmu_pro_vlmevalkit.py)。 - 姊妹项目 AgentCompass 面向 LLM/VLM Agent 评测,支持 30+ 公开基准与 10+ Agent harness(Claude Code、Codex、OpenHands 等)。
2.4 评估器与工具
GenericLLMEvaluator:LLM-as-judge 通用评估。MATHVerifyEvaluator:数学推理验证。CascadeEvaluator:多评估器串行组合,支持自定义评估流水线。RawPromptTemplate:原样传递基准提示词与结构化对话,避免格式化篡改。- 重复分析工具
tools/analyze_repeat.py:检测模型输出中的重复内容与循环。
3 官方界面预览
图 1 为官方 README 中展示的 OpenCompass 平台示意图。
4 官方跳转链接汇总
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库主页 | github.com/open-compass/opencompass | 源码、examples、configs |
| 官方网站 | opencompass.org.cn | 项目主页 |
| 文档 | opencompass.readthedocs.io | 安装、quickstart、数据集与模型说明 |
| CompassHub | hub.opencompass.org.cn | 基准导航 |
| CompassRank | rank.opencompass.org.cn | 模型评测榜单 |
| 安装指南 | Installation | 详细安装步骤 |
| Quick Start | Quick Start | 首次评测示例 |
| AgentCompass | github.com/open-compass/AgentCompass | Agent 评测基础设施 |
| VLMEvalKit | github.com/open-compass/VLMEvalKit | 多模态评测 |
| Discord | discord.gg/KKwfEbFj7U | 社区 |
5 前置要求与服务器配置
5.1 软件前提
- 操作系统:Linux(推荐 Ubuntu 20.04/22.04)。
- Conda:官方推荐用 conda 管理环境。
- Python 3.12:常规与 full 安装;若需跑 APPS / TACO /
LiveCodeBench Code Generation 等代码执行数据集,需 Python
3.10(
pyext==0.7在 Python ≥3.11 下被跳过)。 - GPU(评测本地开源模型时):按模型规模选择;API 评测不需要 GPU。
5.2 硬件建议
| 场景 | 推荐配置 |
|---|---|
| 仅 API 模型评测 | 普通 CPU 服务器即可 |
| 开源 7B–13B 模型评测 | 单张 24GB 显存 GPU |
| 开源 70B 模型评测 | 多卡 A100 / H100 80GB |
| 大规模分布式评测 | 多节点集群(按文档分布式执行章节) |
5.3 端口说明
| 端口 | 服务 | 用途 |
|---|---|---|
| 无 | OpenCompass 评测任务 | 命令行工具,不监听 Web 端口 |
| 8000(可选) | vLLM / LMDeploy 本地推理服务 | 被测模型本地服务化时使用 |
6 方式一:pip 安装与快速评测
6.1 创建环境
conda create --name opencompass python=3.12 -y
conda activate opencompass
6.2 安装 OpenCompass
# 基础安装:支持大多数数据集与模型
pip install -U opencompass

# 完整安装:支持更多数据集
# pip install "opencompass[full]"

# 推理后端(依赖冲突,建议各自独立环境)
# pip install "opencompass[lmdeploy]"
# pip install "opencompass[vllm]"

# API 评测(OpenAI、Qwen 等)
# pip install "opencompass[api]"

# 多模态评测
# pip install "opencompass[vlm]"
6.3 运行评测
安装后阅读 Quick Start 跑首个评测任务。典型命令形式(以官方 quickstart 为准):
# 示例:在指定配置上跑评测(具体配置名以 docs 为准)
opencompass run <config.py>
7 方式二:源码安装
git clone https://github.com/open-compass/opencompass opencompass
cd opencompass
pip install -e .
# pip install -e ".[full]"
# pip install -e ".[vllm]"
8 配置项说明
OpenCompass 通过 Python 配置文件组织评测任务,核心维度包括:
| 维度 | 说明 |
|---|---|
models |
被测模型列表(开源本地路径或 API 端点) |
datasets |
数据集与 prompt 模板 |
workdir |
推理结果与报告输出目录 |
task |
任务分区与并发策略 |
eval |
评估器选择(规则 / LLM-judge / Cascade) |
模型配置样例见 opencompass/configs/models/,数据集配置见
opencompass/configs/datasets/。
9 常用运维命令
# 查看 opencompass 版本
opencompass --version

# 查看 GPU 占用
nvidia-smi

# 查看评测输出
ls <workdir>/

# 停止评测任务
# Ctrl+C;多进程时 pkill -f "opencompass"

# 重复分析(对已有结果检测循环输出)
python tools/analyze_repeat.py <path_to_results>
10 常见故障排查
- APPS / TACO / LiveCodeBench
不可用:
pyext在 Python ≥3.11 下被跳过;改用 Python 3.10 环境。 - 依赖冲突:LMDeploy、vLLM 等后端依赖互相冲突,按官方建议在独立 conda 环境安装。
- API 评测失败:检查
OPENAI_API_KEY等环境变量;2026 年新版支持 OpenAI Responses API 与 LiteLLM 网关,按opencompass/models/下最新实现配置。 - 多模态评测报错:需
pip install "opencompass[vlm]",并参考examples/eval_mmbench_vlmevalkit.py。 - 输出重复 / 循环:用
tools/analyze_repeat.py检测;调整 prompt 与解码参数(temperature、repeat penalty)。 - 结果不可复现:按官方文档固定随机种子与数据集版本;优先用
RawPromptTemplate避免格式化偏差。
11 风险与合规说明
- API 费用:评测商业模型会产生 API 调用费用,大规模基准跑下来成本可观;请先小规模试跑。
- 数据隐私:评测 prompt 与答案可能发送到第三方 API,敏感数据请勿用于 API 评测。
- 模型许可:本地开源模型按各自许可使用;OpenCompass 代码 Apache 2.0。
- 基准偏差:榜单结果受提示词、采样参数、评估器影响,跨模型对比时请固定配置。
- 本文非官方文档:命令与配置以 opencompass.readthedocs.io 最新文档为准。