

TensorRT-LLM:NVIDIA 开源大模型推理优化库与高性能运行时|部署与使用全指南
项目仓库: https://github.com/NVIDIA/TensorRT-LLM
开源协议:Apache 2.0 · 交付形态:Python
库(tensorrt_llm)+ LLM API + trtllm-serve /
trtllm-bench / trtllm-eval CLI ·
版本:1.4.0rc3(README 徽章) · 运行时:Python 3.10 / 3.12、CUDA
13.4.1、PyTorch 2.14.0 · 官方文档:nvidia.github.io/TensorRT-LLM
官方维护状态说明:TensorRT-LLM 由 NVIDIA 维护,2025 年 3 月起完全开源并迁入 GitHub;仓库 README 以新闻与技术博客为主,具体安装与构建命令以官方 Installation Guide 与 Quick Start 为准。本文命令与版本信息均取自 README 徽章与官方文档链接,未臆造安装步骤。
1 项目简介
TensorRT LLM 是 NVIDIA 开源的大语言模型与视觉生成模型推理优化库。它通过为注意力、GEMM、MoE 等算子编写专用 CUDA kernel,配合 Prefill-Decode 分离、Wide Expert Parallelism、投机解码、KV Cache 压缩、稀疏注意力等运行时优化,在 NVIDIA GPU 上实现高吞吐、低延迟推理。库本身基于 PyTorch 架构,提供高层 Python LLM API,从单卡到多卡多节点部署均可通过统一接口配置,并可与 NVIDIA Dynamo、Triton Inference Server 集成。
非官方 / 第三方边界声明:TensorRT-LLM 仅支持 NVIDIA GPU;CPU / AMD / Apple Silicon 不在官方支持矩阵内。模型权重来自各上游模型发布方(Meta、DeepSeek、Qwen、OpenAI 等),按各自许可使用。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | TensorRT LLM(Python 包 tensorrt_llm) |
| 仓库地址 | github.com/NVIDIA/TensorRT-LLM |
| 项目定位 | NVIDIA GPU 上 LLM 与视觉生成模型推理优化库 |
| 开源协议 | Apache 2.0 |
| 版本 | 1.4.0rc3(README 徽章) |
| Python | 3.10 / 3.12 |
| CUDA | 13.4.1(README 徽章) |
| PyTorch | 2.14.0(README 徽章) |
| 核心接口 | 高层 Python LLM API;CLI trtllm-serve /
trtllm-bench / trtllm-eval |
| 生态集成 | NVIDIA Dynamo、Triton Inference Server、Model Optimizer 量化模型 |
| 官方文档 | nvidia.github.io/TensorRT-LLM |
1.2 适用场景
- 在 NVIDIA GPU(A100 / H100 / H200 / B200 / L4 / RTX 系列)上追求最大化 LLM 推理吞吐与最低延迟。
- 需要从单卡扩展到多卡、多节点,并使用张量并行 / 流水线并行 / 专家并行等策略。
- 已有 transformers 模型,希望通过 TensorRT-LLM 编译为高性能引擎并接入 Triton 或 Dynamo 服务。
- 需要做 DeepSeek-R1、Llama 4、Qwen3、GPT-OSS 等前沿模型的 Day-0 优化部署。
1.3 能力边界(官方口径)
- 仅支持 NVIDIA GPU;支持矩阵见官方 support-matrix。
- 库本身不提供 Web UI 或用户管理;服务化需配合 Triton / Dynamo 或自行封装。
- 默认开启匿名遥测(不采集提示词、权重、路径等敏感信息),可通过环境变量或 CLI 关闭。
- 版本演进快,1.0 起遵循 deprecation 政策:废弃 API 给 3 个月迁移期,之后移除。
2 功能特性
2.1 专用 kernel 与运行时优化
- 针对注意力、GEMM、MoE 等常见算子编写专用 CUDA kernel。
- 算法层优化:Prefill-Decode 分离、Wide Expert Parallelism、投机解码(Speculative Decoding)、N-Gram 投机解码、引导解码、KV Cache 复用与压缩、稀疏注意力、Skip Softmax Attention、MultiShot 多轮优化。
2.2 PyTorch 原生架构与可扩展
- 基于 PyTorch,可直接用原生 Python 代码实验与扩展运行时。
- 热门模型(DeepSeek-V3/V3.2/V4、Llama 4、Qwen3、GPT-OSS
等)已预定义,可通过
tensorrt_llm/_torch/models/modeling_*.py自定义。
2.3 并行策略
内置张量并行(TP)、流水线并行(PP)、上下文并行(CP)、MoE 专家并行(EP)、MoE 张量并行,以及面向 NVL72 机架的 DWDP 分布式权重数据并行。
2.4 量化与视觉生成
- 配合 NVIDIA Model Optimizer 提供 FP8 / FP4 量化模型,Hugging Face 上有 nvidia/model-optimizer 合集。
- 2025 年 4 月起支持扩散模型视觉生成,见
docs/source/models/visual-generation.md。
2.5 CLI 与服务化
trtllm-serve:启动 OpenAI 兼容服务。trtllm-bench:性能基准测试。trtllm-eval:模型评测。- 与 NVIDIA Dynamo 集成做数据中心级分布式服务;与 Triton Inference Server 集成做云原生部署。
3 官方界面预览
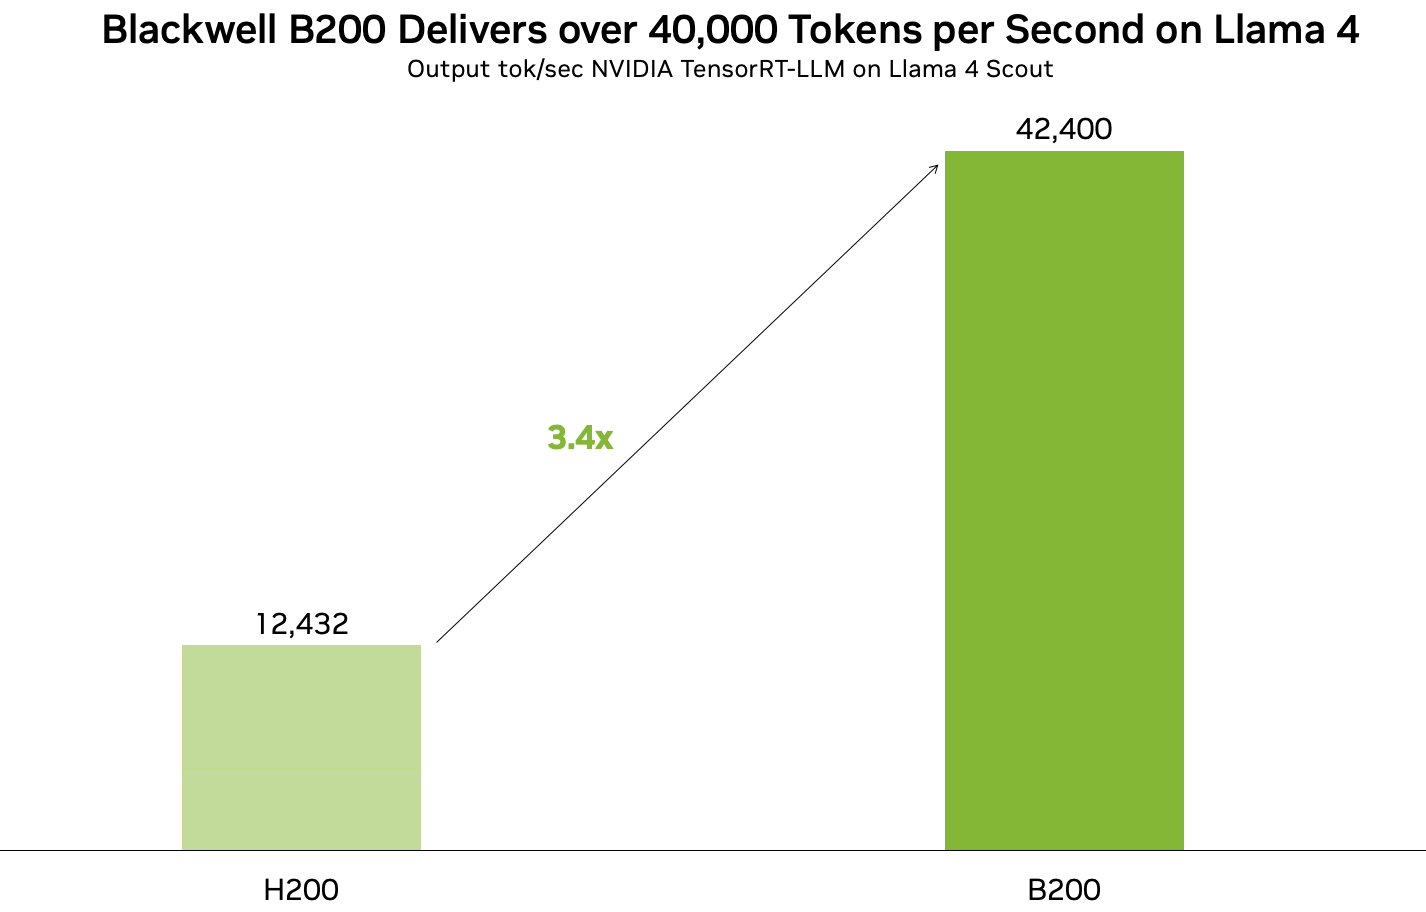
TensorRT-LLM 为命令行 / Python 库,不提供图形界面。图 1 为官方新闻中展示的 L4 GPU 上 Llama 推理性能曲线。
4 官方跳转链接汇总
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库主页 | github.com/NVIDIA/TensorRT-LLM | 源码、README、examples |
| 官方文档 | nvidia.github.io/TensorRT-LLM | 安装、quickstart、API、性能 |
| 安装指南 | Installation Guide | 推荐阅读入口 |
| Quick Start | Quick Start Guide | LLM API 与首个示例 |
| 支持矩阵 | support-matrix | 硬件 / 模型 / 软件版本 |
| Release Notes | release-notes | 版本与废弃政策 |
| 量化模型 | HF nvidia/model-optimizer | FP8 / FP4 现成模型 |
| NVIDIA Dynamo | github.com/ai-dynamo/dynamo | 数据中心级分布式服务 |
| Triton Server | github.com/triton-inference-server/server | 云原生推理服务 |
| DeepWiki | deepwiki.com/NVIDIA/TensorRT-LLM | 代码库问答 |
| 技术博客 | NVIDIA Developer Blog | 各模型优化实战 |
5 前置要求与服务器配置
5.1 软件前提
- 操作系统:Linux(推荐 Ubuntu 22.04);Windows 支持见官方博客(RTX 系列)。
- NVIDIA GPU:依据 support-matrix,覆盖从 RTX 消费级到 H100 / H200 / B200 数据中心卡。
- 驱动与 CUDA:README 徽章标注 CUDA 13.4.1;实际兼容范围以支持矩阵为准。
- Python 3.10 或 3.12(README 徽章)。
- PyTorch 2.14.0(README 徽章)。
5.2 硬件建议
| 场景 | 推荐 GPU |
|---|---|
| 开发 / 小模型(7B–13B) | RTX 4090 24GB / L4 24GB / A10G |
| 大模型单节点(70B 级别) | A100 80GB × 多卡 / H100 80GB × 多卡 |
| 超大模型 / MoE(DeepSeek 级别) | H100 / H200 / B200 多节点 NVL72 |
5.3 端口说明
| 端口 | 服务 | 默认绑定 | 用途 |
|---|---|---|---|
| 8000(默认) | trtllm-serve |
0.0.0.0:8000 |
OpenAI 兼容 API(以官方文档为准) |
具体端口与启动参数以
trtllm-serve --help与官方 quickstart 为准。
6 方式一:pip / 容器安装与 LLM API 快速上手
6.1 安装
TensorRT-LLM 推荐通过官方预编译 wheel 或 NGC 容器安装;具体步骤按 Installation Guide 执行。在满足 Python 3.10 / 3.12、CUDA 13.4.1、PyTorch 2.14.0 的环境中:
# 官方提供的预编译 wheel(以 Installation Guide 给出的版本为准)
# pip install tensorrt_llm

# 如需关闭遥测(推荐生产环境)
export TRTLLM_NO_USAGE_STATS=1
6.2 用高层 LLM API 跑一次推理
from tensorrt_llm import LLM, SamplingParams

# model 可指向 Hugging Face 模型 id 或本地权重目录
llm = LLM(model="nvidia/Llama-3.1-70B-Instruct-FP8")

sampling_params = SamplingParams(max_tokens=128, temperature=0.7)
output = llm.generate(["Hello, introduce yourself."], sampling_params)
print(output)
6.3 启动 OpenAI 兼容服务
# 以官方文档为准;--no-telemetry 关闭遥测
trtllm-serve <model> --host 0.0.0.0 --port 8000 --no-telemetry
7 方式二:源码构建与 examples
7.1 克隆仓库
git clone https://github.com/NVIDIA/TensorRT-LLM.git
cd TensorRT-LLM
7.2 编译与构建
源码构建需要 NVIDIA 编译工具链;步骤以 Installation
Guide 与仓库 docs/ 内说明为准。仓库
examples/ 目录按模型组织示例(如
examples/models/core/deepseek_v3),每个示例包含构建引擎与运行脚本。
7.3 性能基准
# 以官方文档为准;--no-telemetry 关闭遥测
trtllm-bench <model> --dataset <path> --no-telemetry
8 配置项说明
8.1 遥测相关环境变量
| 变量 | 作用 |
|---|---|
TRTLLM_NO_USAGE_STATS=1 |
关闭遥测 |
DO_NOT_TRACK=1 |
关闭遥测(通用 DNT 约定) |
TELEMETRY_DISABLED=true |
关闭遥测 |
也可创建文件 ~/.config/trtllm/do_not_track,或在 Python
中传 TelemetryConfig(disabled=True),或在 CLI 上加
--no-telemetry。
8.2 并行与量化关键参数(以 LLM API 为准)
| 维度 | 说明 |
|---|---|
| TP / PP / CP | 张量 / 流水线 / 上下文并行度 |
| MoE-EP / MoE-TP | MoE 模型的专家并行 / 张量并行 |
| dtype / KV cache dtype | 计算精度(FP16 / BF16 / FP8 / FP4) |
| 量化 | 配合 Model Optimizer 产出的量化权重 |
完整参数列表以 LLM API 文档 与各模型 example README 为准。
9 常用运维命令
# 查看 GPU 占用
nvidia-smi

# 查看 trtllm 相关 CLI 帮助
trtllm-serve --help
trtllm-bench --help
trtllm-eval --help

# 关闭遥测后运行
TRTLLM_NO_USAGE_STATS=1 trtllm-serve <model> --no-telemetry

# 查看已安装版本
python -c "import tensorrt_llm; print(tensorrt_llm.__version__)"
10 常见故障排查
- 仅 NVIDIA GPU 支持:AMD / Apple Silicon / 纯 CPU 无法运行;请改用 vLLM、llama.cpp 等跨平台方案。
- CUDA / PyTorch 版本不匹配:README 徽章要求 CUDA 13.4.1、PyTorch 2.14.0;版本不符时优先按官方 support-matrix 对齐。
- 模型权重格式不兼容:TensorRT-LLM 支持的模型需对应仓库 example;量化模型请优先使用 nvidia/model-optimizer 已发布版本。
- 启动时报废弃 API 警告:按 Release Notes 给出的 3 个月迁移期升级到新接口。
- 遥测顾虑:设置
TRTLLM_NO_USAGE_STATS=1或加--no-telemetry;官方声明不采集提示词、权重与路径。 - 性能不及预期:参考官方 performance-tuning-guide
用
trtllm-bench做基准,按报告调整并行度与 batch。
11 风险与合规说明
- 硬件锁定:仅支持 NVIDIA GPU,迁移到其他硬件需重选推理框架。
- 版本演进快:1.4.0rc3 仍为 rc 预发布版本,生产部署请评估稳定性;按官方 deprecation 政策升级。
- 模型许可:TensorRT-LLM 代码 Apache 2.0,但运行的模型权重按各自上游许可(Meta Llama、DeepSeek、Qwen 等)。
- 遥测:默认开启但匿名化,不采集敏感数据;生产环境建议显式关闭。
- 本文非官方文档:安装与 API 步骤以官方 nvidia.github.io/TensorRT-LLM 最新文档为准;本文未臆造具体 pip 包版本与构建命令。