
OpenAI Swarm 本地部署指南:用最朴素的抽象理解多 Agent 协作
一、项目介绍
多 Agent 系统听起来常常很复杂:每个智能体有独立记忆、独立工具、独立规划模块,还要在它们之间传递上下文。OpenAI 开源的 Swarm 反其道而行之——它是一个实验性、教学性质的轻量框架,试图用最少的抽象让人理解"多个智能体如何协作"。
根据官方 README 的定义,Swarm 专注于让智能体的协调与执行变得轻量、高度可控、易于测试。它只通过两个原语抽象来实现这一点:Agent(智能体)与 handoff(交接)。一个 Agent 封装了指令(instructions)与工具(functions),并且可以在任意时刻选择把对话交接给另一个 Agent。
官方在 README 顶部用醒目的提示说明:Swarm 现已被生产级的 OpenAI Agents SDK 所取代,后者是 Swarm 的演进版本,由 OpenAI 团队持续维护。但 Swarm 作为理解多 Agent 编排的教学材料,依然极具价值——它几乎完全在客户端运行,类似 Chat Completions API,在调用之间不保存状态,概念边界非常清晰。
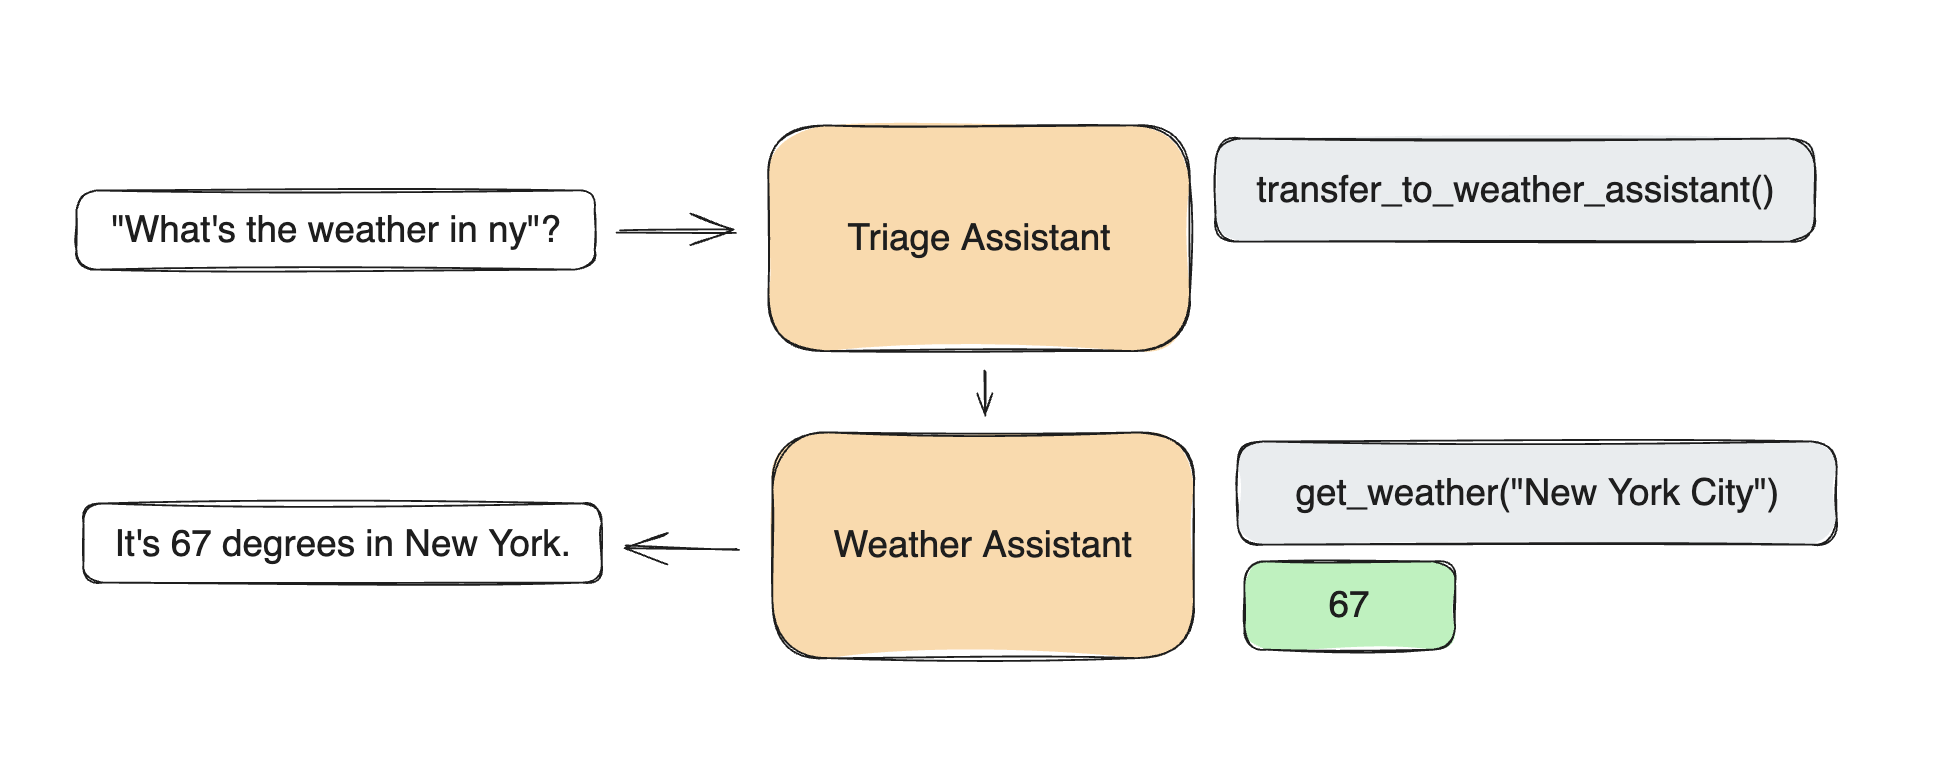
为什么要学这样一个"已被取代"的框架?因为它把多 Agent 的核心机制剥到了最薄:Agent 就是指令加函数,交接就是函数返回另一个 Agent,状态就是一个字典。没有花哨的记忆模块、没有复杂的规划器,你能在几十行代码里看懂"多智能体对话"到底是怎么跑起来的。理解了 Swarm,再去看功能更全的 Agents SDK 或其他编排框架,就不会被概念淹没。
二、官方信息
| 项目 | 信息 |
|---|---|
| 仓库地址 | github.com/openai/swarm |
| 继任项目 | OpenAI Agents SDK |
| Star 数量 | 约 22k |
| 主语言 | Python |
| Python 要求 | 3.10+ |
| 默认模型 | gpt-4o |
| 最近更新 | 2026-04(实验性归档维护状态) |
注:Swarm 为教学实验项目,已停止活跃迭代,生产使用建议迁移到 Agents SDK。本文命令与行为以仓库 README 为准。
本文将带你把 Swarm 装好、跑通第一个多 Agent 交接示例,并理解它那套看似简单却能表达丰富协作的运行循环。
三、项目结构与核心特性
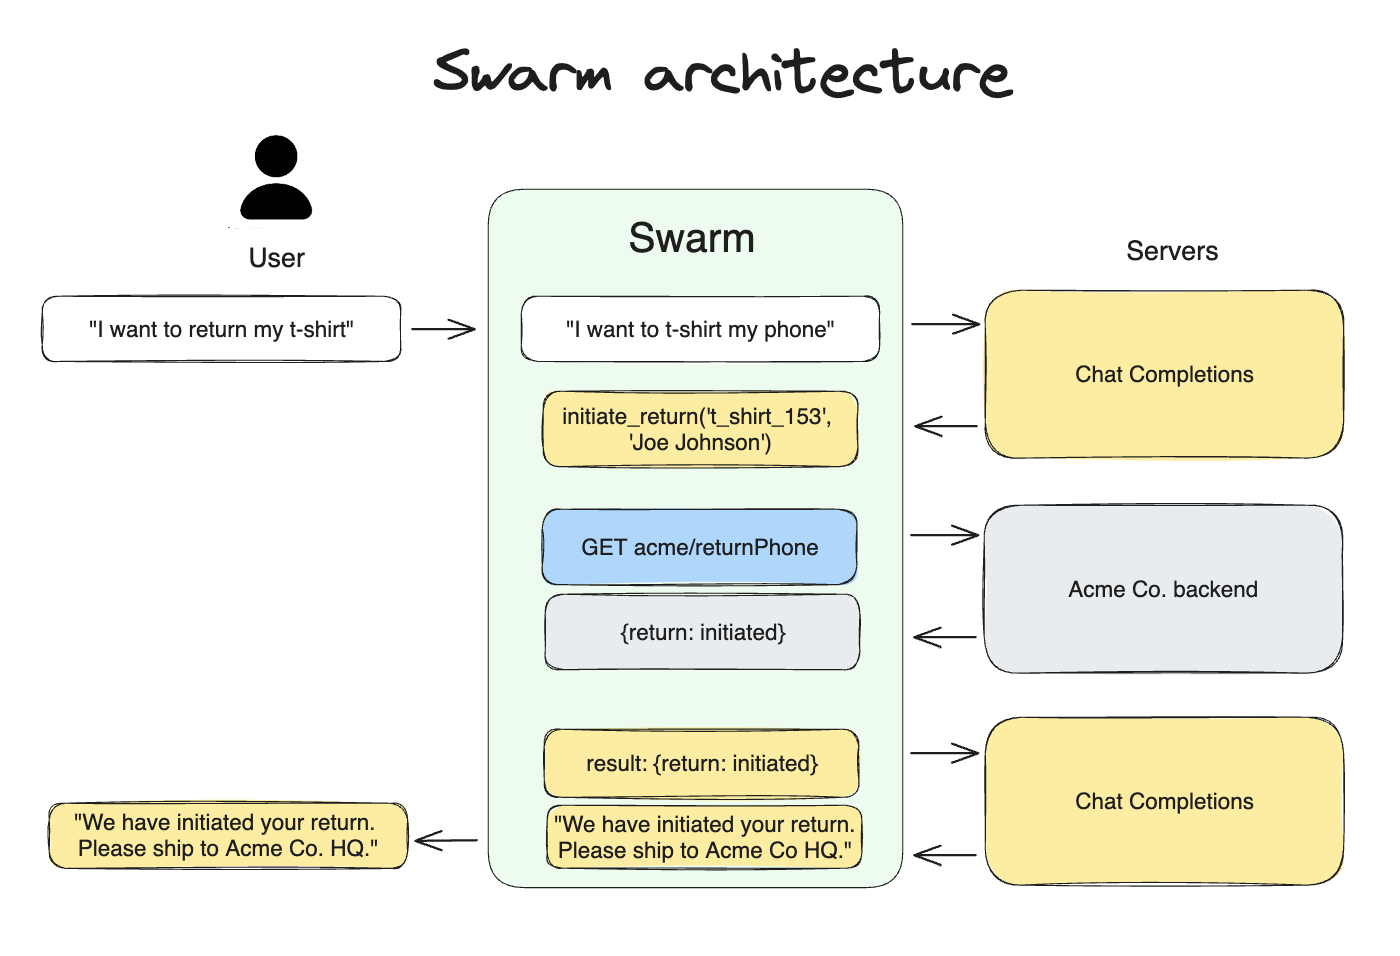
理解 Swarm,关键是理解它的运行循环。client.run() 内部实现了这样一个闭环:
- 让当前 Agent 产出一次补全(completion);
- 执行它提出的工具调用,并把结果追加回消息列表;
- 如果需要,切换到另一个 Agent;
- 如有必要,更新上下文变量;
- 当没有新的工具调用时,返回给用户。
这套循环可以连续跑多轮,直到任务完成。由此带来几个核心特性:
- Agent 即指令加工具:一个 Agent 本质上是一段 system prompt 加上一组可调用的 Python 函数。函数返回字符串就是普通输出;返回一个 Agent 对象,就触发交接。
- Handoff 交接:当任务需要换"人"处理时(例如客服问题转接到销售),函数直接
return sales_agent,控制权随之转移。 - 上下文变量:通过
context_variables字典在多轮、多 Agent 之间共享临时状态(如用户名、部门)。 - 自动函数 Schema:Swarm 自动把 Python 函数转成 JSON Schema 喂给模型——docstring 变成描述,类型提示变成参数类型,没有默认值的参数标记为 required。
- 流式与 REPL:支持
stream=True,并提供run_demo_loop在命令行直接交互式测试。
适用场景
虽然 Swarm 已被官方标记为教学实验项目,但它的思路在今天仍有很强的参考价值。它适合学习多 Agent 编排的基本概念:交接、函数调用、上下文共享、多轮循环。如果你正在评估各种 Agent 框架,先在 Swarm 里手写一个"分诊-转接-执行"的小例子,能帮你建立直观感受,再去读 Agents SDK 或其他框架的源码就不会发懵。它也适合快速原型验证某个多 Agent 流程是否可行——几十行代码就能跑通,成本极低。
与同类框架对比
和功能更全的多 Agent 框架相比,Swarm 刻意不做记忆持久化、不做复杂规划,把状态管理完全留给调用方。这种"薄"反而是它的价值:你能看清楚多 Agent 运行的每一步,而不是被一堆黑盒抽象包裹。和 OpenAI 官方的 Assistants API 相比,Swarm 几乎全在客户端运行、无状态、可控;而 Assistants API 是全托管的。理解 Swarm 之后再迁移到 Agents SDK,会发现后者只是在这套朴素原语上加了持久化、工具生态与观测能力。
四、环境与版本要求
- Python 3.10 及以上(README 明确要求)。
- 一个 OpenAI API Key(因为 Swarm 底层调用 Chat Completions API),通过环境变量
OPENAI_API_KEY提供。 - 网络能访问 OpenAI API;若使用兼容端点,可在实例化
Swarm时传入自定义 client。 - 无需数据库、无需独立服务进程,库本身在本地进程内完成编排。
提示:Swarm Agent 与 OpenAI Assistants API 里的 Assistant 没有任何关系,只是命名相似。Swarm 完全基于 Chat Completions API,是无状态的。
五、本地部署步骤
1. 安装
Swarm 没有发布到 PyPI,官方推荐直接从 GitHub 安装:
python -m venv .venv
source .venv/bin/activate

# 方式一:通过 HTTPS
pip install git+https://github.com/openai/swarm.git

# 方式二:通过 SSH(已配置密钥时)
pip install git+ssh://git@github.com/openai/swarm.git
2. 配置 API Key
export OPENAI_API_KEY="sk-你的密钥" # Windows: set / $env:OPENAI_API_KEY=...
3. 编写第一个多 Agent 示例
新建 demo.py:
from swarm import Swarm, Agent

client = Swarm()

# 定义一个"交接函数":返回 agent_b 即可触发切换
def transfer_to_agent_b():
    return agent_b

agent_a = Agent(
    name="Agent A",
    instructions="You are a helpful agent.",
    functions=[transfer_to_agent_b],
)

agent_b = Agent(
    name="Agent B",
    instructions="Only speak in Haikus.",   # 只以俳句回答
)

response = client.run(
    agent=agent_a,
    messages=[{"role": "user", "content": "I want to talk to agent B."}],
)

print(response.messages[-1]["content"])
逐行说明:
Swarm()内部会实例化一个 OpenAI client;agent_a拥有一个交接函数,模型判断需要时会调用它;client.run()自动在两个 Agent 之间完成多轮对话;- 最终输出类似俳句的回复,例如 "Hope glimmers brightly, New paths converge gracefully, What can I assist?"
4. 交互式 REPL 验证
官方提供了命令行演示循环,适合快速试玩:
# repl_demo.py
from swarm import Agent
from swarm.repl import run_demo_loop

def hello():
    return "Hi!"

agent = Agent(name="Tutor", instructions="You are a helpful tutor.", functions=[hello])
run_demo_loop(agent, stream=True)
运行:
python repl_demo.py
在提示符下输入问题,如果模型能正确调用工具或按指令回答,说明部署成功。
排错思路
模型不交接时,先检查 instructions 是否清楚描述了"什么时候该转接给谁",以及交接函数的命名是否直观。Swarm 依赖模型自行决定调用函数,含糊的描述会让模型选择直接回答而不是转接。其次,多轮对话要自己维护状态:把上一次 run() 返回的 messages、agent、context_variables 原样回传,再追加新的用户消息,否则每次都像从零开始。
调试时打开 debug=True 能看到每轮发给模型的完整消息与工具调用,非常有助于理解"模型为什么这么决定"。注意 Swarm 是无状态的,不要指望它自动记住上一次对话;把这一点想通,多 Agent 的状态管理思路就清晰了。
六、API 用法与示例
client.run() 的常用参数:
| 参数 | 作用 | 默认值 |
|---|---|---|
agent |
起始 Agent | 必填 |
messages |
消息列表,同 Chat Completions | 必填 |
context_variables |
共享上下文字典 | {} |
max_turns |
最大对话轮数 | 无限 |
model_override |
临时覆盖模型 | None |
stream |
是否流式 | False |
函数如何更新上下文并交接:
from swarm import Swarm, Agent, Result

client = Swarm()

sales_agent = Agent(name="Sales Agent")

def talk_to_sales():
    print("Hello, World!")
    return Result(
        value="Done",
        agent=sales_agent,
        context_variables={"department": "sales"}
    )

agent = Agent(functions=[talk_to_sales])

response = client.run(
    agent=agent,
    messages=[{"role": "user", "content": "转接销售"}],
    context_variables={"user_name": "John"}
)
print(response.agent.name)            # Sales Agent
print(response.context_variables)     # {'department': 'sales', 'user_name': 'John'}
流式输出:
stream = client.run(agent, messages, stream=True)
for chunk in stream:
    print(chunk)
Swarm 还在标准流式事件之外增加了 {"delim": "start"} 与 {"delim": "end"},用来标记每次 Agent 切换,方便在界面上区分"现在是谁在说话"。完整字段说明见仓库 README 的 Response 字段表。
把示例搬到自己的业务里
Swarm 仓库里的 examples/airline 是最能体现多 Agent 价值的例子:它把航空客服拆成预订、更改、退款、投诉等多个专职 Agent,用户开口说"我想改航班",分诊 Agent 判断意图后交接给对应的专职 Agent,后者再调用查票、支付等函数。你会发现,这种"按职责拆 Agent"的模式比把所有规则塞进一个巨大的 system prompt 要稳定得多。
在自己的业务里落地时,建议遵循三条经验。第一,Agent 的 instructions 要短而具体,它是当前 Agent 的 system prompt,切换 Agent 时旧 Agent 的 instructions 不会留在对话里,所以每个 Agent 只需要关心自己的职责。第二,交接函数要语义清晰,函数名直接告诉模型"我能把你转给谁",例如 transfer_to_billing。第三,用 context_variables 传全局状态,例如用户身份、会话 ID,避免在每个 Agent 里重复询问。
关于评估,官方在 airline、weather_agent、triage_agent 示例中附带了简单的 eval 脚本思路:构造一批典型用户消息,断言最终被正确交接或正确调用了某个函数。多 Agent 系统最大的风险是"该交接时不交接、不该调用时乱调用",因此在上线前跑一批回归用例非常必要。
七、常见问题 FAQ
Q1:Swarm 还能用于生产项目吗?
A:官方明确建议生产环境迁移到 OpenAI Agents SDK,它是 Swarm 的生产级演进版。Swarm 更适合学习多 Agent 的基础模式(工具调用、交接、上下文共享)。
Q2:运行报 OPENAI_API_KEY 未设置或鉴权失败?
A:先确认已通过环境变量导出密钥;若使用 Azure OpenAI 或其他兼容端点,需要在构造 Swarm 时传入对应的 base_url 与 client 配置,具体请以 OpenAI SDK 文档为准。
Q3:模型没有按预期触发交接?
A:交接依赖模型正确发起函数调用。请确保函数命名与 instructions 描述清晰,例如函数名直接叫 transfer_to_sales;同时确认模型支持工具调用(默认 gpt-4o 支持)。
Q4:多轮对话的状态怎么保存?
A:Swarm 是无状态的。client.run() 返回的 Response 里包含最新的 messages、当前 agent 与 context_variables;把这些连同新的用户消息再次传给下一次 run(),即可在任意位置续上对话。
Q5:有哪些可参考的示例?
A:仓库的 examples/ 目录提供了 basic、triage_agent(分诊交接)、weather_agent(函数调用)、airline(航空客服多 Agent)、support_bot、personal_shopper 等示例,每个目录都有自己的 README,适合照搬到自己的业务。
小结
Swarm 的意义不在于"能不能上线跑",而在于它用最少的代码让人理解多 Agent 的运行机制:一个循环不断地让当前 Agent 说话、调用工具、必要时交接。把这套抽象吃透,你再去看任何更复杂的 Agent 框架,都能一眼看出它在哪些地方做了增强。生产项目请直接使用官方推荐的 Agents SDK,但作为学习材料,Swarm 的简洁无可替代。建议把 examples/airline 完整读一遍,那是理解"按职责拆分 Agent"最佳的范本。读完后不妨自己动手改一改:加一个退款 Agent、加一个查订单的函数,观察模型在什么条件下会主动交接。这种动手实验比读十篇概念文章都更能帮你建立对多 Agent 的直觉。当你能自如地在 Swarm 里拆出多个专职 Agent、并让它们正确交接时,再去看任何生产级 Agent 框架,都会觉得其核心机制不过如此。
部署后的日常使用
把 Swarm 跑通后,日常使用的核心是设计好你的 Agent 分工。建议从一个"分诊 Agent"开始:它只负责理解用户意图并决定转给谁;再为每类任务写一个专职 Agent。每次调用 client.run() 时,把上一次返回的 messages、agent、context_variables 原样带回,就能在任意时刻续上对话。用 run_demo_loop 在命令行里调试,比写完整脚本快得多,适合快速验证多 Agent 流程是否合理。熟练之后,你会发现 Swarm 那套"指令加函数加交接"的思路,几乎可以平移到任何多 Agent 场景里。
写在最后
Swarm 用极少的代码揭示了多 Agent 协作的本质,是这个领域最好的"入门教材"之一。虽然官方已建议生产使用 Agents SDK,但理解 Swarm 之后,你对任何 Agent 框架的学习都会事半功倍。把它当作一面透镜,透过它看清多智能体的运行机制,再去选择适合自己项目的生产工具。这个"先理解、再选型"的顺序,能帮你避免在纷繁的 Agent 框架里迷失方向。先把最小的多 Agent 循环跑明白,复杂系统的原理自然就通了。这种"透过简单框架理解复杂系统"的学习方式,值得在任何新技术出现时重复使用。理解了 Swarm,你就拥有了一把解剖多 Agent 系统的手术刀。带着这份理解再去看生产框架,你会发现它们并没有那么神秘。花一下午把 Swarm 跑通,你对 Agent 的理解会远超读十篇科普。动手永远是最好的老师。
上手顺序建议
建议的上手顺序是:先跑通官方的 examples/weather,理解一个 Agent 如何定义工具并返回结果;再看 examples/airline,观察多个专职 Agent 之间如何通过交接函数协作;最后自己动手加一个新的 Agent 或新的工具函数。走完这三步,你就会明白 Swarm 的核心其实只有三件事——给模型清楚的指令、让模型能调用函数、在适当时候把控制权交给另一个 Agent。其余的复杂性,都可以由你自己按需叠加。
相关链接
- 仓库:github.com/openai/swarm
- 继任项目 Agents SDK:github.com/openai/openai-agents-python
- 示例:github.com/openai/swarm/tree/main/examples
- Chat Completions API 参考:platform.openai.com/docs/api-reference/chat