
Text Generation Inference(简称 TGI)是 Hugging Face 官方开源的大语言模型推理部署工具包,它用 Rust、Python 与 gRPC 构建了一套高性能文本生成推理服务器,并在 Hugging Face 自家生产环境中被实际使用,为 Hugging Chat、Inference API 与 Inference Endpoints 提供推理服务。作为一套部署与服务大语言模型(LLM)的工具包,TGI 面向当下最流行的开源大模型提供高性能文本生成能力,支持 Llama、Falcon、StarCoder、BLOOM、GPT-NeoX 等众多模型,完整支持清单见官方支持模型列表。需要特别说明的是:根据仓库 README 顶部的官方公告,TGI 目前已进入维护模式,官方今后只接受针对小问题修复、文档改进与轻量维护类的 Pull Request;TGI 当年推动的"基于 transformers 模型架构做优化推理引擎"的路线,如今已被下游引擎广泛采用,官方推荐今后转向使用 vLLM、SGLang,以及 llama.cpp、MLX 这类彼此兼容的本地引擎。本文基于官方 README 逐节完整翻译整理,从项目背景、核心特性、安装部署、配置说明、使用示例到常见问题进行全面说明,帮助开发者完整了解它的能力、部署方式与用法,并快速完成本地部署。
一、项目官方信息
| 项目 | 信息 |
|---|---|
| 项目名称 | Text Generation Inference(TGI) |
| GitHub 仓库 | huggingface/text-generation-inference |
| 出品方 | Hugging Face |
| Star 数 | 约 1.1 万(实时以仓库页为准) |
| 开源协议 | Apache-2.0 |
| 主要语言 | Rust + Python(gRPC 服务) |
| 官方 API 文档 | Swagger UI |
| 官方文档 | Hugging Face TGI 文档 |
二、官方图片与架构
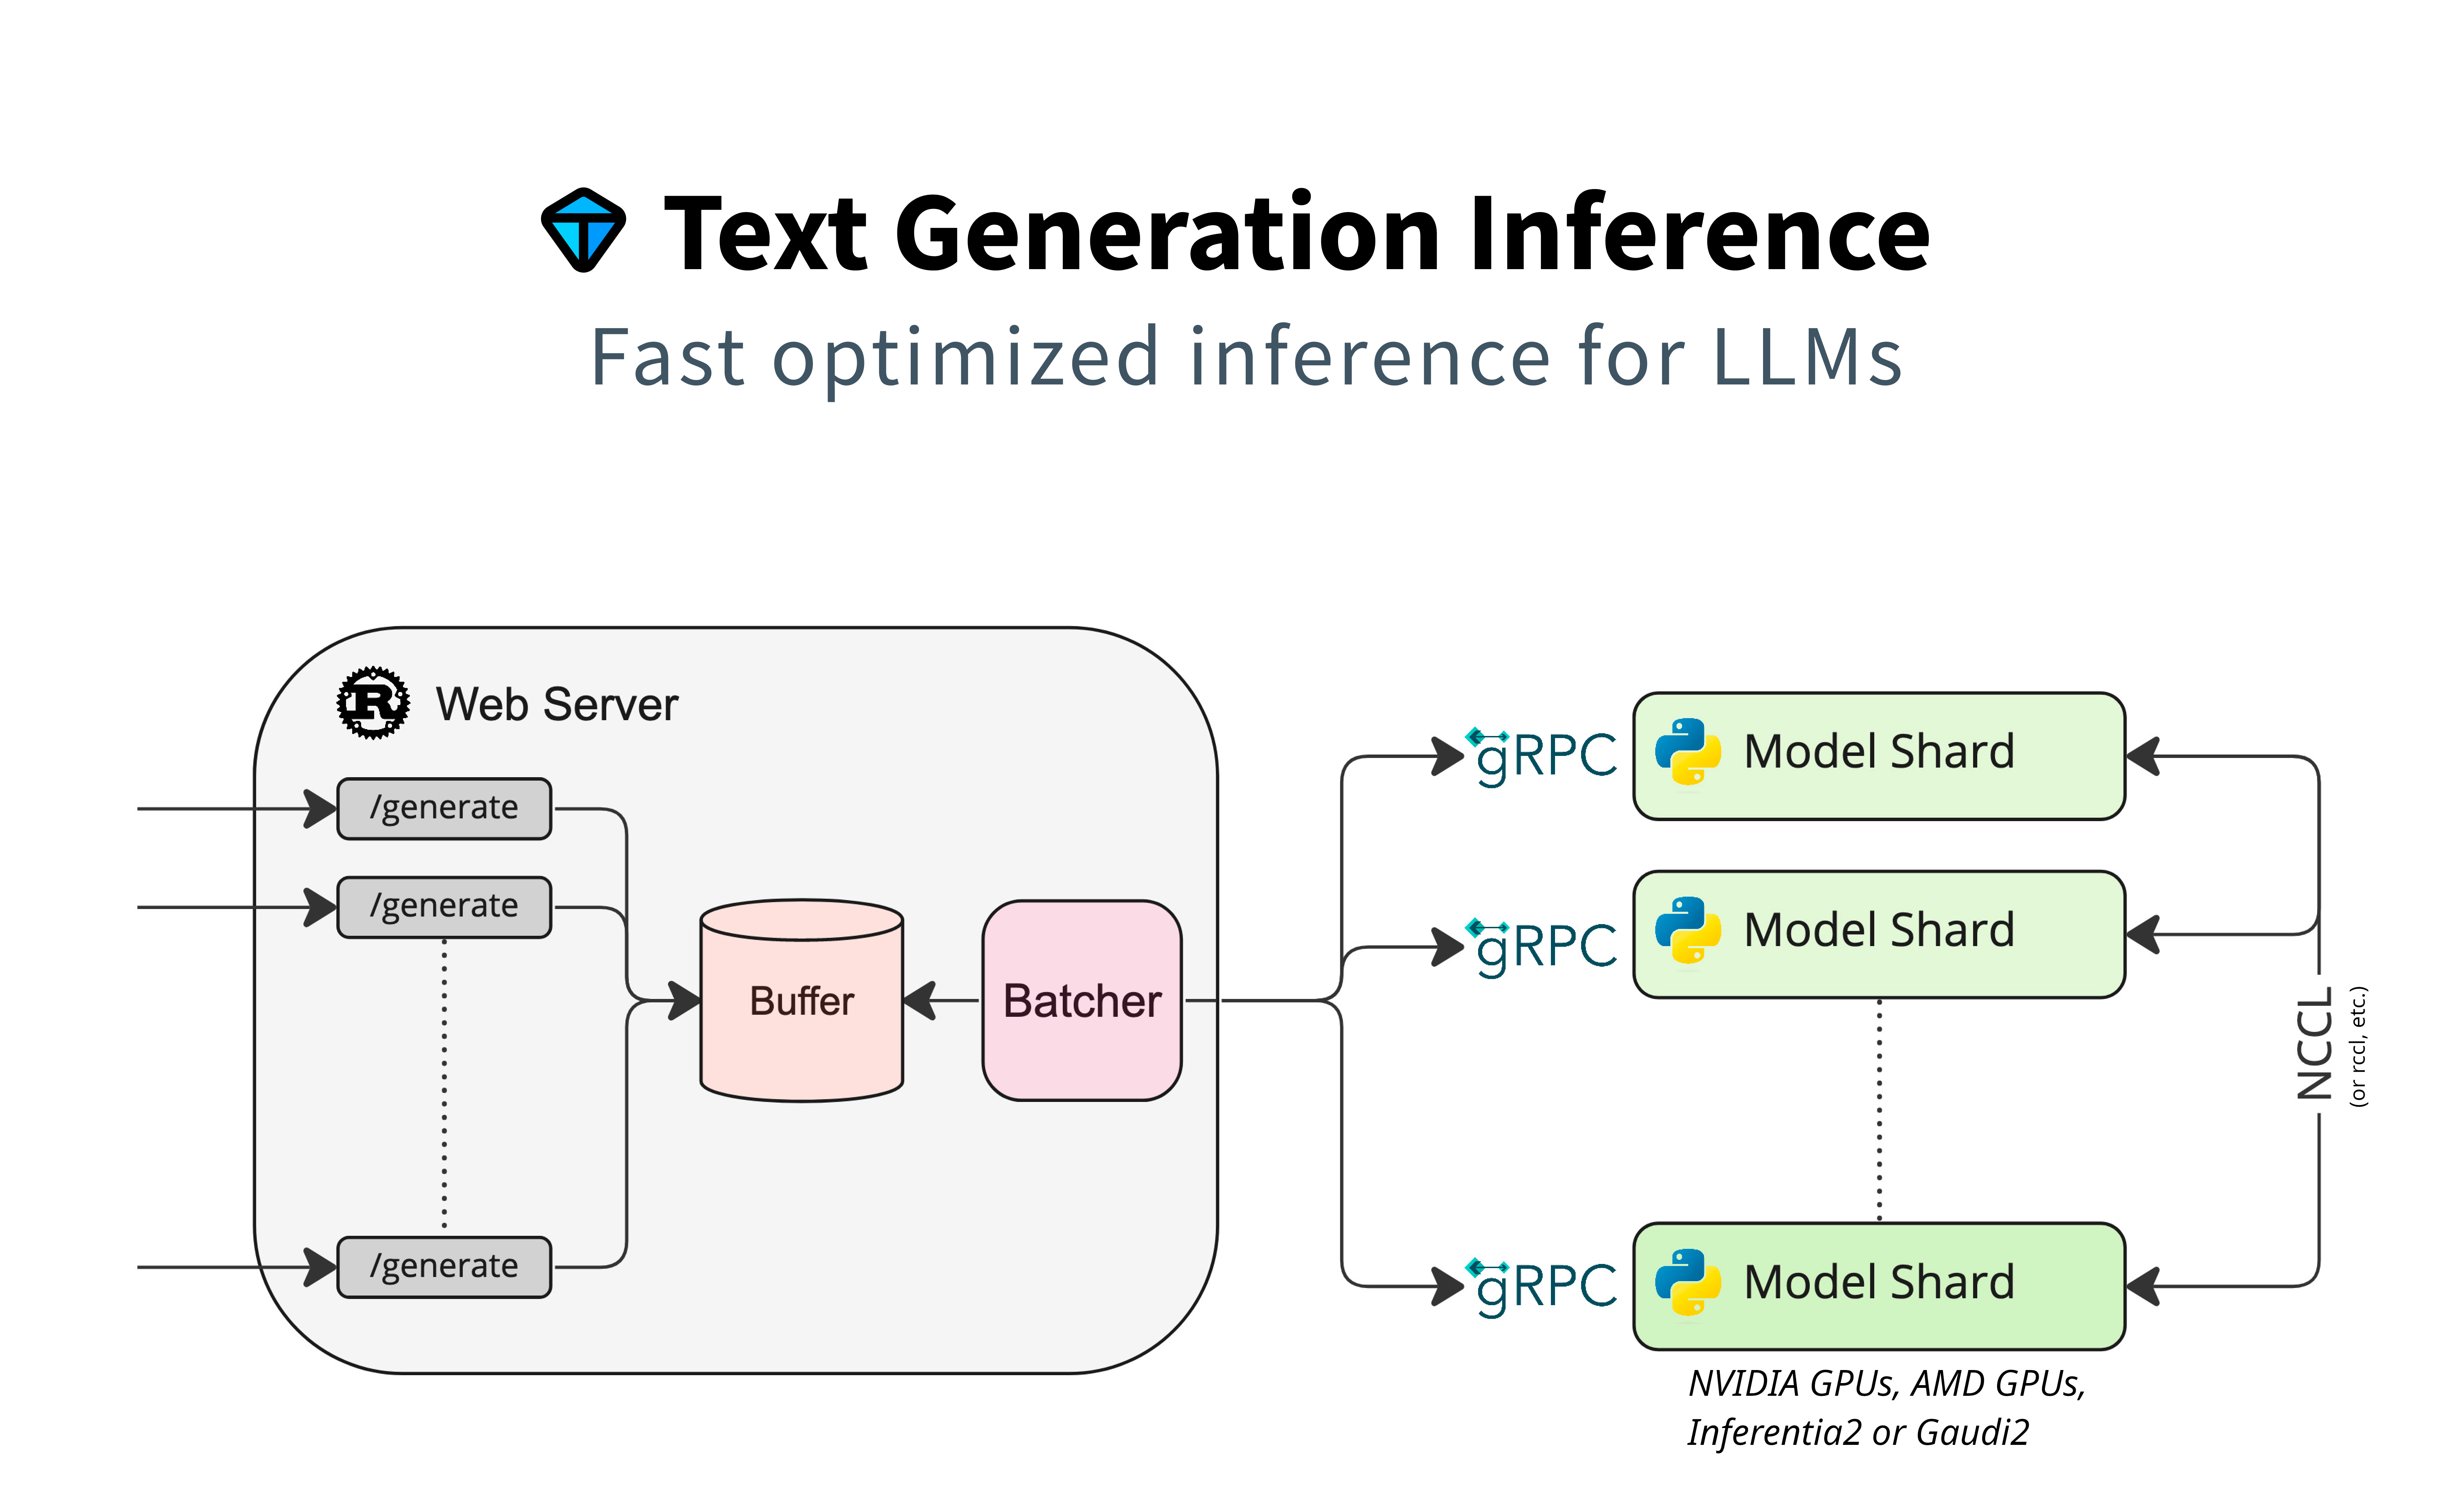
仓库 README 顶部附有一段官方演示视频封面(Making TGI deployment optimal),正文架构图见官方文档中的 TGI 架构图。整体上,TGI 由前端的 Rust 路由(router)与后端的 Python 推理服务组成,通过 gRPC 通信:Rust 路由负责接收 HTTP 请求、做连续批处理调度与流式回包,Python 推理服务则真正加载权重并执行前向计算,二者分离的设计既保证了网关层的高并发吞吐,又复用了 PyTorch 生态丰富的模型实现。服务内置 Prometheus 指标暴露与 OpenTelemetry 分布式追踪,支持张量并行把单个大模型切到多张 GPU 上推理。Adyen 官方博客曾详细解析 TGI 在大规模生产环境下的内部工作原理,可参考 LLM inference at scale with TGI。封面沿用本文既有官方仓库图,不再改动。
三、环境要求
根据 README 的说明,部署 TGI 需满足以下条件:
- 硬件支持:官方提供 Nvidia 与 AMD(-rocm 镜像) 容器镜像;此外还支持 AWS Inferentia(见 optimum-neuron)、Intel GPU、Habana Gaudi(见 tgi-gaudi)以及 Google TPU(见 optimum-tpu 文档)。
- NVIDIA 驱动:使用 NVIDIA GPU 时需要先安装 NVIDIA Container Toolkit,并推荐使用 CUDA 12.2 或更高版本的驱动。
- Python 版本:本地源码安装时需要至少 Python 3.9,官方示例使用 Python 3.11。
- 共享内存:多卡张量并行依赖 NCCL,容器需通过
--shm-size预留共享内存(官方示例为 1G);若使用 Kubernetes,需要以内存型 emptyDir 的形式为/dev/shm提供等价容量。 - CPU 兜底:在无 GPU、无 CUDA 的机器上也能运行,但需去掉
--gpus all并加上--disable-custom-kernels,官方明确提示 CPU 并非本项目目标平台,性能会比较差,只适合用来做功能验证而非生产服务。 - 网络与数据卷:首次启动时会从 Hugging Face Hub 下载模型权重,建议像官方示例那样把本地目录挂载到容器内
/data,让权重在多次重启之间复用,避免每次运行都重复下载;如果使用受限模型,还需要提前准备好具备 READ 权限的访问令牌。
四、部署步骤
1. Docker 部署(推荐)
官方建议从 Quick Tour 开始,最简单的方式是使用官方 Docker 容器:
model=HuggingFaceH4/zephyr-7b-beta
# 与容器共享一个数据卷,避免每次启动都重新下载权重
volume=$PWD/data

docker run --gpus all --shm-size 1g -p 8080:80 -v $volume:/data \
    ghcr.io/huggingface/text-generation-inference:3.3.5 --model-id $model
启动后即可向服务发起请求。官方建议第一次上手的读者先通读 Quick Tour,它会从零带你跑通容器启动、请求发送与流式输出。AMD 显卡请改用 -rocm 镜像,并挂载相应设备节点:
docker run --device /dev/kfd --device /dev/dri --shm-size 1g -p 8080:80 -v $volume:/data ghcr.io/huggingface/text-generation-inference:3.3.5-rocm --model-id $model
2. 使用私有或受限(gated)模型
如果模型是私有仓库,或是需要在网页上签署许可协议才能下载的 gated 模型(例如 Meta 官方的 Llama 系列),直接让 TGI 去下载会因权限不足而失败。这时可以通过 HF_TOKEN 环境变量配置 TGI 所用的访问令牌,从而获得受保护资源的访问权限:
- 前往 Hugging Face 的令牌设置页;
- 复制你的 CLI READ 令牌;
- 导出环境变量
HF_TOKEN=<your CLI READ token>。
Docker 下的写法为:
model=meta-llama/Meta-Llama-3.1-8B-Instruct
volume=$PWD/data
token=<your cli READ token>

docker run --gpus all --shm-size 1g -e HF_TOKEN=$token -p 8080:80 -v $volume:/data \
    ghcr.io/huggingface/text-generation-inference:3.3.5 --model-id $model
3. 关于共享内存(shm)的注意事项
NCCL 是 PyTorch 做分布式训练/推理时使用的通信框架,TGI 借助 NCCL 实现张量并行,从而大幅加速大模型推理。当 NCCL 无法通过 NVLink 或 PCI 在设备间点对点直连时,会回退到使用主机内存共享数据,因此上面命令中加了 --shm-size 1g。如果在 Kubernetes 中运行,可以通过声明一个内存型 emptyDir 卷并挂载到 /dev/shm 来提供共享内存:
- name: shm
  emptyDir:
   medium: Memory
   sizeLimit: 1Gi
也可以设置环境变量 NCCL_SHM_DISABLE=1 关闭共享内存,但官方提示这会影响性能。
4. 分布式追踪
TGI 内置了基于 OpenTelemetry 的分布式追踪能力,通过 --otlp-endpoint 参数指定 OTLP 收集器地址即可启用,还可以用 --otlp-service-name 覆盖默认服务名。
5. 本地源码安装
除了 Docker,也可以在本地安装。先克隆仓库:
git clone https://github.com/huggingface/text-generation-inference
cd text-generation-inference
然后安装 Rust,并创建至少 Python 3.9 的虚拟环境(以 3.11 为例):
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh

# 使用 conda
conda create -n text-generation-inference python=3.11
conda activate text-generation-inference

# 或使用 python venv
python3 -m venv .venv
source .venv/bin/activate
可能还需要安装 Protoc:
PROTOC_ZIP=protoc-21.12-linux-x86_64.zip
curl -OL https://github.com/protocolbuffers/protobuf/releases/download/v21.12/$PROTOC_ZIP
sudo unzip -o $PROTOC_ZIP -d /usr/local bin/protoc
sudo unzip -o $PROTOC_ZIP -d /usr/local 'include/*'
rm -f $PROTOC_ZIP
macOS 用户用 Homebrew 安装即可:brew install protobuf。之后执行编译安装并启动:
BUILD_EXTENSIONS=True make install # 安装仓库与带 CUDA 内核的 HF/transformer fork
text-generation-launcher --model-id mistralai/Mistral-7B-Instruct-v0.2
部分机器还需要 OpenSSL 库与 gcc,在 Linux 上可执行 sudo apt-get install libssl-dev gcc -y。
6. Nix 安装方式
另一种本地安装途径是使用 Nix,目前仅支持 x86_64 Linux 加 CUDA GPU。使用 Nix 时所有依赖都能从二进制缓存拉取,无需本地编译。先按指引安装 Cachix 并启用 Hugging Face 缓存,否则 Nix 会本地编译大量依赖、耗时数小时。之后即可用 nix run 启动 TGI:
cd text-generation-inference
nix run --extra-experimental-features nix-command --extra-experimental-features flakes . -- --model-id meta-llama/Llama-3.1-8B-Instruct
在非 NixOS 系统上使用 Nix,需要按官方说明做若干符号链接,让 Nix 包能找到 CUDA 驱动库。开发调试可使用 impure 开发环境 nix develop .#impure。
五、使用方法与核心特性
1. 启动服务
本地或容器启动后,实际推理命令很简单:
text-generation-launcher --model-id mistralai/Mistral-7B-Instruct-v0.2
启动器会自动完成权重下载、权重格式校验(优先使用 Safetensors)、根据 GPU 数量做张量并行切分,并在 8080 端口(容器内部为 80,映射到宿主机 8080)上对外提供 HTTP 推理接口。查看全部启动参数可运行 text-generation-launcher --help(源码见 launcher/src/main.rs),其中既包括 --model-id、--quantize 这类常用选项,也包括 --otlp-endpoint、--otlp-service-name 这类可观测性配置。
2. 发起文本生成请求
服务默认监听 8080 端口,/generate_stream 接口基于 SSE 做流式输出:
curl 127.0.0.1:8080/generate_stream \
    -X POST \
    -d '{"inputs":"What is Deep Learning?","parameters":{"max_new_tokens":20}}' \
    -H 'Content-Type: application/json'
也可以使用兼容 OpenAI Chat Completion 的 Messages API:
curl localhost:8080/v1/chat/completions \
    -X POST \
    -d '{
  "model": "tgi",
  "messages": [
    { "role": "system", "content": "You are a helpful assistant." },
    { "role": "user", "content": "What is deep learning?" }
  ],
  "stream": true,
  "max_tokens": 20
}' \
    -H 'Content-Type: application/json'
REST API 的 OpenAPI 文档可通过 /docs 路由查看,在线 Swagger UI 见 huggingface.github.io/text-generation-inference。
3. 核心特性逐条说明
README 列出的能力可以归纳为以下几类。在易用性方面,TGI 提供了简单的启动器,一条命令即可服务大多数主流大模型;在生产可用性方面,它内置了基于 OpenTelemetry 的分布式追踪与 Prometheus 指标暴露,方便接入现有监控体系。在性能方面,TGI 支持多 GPU 张量并行(Tensor Parallelism)来加速大模型推理,对进入服务的请求做连续批处理(continuous batching),从而显著提升整体吞吐;文本输出采用 Server-Sent Events(SSE)做 Token 流式返回,让客户端可以逐字接收结果而无需等待整段生成完毕。在兼容性方面,它提供了兼容 OpenAI Chat Completion 格式的 Messages API,方便把已有的 OpenAI 客户端直接切换到自建推理服务;同时针对主流模型架构,使用 Flash Attention 与 Paged Attention 对推理代码做了优化。
在量化与权重方面,TGI 支持多种量化方案以降低显存门槛,包括 bitsandbytes、GPT-Q、EETQ、AWQ、Marlin 以及 fp8;权重加载使用 Safetensors 格式,兼顾安全性与加载速度。在生成控制方面,TGI 内置了基于 A Watermark for Large Language Models 的文本水印,支持 logits 处理器(温度缩放、top-p、top-k、重复惩罚等,完整参数见 transformers.LogitsProcessor)、自定义停止序列(stop sequences)与对数概率(log probabilities)输出。此外,推测解码(Speculation)可以带来约 2 倍的延迟改善;Guidance/JSON 约束可以指定输出格式,在加速推理的同时保证输出符合约定的规范;TGI 还支持通过自定义提示词引导模型输出,并可直接加载经过微调的模型来完成特定任务、获得更高的准确率与表现。
4. 量化运行
TGI 既可以直接加载预先量化好的权重(AWQ、GPTQ、Marlin),也可以用 bitsandbytes、EETQ、fp8 在运行时动态量化,以降低显存占用:
text-generation-launcher --model-id mistralai/Mistral-7B-Instruct-v0.2 --quantize
4bit 量化可通过 bitsandbytes 的 NF4 与 FP4 数据类型启用,启动时传 --quantize bitsandbytes-nf4 或 --quantize bitsandbytes-fp4。更多量化细节见量化文档。
5. 优化架构与模型支持
TGI 对主流现代模型开箱即用,完整支持列表见支持模型列表。对于列表之外的其他架构,TGI 以尽力而为(best-effort)的方式支持,底层走 AutoModelForCausalLM.from_pretrained(<model>, device_map="auto") 或 AutoModelForSeq2SeqLM.from_pretrained(<model>, device_map="auto"),即借助 Hugging Face transformers 的自动设备映射来加载。这意味着只要模型在 transformers 生态中可用,通常也能被 TGI 直接拉起,只是未必享受到 Flash Attention、Paged Attention、推测解码等针对特定架构的深度优化。
六、开发与测试
如果需要从源码参与 TGI 的开发,可以分别启动 Python 推理服务与 Rust 路由进行调试:
make server-dev
make router-dev
测试命令覆盖了多个层面,README 给出的完整清单如下:
# python 服务端测试
make python-server-tests
# python 客户端测试
make python-client-tests
# 或同时跑服务端与客户端测试
make python-tests
# rust cargo 测试
make rust-tests
# 集成测试
make integration-tests
其中 server-dev 与 router-dev 分别对应推理服务和路由网关两个组件;nix develop .#impure 提供的开发环境里已经预装了 cargo、Python、Torch 等全部依赖,首次进入或更新 protobuf 后需要按 README 中的步骤重新用 grpc_tools 生成 Python 侧的 pb 代码。
七、常见问题 FAQ
- TGI 还在积极维护吗? 官方 README 已在顶部用醒目的 CAUTION 声明 TGI 进入维护模式,只接受小问题修复、文档改进与轻量维护类的 PR;新项目官方推荐使用 vLLM、SGLang,或 llama.cpp、MLX 等本地引擎。已有基于 TGI 的服务仍可继续运行,但新选型建议优先评估上述替代引擎。
- 没有 GPU 能跑吗? 可以,但需去掉
--gpus all并加--disable-custom-kernels,官方明确提示 CPU 并非本项目目标平台,性能会比较差,仅建议用于功能验证。 - Llama 等受限模型怎么下载? 先在 Hugging Face 网页上申请并通过该模型的访问许可,再到令牌页面创建一个具备 READ 权限的 CLI 令牌,通过环境变量
HF_TOKEN传入容器;容器内会自动用该令牌去 Hub 下载受保护权重。 - 多卡张量并行报错或显存共享异常怎么办? 检查 Docker 启动参数里的
--shm-size是否足够(官方示例为 1G);在 Kubernetes 下需要声明一个 medium 为 Memory 的 emptyDir 卷并挂载到/dev/shm;也可以临时用NCCL_SHM_DISABLE=1关闭共享内存来定位问题,但官方提示这会影响性能,不建议长期使用。 - 如何降低显存占用? 直接加载 AWQ、GPTQ、Marlin 等预量化权重,或在启动时加
--quantize,进一步可用 bitsandbytes-nf4、bitsandbytes-fp4、EETQ、fp8 等方式做 4bit 量化,从而在有限显存上运行更大参数的模型。 - 有没有兼容 OpenAI 的接口? 有。
/v1/chat/completions提供 Messages API,请求与响应格式与 OpenAI Chat Completion 兼容,可以直接把已基于 OpenAI SDK 编写的客户端地址切换到自建 TGI 服务。 - 如何查看全部启动参数? 运行
text-generation-launcher --help即可列出所有命令行选项,对应源码在仓库的 launcher/src/main.rs。 - 如何接入监控与链路追踪? TGI 内置 OpenTelemetry 分布式追踪,通过
--otlp-endpoint指向你的 OTLP 收集器即可开启,用--otlp-service-name可自定义服务名;同时内置 Prometheus 指标暴露,可直接接入 Prometheus 与 Grafana 体系。
八、跳转链接
- GitHub 仓库:huggingface/text-generation-inference
- 官方文档:Text Generation Inference Docs
- 在线 API 文档:Swagger UI
- 推荐替代引擎:vLLM 与 SGLang
- 支持模型列表:Supported Models
综合来看,TGI 是一套在 Hugging Face 生产环境里长期验证过的大模型推理服务器:它用 Docker 镜像即可拉起,支持流式输出、连续批处理、张量并行、多种量化方案以及兼容 OpenAI 的 Messages API,适合作为自建大模型服务的起点。需要提醒的是,官方已将 TGI 转入维护模式,全新项目建议优先评估 vLLM 与 SGLang;但对于已经在用 TGI、或需要与 Hugging Face 生态深度对接的团队,本文整理的 Docker 部署、私有模型令牌、共享内存调优与量化运行等步骤仍然适用。