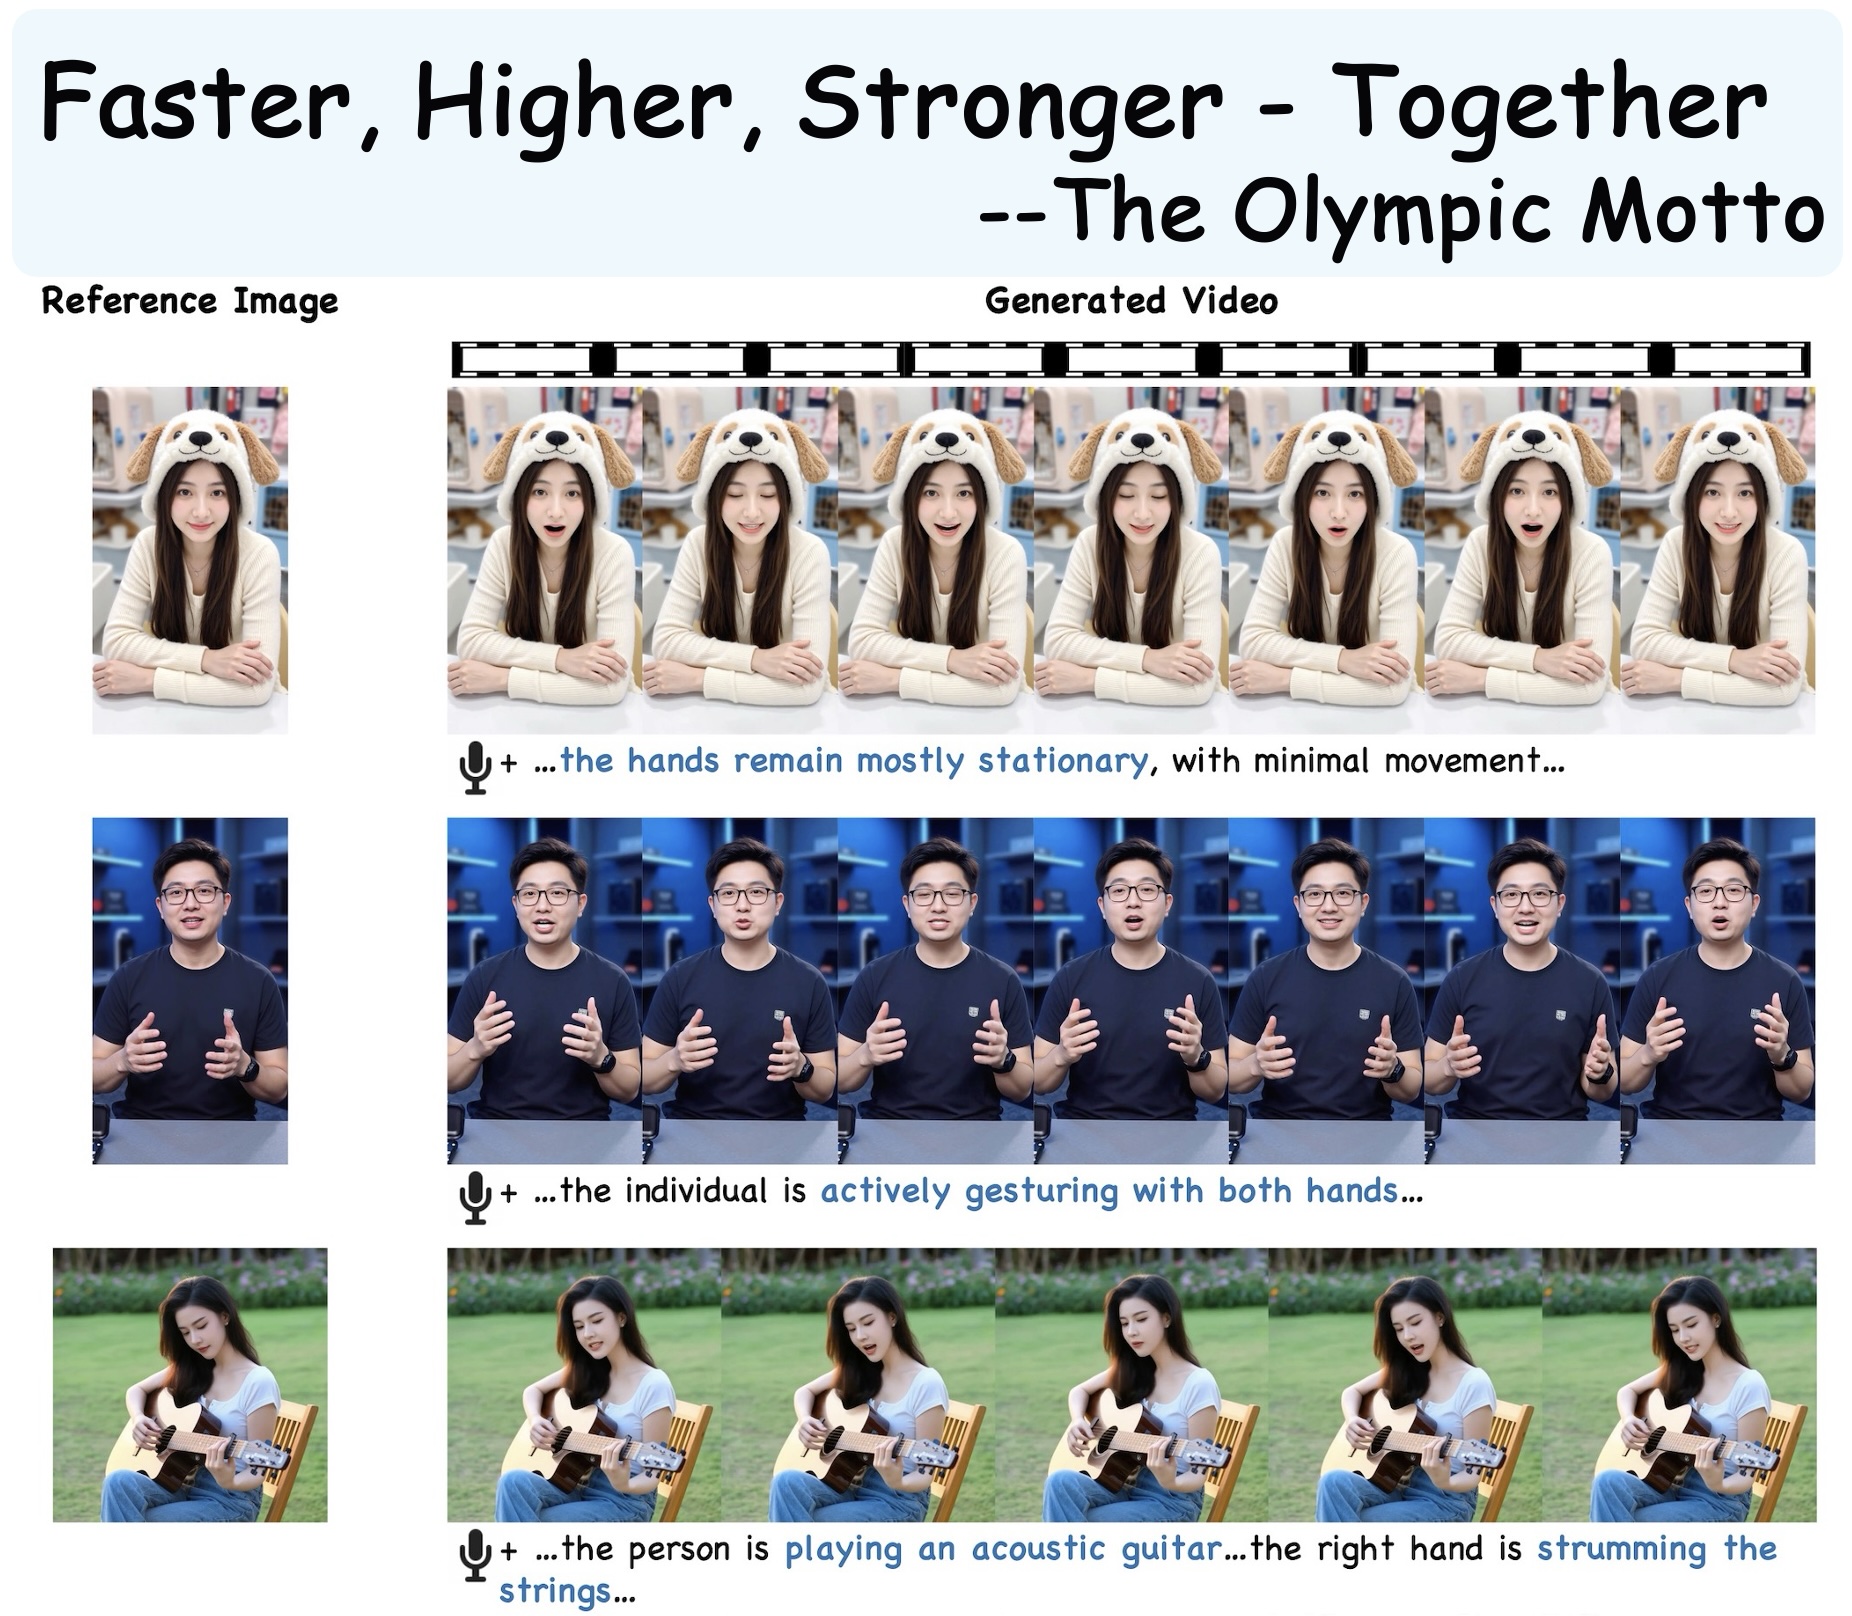
EchoMimicV3 保姆级部署教程:1.3B 参数蚂蚁开源统一多模态人体动画,12G 显存跑起来
EchoMimicV3(仓库 antgroup/echomimic_v3)是蚂蚁集团终端技术部(支付宝)EchoMimic 系列的第三代作品,论文标题《EchoMimicV3: 1.3B Parameters are All You Need for Unified Multi-Modal and Multi-Task Human Animation》,已被 AAAI 2026 接收。与第一代"单张照片+音频生成说话头像"不同,V3 把模型压到 1.3B 参数,做到了统一多模态输入、多任务输出:同一张模型权重既能做音频驱动说话头像,也能做半身人体动画,并且在 2026 年 1 月 22 日更新的 Flash 版本里把推理显存压到了 12GB、支持最高 768×768 分辨率、8 步快速出片。这意味着一张 3090/4070 级别的消费卡就能玩,而它的前身 V1/V2 动辄需要 A100 80G。
本文严格按官方 README 的 Quick Start 章节,带你在 Linux 上创建 conda 环境、安装依赖、从 HuggingFace/ModelScope 下载权重,跑通 Preview 版与 Flash 版两条推理链路,并附官方给出的全部调参经验。
一、项目介绍与适用场景
EchoMimicV3 基于 Wan2.1-Fun-V1.1-1.3B-InP 底座做微调,定位是"统一的多模态人体动画模型":输入一张人物图片 + 一段音频(或音频+文本提示),输出人物随音频说话、做动作的视频。官方给出两条产品线:
- EchoMimicV3-preview:完整质量版,用
wav2vec2-base-960h做音频编码器; - EchoMimicV3-flash-pro:快速版(2026.01.22 更新),用
chinese-wav2vec2-base做音频编码器,12G 显存、8 步生成、无需人脸掩码、最高 768×768。
适用场景:短视频口播数字人、课程虚拟讲师、电商带货数字人分身、基于真人形象的二创动画。对个人开发者而言,它最大的价值是"小显存也能跑高保真数字人视频",对企业则是可二次开发的开源底座(Apache-2.0)。
二、核心功能逐条拆解
- 音频驱动说话头像:输入人像 + 音频,输出唇形同步的说话视频(talking head)。
- 半身人体动画:同一权重支持 talking body,动作更丰富。
- 多模态输入统一:音频、文本提示、掩码(mask)统一在一个模型里处理。
- Flash 快速推理:8 步采样、12G 显存、768×768、无需人脸掩码。
- 量化 GradioUI:官方提供
app_mm.py量化版 Gradio 界面,16G 显存可跑。 - ComfyUI 集成:社区已出 ComfyUI 节点(smthemex/ComfyUI_EchoMimic),16G 显存可用。
- 长视频生成:超过 138 帧时可启用 Long Video CFG 分段生成。
- Win 一键包:官方提供量化版 Windows 一键安装包(百度网盘),不想折腾命令行的用户可直接用。
三、全套官方链接
| 类型 | 链接 |
|---|---|
| GitHub 仓库 | https://github.com/antgroup/echomimic_v3 |
| 官方文档 | 仓库 README(https://github.com/antgroup/echomimic_v3/blob/main/README.md) |
| 官方 Demo | ModelScope 在线 Studio:https://modelscope.cn/studios/BadToBest/EchoMimicV3 |
| License | Apache-2.0(官方 README "License"一节明确声明) |
四、硬件与环境前置要求
官方 README "Environment Setup" 一节原文:
- 测试系统:Centos 7.2 / Ubuntu 22.04,CUDA ≥ 12.1。
- 测试显卡:A100(80G) / RTX4090D(24G) / V100(16G)。
- Python 版本:3.10 / 3.11。
- Flash 版显存:官方 2026.01.22 更新明确——12G VRAM 即可,支持最高 768×768 分辨率。
- 权重体积:含底座 Wan2.1-Fun-1.3B-InP、音频编码器、扩散 Transformer 权重,磁盘预留约 30GB;下载需要能访问 HuggingFace 或 ModelScope(国内用户建议 ModelScope)。
注意:模型权重与代码同为 Apache-2.0,但底座 Wan2.1 与 wav2vec 系列权重各自有自己的许可,商用前需一并核对。
五、多平台部署步骤
官方提供 Windows 一键安装包 与 Linux 源码安装 两种方式;官方未提供 Docker 部署方式,本文不展开 Docker 小节。
5.1 Windows 部署
官方 README 原文:"Please use the one-click installation package (百度网盘链接,提取码 glut) to get started quickly for Quantified version." 即 Windows 用户直接下载官方量化版一键包解压即用,不需要手动配 Python 环境。官方未提供 Windows 下从源码安装的步骤,本文不展开。
5.2 Linux 源码部署(官方 Quick Start)
第 1 步:创建 conda 环境。
conda create -n echomimic_v3 python=3.10
conda activate echomimic_v3
解释:官方指定 Python 3.10,与测试环境一致;激活后后续 pip 都装在这个环境里。
第 2 步:克隆代码并安装依赖。
git clone https://github.com/antgroup/echomimic_v3.git
cd echomimic_v3
pip install -r requirements.txt
解释:官方 README "Other dependencies" 一节原文即 pip install -r requirements.txt,依赖清单以仓库内 requirements.txt 为准(含 PyTorch、diffusers、transformers 等,按官方锁定版本安装即可)。
第 3 步:下载并组织权重。
官方 "Model Preparation" 一节给出了 5 个权重的下载地址:
| 模型 | 下载地址 | 用途 |
|---|---|---|
| Wan2.1-Fun-V1.1-1.3B-InP | https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-1.3B-InP | 底座模型 |
| wav2vec2-base | https://huggingface.co/facebook/wav2vec2-base-960h | Preview 版音频编码器 |
| chinese-wav2vec2-base | https://modelscope.cn/models/TencentGameMate/chinese-wav2vec2-base | Flash 版音频编码器 |
| EchoMimicV3-preview | https://huggingface.co/BadToBest/EchoMimicV3 (或 ModelScope 同名仓库) | preview 权重 |
| EchoMimicV3-Flash | https://huggingface.co/BadToBest/EchoMimicV3/tree/main/echomimicv3-flash-pro | Flash 权重 |
按官方要求的目录结构摆放——Flash 版:
./flash/
├── Wan2.1-Fun-V1.1-1.3B-InP
├── chinese-wav2vec2-base
└── transformer
    └── diffusion_pytorch_model.safetensors
Preview 版:
./preview/
├── Wan2.1-Fun-V1.1-1.3B-InP
├── wav2vec2-base-960h
└── transformer
    └── diffusion_pytorch_model.safetensors
解释:两个子目录并存,transformer/diffusion_pytorch_model.safetensors 才是 EchoMimicV3 自己的权重,其余是底座与编码器。
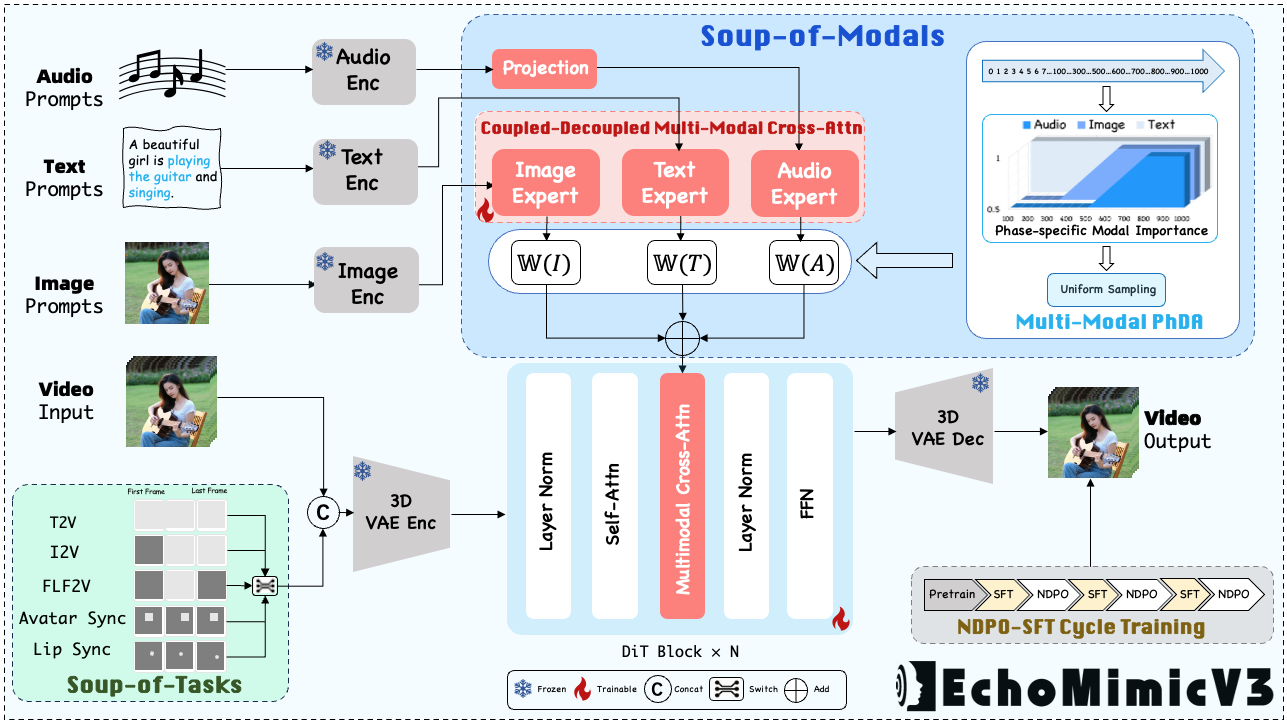
(官方 README 中的算法框架图,出处:asset/algo_framework.png)
5.3 Docker 部署
官方未提供 Docker 部署方式,本文不展开。
六、配置文件全部参数解释
官方 README "Tips" 一节明确给出了 5 个推理参数的最佳区间,这是该项目最重要的"配置表":
| 参数 | 作用 | 官方推荐区间 | 调大调小的效果 |
|---|---|---|---|
audio_guidance_scale(Audio CFG) |
音频引导强度 | 1.8 ~ 2 | 调大→唇形更准;调小→画面质量更好 |
guidance_scale(Text CFG) |
文本引导强度 | 3 ~ 6 | 调大→更贴合提示词;调小→画面质量更好 |
teacache_threshold(TeaCache) |
TeaCache 缓存阈值 | 0 ~ 0.1 | 用于加速采样的缓存策略 |
| 采样步数 | denoising steps | 说话头像 5 步;说话人体 15~25 步 | 步数越多越慢、细节越好 |
partial_video_length |
单段视频长度 | 可设 81、65 或更小 | 调小→显著降低显存占用 |
官方原文:"Long video generation: If you want to generate a video longer than 138 frames, you can use Long Video CFG." 超过 138 帧的长视频需要走 Long Video CFG 方案。其余参数官方未在 README 中展开,此处不臆造。
七、启动、后台常驻与开机自启
7.1 启动(Flash 版)
bash run_flash.sh
官方原文,启动后会按 flash/ 目录权重跑推理。
7.2 启动(Preview 版)
python infer_preview.py
7.3 启动(量化 GradioUI)
python app_mm.py
官方说明:这是量化版 Gradio 界面,16G 显存可运行;启动后终端会打印本地 http://127.0.0.1:7860 地址,浏览器打开即可。
7.4 后台常驻
命令行推理跑完即退出,属一次性任务;GradioUI 服务可用 nohup 常驻:
nohup python app_mm.py > app.log 2>&1 &
或用 systemd 托管(参考本文其他章节的 unit 写法,把 ExecStart 换成 conda run -n echomimic_v3 python /path/to/app_mm.py)。
7.5 修改端口
Gradio 默认 7860,如需改端口,启动时加参数(如 python app_mm.py --server_port=7861),官方 README 未明确给出该参数名,以 python app_mm.py --help 实际输出为准。
八、功能实操教程
第 1 步:确认权重目录结构与本文第五节完全一致,flash/ 与 preview/ 下都有 transformer/diffusion_pytorch_model.safetensors。
第 2 步:跑官方 demo。官方说明:images, audios, masks and prompts are provided in datasets/echomimicv3_demos——仓库自带示例图片、音频、掩码和提示词。
第 3 步:执行 Flash 快速推理 bash run_flash.sh。预期终端打印采样进度条(5 步 talking head),完成后在输出目录得到 mp4。
第 4 步:执行 Preview 推理 python infer_preview.py,对比 Flash 版画质差异。
第 5 步:打开 GradioUI python app_mm.py,浏览器上传自己的人像 + 音频,调 audio_guidance_scale 到 1.8~2、guidance_scale 到 3~6,点生成,观察唇形同步度。显存不够时把 partial_video_length 设到 65。
九、全套报错故障排查
-
CUDA out of memory原因:显存不足。Flash 版官方要求 12G,Preview 版更高。 解决:把partial_video_length设为 81、65 或更小(官方 Tips);切换到 Flash 版;用app_mm.py量化 GradioUI;关闭其他占显存的进程。 -
FileNotFoundError: diffusion_pytorch_model.safetensors原因:权重目录结构不对,文件没放在transformer/下。 解决:对照本文第五节的目录树检查,确保 Flash/Preview 两个子目录各自独立。 -
HuggingFace 下载超时 / 连不上 原因:国内网络访问 HF 不稳定。 解决:改用 ModelScope 镜像源(官方 ModelScope 链接:https://modelscope.cn/models/BadToBest/EchoMimicV3),或设置
export HF_ENDPOINT=https://hf-mirror.com。 -
CUDA 版本不匹配 原因:官方要求 CUDA ≥ 12.1。 解决:
nvcc --version检查;conda 环境内重装匹配 cu121 的 PyTorch;V100/A100 等较老卡以官方测试环境为准。 -
采样步数太高导致又慢又爆显存 原因:talking head 官方只要 5 步,talking body 才 15~25 步。 解决:头像任务用 5 步;不要盲目加大步数(官方 Tips 原文)。
十、升级、回滚与卸载
- 升级:
git pull拉最新代码,重新pip install -r requirements.txt;权重按官方更新说明重新下载(如 2026.01.22 的 Flash-pro 更新)。官方更新记录见 README "Updates" 一节。 - 回滚:
git checkout <旧tag>;权重建议单独备份flash/、preview/目录。 - 卸载:删除仓库目录与权重目录;
conda env remove -n echomimic_v3。
十一、商用许可与合规风险提示
- 代码与模型权重均为 Apache-2.0,官方明确"不对你生成的内容主张权利",但要求使用者自行对模型使用负责,不得用于违法、伤害他人、传播恶意信息等用途。
- 底座 Wan2.1-Fun-V1.1-1.3B-InP 与音频编码器 wav2vec2-base / chinese-wav2vec2-base 各有独立许可,商用前需单独核对各自 License 页。
- 克隆真人形象生成视频涉及肖像权与声音权,必须取得本人授权;注意防范深度伪造滥用风险。
参考链接
- 官方 README:https://github.com/antgroup/echomimic_v3/blob/main/README.md
- 论文:https://arxiv.org/abs/2507.03905
- 权重(HF):https://huggingface.co/BadToBest/EchoMimicV3
- 权重(ModelScope):https://modelscope.cn/models/BadToBest/EchoMimicV3
- 在线 Demo:https://modelscope.cn/studios/BadToBest/EchoMimicV3