LatentSync 保姆级部署教程:字节开源音频驱动潜空间唇形同步模型,8G 显存就能跑
LatentSync(仓库 bytedance/LatentSync)是字节跳动开源的端到端唇形同步(lip-sync)模型:给一段人物视频 + 一段新音频,它把人物的嘴型重新对齐到新音频上,输出"这个人说了另一段话"的视频。与 Wav2Lip 这类在像素空间做两阶段生成的老方法不同,LatentSync 直接在音频条件的潜空间扩散模型里建模音视频关联(基于 Stable Diffusion 体系),中间不经过任何显式的运动表示。项目从 2024 年 12 月首次发布到 2025 年 6 月连续迭代到 1.6 版(512×512 分辨率、缓解模糊问题),GitHub 6.2k+ Star。
它和之前本站写过的 Wav2Lip、MuseTalk 是同类但不同路线:LatentSync 官方数据显示 1.5 版推理只要 8GB 显存,对消费级显卡极其友好;本文按官方 README 把环境一键脚本、Gradio 界面、命令行推理、训练配置全部走一遍。
一、项目介绍与适用场景
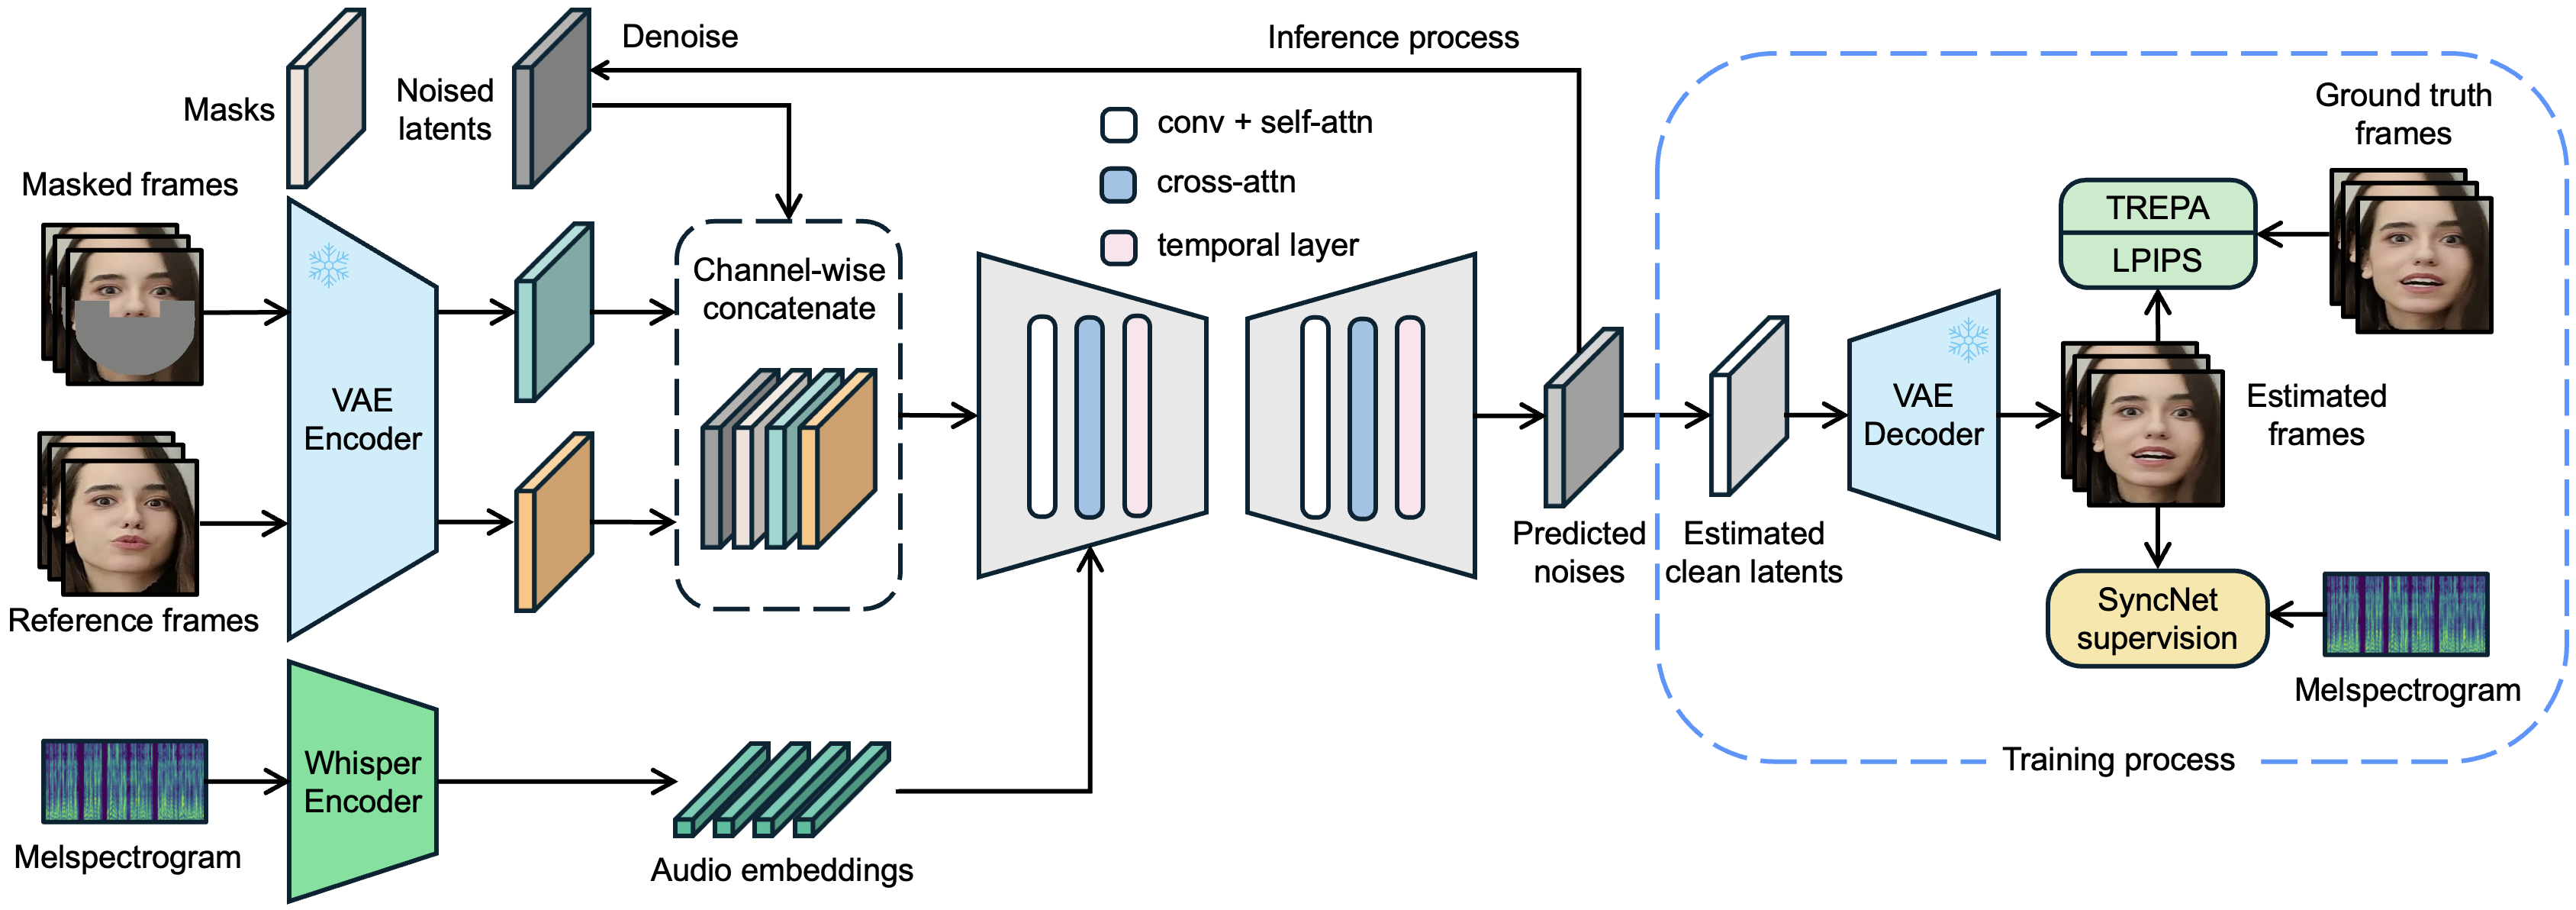
LatentSync 的定位是"音频条件潜扩散模型 + SyncNet 监督"的唇形同步框架:用 Whisper 把音频转成 mel 频谱嵌入,再通过 cross-attention 注入 U-Net,参考帧与遮罩帧和噪声潜空间拼接后送入扩散,最后解码成视频。官方同时开源了推理代码、数据处理流水线、训练代码三部分。
典型场景:给已有视频换配音 / 换语言(比如把英文口型视频换成中文口型)、口播视频后期改词、影视配音对上嘴型、虚拟主播视频的音频对齐。个人本地用它,一张 8G 显存的卡就能跑 1.5 版。
二、核心功能逐条拆解
- 端到端唇形同步:音频驱动潜扩散模型直接生成对齐嘴型的视频,无需中间运动表示。
- 8G 低显存推理:LatentSync 1.5 版最低 8GB 显存;1.6 版 18GB(512×512)。
- Gradio 图形界面:
python gradio_app.py起可视化界面上传视频音频。 - 命令行批量推理:
./inference.sh脚本化跑批。 - 可调推理参数:
inference_steps(20-50)、guidance_scale(1.0-3.0)。 - 完整数据处理流水线:5 步脚本做场景检测、人脸仿射对齐、质量筛选。
- U-Net 训练:官方提供 5 个 stage 配置文件,从 20G 到 55G 显存覆盖。
- SyncNet 训练与评测:官方开源 94% 准确率的 SyncNet 权重,可评测同步置信度。
三、全套官方链接
| 类型 | 链接 |
|---|---|
| GitHub 仓库 | https://github.com/bytedance/LatentSync |
| 官方文档 | 仓库 README(https://github.com/bytedance/LatentSync/blob/main/README.md) |
| 官方 Demo | HuggingFace Space:https://huggingface.co/spaces/fffiloni/LatentSync |
| License | Apache-2.0 |
四、硬件与环境前置要求
官方 README 明确给出的显存门槛:
- 推理最低显存:LatentSync 1.5 版 8 GB;1.6 版(512×512)18 GB。
- 训练显存(官方配置表):stage1 23GB;stage2 30GB;stage2_efficient 20GB(官方点名 RTX 3090 可用);stage1_512 30GB;stage2_512 55GB。
- 依赖:Python 环境 + ffmpeg;权重通过官方
setup_env.sh一键下载。 - 权重:
checkpoints/latentsync_unet.pt+checkpoints/whisper/tiny.pt,官方 HF 仓库ByteDance/LatentSync-1.6。
五、多平台部署步骤
官方只提供源码部署(一个 setup 脚本装环境 + 下权重),未提供 Docker,本文不展开 Docker 小节。
5.1 源码部署
第 1 步:克隆仓库。
git clone https://github.com/bytedance/LatentSync.git
cd LatentSync
第 2 步:一键装环境并下载权重。
source setup_env.sh
官方 README 原文:"Install the required packages and download the checkpoints via: source setup_env.sh"。这个脚本会创建/激活 conda 环境、安装 pip 依赖、并从 HuggingFace 下载权重。成功后 checkpoints/ 目录应为:
./checkpoints/
|-- latentsync_unet.pt
|-- whisper
|   `-- tiny.pt
解释:latentsync_unet.pt 是 LatentSync 主权重,whisper/tiny.pt 是音频编码器。如果自动下载失败,可手动到 https://huggingface.co/ByteDance/LatentSync-1.6 下载这两个文件放到对应位置。
5.2 Docker 部署
官方未提供 Docker 部署方式,本文不展开。
六、配置文件全部参数解释
官方 README "Inference" 一节给出两个可调推理参数:
| 参数 | 作用 | 官方区间 | 调大效果 | 来源 |
|---|---|---|---|---|
inference_steps |
扩散采样步数 | 20 ~ 50 | 画面质量更好但更慢 | README "Inference" |
guidance_scale |
引导强度 | 1.0 ~ 3.0 | 唇形更准但可能画面抖动/失真 | 同上 |
训练配置方面,官方在 configs/unet/ 目录下提供 5 个 yaml,对应显存如第四节所列。官方未在 README 中逐字段展开 yaml 内部参数,此处不臆造。
七、启动、后台常驻与开机自启
7.1 启动 Gradio 界面
python gradio_app.py
预期:终端打印 Gradio 本地地址(默认 7860),浏览器打开后上传视频和音频即可。
7.2 命令行推理
./inference.sh
解释:官方 CLI 入口,按脚本内指定的输入输出路径批量跑。
7.3 后台常驻
Gradio 服务可用 nohup:
nohup python gradio_app.py > gradio.log 2>&1 &
或写 systemd unit(把 ExecStart 指向 conda run -n <env> python /path/to/gradio_app.py),systemctl enable 开机自启。
7.4 修改端口
Gradio 启动时加 --server_port(如 --server_port=7861),以 python gradio_app.py --help 为准。
八、功能实操教程
第 1 步:确认 source setup_env.sh 跑通,checkpoints/ 下两个文件就位。
第 2 步:启动 Gradio python gradio_app.py,浏览器打开。
第 3 步:上传一段人物正面视频(mp4)和一段新音频(wav/mp3),先把 inference_steps 设 30、guidance_scale 设 2.0,点生成。
第 4 步:观察输出视频——嘴型应与新音频对齐。不满意时把 guidance_scale 提到 3.0 看唇形是否更紧,注意画面是否抖动(官方提示 guidance 过高会失真)。
第 5 步:切命令行跑批——编辑 inference.sh 里的输入路径,执行 ./inference.sh。
第 6 步(可选):评测同步质量——官方提供:
./eval/eval_sync_conf.sh
计算生成视频的 sync confidence score,验证唇形对齐好坏。
第 7 步(可选,训练党):如果你要自己训 U-Net,先按官方 5 步数据流水线处理数据:
./data_processing_pipeline.sh
然后用官方预训练 SyncNet(94% 准确率):
huggingface-cli download ByteDance/LatentSync-1.6 stable_syncnet.pt --local-dir checkpoints
再按显存选配置——stage1 23G、stage2_efficient 20G(RTX 3090 可跑)、stage2 30G、512 分辨率的 stage2_512 要 55G:
./train_unet.sh
官方提示要先在 configs/unet/*.yaml 里改数据目录、checkpoint 保存路径、训练超参;写数据文件列表用:
python -m tools.write_fileslist
九、全套报错故障排查
-
OOM / CUDA out of memory原因:1.6 版要 18G,1.5 版 8G。 解决:显存不够切回 1.5 权重;降低分辨率;inference_steps调小。 -
权重下载失败 /
latentsync_unet.pt不存在 原因:setup_env.sh中途断网。 解决:手动从 https://huggingface.co/ByteDance/LatentSync-1.6 下载latentsync_unet.pt与tiny.pt,放到checkpoints/与checkpoints/whisper/。 -
ffmpeg not found原因:系统缺 ffmpeg。 解决:sudo apt install ffmpeg(Ubuntu)或官网下载 Windows 版加入 PATH。 -
生成视频嘴型对不上 / 画面模糊 原因:guidance 太低或步数太少;1.5 版本身在 512 上偏糊。 解决:
guidance_scale提到 2.5~3.0;inference_steps提到 40~50;追求清晰度用 1.6 的 512 权重(需 18G 显存)。 -
训练时数据流水线报错 原因:官方要求先跑
./data_processing_pipeline.sh,且要改input_dir。 解决:编辑脚本里的input_dir指向数据目录;按官方 5 步流程(去损坏→25fps/16k 重采样→场景检测→5-10s 切段→人脸仿射对齐)逐步排查。
十、升级、回滚与卸载
- 升级:
git pull;按官方 changelog(docs/changelog_v1.5.md、changelog_v1.6.md)重新下载对应版本权重;pip install -r重装依赖。 - 回滚:
git checkout <旧tag>;权重保留多版本目录(1.5 / 1.6 分目录)。 - 卸载:删除仓库目录、
checkpoints/;conda env remove。
十一、商用许可与合规风险提示
- 代码与权重为 Apache-2.0,允许商用、修改、分发。
- 官方致谢部分明确代码基于 AnimateDiff 构建,并借鉴了 MuseTalk、Wav2Lip、StyleSync、SyncNet 等,各自开源协议需一并遵守。
- 唇形同步技术有天然的深度伪造滥用风险:必须对真实人物的音视频使用取得本人授权,不得用于冒充他人、虚假宣传等违法用途。
参考链接
- 官方 README:https://github.com/bytedance/LatentSync/blob/main/README.md
- 权重(HF):https://huggingface.co/ByteDance/LatentSync-1.6
- 论文:https://arxiv.org/abs/2412.09262
- 在线 Demo:https://huggingface.co/spaces/fffiloni/LatentSync