
zstd 快速压缩算法部署指南

一、项目介绍
Zstandard 简称 zstd,是由 Meta 公司开发的快速无损压缩算法,目标是在 zlib 级别的压缩速度下提供更好的压缩比。它由快速熵编码阶段提供支撑,格式稳定并已被标准化为互联网标准文档。zstd 提供 C 语言参考实现,以 BSD 或 GPLv2 双重许可证发布。项目同时提供命令行工具,可以生成和解码多种压缩格式的文件。zstd 已在 Meta 内部和众多大型云基础设施中部署,用于压缩海量数据,并持续通过 Google 模糊测试项目进行安全测试。
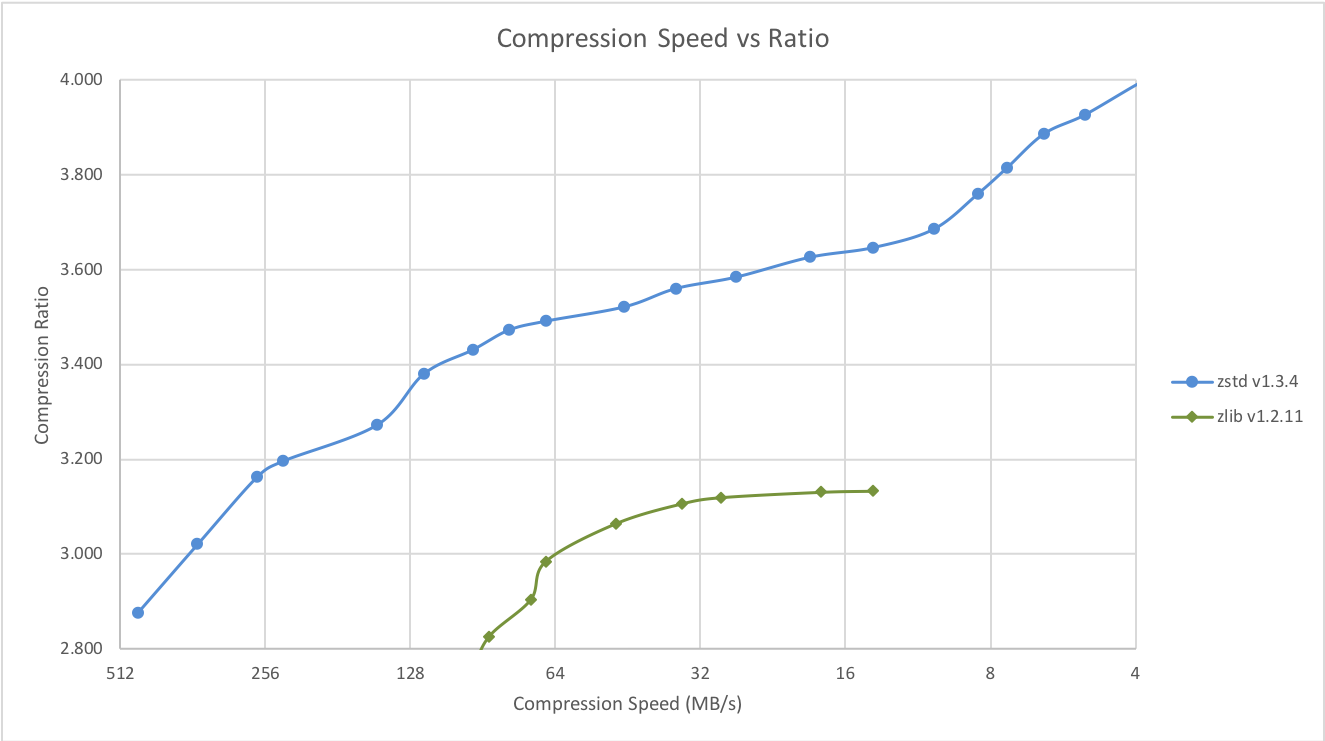
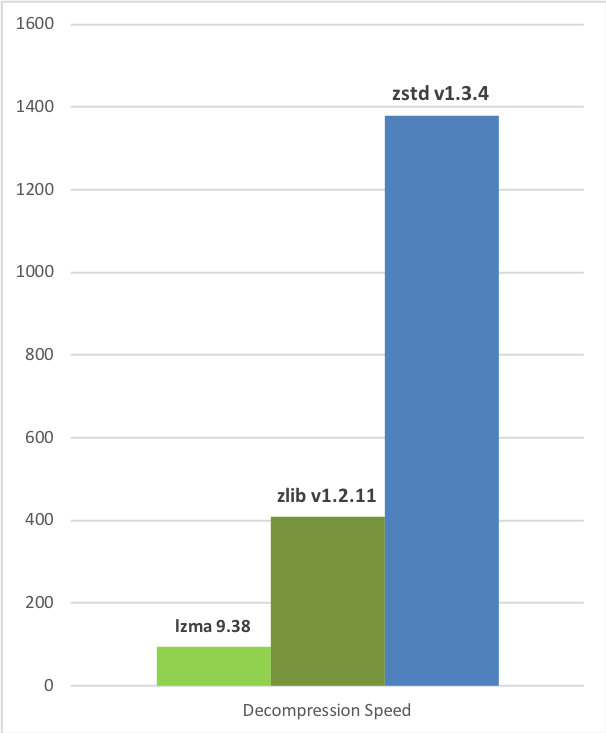
zstd 的核心优势在于速度与压缩比的灵活平衡:压缩级别从负级别到二十二级可调,用户可以根据场景选择最合适的平衡点。解压速度在所有压缩级别下保持一致,这是 LZ 系列压缩算法的共同特性。对于 KB 级别的小数据,zstd 提供训练模式,通过字典训练大幅提升小数据压缩率。zstd 还支持多线程压缩、长距离匹配、字典加载等高级特性,适合各种数据压缩场景。
二、官方信息
| 项目 | 信息 |
|---|---|
| 仓库地址 | github.com/facebook/zstd |
| 官方网站 | facebook.github.io/zstd |
| Star 数量 | 约 23,000+ |
| 最近更新 | 2026-08-15 |
| 开发语言 | C |
| 开源协议 | BSD OR GPLv2 |
| 标准文档 | RFC 8878 |
三、项目结构与核心特性
zstd 仓库主要目录包括库实现目录、命令行工具目录、文档目录、测试目录和构建支持目录。库实现目录包含压缩和解压核心算法。命令行工具目录提供用户界面。
核心特性包括:速度可调的压缩级别、小数据字典训练、多格式支持、多语言绑定、多构建系统支持、内存压缩。
四、环境与版本要求
系统要求:Linux、macOS、Windows 均可运行。编译器支持 C89 核心库和 C99 命令行工具。核心库零依赖,纯 C 实现。
五、本地部署步骤
方式一:包管理器安装
使用系统包管理器安装 zstd 包和开发包。在 Debian/Ubuntu 上安装 zstd 和 libzstd-dev。在红帽系系统上安装 zstd 和 libzstd-devel。在 macOS 上使用 Homebrew 安装。
方式二:源码编译
克隆仓库后直接使用 make 编译,生成命令行工具和库文件。运行测试验证正确性,然后安装到系统。还支持 CMake、Meson、VCPKG、Conan 等多种构建方式。
启动验证
执行版本检查命令确认安装成功。测试压缩和解压缩流程:创建测试文件,压缩生成压缩包,然后解压还原,验证数据完整性。
六、API 用法与示例
命令行常用操作包括压缩文件、删除原文件、指定压缩级别、最快压缩、解压、解压到标准输出、压缩目录等。字典训练模式包括训练字典、使用字典压缩、使用字典解压三步流程。C 语言库 API 提供压缩和解压函数。
七、常见问题 FAQ
Q1:zstd 和 gzip 有什么区别?
zstd 在相似压缩比下速度更快,压缩级别可调范围更大。现代 Linux 发行版已将 zstd 用于内核和软件包压缩。
Q2:如何在脚本中使用 zstd 替代 gzip?
命令参数类似。配合 tar 使用时指定压缩程序。
Q3:如何生成静态链接版本?
使用 Makefile 静态选项或 CMake 关闭共享库选项。
Q4:小数据压缩效果差怎么办?
使用字典训练模式,收集同类样本训练字典。
Q5:zstd 支持多线程吗?
支持,使用自动线程数选项。
Q6:zstd 的压缩级别怎么选?
一级默认平衡速度和压缩比,负级别最快,十九级以上最高压缩比。
zstd 是由 Meta 公司的工程师发明的快速无损压缩算法。它的设计目标是在保持与 zlib 相当甚至更好的压缩比的同时,提供显著更快的压缩速度和解压速度。zstd 的核心算法基于 LZ77 变体和熵编码,通过快速的匹配查找和高效的熵编码实现了速度和压缩比的良好平衡。zstd 格式已经被标准化为互联网标准文档,得到了广泛的行业认可和采用。
zstd 在 Meta 内部被广泛部署,用于压缩海量的用户数据和日志。经过大规模生产环境的验证,zstd 的稳定性和性能表现都非常出色。它还持续通过模糊测试项目进行安全测试,确保压缩和解压过程不会出现安全漏洞。许多大型云基础设施和数据库系统也采用了 zstd 作为数据压缩格式,包括 PostgreSQL 数据库、Apache 基础设施等。
zstd 的一个重要特性是支持字典训练模式。对于 KB 级别的小数据,传统的通用压缩算法效果很差,因为它们需要从数据中学习冗余模式。而 zstd 的字典训练模式可以通过收集一批相似的样本数据,训练出一个通用的字典,然后在压缩单个小数据时使用这个字典。这种方式可以大幅提升小数据的压缩率,特别适合压缩大量相似的小对象,比如日志记录、消息队列中的消息、缓存条目等场景。
zstd 还支持多线程压缩,可以利用多核 CPU 并行压缩数据。压缩级别范围非常宽,从负五级到二十二级,用户可以根据场景灵活选择。负级别牺牲压缩比换取极致速度,适合实时压缩场景。高压缩比级别适合归档和存储场景。解压速度在所有级别下都保持一致,这是 LZ 系列算法的共同特性,因为解压过程比压缩简单得多。
zstd 的命令行工具设计简洁,与 gzip 和 xz 等传统压缩工具的使用方式类似。用户可以很容易地从现有工具迁移到 zstd。压缩和解压缩命令的基本语法与 gzip 几乎一样,只是将命令名换成 zstd。这种设计让用户学习成本很低,不需要重新学习一套全新的命令行语法。
zstd 在实际生产环境中有很多应用场景。数据库系统使用 zstd 压缩存储的数据表,在读取性能和存储成本之间取得平衡。日志系统使用 zstd 压缩历史日志,减少磁盘占用。容器镜像使用 zstd 格式,加快镜像拉取速度。软件包使用 zstd 压缩,加快下载和安装速度。这些场景都利用了 zstd 速度快、压缩比适中的特点。
zstd 的字典训练功能在实际使用中有一些最佳实践。首先,训练样本应该尽可能代表实际要压缩的数据,样本数量建议在几十到几百个之间。其次,字典大小需要根据数据大小调整,太小的字典效果有限,太大的字典会增加内存开销。第三,训练好的字典需要和压缩数据一起保存,解压时需要使用相同的字典。这种字典模式特别适合压缩大量相似的小数据,比如微服务架构中的请求日志。
zstd 还提供了 C 语言编程库,开发者可以在自己的程序中集成 zstd 压缩功能。库的 API 设计简洁,基本流程是初始化压缩上下文、压缩数据、清理资源。流式压缩支持分块压缩大文件,不需要一次性加载全部数据到内存。这种流式接口非常适合处理大文件和网络数据流。zstd 库被许多编程语言绑定,包括 Python、Go、Java 等,开发者可以在自己熟悉的语言中使用 zstd。
zstd 的性能特点是压缩速度和压缩比可以灵活权衡。压缩级别从负五级到二十二级可调,负级别使用快速压缩算法,牺牲压缩比换取速度,适合实时压缩场景。高压缩比级别使用更复杂的算法,适合归档和冷存储场景。解压速度在所有级别下都很快,因为解压算法本身很简单。这种不对称的设计让 zstd 特别适合一次压缩多次解压的场景,比如软件分发和数据备份。
zstd 项目的发展也很活跃。它最初由 Meta 的工程师开发,现在由开源社区维护。项目定期发布新版本,持续改进压缩速度和压缩比。zstd 还与 Linux 内核社区合作,将 zstd 作为内核镜像和 initramfs 的压缩格式。这种深度集成让 zstd 成为 Linux 生态中重要的压缩工具。zstd 的格式设计预留了扩展空间,未来可以添加新的压缩算法而不破坏向后兼容性。
zstd 的内存压缩模式也是一个重要特性。除了压缩文件之外,zstd 还可以压缩内存中的数据,用于减少内存占用。这种内存压缩技术在数据库和缓存系统中特别有用,可以在不增加物理内存的情况下存储更多数据。zstd 的内存压缩速度很快,不会成为性能瓶颈。许多数据库系统已经集成了 zstd 的内存压缩功能。
zstd 还提供了训练好的字典库,可以直接下载使用。对于常见的数据类型,比如日志、JSON 数据、文本文件等,社区提供了预训练的字典,可以直接使用而不需要自己训练。这些字典由社区维护和优化,效果很好。用户可以根据自己的数据类型选择合适的字典,快速获得更好的压缩率。
zstd 的命令行工具还支持一些实用功能。比如可以查看压缩文件的元数据,包括压缩级别、字典 ID、原始大小等。可以测试压缩和解压缩的性能,统计压缩率和速度。这些功能帮助用户评估压缩效果,选择最合适的压缩级别。zstd 还支持与其他压缩工具的互操作,可以解压缩其他格式的文件。
zstd 在容器技术中也有重要应用。Docker 和 OCI 镜像可以使用 zstd 格式压缩,相比传统的 gzip 压缩,zstd 的解压速度更快,可以显著加快容器启动速度。许多云服务商已经支持 zstd 格式的容器镜像,用户可以直接使用。这种快速解压能力对于大规模容器部署场景非常有价值。
zstd 的算法设计有一些独特之处。它的匹配查找使用了快速哈希表,在速度和压缩率之间取得平衡。熵编码使用了高精度的自适应范围编码,比传统的哈夫曼编码效率更高。这些算法设计让 zstd 在同等压缩级别下比其他算法更快或更压缩。zstd 还支持长距离匹配,可以找到跨越大距离的重复模式,提高压缩率。
zstd 的命令行工具还支持一些高级功能。比如可以指定字典文件进行压缩和解压缩,可以显示压缩进度,可以测试文件完整性。这些功能让 zstd 不仅是一个压缩工具,也是一个完整的数据处理工具。zstd 还支持与 tar 命令配合使用,可以创建和解压压缩归档。
zstd 的性能在实际测试中表现出色。在相同压缩级别下,zstd 的压缩速度通常比 gzip 快三到五倍,解压速度快五到十倍。压缩比与 gzip 相当或更好。这种速度优势让 zstd 适合在大数据场景中使用,压缩和解压缩的时间成本很低。zstd 还支持多核并行,可以利用现代 CPU 的多核架构进一步提高压缩速度。