

MiniMax H3:全能多模态音视频生成模型 · 本地部署与使用最全指南

一句话定位:MiniMax H3 是 MiniMax 于 2026 年 8 月 3 日开源的通用全模态(omni-modal)生成系统——一次生成同时产出视频 + 同步立体声音频,原生支持最高 2K 分辨率、最长 15 秒,具备多模态上下文理解能力,开源权重免费、可商用(附条款)。
开源地址:Hugging Face
MiniMaxAI/MiniMax-H3· 魔搭社区MiniMaxAI/MiniMax-H3· GitHubMiniMax-AI/MiniMax-H3许可证:MiniMax H3 Community License(社区许可,免版税商用,详见第十二章)
目录
- 一、官方跳转与下载链接
- 二、模型简介与核心能力
- 三、模型规格与输入输出
- 四、系统架构详解
- 五、硬件环境要求
- 六、部署路径总览
- 七、ComfyUI 本地部署(新手最快路径)
- 八、SGLang 自托管 API 部署
- 九、Diffusers 加载与使用
- 十、使用教程:四种玩法详解
- 十一、完整 2K 工作流(本地 + API 组合)
- 十二、许可证与合规说明
- 十三、常见问题排查
- 十四、参考链接汇总
一、官方跳转与下载链接
1.1 开源资源
| 资源 | 链接 |
|---|---|
| Hugging Face 权重仓库 | https://huggingface.co/MiniMaxAI/MiniMax-H3 |
| 魔搭社区(ModelScope) | https://modelscope.cn/models/MiniMaxAI/MiniMax-H3 |
| GitHub 官方源码仓库 | https://github.com/MiniMax-AI/MiniMax-H3 |
| 源码 ZIP 打包下载 | https://github.com/MiniMax-AI/MiniMax-H3/archive/refs/heads/main.zip |
1.2 在线使用(无需部署)
| 资源 | 链接 |
|---|---|
| 在线 API(国际版) | https://platform.minimax.io/docs/api-reference/video-generation-v2-create |
| 在线 API(国内版) | https://platform.minimaxi.com/docs/api-reference/video-generation-v2-create |
| Web App(国际版) | https://hailuoai.video/tools/minimax-h3 |
| Web App(国内版) | https://hailuoai.com/ |
| 桌面端(国际版) | https://hub.minimax.io/ |
| 桌面端(国内版) | https://hub.minimaxi.com/ |
| 官方定价页 | https://minimax.io/price |
1.3 官方文档与社区
| 资源 | 链接 |
|---|---|
| H3 中文教程页(MiniMax Design) | https://design.minimaxi.com/h3 |
| 本地部署文档(中文) | https://platform.minimaxi.com/docs/guides/local-deploy-h3 |
| 本地部署文档(英文) | https://platform.minimax.io/docs/guides/local-deploy-h3 |
| 官方 Discord 社区 | https://discord.com/invite/MiniMax |
| 官方 X 账号 | https://x.com/MiniMax_AI |
| 联系邮箱 | model@minimax.io |
二、模型简介与核心能力
2.1 这是什么
MiniMax H3 是一个通用全模态生成系统:它统一理解由文本、图像、视频、音频组成的多模态上下文,并同时生成带原生立体声音频的视频。得益于面向任务泛化的系统设计,H3 在预训练阶段就具备了广泛的多模态上下文理解与生成能力,能够出色地执行复杂的多模态指令。
2.2 核心能力一览
| 能力 | 说明 |
|---|---|
| 🎬 文本生视频(T2VA) | 纯文本提示词直接生成音视频 |
| 🖼️ 首/尾帧控制(FL2VA) | 支持 0/1/2 张输入图:无图=文生视频、1 图=首帧或尾帧生视频、2 图=首尾帧生视频 |
| 📎 全参照生成(Ref2VA) | 最多 9 张图 + 3 段视频 + 3 段音频混合参照,用于角色一致性、视频编辑、动作参照、镜头续写 |
| 🔊 原生立体声音频 | 视频与 32kHz 立体声同步生成,人物说话口型与声音天然对齐 |
| 🔄 2K 重生成(H3-Regenerate-2K) | 把 768p 结果连同原始上下文送回模型,以原生 2K 重生成,细节更精 |
| 🧠 智能上下文理解(H3-Context-IR) | 把文/图/视频/音频指令精炼成模型最吃得动的表示,同样的 prompt 出更好的结果 |
2.3 开源权重的三个组成部分
完整 H3 系统包含三个模块,其中两个已开源、一个提供 API:
| 模块 | 状态 | 作用 |
|---|---|---|
| H3-Context-IR | 未开源(走 API) | 理解并精炼多模态输入指令 → 输出结构化的 Context 表示 |
| H3-Base | ✅ 开源 | 基于 Context 表示联合生成 768p 视频 + 立体声音频 |
| H3-Regenerate-2K | 未开源(走 API) | 把 768p 结果 + 原始上下文送回模型,2K 重生成 |
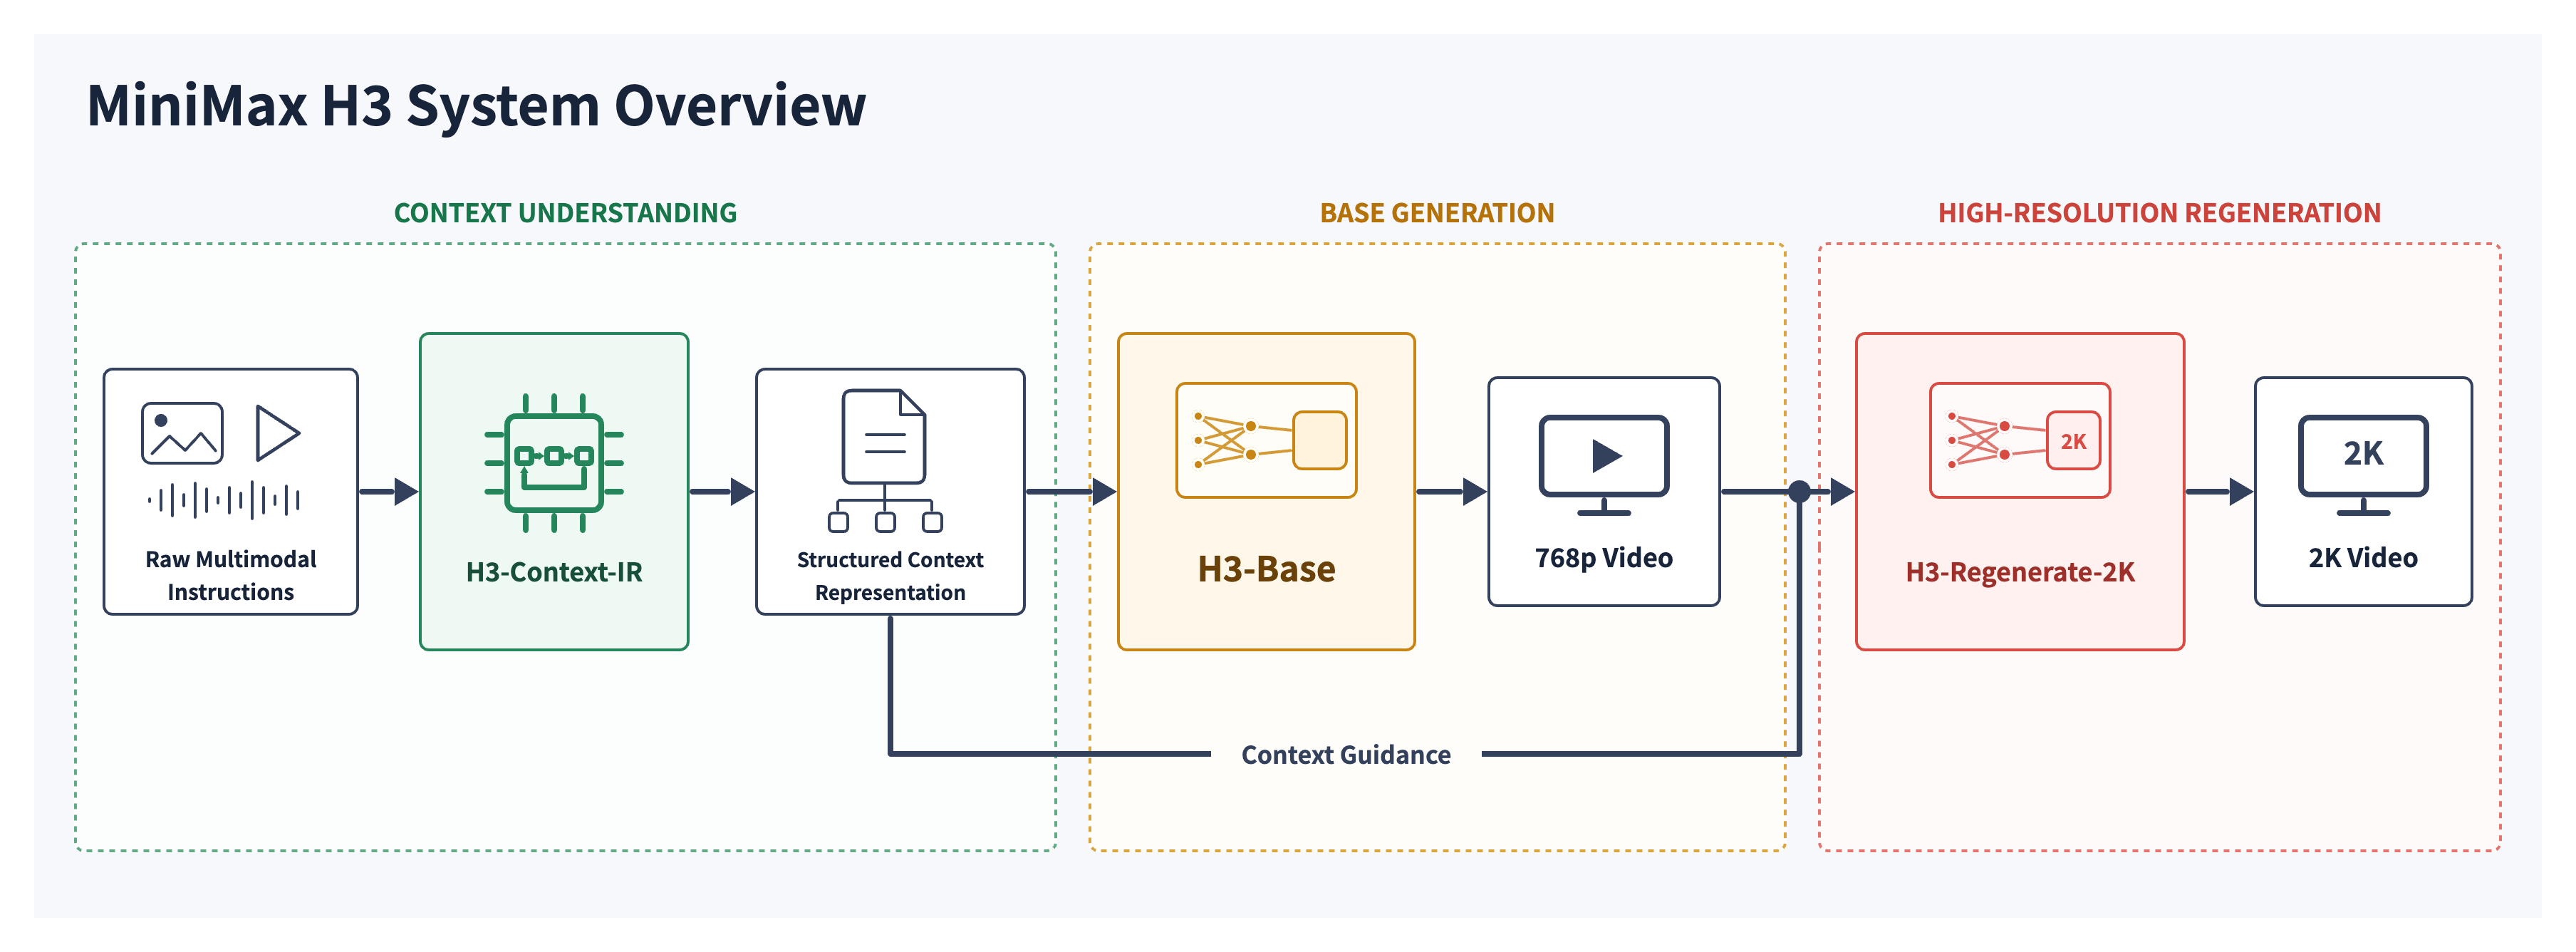
▲ 图 1:H3 完整系统三段式流程——Context Understanding(上下文理解)→ Base Generation(768p 基础生成)→ High-Resolution Regeneration(2K 高分辨率再生)
三、模型规格与输入输出
3.1 输出规格(官方)
| 项目 | 规格 |
|---|---|
| 输出时长 | 4–15 秒 |
| 输出宽高比 | 支持 21:9、16:9、4:3、1:1、3:4、9:16 等广泛比例 |
| 输出分辨率 | 多种分辨率;开源权重默认短边 768 像素;API 最高 2K |
| 输出帧率 | 24 FPS |
| 输出音频 | 32 kHz 立体声 |
| 对白语言 | 稳定支持 11 种:阿拉伯语、中文、英语、法语、德语、意大利语、日语、韩语、葡萄牙语、俄语、西班牙语;其他语言也支持(程度不一) |
3.2 两个模型变体(Checkpoint)
| 变体 | 输入模式 | 规格 |
|---|---|---|
| H3-Base-FL2VA | 首/尾帧模式 | 支持 0、1、2 张输入图:无图=文生视频;1 图=首帧或尾帧生视频;2 图=首尾帧生视频 |
| H3-Base-Ref2VA | 全参照模式 | 图片 ≤9 张;视频 ≤3 段(每段 2–15 秒,总时长 ≤15 秒);音频 ≤3 段(每段 2–15 秒,总时长 ≤15 秒);混合输入文件总数 ≤12 |
⚠️ T2V 和 I2V 使用 FL2VA 扩散模型;R2V 需要独立的 Ref2VA 扩散模型,两者不能互换。
3.3 模型参数(开源权重)
| 组件 | 参数 |
|---|---|
| H3-Omni-Transformer | 33B 参数稠密单流 Transformer,其中约 13B 位于 AdaLN 相关分支(推理时可缓存预计算、无需加载) |
| H3-Encoder | Qwen3-VL-32B 全量预训练权重,取其第 50 层隐状态 |
| H3-VisualVAE | 时序因果视频自编码器,空间压缩 16×、时间压缩 4×、24 通道(f16t4d24) |
| H3-AudioVAE | 左右声道共用同一编解码器,32kHz 音频压缩为 40Hz 速率的潜变量 token |
| 权重精度 | BF16(官方混合 BF16/FP32 checkpoint) |
四、系统架构详解
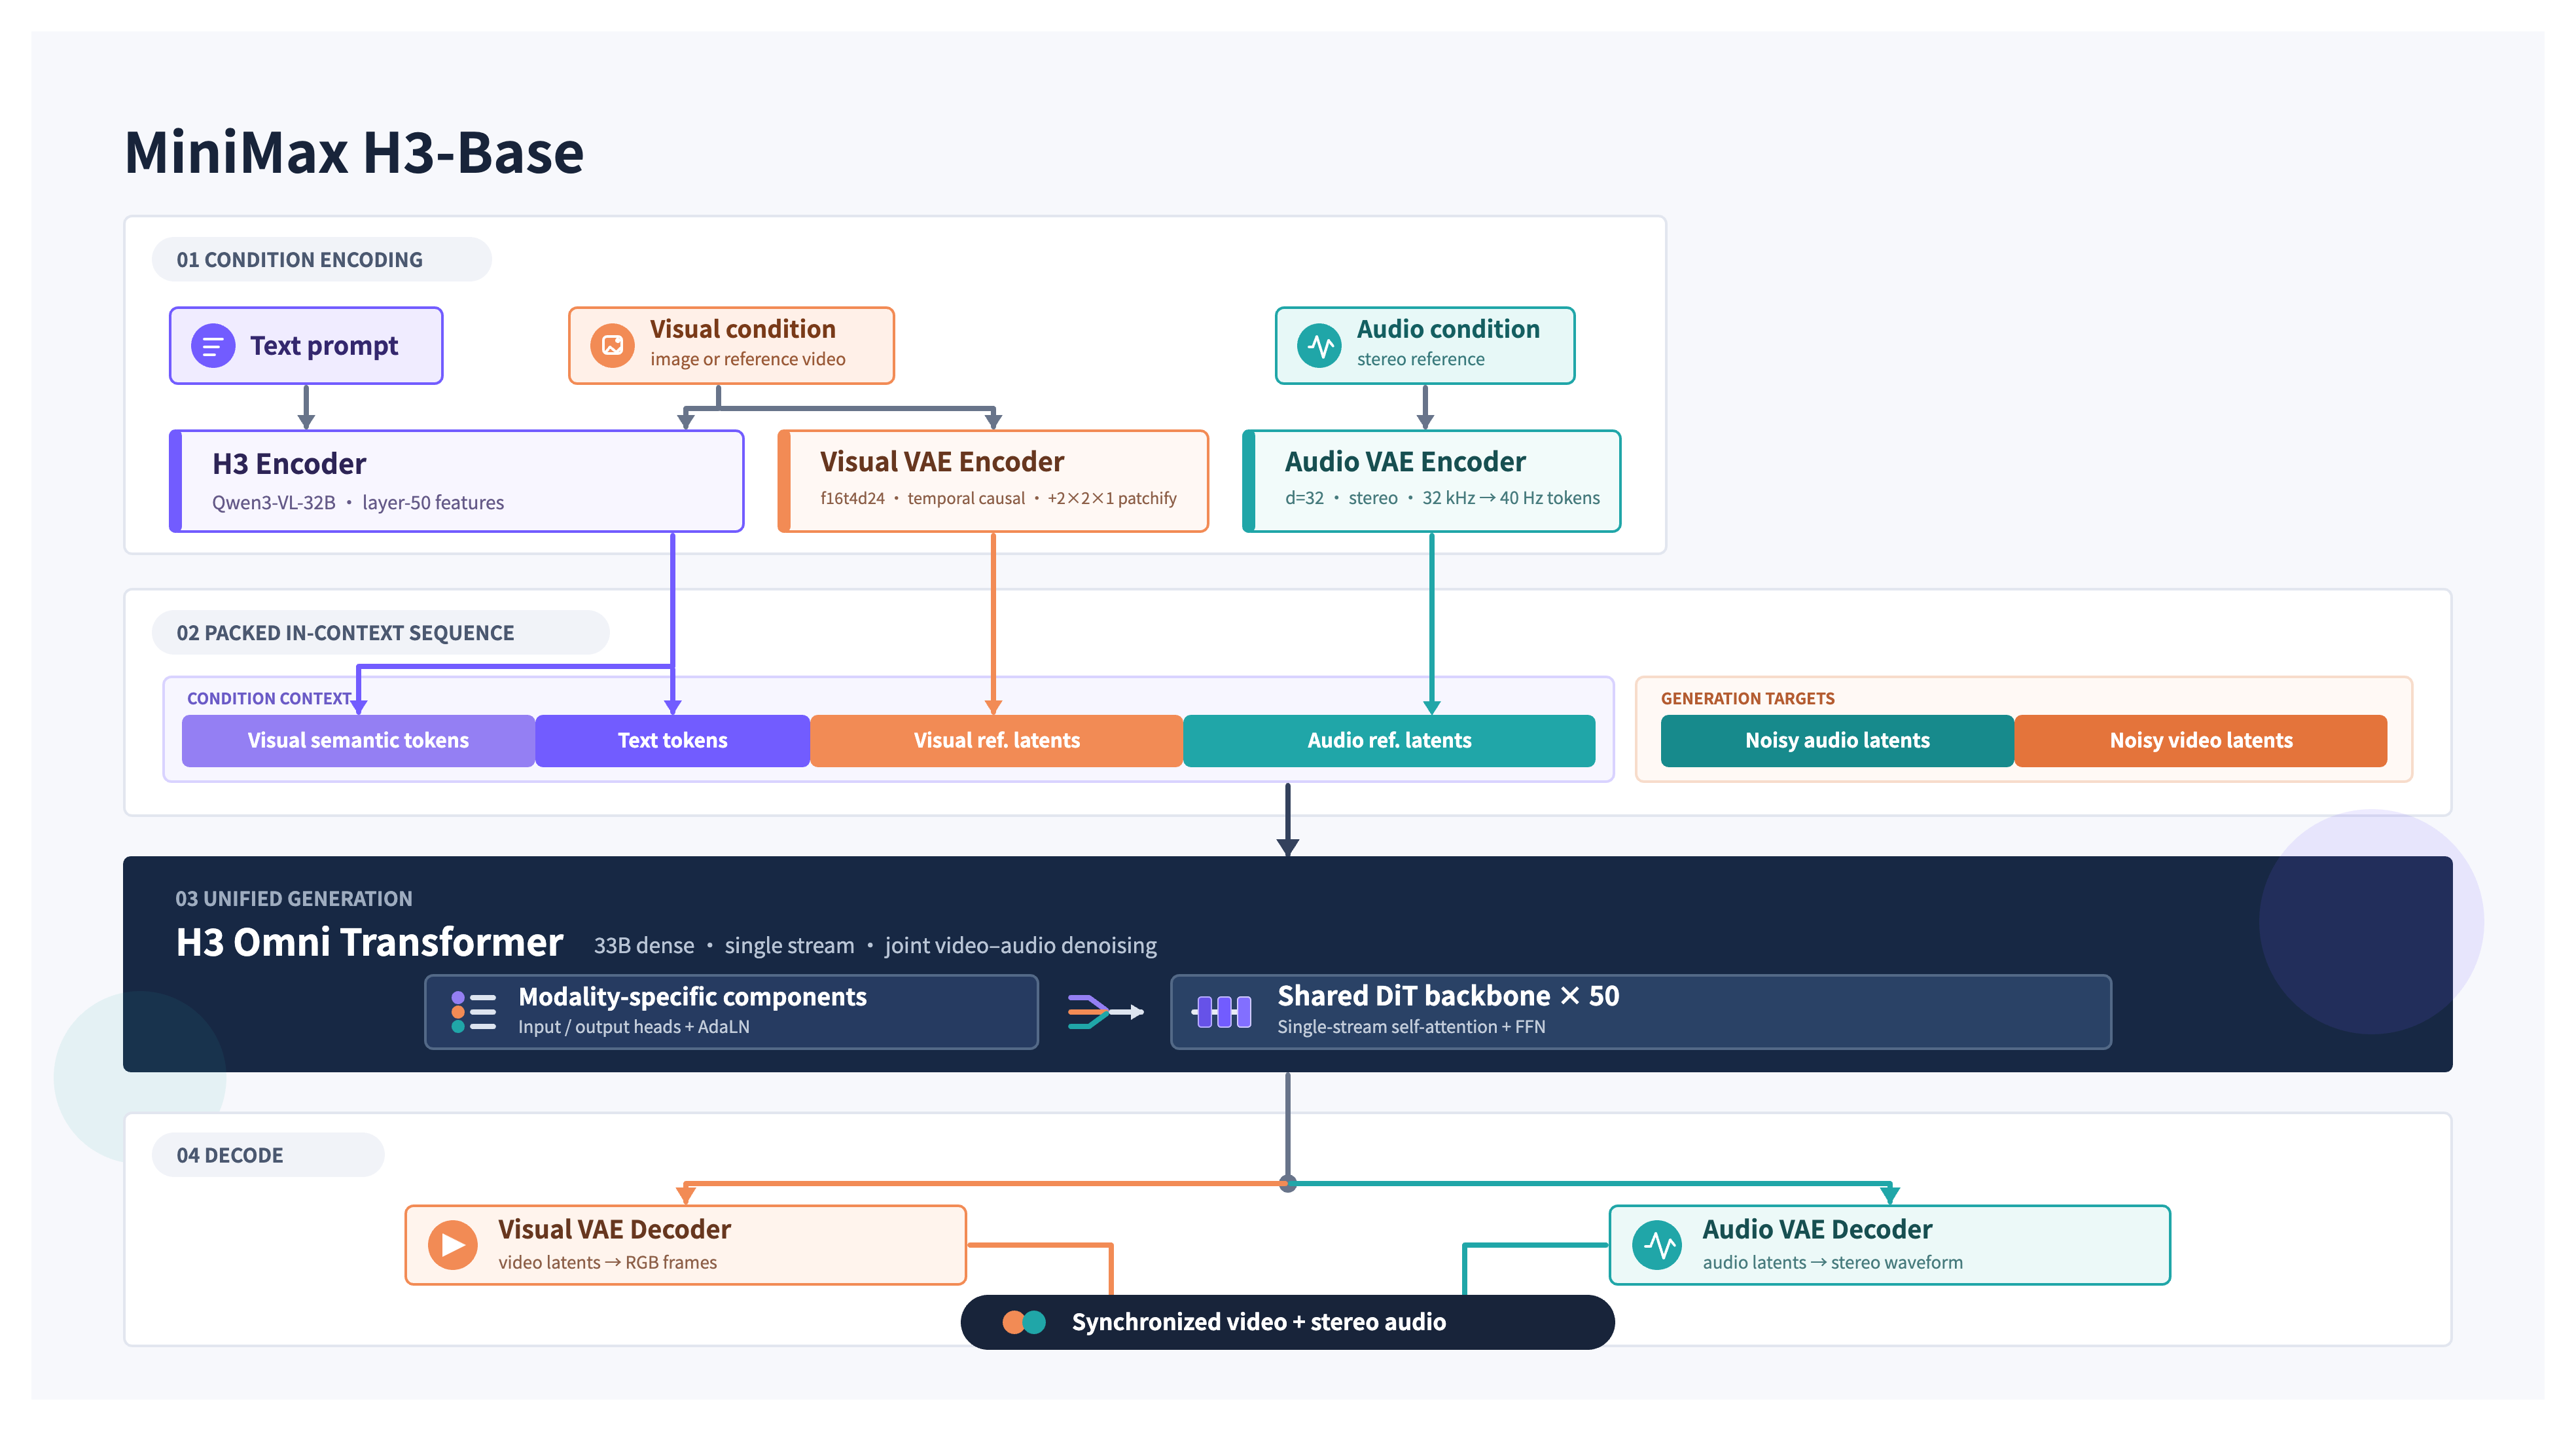
▲ 图 2:H3-Base 四阶段流程——条件编码 → 打包上下文序列 → 统一生成(33B Omni Transformer 联合去噪)→ 解码输出同步音视频
4.1 架构概览
- H3-Base 用对应编码器/VAE 编码不同模态,组织成统一打包的多模态序列,用 MM-RoPE(三维多模态旋转位置编码) 捕获 token 间的时空关系,然后整体送入 H3-Omni-Transformer;
- 文本由 H3-Encoder 编码;视觉输入由 H3-Encoder + H3-VisualVAE 编码;音频由 H3-AudioVAE 编码;
- H3-Omni-Transformer 联合预测视频和音频潜变量,再由解码器分别解码为视频帧与立体声波形;
- 原生支持稀疏注意力训练/推理(当前开源版本仅提供全注意力推理,稀疏注意力实现将在未来更新中发布)。
4.2 设计亮点
- 无模态特定结构的骨干:注意力层与 FFN 层不含模态特定结构,模态特定参数只集中在输入/输出层和 AdaLN 分支,AdaLN 用较低成本提升生成质量;
- 2K 不用超分模块:通过 in-context 方式让基座模型"重生成"自己的低分辨率结果,可复用原始多模态上下文,恢复小文字、细节等常规超分要"猜"的信息;
- 推理显存优化:AdaLN 分支参数可预计算缓存,推理部署时无需全部加载。
五、硬件环境要求
5.1 社区验证参考点(官方 FAQ 公布)
| 配置 | 说明 |
|---|---|
| 12 GB 显存(RTX 3060 级) | pruned int8 权重(共约 42 GB 下载),可出带音频的 480p |
| 16–24 GB 显存 | 很从容,调优后每条几分钟 |
| RTX 5090 / DGX Spark | 配 NVIDIA Sol Engine 栈可再快约 4× |
| Apple Silicon(Mac) | 走 MLX(建议 128GB 统一内存)或 16GB 起的 NF4 路线 |
| 社区最低方案 | 压到 5–8 GB 显存 可玩 |
| 系统内存 | 建议 32–64 GB(放不进显存的层从内存调度) |
| 无 GPU | 可用 Colab |
5.2 SGLang 服务器参考配置(官方)
| 项目 | 参考值 |
|---|---|
| GPU | 单节点 8 × NVIDIA B200(参考拓扑,非最低要求);Quickstart 也有 4 GPU 命令 |
| 精度 | 官方混合 BF16/FP32 权重,组件常驻 |
| 本地磁盘 | 模型权重约 108 GB(另需下载元数据与输出预留空间) |
| OS / Python | Linux、Python 3.12 |
| 依赖工具 | git、curl、jq、ffmpeg、NVIDIA 驱动与 CUDA runtime |
实际更亲民的部署:4 × H200(Ulysses 4)上 1344×768、124 帧、50 步、5 秒 T2VA,三组平均推理延迟约 75 秒;
quality:"high"的 Cache-DiT 路径约 53.7 秒。
六、部署路径总览
| 路径 | 适用场景 | 接口形态 | 权重来源 |
|---|---|---|---|
| ComfyUI 本地工作流 ⭐ | 交互创作、提示词迭代、关键帧与参考素材 | 可视化节点图与模板库 | Comfy-Org 发布的裁剪/量化权重(INT8/NVFP4) |
| SGLang 自托管 API | 可复现的服务器部署、应用集成 | 异步 /v1/videos API |
官方 MiniMaxAI/MiniMax-H3 checkpoint |
| vLLM-Omni 自托管 API | FL2VA+Ref2VA 合并服务、同步 MP4 响应、AMD ROCm | 同步与异步 /v1/videos API |
官方 checkpoint(社区维护 recipe) |
| Diffusers Python 管线 | 开发者脚本化调用 | Python API | diffusers 自动拉取所需组件 |
| 官方 API(最省事) | 无需 GPU、直接出 2K | REST API | MiniMax 托管 |
七、ComfyUI 本地部署(新手最快路径)
ComfyUI day-0 原生支持 H3,自带工作流模板,无需先搭推理 API,适合快速体验 T2V、I2V 和参考素材驱动工作流。
7.1 环境要求
- ComfyUI 0.30.0 或更高版本
- 显存建议 12GB 起步(社区最低 5–8GB 可玩)
- Windows / Linux / macOS 均可(用 ComfyUI 桌面版最简单)
7.2 安装 ComfyUI
方式 A:桌面版(推荐,Windows 用户最省心)
- 到 ComfyUI 官网 https://www.comfy.org/ 下载桌面版安装包;
- 安装后启动,进入可视化界面。
方式 B:源码运行(Linux / 开发者)
git clone https://github.com/Comfy-Org/ComfyUI.git
cd ComfyUI
python -m venv venv
source venv/bin/activate
pip install -r requirements.txt
python main.py
7.3 通过模板库加载 H3 工作流
- 启动 ComfyUI(0.30.0+);
- 打开 Template Library(模板库)→ Video(视频);
- 选择 MiniMax H3 T2V / MiniMax H3 I2V / MiniMax H3 R2V 模板;
- 按模型扫描弹窗下载所需文件(来自 Comfy-Org 重打包仓,含扩散模型、文本编码器、两个 VAE 三组件,放进
ComfyUI/models/); - 模型列表没刷新就重启 ComfyUI; - 填写提示词,以及需要的输入图片/视频/音频参考素材;
- 在 Resolution Selector 中用
0.98 Megapixels和32的倍数,或 16:9 原生画布直接设 1344 × 768; - ⚠️ 不要选1.0 Megapixels:会得到 1376×768,超过 H3-Base 的 768×1344 像素面积上限; - 加入队列。正确结果应为 24 FPS 视频流 + 同步立体声音频 的 MP4。
7.4 三种内置工作流
| 工作流 | 输入与控制 | 使用的扩散模型 |
|---|---|---|
| T2V | 描述镜头、运镜、对白、音效和音乐的文本提示词 | FL2VA |
| I2V | 输入图片;可选首帧和尾帧 | FL2VA |
| R2V | 图片/视频/音频参考素材任意组合 | Ref2VA |
R2V 提示词引用规则:按连接顺序使用
<Picture 1>、<Video 1>、<Audio 1>等标签引用输入,并说明每个参考素材负责身份、风格、动作、运镜还是声音。
7.5 分辨率、时长与 Turbo 模式
- H3-Base 使用 768 像素短边,宽高需对齐到 32 的倍数;
1344 × 768是原生 16:9 画布; - 时长按模型的 17k+5 帧网格和 24 FPS 对齐,请求时长可能被调整到有效帧数;
- FL2VA 示例工作流默认 20 steps;可选 8-step Turbo LoRA 更快,但可能降低动作和音频质量。
7.6 官方模板 JSON(可直接加载)
八、SGLang 自托管 API 部署
适合需要 HTTP 服务、可复现服务器配置或应用集成 的场景。
8.1 安装固定的 SGLang 源码
H3 早期支持阶段,官方建议固定 commit 保证可复现性。
export MINIMAX_H3_WORKDIR="$PWD/minimax-h3-deploy"
mkdir -p "$MINIMAX_H3_WORKDIR"

git clone https://github.com/sgl-project/sglang.git "$MINIMAX_H3_WORKDIR/sglang"
cd "$MINIMAX_H3_WORKDIR/sglang"
git checkout 2511743bd784e69e5a81ca3d926a000711dae4ab

python3 -m pip install --upgrade uv
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e "python[diffusion]" --prerelease=allow
uv pip install "huggingface_hub==1.28.0"
sglang --version
8.2 下载固定的 FL2VA checkpoint
export HF_HOME="$MINIMAX_H3_WORKDIR/hf-cache"
export MINIMAX_H3_MODEL_DIR="$MINIMAX_H3_WORKDIR/model"

hf download MiniMaxAI/MiniMax-H3 \
  --revision 42ed227ee7df40d41602854ae760620d6eb651fe \
  --include "model_index.json" "FL2VA/*" \
  --local-dir "$MINIMAX_H3_MODEL_DIR"
--model-path应指向仓库根目录(model_index.json所在处),不要指向FL2VA/子目录;SGLang 通过--model-variant fl2va选择分区。
8.3 启动 FL2VA 服务
HF_HUB_OFFLINE=1 sglang serve \
  --model-path "$MINIMAX_H3_MODEL_DIR" \
  --model-variant fl2va \
  --num-gpus 8 \
  --tp-size 1 \
  --ulysses-degree 8 \
  --encoder-parallel auto \
  --performance-mode speed \
  --host 127.0.0.1 \
  --port 30010
保持进程运行。首次启动要加载模型并 warmup,可能需数分钟才就绪。
8.4 检查就绪状态
curl --fail --retry 60 --retry-delay 10 --retry-all-errors \
  http://127.0.0.1:30010/health
就绪后返回 {"status":"ok"}。
⚠️
/liveness只表示 HTTP 进程能接收请求;应使用/health,模型 warmup 完成前返回 HTTP 503。
8.5 生成、轮询并下载 MP4
video_id=$(
  curl -fsS -X POST http://127.0.0.1:30010/v1/videos \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-H3",
    "prompt": "At night, three cats perform with tiny brass instruments in a warm living room, with movement synchronized to the music.",
    "seconds": 5,
    "task": "t2va",
    "conditions": [],
    "target": {
      "short_edge": 768,
      "aspect_ratio": "16:9",
      "duration_seconds": 5.0
    },
    "num_outputs_per_prompt": 1,
    "num_inference_steps": 50,
    "flow_shift": 12.0,
    "audio_flow_shift": 3.0,
    "seed": 1101
  }' | jq -r '.id'
)
test -n "$video_id" && test "$video_id" != "null"

while true; do
  job=$(curl -fsS "http://127.0.0.1:30010/v1/videos/${video_id}")
  status=$(printf '%s' "$job" | jq -r '.status')
  case "$status" in
    completed) break ;;
    failed)
      printf '%s\n' "$job" | jq . >&2
      exit 1 ;;
    *) sleep 5 ;;
  esac
done

curl -fsS -L "http://127.0.0.1:30010/v1/videos/${video_id}/content" -o minimax-h3-t2va.mp4

ffprobe -v error \
  -show_entries stream=codec_type,codec_name,width,height,r_frame_rate,sample_rate,channels \
  -of json minimax-h3-t2va.mp4
预期结果:非空 MP4,包含一条 24 FPS 的 H.264 视频流 + 一条 32 kHz 的 AAC 立体声音频流。16:9、短边 768 对应 1344×768,时长约 5 秒。
8.6 Ref2VA 服务(第二个进程)
Ref2VA 需要独立的 checkpoint 分区和端口:
# 下载 Ref2VA 分区
hf download MiniMaxAI/MiniMax-H3 \
  --revision 42ed227ee7df40d41602854ae760620d6eb651fe \
  --include "model_index.json" "Ref2VA/*" \
  --local-dir "$MINIMAX_H3_MODEL_DIR"

# 启动 Ref2VA 服务(另一端口)
HF_HUB_OFFLINE=1 sglang serve \
  --model-path "$MINIMAX_H3_MODEL_DIR" \
  --model-variant ref2va \
  --num-gpus 4 \
  --ulysses-degree 4 \
  --performance-mode speed \
  --host 0.0.0.0 \
  --port 30011
九、Diffusers 加载与使用
开发者用 Python 脚本调用最方便。diffusers 用户无需手动下载:ModularPipeline.from_pretrained("MiniMaxAI/MiniMax-H3") 会自动拉取所需组件。
9.1 安装依赖
pip install "torch>=2.4.0" \
  "diffusers>=0.32.2" \
  "transformers>=4.45.0" \
  "safetensors>=0.4.3" \
  "accelerate>=0.34.0" \
  "huggingface_hub>=0.25.0" \
  "numpy>=1.24.0" \
  "Pillow>=10.0.0" \
  "soundfile>=0.12.0" \
  "imageio>=2.34.0" \
  "imageio-ffmpeg>=0.5.0" \
  "av>=11.0.0"
官方文档引用 diffusers 的
minimax-h3分支获取最新类;若 PyPI 版本尚未包含 H3 类,从源码安装:pip install "git+https://github.com/huggingface/diffusers.git@minimax-h3"
9.2 加载并生成(Python 示例)
import torch
from diffusers import ModularPipeline

pipe = ModularPipeline.from_pretrained(
    "MiniMaxAI/MiniMax-H3",
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
)
pipe.to("cuda")

result = pipe(
    prompt="A cinematic shot of a robot walking through a neon-lit city at night, rain reflecting on the street.",
    negative_prompt="",
    width=1344,
    height=768,
    num_inference_steps=50,
    guidance_scale=1.0,
    num_frames=124,          # 约 5 秒 @ 24FPS
    seed=42,
    audio=True,              # 同时生成立体声音频
)

result.videos[0].save("output.mp4")
result.audios[0].save("output_audio.wav")
详细加载配方见官方 diffusers 文档: https://github.com/huggingface/diffusers/blob/minimax-h3/docs/source/en/api/pipelines/minimax_h3.md
十、使用教程:四种玩法详解
10.1 文生视频(T2VA,Text-to-Video-Audio)
ComfyUI:加载 MiniMax H3 T2V 模板,填提示词,选 1344×768,队列即可。
API 方式:
curl -fsS -X POST http://localhost:30010/v1/videos \
  -H "Content-Type: application/json" \
  -d '{
    "task": "t2va",
    "prompt": "Cinematic, medium wide shot. A lone astronaut walks across a vast alien desert under two moons, dust kicking up behind her boots, a low synth score building.",
    "conditions": [],
    "target": {
      "short_edge": 768,
      "aspect_ratio": "16:9",
      "duration_seconds": 10
    },
    "seed": 0
  }'
10.2 首帧/尾帧生视频(I2V / FL2VA)
ComfyUI:加载 MiniMax H3 I2V 模板,把首帧图连到 MiniMaxH3ImageToVideo 节点(可选接尾帧)。
API 方式(首帧图以 base64 传入):
curl -fsS -X POST http://localhost:30010/v1/videos \
  -H "Content-Type: application/json" \
  -d '{
    "task": "i2va",
    "prompt": "Continue the scene naturally: the woman turns toward the window and smiles.",
    "conditions": [
      {
        "media": "<BASE64_ENCODED_FIRST_FRAME>",
        "media_type": "image"
      }
    ],
    "target": {
      "short_edge": 768,
      "aspect_ratio": "16:9",
      "duration_seconds": 5
    },
    "seed": 0
  }'
10.3 全参照生视频(R2V / Ref2VA)⭐ 最强玩法
可同时输入图片、视频、音频作为参照,实现角色一致性、视频编辑、动作参照、镜头续写。
ComfyUI:加载 MiniMax H3 R2V 模板,按顺序连接参考素材节点;提示词中用 <Picture 1>、<Video 1>、<Audio 1> 标签引用,并说明各素材承担什么(身份/风格/动作/运镜/声音)。
API 方式:
curl -fsS -X POST http://localhost:30010/v1/videos \
  -H "Content-Type: application/json" \
  -d '{
    "task": "ref2va",
    "prompt": "<Picture 1> provides the character identity and outfit style. <Video 1> provides the camera motion. Continue the story: the hero draws his sword and faces the dragon.",
    "conditions": [
      { "media": "<BASE64_PICTURE>", "media_type": "image" },
      { "media": "<BASE64_VIDEO>", "media_type": "video" }
    ],
    "target": {
      "short_edge": 768,
      "aspect_ratio": "16:9",
      "duration_seconds": 5
    },
    "seed": 0
  }'
10.4 提示词编写技巧(Prompting Guidance)
H3 对 prompt 结构的敏感度高于多数模型——它用完整的多模态语言模型读你的提示词。官方提供两份指南:
| 指南 | 链接 |
|---|---|
| base(FL2VA)提示词指南 | https://platform.minimaxi.com/docs/guides/h3-prompting-base |
| reference(Ref2VA)提示词指南 | https://platform.minimaxi.com/docs/guides/h3-prompting-reference |
结构化提示词三段式(官方推荐结构):
integrated_multimodal_description: [Shot 1] Cinematic, ...(分镜描述:景别、运镜、动作、时间点)
overall_soundscape: A low, resonant hum ...(整体声景:环境声、对白、音效)
non_diegetic_music: Cinematic space-opera orchestral score ...(非叙事配乐:曲风、节奏、情绪)
用 Claude/Codex 等 coding agent 可一键安装官方提示词 skill(共 9 个,含 8 个风格化专用):
bash
npx skills add https://github.com/MiniMax-AI/MiniMax-H3 --skill h3-prompt-writing
十一、完整 2K 工作流(本地 + API 组合)
把本地部署的 SGLang 服务与官方 H3-Context-IR 和 H3-Regenerate-2K API 结合,即可复现直接调用 MiniMax API 的 2K 视频质量。
11.1 配置环境变量
# SGLang 服务地址
SGLANG_DEPLOYMENT_URL="<sglang-deployment-url>"

# MiniMax API(二选一)
# 国内
MINIMAX_API_BASE="https://api.minimaxi.com"
# 国际
# MINIMAX_API_BASE="https://api.minimax.io"

# 平台创建 API key
TOKEN="<token>"
11.2 三步工作流
| 步骤 | 做什么 | 接口 |
|---|---|---|
| ① H3-Context-IR | 把原始多模态指令精炼为模型最吃的 Context 表示 | /video-generation-v2-h3-context-ir |
| ② H3-Base(本地) | 用精炼后的 prompt 在本地生成 768p 音视频 | SGLang /v1/videos |
| ③ H3-Regenerate-2K | 把 768p 结果 + 原始上下文送回模型,2K 重生成 | /video-generation-v2-regeneration |
官方仓库 scripts/readme/ 目录提供全部用例(T2VA / I2VA / Ref2VA,768p 与 2K 两条路径)的可直接运行 curl 脚本,每个案例附官方 2K 与 768p 参考输出便于对照验证。
11.3 API 文档直达
十二、许可证与合规说明
许可证:MiniMax H3 Community License Agreement(社区许可协议)
| 要点 | 说明 |
|---|---|
| ✅ 免费 | 开源权重免费,本地运行只花自己的硬件和电费 |
| ✅ 可商用 | 免版税商用,三个要点:① 商业产品/服务年收入超过 2000 万美元需另行书面授权(邮件 api@minimax.io,标题 "MiniMax H3 licensing – authorization request");② 使用 H3 的商业产品须界面显著标注 "MiniMax H3";③ 遵守《可接受使用政策》,托管给他人使用须落实合理内容安全措施 |
| ✅ 可微调 | 许可明确覆盖衍生模型且归你所有;社区工具链已就绪(AI-Toolkit 支持 H3 蒸馏训练适配器);再分发需标注修改说明,衍生物仍受社区许可约束 |
| ⚠️ 地区限制 | 权重许可暂不含欧盟、英国、美国、韩国(这些地区生成式视频法规仍在演进);受限地区机构可申请正式授权做合规部署;API 全球可用 |
| ⚠️ 重要限制 | 产出与权重不得用于训练或改进其他(非 H3 系)AI 模型 |
| ⚠️ 内容限制 | 不得违法使用、不得侵犯知识产权与肖像权、不得涉及未成年人伤害、不得用产出伤害他人 |
十三、常见问题排查
| 问题 | 原因与处理 |
|---|---|
| 选 1.0 Megapixels 报错 | 1376×768 超过 H3-Base 768×1344 面积上限;用 0.98 Megapixels 或直接 1344×768 |
| 显存不足 OOM | 12GB 用 pruned int8 权重(约 42GB 下载);社区最低 5–8GB 方案;系统内存建议 32–64GB 做层调度 |
/health 一直 503 |
模型仍在 warmup,等就绪;不要用 /liveness 判断 |
| 模型列表不刷新 | ComfyUI 重启后再看模板库 |
| R2V 效果差 | 提示词必须用 <Picture 1>/<Video 1>/<Audio 1> 标签引用素材并说明其角色 |
| 想直接出 2K | 本地开源权重只出 768p 短边;2K 需走 H3-Regenerate-2K API 或直接 API 生成 |
| 想商用被拦 | 年收入>2000 万美元需书面授权;遵守 AUP 与标注要求 |
| 提示词不理想 | H3 对 prompt 结构敏感,用官方三段式(integrated_multimodal_description / overall_soundscape / non_diegetic_music)或装官方 h3-prompt-writing skill |
| 对比性能困惑 | ComfyUI 用 Comfy-Org 裁剪/量化权重,SGLang 用官方 BF16 checkpoint,两者数值基线不同,不要混用性能结论 |
十四、参考链接汇总
开源与下载
官方文档
在线使用与社区
| 资源 | 链接 |
|---|---|
| 在线 API(国际) | https://platform.minimax.io/docs/api-reference/video-generation-v2-create |
| 在线 API(国内) | https://platform.minimaxi.com/docs/api-reference/video-generation-v2-create |
| Web App(国际) | https://hailuoai.video/tools/minimax-h3 |
| Web App(国内) | https://hailuoai.com/ |
| 定价页 | https://minimax.io/price |
| Discord 社区 | https://discord.com/invite/MiniMax |
免责声明:本文所有命令、参数、数据均整理自 MiniMax 官方 GitHub 仓库 README、官方文档中心与设计站,如官方更新请以仓库最新版本为准。模型权重受 MiniMax H3 Community License 约束,请务必阅读并遵守上游许可证(含地区限制与使用义务)。