
Whisper:OpenAI 开源语音识别模型|本地部署与转写全指南
一套在 68 万小时多语言语音数据上训练的通用语音识别模型,命令行一条命令即可完成音频转写、翻译与语种识别,全部在本地运行。
| 项目 | 信息 |
|---|---|
| 官方仓库 | openai/whisper |
| 官方博客 | openai.com/blog/whisper |
| 研究论文 | arxiv.org/abs/2212.04356 |
| 模型卡 | github.com/openai/whisper/blob/main/model-card.md |
| PyPI 包 | pypi.org/project/openai-whisper |
| 语言 / 许可 | Python / MIT |

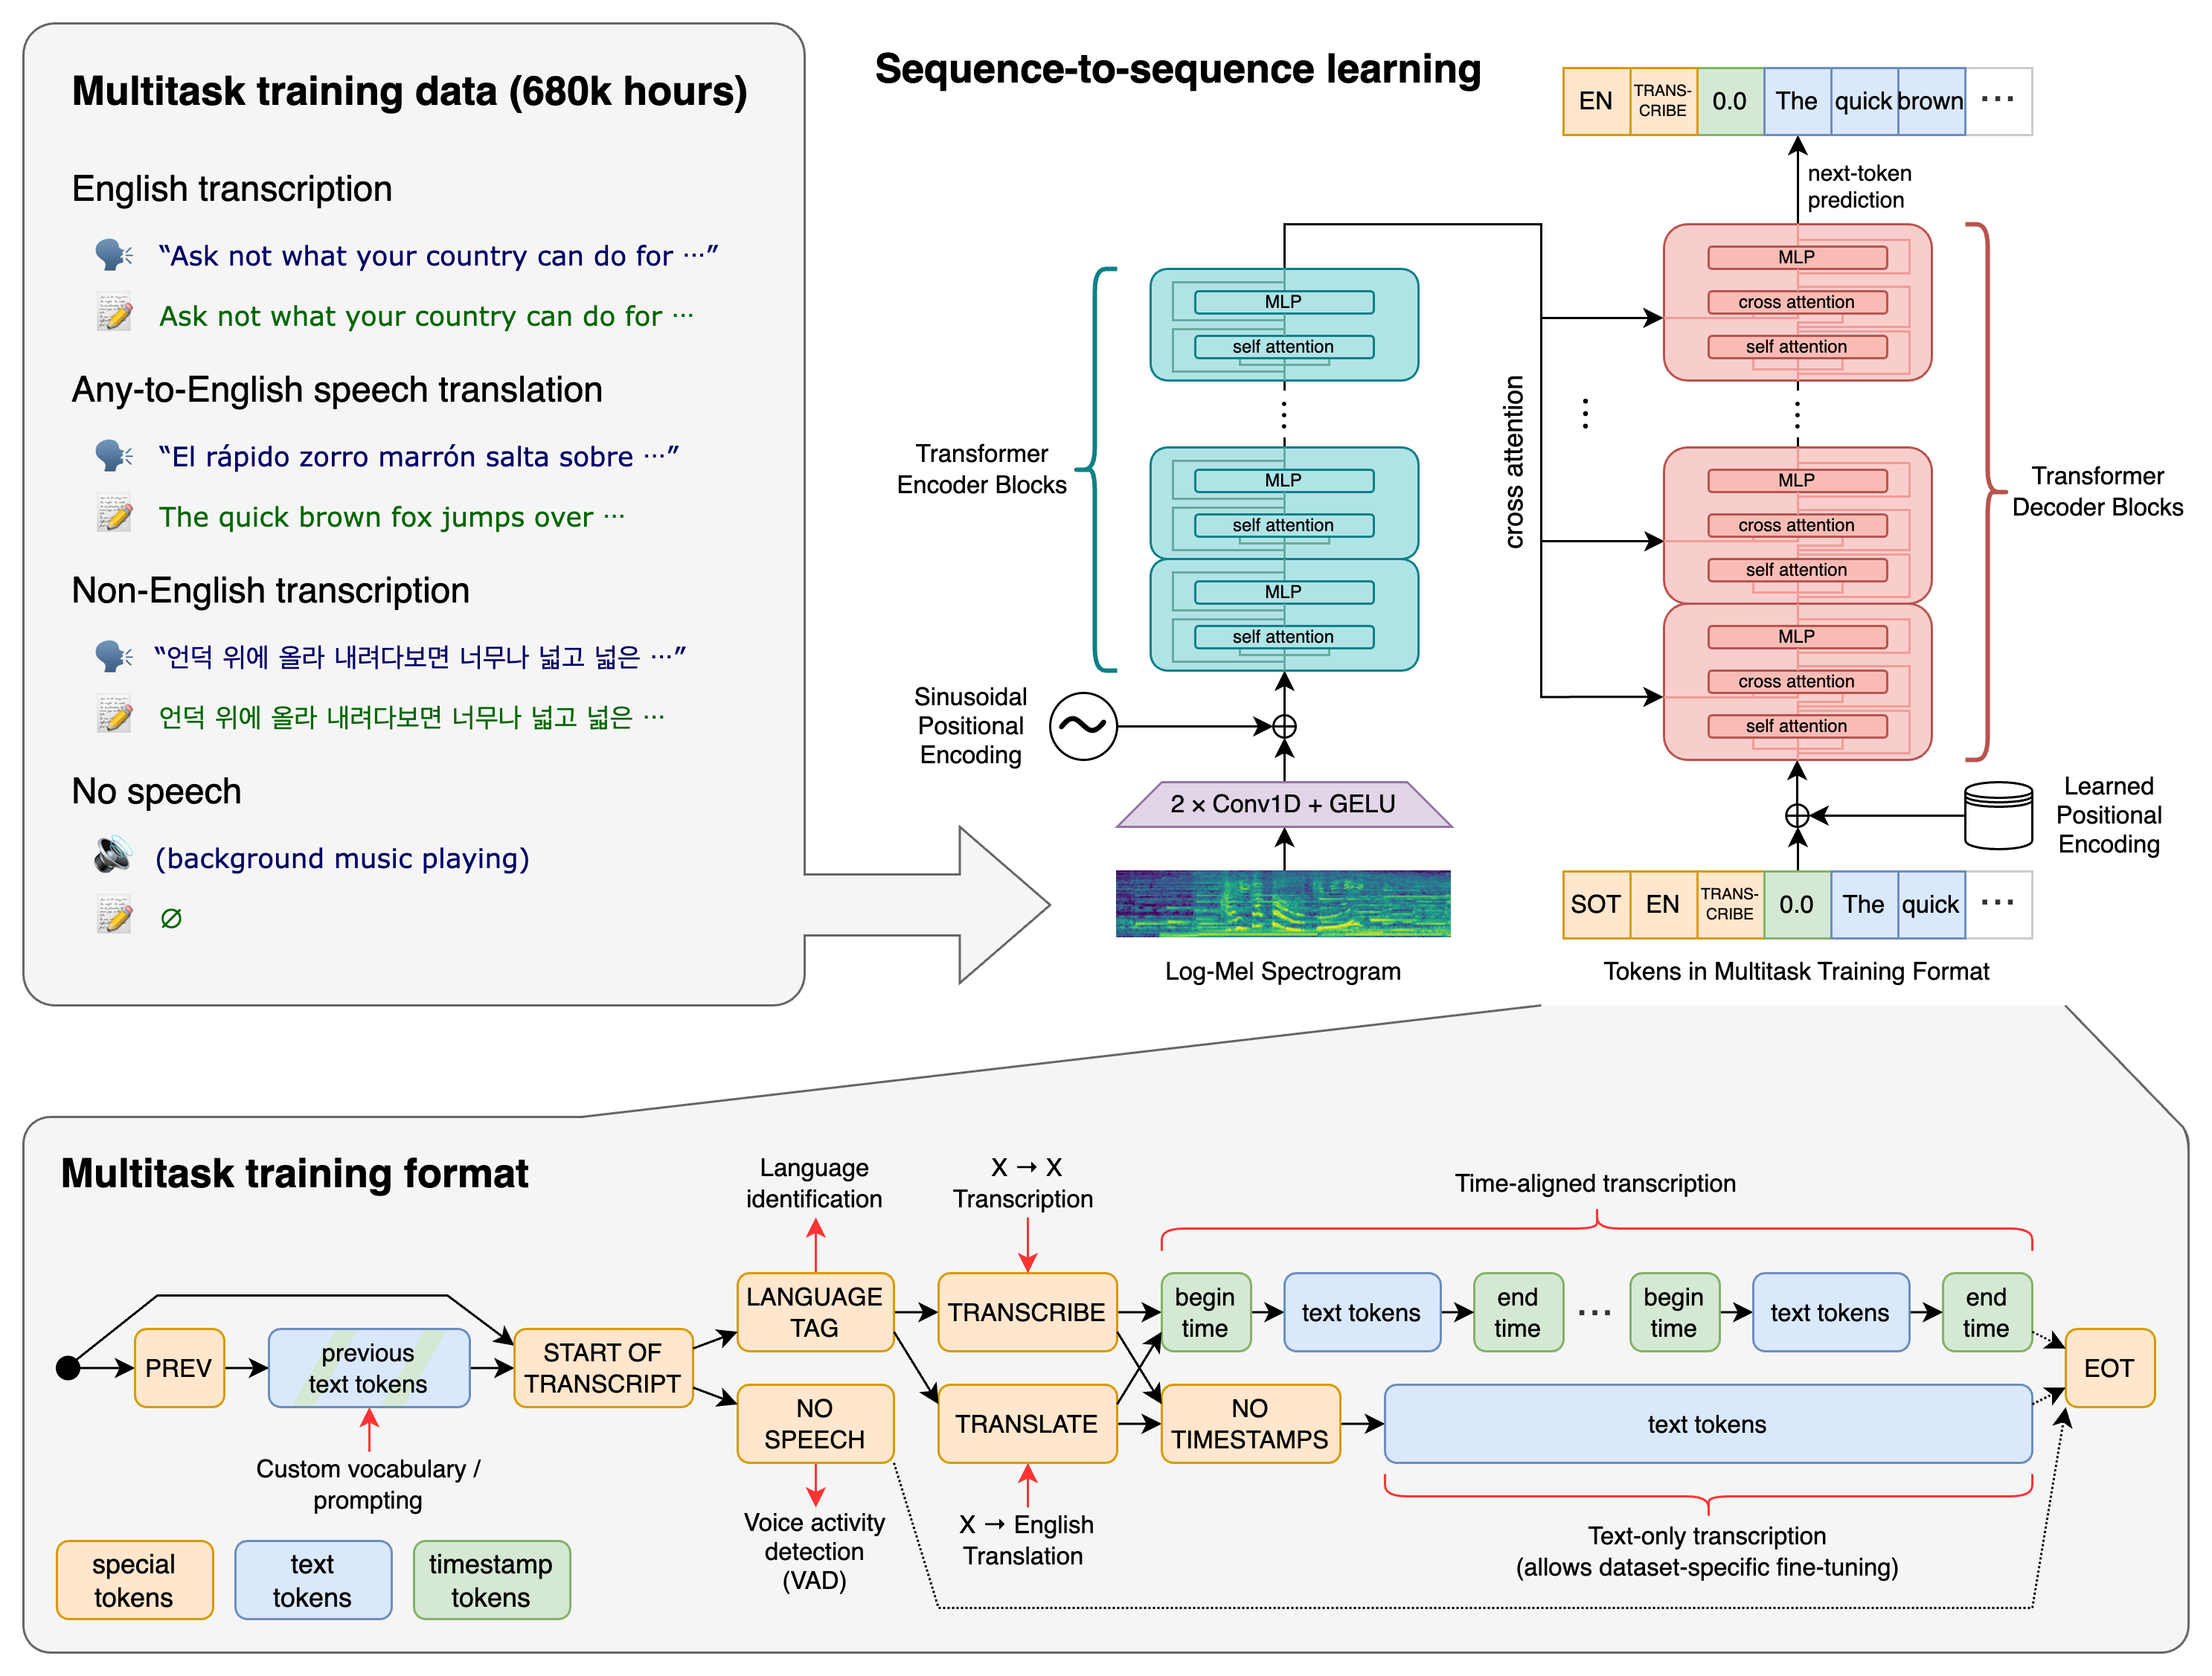
▲ 图 0:Whisper 编码器—解码器模型处理流程官方架构图(官方架构图)
项目简介
Whisper 是 OpenAI 于 2022 年开源的语音识别与语音翻译模型,基于编码器—解码器 Transformer 架构训练,训练数据覆盖约 68 万小时的多语言、多任务音频与语音转写文本,是当前生态中影响力最大的开源语音识别项目之一。截至 2026 年 10 月 25 日,其 GitHub 仓库已收获约 11.1 万 star(111,216)、13,467 个 fork,被几乎所有主流语音转写工具、字幕生成器、会议记录方案作为底层引擎引用。
项目提供命令行工具与 Python API 两种使用方式:把一个音频文件丢给 whisper 命令即可输出带时间戳的文本字幕;在代码里 load_model 后调用 transcribe,就能把转写能力嵌入自己的应用。整个推理过程运行在本地机器上,音频不会上传到任何云端服务,适合处理会议录音、课程录像、播客剪辑、客服质检等对隐私有要求的场景。
需要如实说明的是:官方仓库目前已进入维护模式,最后一次代码提交为 2026 年 8 月 31 日,仓库并未归档,核心代码与模型权重均可正常下载使用;社区在此基础上衍生出 faster-whisper、whisper.cpp 等持续活跃的加速实现,生产环境可按需选用。
核心能力与特性
- 多语言语音转写:官方论文覆盖约 99 种语言的语音识别,中文、英文、日语、粤语等语种均有可用效果,语种可自动识别也可手动指定。
- 语音翻译:
--task translate模式可将任意语言的语音直接翻译为英文文本,完成"听外语说英文"的端到端转换。 - 语种识别:不指定语言时,模型会先判断音频语种并在结果中输出检测到的语言代码。
- 五种模型尺寸可选:tiny、base、small、medium、large 外加 turbo 折中尺寸,从低配置笔记本到专业显卡工作站都能找到对应档位。
- 命令行 + Python API 双接口:既能作为独立工具批量处理音视频文件,也能作为库嵌入自有脚本与服务。
- 多种输出格式:支持 txt、vtt、srt、tsv、json 以及 all 全量格式,SRT/VTT 可直接作为字幕使用,json 保留分段与词级时间戳。
- 跨平台本地运行:Linux、macOS、Windows 均可安装,依赖 Python 与系统级 ffmpeg,模型权重首次运行自动下载,之后可离线使用。
- 时间戳与上下文提示:支持分段时间戳、词级时间戳输出,并可通过
--initial_prompt传入专业术语上下文以提升识别准确率。
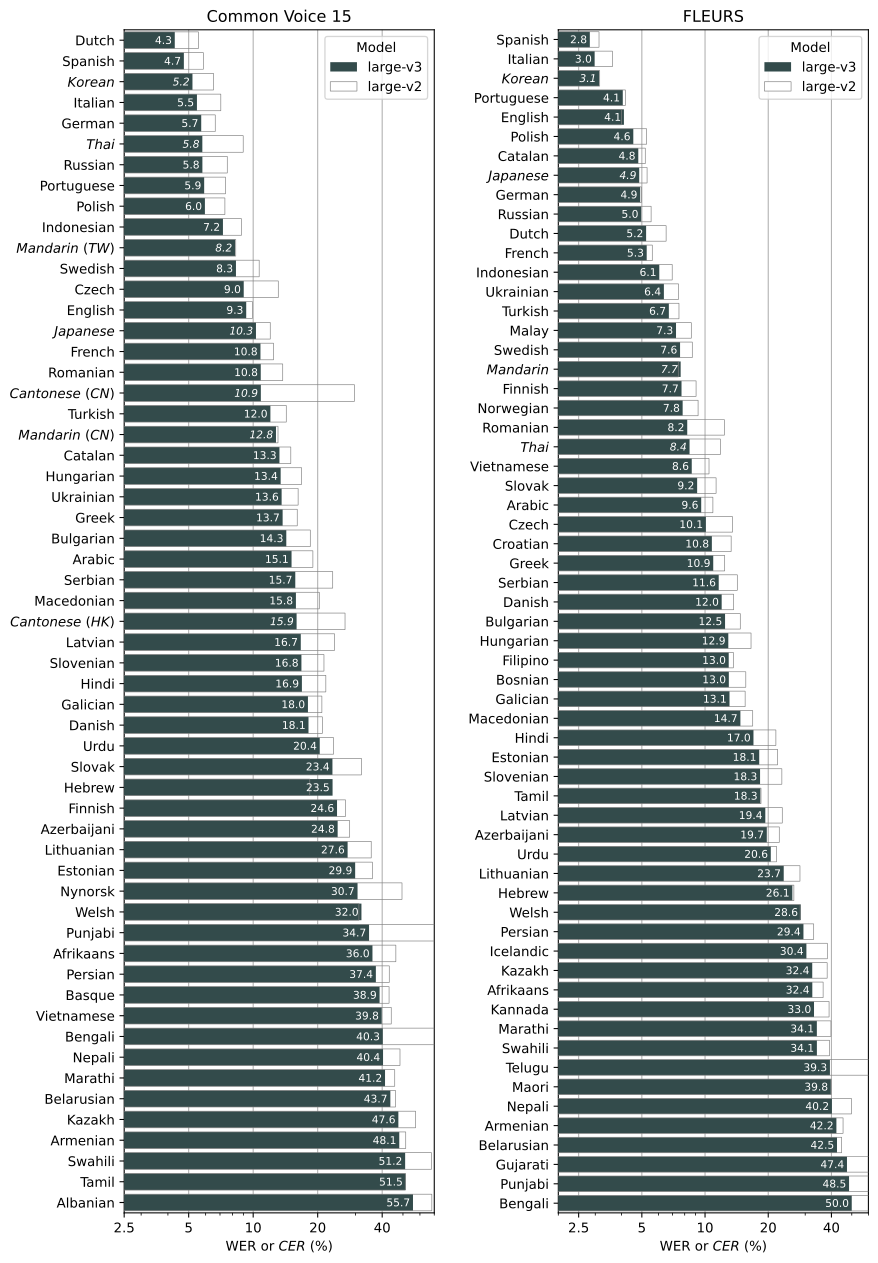
▲ 图 1:Whisper 在各语言上的词错误率分布官方统计图(官方性能图)
硬件与系统要求
Whisper 本身是一个轻量的 Transformer 模型,资源占用主要取决于所选模型尺寸;纯 CPU 可以运行,只是速度较慢。
| 项目 | 最低要求 | 推荐配置 |
|---|---|---|
| CPU | x86-64 双核,tiny / base 模型可跑 | 4 核以上主频越高越好 |
| 内存 | 8 GB | 16 GB 及以上(large 模型建议 32 GB) |
| GPU | 可选,无独显可纯 CPU 运行但速度慢 | NVIDIA CUDA 6 GB 显存以上,跑 medium 及以上模型 |
| 操作系统 | Linux、macOS、Windows 10+ | 同左 |
| 磁盘 | 安装包与依赖约 1 GB | 按所选模型预留权重空间,medium 及以上建议预留数 GB |
各模型尺寸的显存占用参考如下(显存不足时优先选小一档模型,或回退到 CPU 推理):
| 模型 | 参数量 | 显存参考 | 适用场景 |
|---|---|---|---|
| tiny | 39 M | 约 1 GB | 快速测试、低配机器、实时性优先 |
| base | 74 M | 约 1 GB | 轻量转写,速度优先 |
| small | 244 M | 约 2 GB | 速度与准确率平衡,日常入门档位 |
| medium | 769 M | 约 5 GB | 中文等多语言常用选择,准确率与速度折中 |
| large | 1550 M | 约 10 GB | 最高识别准确率,有独显时选用 |
| turbo | 809 M | 约 6 GB | large-v3-turbo,速度与准确率之间的折中档位 |
完整部署方式
环境准备
Whisper 要求 Python 3.8 至 3.11 版本;系统层面必须安装 ffmpeg,用于读取 mp3、wav、m4a、mp4 等各类音视频格式。
# Ubuntu / Debian 安装 ffmpeg
sudo apt update && sudo apt install -y ffmpeg

# macOS(Homebrew)
brew install ffmpeg

# Windows(Chocolatey)
choco install ffmpeg
# 确认 Python 版本(建议 3.8-3.11)
python3 --version

# 确认 ffmpeg 可用
ffmpeg -version
Windows 用户也可以前往 ffmpeg.org 下载编译好的压缩包,解压后把 bin 目录加入系统 PATH。
安装 Whisper
# 创建并激活虚拟环境(可选,避免污染系统 Python)
python3 -m venv whisper-env
source whisper-env/bin/activate   # Windows: whisper-env\Scripts\activate

# 通过 PyPI 安装官方包
pip install -U openai-whisper

# 验证命令行可用
whisper --help
安装过程中若 tiktoken 等依赖在当前平台没有预编译 wheel,会提示需要 Rust 工具链;按提示通过 rustup 安装 Rust 后重新执行 pip install -U openai-whisper 即可。
模型权重说明
Whisper 没有官方 Hugging Face 模型页,权重文件也不随 PyPI 包分发。首次调用 whisper 命令或执行 whisper.load_model(...) 时,程序会自动从 OpenAI Azure CDN 下载对应模型权重并缓存到本地:Linux / macOS 默认在 ~/.cache/whisper,Windows 默认在 %USERPROFILE%\.cache\whisper。下载完成后断网也能正常转写;若换机器迁移,直接拷贝该缓存目录即可。
使用方法
命令行基础转写
# 最常用:转写中文音频,使用 medium 模型,强制指定语言为中文
whisper audio.mp3 --model medium --language zh

# 输出 txt、srt、vtt 三种格式(默认仅输出 txt,指定 --output_format 后生成对应文件)
whisper audio.mp3 --model small --language zh --output_format txt srt vtt

# 把任意语言音频翻译成英文(输出英文文本)
whisper meeting.wav --model large --task translate

# 自动识别语种,不手动指定 --language
whisper podcast.mp3 --model turbo --output_format all
转写完成后,命令行所在目录会生成与音频同名的一组文本与字幕文件。
Python API 调用
import whisper

# 加载模型(首次运行自动从 OpenAI Azure CDN 下载权重到本地缓存)
# 可选尺寸:tiny / base / small / medium / large / turbo
model = whisper.load_model("medium")

# 转写音频,指定语言为中文;不填 language 则由模型自动识别
result = model.transcribe("audio.mp3", language="zh")

# 输出完整转写文本
print(result["text"])

# 分段结果:每段带起止时间戳与文本
for segment in result["segments"]:
    print(f"[{segment['start']:.2f} - {segment['end']:.2f}] {segment['text']}")
常用参数说明
| 参数 | 作用 |
|---|---|
--model |
选择模型尺寸:tiny / base / small / medium / large / turbo |
--language |
指定音频语种(如 zh、en、ja);省略则自动识别 |
--task |
transcribe 为原文转写,translate 为翻译为英文 |
--output_format |
输出格式:txt / vtt / srt / tsv / json / all |
--initial_prompt |
传入术语、人名等上下文提示词,改善专业场景识别效果 |
--word_timestamps |
开启词级时间戳输出 |
--temperature |
采样温度,解码不稳定时可适当调低 |
--verbose False |
关闭实时打印,批量脚本场景更安静 |
批量处理与衍生工具
对整个目录批量转写时,在 shell 循环里逐条调用 whisper 命令即可;Python 脚本中复用同一个 load_model 实例循环调用 transcribe,可避免重复加载权重。社区生态中,faster-whisper 基于 CTranslate2 对模型做了量化与推理加速,参数接口与原生 Whisper 高度相似,适合追求吞吐的生产场景;whisper.cpp 则把模型移植到 CPU 端侧部署。这些衍生项目均以 Whisper 训练出的权重为基础,可按需评估选用。
官方链接
| 资源 | 链接 |
|---|---|
| GitHub 仓库 | github.com/openai/whisper |
| 官方博客 | openai.com/blog/whisper |
| 研究论文 | arxiv.org/abs/2212.04356 |
| 模型卡 | github.com/openai/whisper/blob/main/model-card.md |
| PyPI 安装包 | pypi.org/project/openai-whisper |
| 系统依赖 ffmpeg | ffmpeg.org |
常见问题(FAQ)
问:没有独立显卡能跑 Whisper 吗? 可以。Whisper 支持纯 CPU 推理,tiny、base、small 模型在普通笔记本上即可完成短音频转写;medium、large 模型在 CPU 上速度会明显变慢,有 NVIDIA 显卡时建议配合 CUDA 运行,显存占用参考上文模型尺寸表。
问:模型权重下载到哪里?换机器可以离线拷贝吗?
首次加载模型时自动下载到缓存目录:Linux / macOS 为 ~/.cache/whisper,Windows 为 %USERPROFILE%\.cache\whisper。把该目录整体拷贝到新机器相同位置,即可在断网环境下直接使用对应模型。
问:中文转写选哪个模型比较合适? 入门测试用 small 即可兼顾速度与准确率;日常会议录音、课程字幕推荐 medium;追求最高准确率且显存充足时选 large;turbo 是 large-v3-turbo 折中档位,显存约 6 GB,速度比 large 快不少。
问:支持多少种语言?能自动识别说的是什么语言吗?
官方论文覆盖约 99 种语言。不指定 --language 时模型会自动识别语种;--task translate 模式则把任意语言的语音统一翻译为英文输出。
问:官方仓库还在维护吗?现在使用会不会过时? 仓库已进入维护模式,最后提交于 2026 年 8 月 31 日,目前并未归档,代码与权重均可正常下载使用。核心识别能力已经稳定,社区衍生实现(如 faster-whisper、whisper.cpp)持续提供加速与新特性,生产环境可结合这些方案使用。
问:安装时 tiktoken 报错说需要 Rust 工具链怎么办?
当前平台没有 tiktoken 预编译 wheel 时会从源码编译,需要先安装 Rust(rustup),安装完成后重新执行 pip install -U openai-whisper;也可以先升级 pip(pip install -U pip)再重试,部分平台新版本 wheel 会可用。
许可证
Whisper 代码仓库采用 MIT 许可证,允许自由使用、修改、合并、发布与商用,只需在分发副本中保留原始版权声明与许可文本。模型权重的使用条款以官方模型卡 model-card.md 为准,涉及对外提供模型服务或商用产品时,建议先通读模型卡中的适用范围说明。