
llama.cpp:纯 C++ 大模型推理引擎|编译、量化与部署全指南
用纯 C/C++ 写出的轻量推理底座,不依赖 Python 运行时,在 CPU、独显、Apple Silicon 甚至浏览器里都能把 GGUF 大模型跑起来。
| 项目 | 信息 |
|---|---|
| 官方仓库 | ggml-org/llama.cpp |
| 官方文档 | 仓库 docs 目录 |
| 官网 | llama.app |
| 模型权重(HF) | huggingface.co/ggml-org(GGUF 模型组织) |
| 语言 / 许可 | C++ / MIT |

▲ 图 0:llama.cpp 官方品牌封面(深色版,官方品牌素材)
项目简介
llama.cpp 是当下最有影响力的本地大模型推理引擎之一,由 Georgi Gerganov 发起并持续由 ggml-org 社区维护。截至 2026 年 10 月 25 日,其 GitHub 仓库已收获约 13.2 万 star(132,274),fork 数约 2.48 万(24,782),是 AI 开源生态里 star 密度最高的 C++ 项目之一。它最初以纯 C 语言复现 LLaMA 推理过程而闻名,后来逐步演化为一套通用的、跨平台的推理基础设施。
它的核心思路非常直接:把模型权重和计算过程都搬进一份可以直接编译的本地程序里。运行时不需要 Python、不需要大型框架、不需要重型依赖,一个编译产物加上一个 GGUF 模型文件就能完成推理。正因为如此,llama.cpp 成为了无数上层工具的底层底座:Ollama、Open WebUI 后端、各类本地聊天桌面端、嵌入式设备与边缘盒子里的模型服务,背后大量调用的都是 llama.cpp 的推理能力。
对个人开发者来说,llama.cpp 适合想理解推理原理、想在低配机器上榨干性能、或者想把模型嵌入自己 C/C++ 程序的用户;对工程团队来说,它是资源受限环境、离线内网部署、多后端硬件适配时最稳妥的本地推理选择。
核心能力与特性
- 纯 C/C++ 实现,运行时零重型依赖:核心代码围绕自研的 ggml 计算库编写,编译后即可在目标系统直接运行,不需要 Python 环境、CUDA Toolkit 运行时之外的框架链。
- 1.5 bit 到 8 bit 全档位量化:支持从二值化近似到 Q8_0、F16 的多种量化格式,同等模型在显存/内存占用上可相差数倍,配合 GGUF 单文件权重分发。
- 多硬件后端自动适配:内置 NVIDIA CUDA、AMD HIP(ROCm)、Apple Metal、Vulkan、Intel SYCL、OpenCL、WebGPU、OpenVINO 等后端,编译时通过开关选择,运行时自动使用可用加速设备。
- CPU + GPU 混合推理:支持把指定层数卸载到 GPU(
-ngl参数),其余层留在 CPU,显存吃紧时也能跑大模型。 - CLI、Server、工具链三位一体:既有交互式终端
llama-cli,也有带内置 WebUI 的 HTTP 服务llama-server,还有llama-quantize、llama-gguf等量化与格式转换工具。 - 内置 OpenAI 兼容接口:
llama-server暴露/v1/chat/completions等端点,可直接被 OpenAI SDK 与多数第三方前端接入。 - 多模态支持:在对话模型之外可挂载视觉投影(mmproj),支持图像输入;新版构建也可处理视频等媒体输入。
- 多种交付形态:可从源码用 CMake 编译,可下载 GitHub Releases 预编译二进制,也可以直接拉取官方 Docker 镜像运行。
硬件与系统要求
llama.cpp 本身极轻量,配置门槛主要取决于要跑的模型大小与量化等级。
| 项目 | 最低要求 | 推荐配置 |
|---|---|---|
| CPU | x86-64 四核(纯 CPU 跑 1B 级小模型) | 8 核以上,主频越高越好;Apple Silicon 统一内存有明显优势 |
| 内存 | 4 GB(0.8B Q4 量化模型约需 1 GB 左右) | 16 GB 以上(7B Q4_K_M 约 5-6 GB,27B 量化约 16 GB) |
| GPU | 可选,无独显可纯 CPU 运行 | NVIDIA CUDA 6 GB 显存以上 / AMD ROCm / Apple Metal / Vulkan 兼容显卡 |
| 操作系统 | Linux、macOS、Windows 10+ | 同左;Windows 需 Visual Studio C++ 生成工具与 CMake |
| 磁盘 | 模型文件另计:7B Q4_K_M 约 4 GB,27B Q8_0 约 27 GB | 预留模型缓存与编译临时空间 10 GB 以上 |
显存不够时的速算经验:参数量(B) × 量化后每参数字节 ≈ 显存占用,Q4_K_M 约 0.55-0.6 字节/参数,Q8_0 约 1 字节/参数;装不下的层数用 -ngl 混合卸载到 CPU 内存继续跑。
完整部署方式
环境准备
以源码编译为例,先准备构建工具链:
# Debian / Ubuntu
sudo apt update
sudo apt install -y build-essential cmake git

# macOS(先安装 Xcode Command Line Tools,再用 Homebrew)
xcode-select --install
brew install cmake git

# Windows:安装 Visual Studio 2022,勾选"使用 C++ 的桌面开发",再安装 CMake 与 Git
源码克隆与默认 CPU 编译
# 克隆官方仓库
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp

# 生成构建目录并配置(默认纯 CPU 后端)
cmake -B build

# 编译 Release 版本,产物输出到 build/bin/
cmake --build build --config Release

# 查看生成的可执行程序
ls build/bin/
按需开启硬件加速后端
编译时通过 CMake 开关启用对应后端,可叠加多个开关:
# NVIDIA CUDA(需先装好 NVIDIA 驱动与 CUDA Toolkit)
cmake -B build -DGGML_CUDA=ON
cmake --build build --config Release

# Apple Metal(macOS)
cmake -B build -DGGML_METAL=ON
cmake --build build --config Release

# AMD ROCm HIP / Vulkan / Intel SYCL / OpenCL / OpenVINO / WebGPU 依次为:
#   -DGGML_HIP=ON / -DGGML_VULKAN=ON / -DGGML_SYCL=ON
#   -DGGML_OPENCL=ON / -DGGML_OPENVINO=ON / -DGGML_WEBGPU=ON
获取 GGUF 模型权重
模型统一使用 GGUF 格式,可从 Hugging Face 上的 ggml-org 组织拉取,也可使用社区发布的任意 GGUF 文件:
# 安装 Hugging Face CLI
pip install -U "huggingface_hub[cli]"

# 示例:下载 0.8B 小模型 GGUF 到本地目录
hf download ggml-org/Qwen3.5-0.8B-GGUF --local-dir models/qwen3.5-0.8b-gguf
llama.cpp 的 CLI 也支持 -hf 参数直接按仓库名拉取模型,首次运行自动下载并缓存,无需手动执行 hf 命令。
方式一:Releases 预编译二进制
不想本地编译时,前往 GitHub Releases 下载对应系统架构的压缩包,解压后直接运行 llama-cli、llama-server 即可;注意预编译包通常按后端分别提供,选择与自己显卡匹配的版本。
方式二:Docker 容器运行
# 后台启动 server 镜像,挂载本地模型目录,暴露 8080 端口
docker run --rm -it -p 8080:8080 \
  -v /home/user/models:/models \
  ghcr.io/ggml-org/llama.cpp:server \
  -m /models/model.gguf --port 8080 --host 0.0.0.0
使用方法
命令行交互式对话(llama-cli)
# 方式 A:指定本地 GGUF 文件,进入交互式多轮对话
./build/bin/llama-cli -m models/qwen3.5-0.8b-gguf/model.gguf \
  -c 2048 --interactive-first -cnv

# 方式 B:通过 -hf 直接从 Hugging Face 拉取对应版本(如 Q8_0)
./build/bin/llama-cli -hf ggml-org/Qwen3.5-0.8B-GGUF:Q8_0

# 一次性提问并限制生成长度,适合脚本化调用
./build/bin/llama-cli -m models/model.gguf \
  -p "用三句话解释什么是大模型量化" -n 256

# 显存吃紧时把前 99 层卸载到 GPU,其余留在 CPU 混合推理
./build/bin/llama-cli -m models/model.gguf -ngl 99
常用参数:-c 设置上下文长度,-p 传入提示词,-n 限制最大生成 token,-ngl 指定卸载到 GPU 的层数,--temp 控制采样温度,-f 从文件读取提示词。交互式会话内可使用 /exit 退出、/regen 重新生成上一条回复、/clear 清空历史,图像、文本文件也可通过 /image、/read 命令挂载。
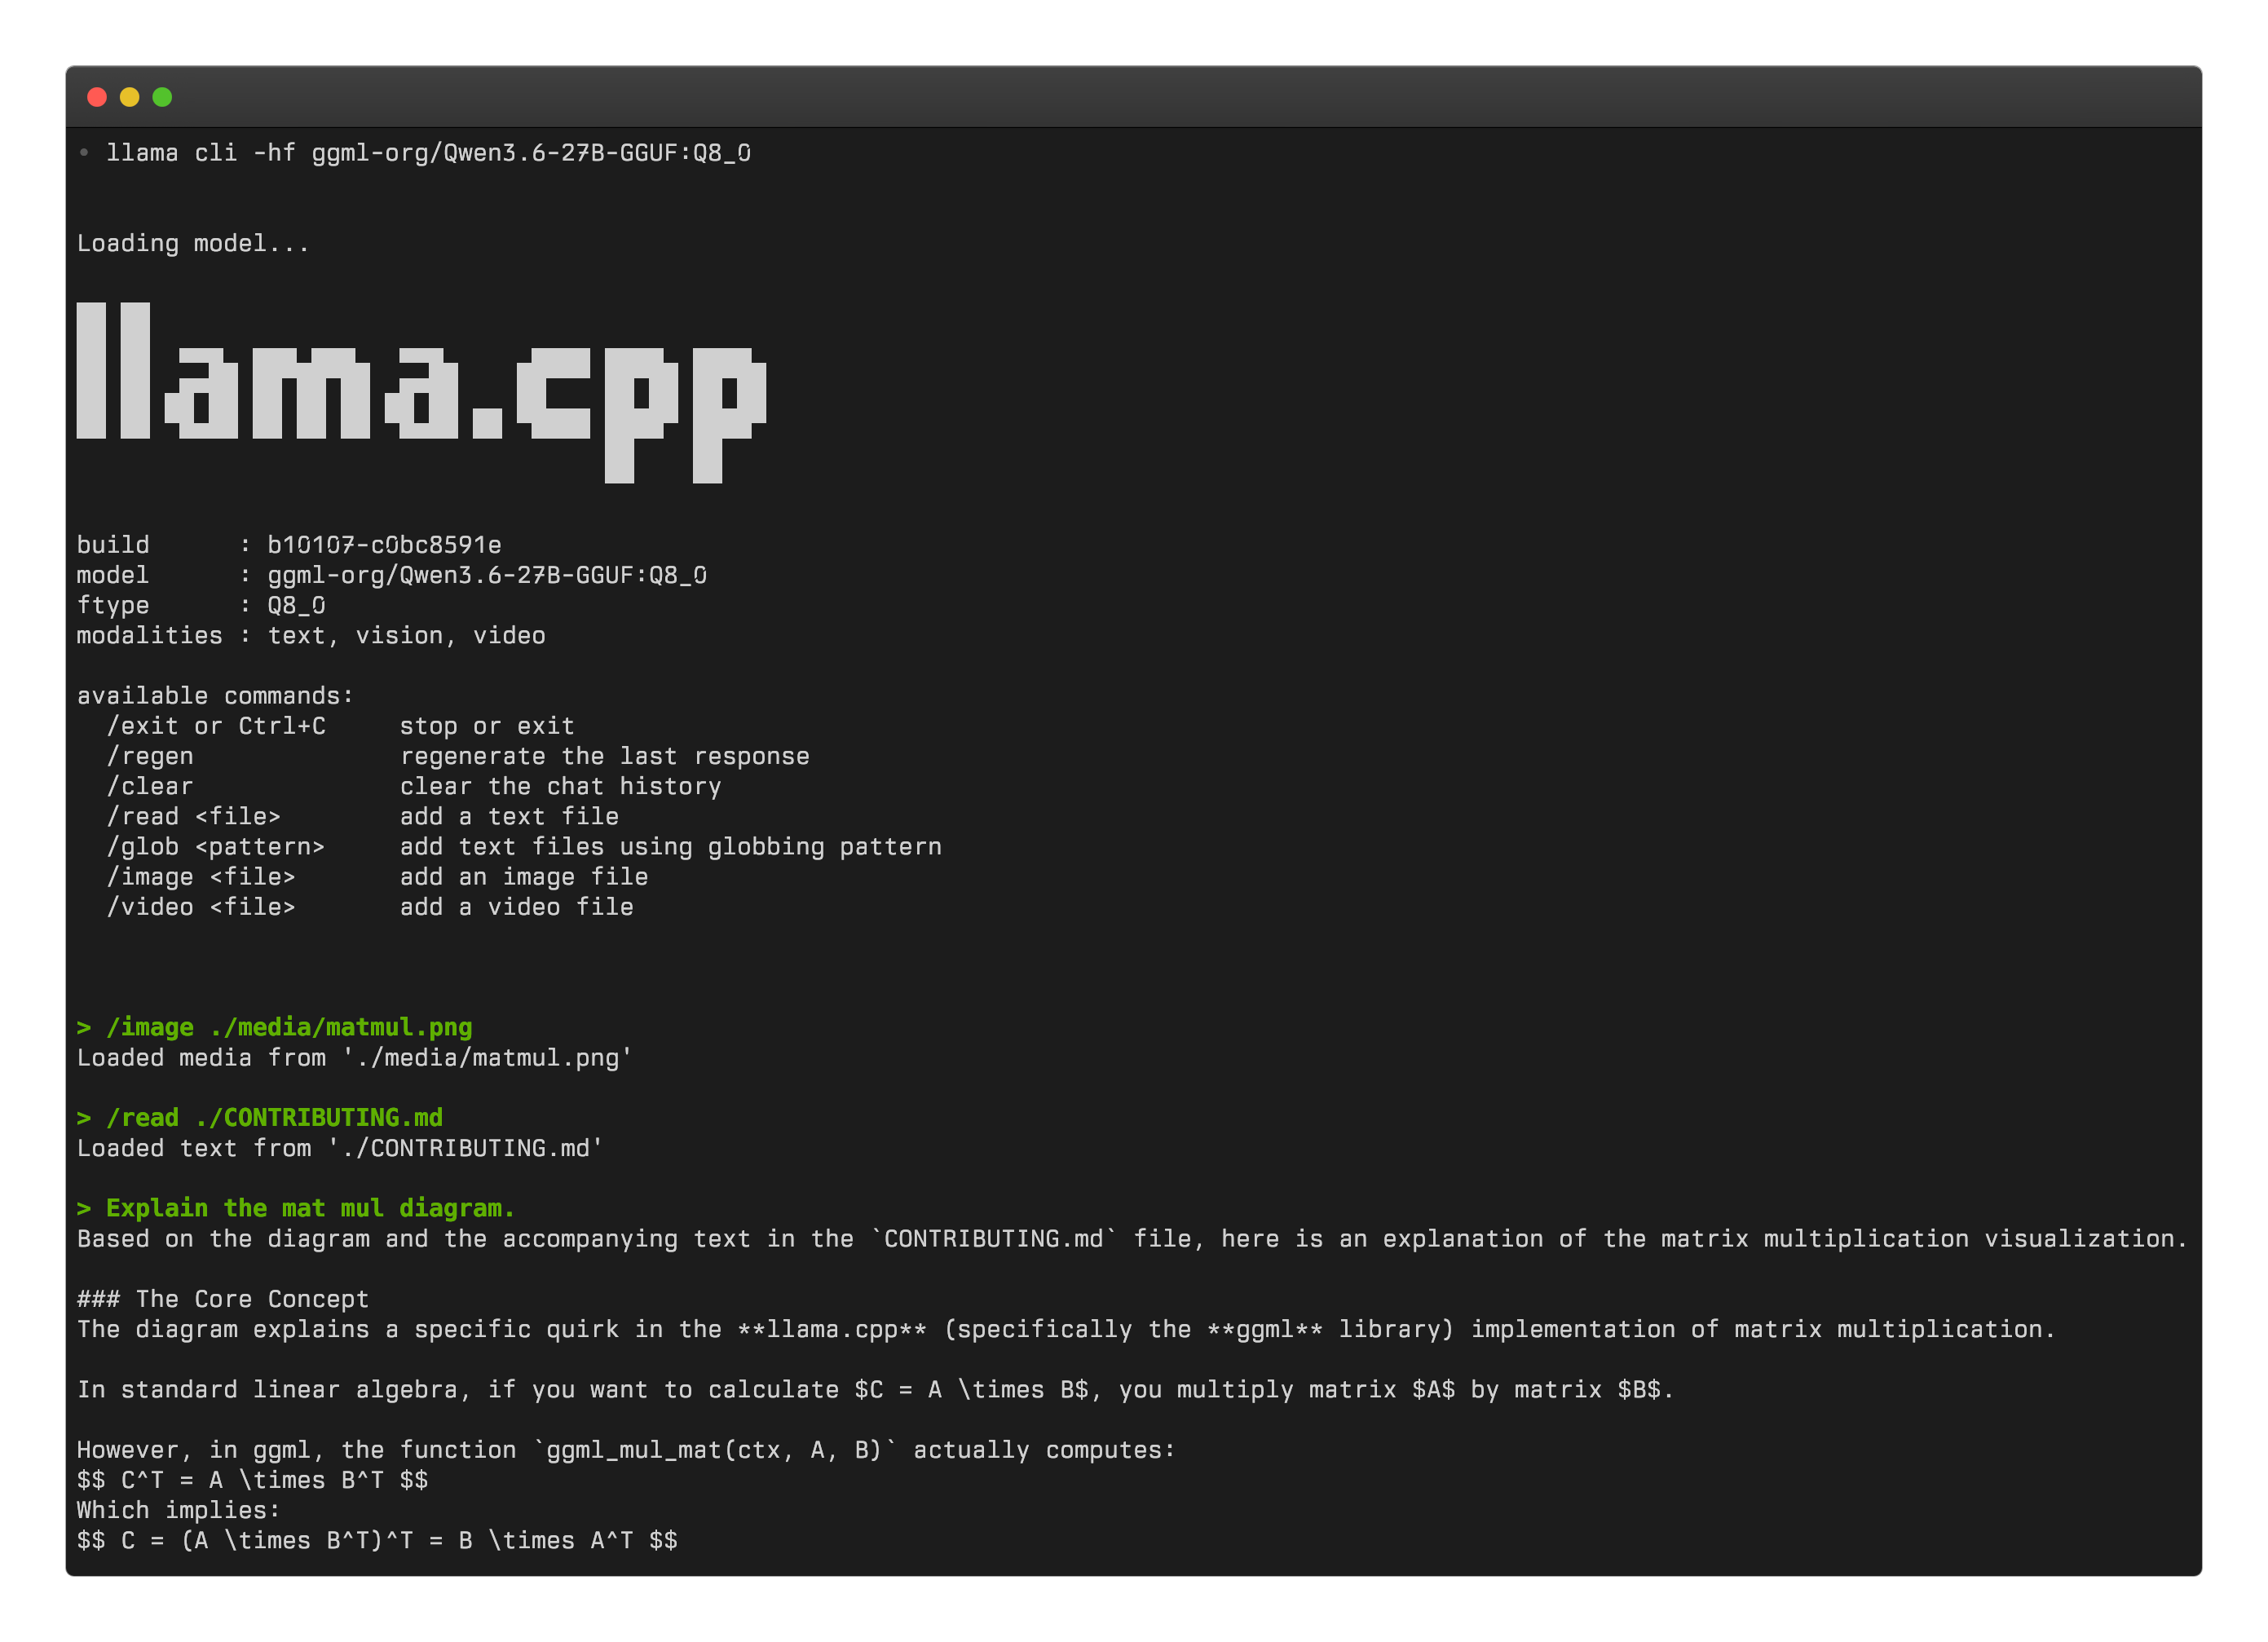
▲ 图 1:llama-cli 终端交互式会话,可通过 -hf 参数直接拉取 HF 模型,并挂载图像与文档进行多模态问答(官方截图)
HTTP 服务与内置 WebUI(llama-server)
# 启动服务,监听本机 8080 端口,加载本地模型
./build/bin/llama-server -m models/model.gguf \
  --port 8080 --host 127.0.0.1 -ngl 999

# 对外开放局域网访问时把 --host 改为 0.0.0.0
# 内置浏览器界面地址:http://127.0.0.1:8080
# OpenAI 兼容端点:http://127.0.0.1:8080/v1/chat/completions
# 用 curl 调用 OpenAI 兼容对话接口
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "model",
    "messages": [{"role": "user", "content": "你好,介绍一下你自己"}]
  }'
浏览器打开 http://127.0.0.1:8080 即可使用内置 WebUI:左侧为会话列表与历史记录,可在输入框附近切换模型、推理模式与内置工具,也支持挂载 MCP 服务与 Hugging Face 模型选择。
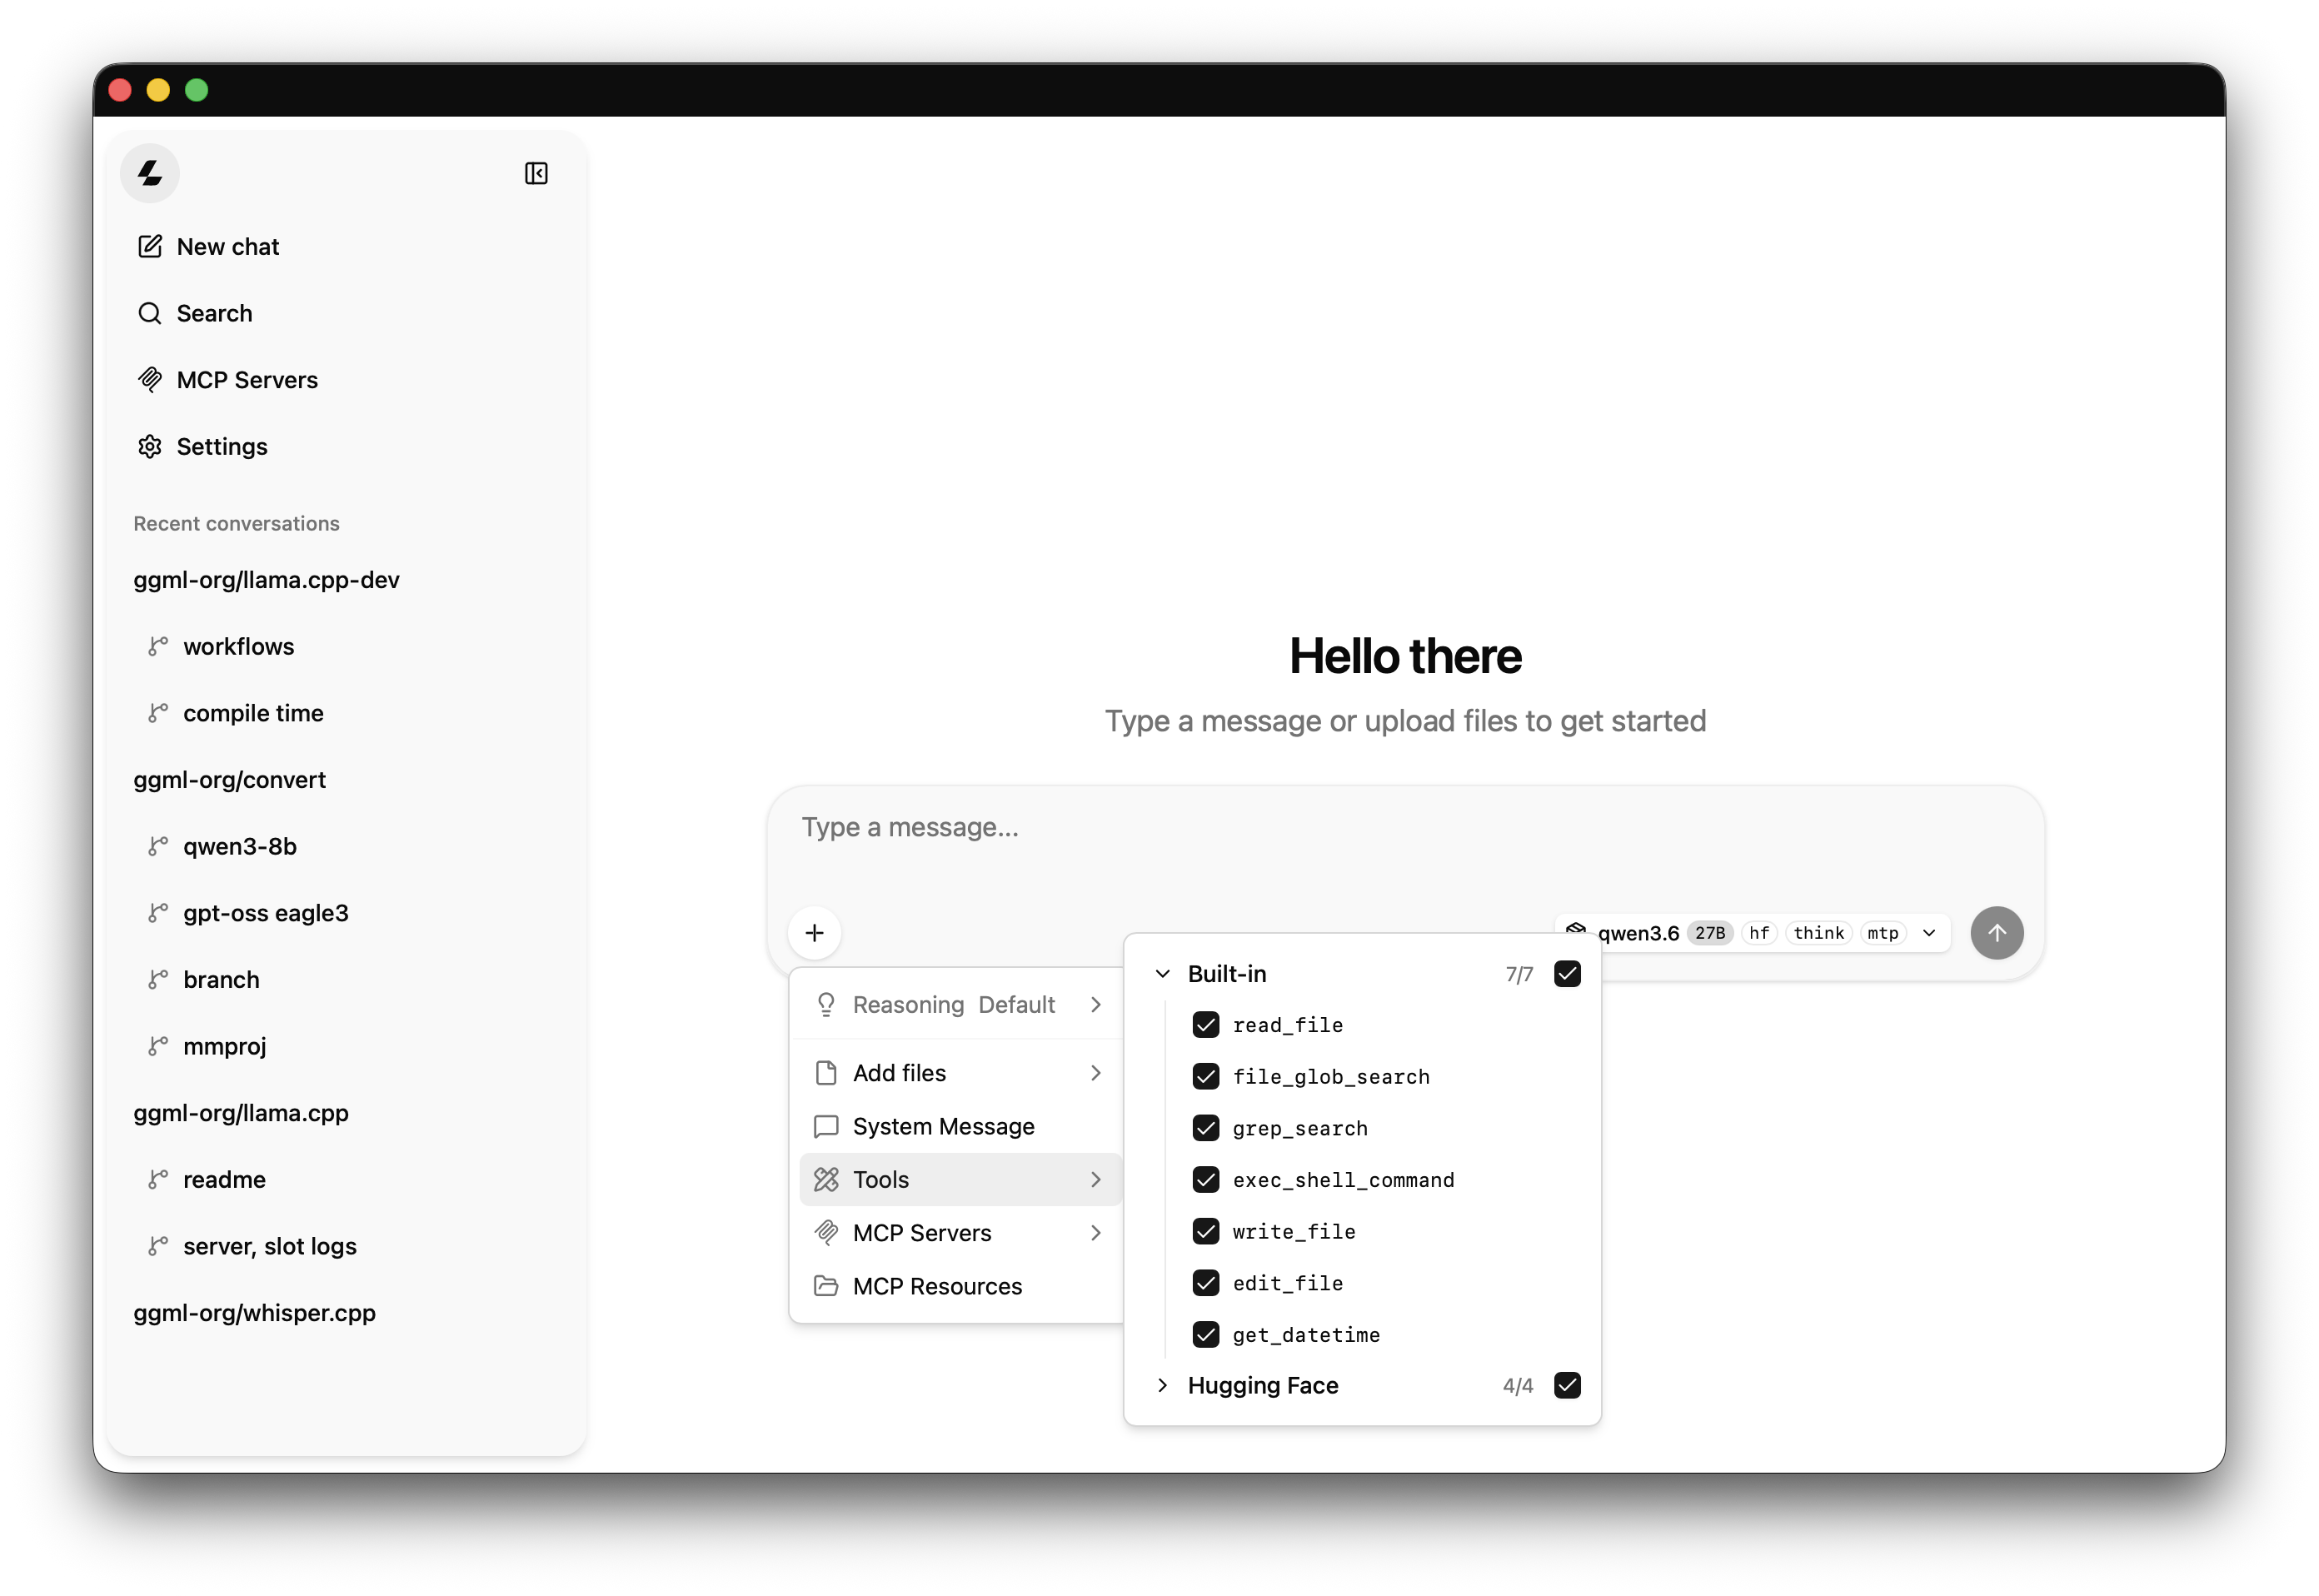
▲ 图 2:llama-server 内置 WebUI 界面,左侧为会话列表,可切换模型、推理模式、内置工具与 MCP 服务(官方截图)
模型量化(llama-quantize)
拿到 FP16 / BF16 原始 GGUF 权重后,可用量化工具压缩到更低位宽:
# 把 F16 模型转换为 Q4_K_M 量化版本
./build/bin/llama-quantize models/model.f16.gguf models/model.Q4_K_M.gguf Q4_K_M
| 量化等级 | 位宽 | 体积相对 F16 | 适用场景 |
|---|---|---|---|
| Q2_K | 约 2.5 bit | 约 18% | 内存极紧张,能接受明显质量损失 |
| Q4_K_M | 约 4.8 bit | 约 28% | 桌面端平衡之选,通用推荐 |
| Q5_K_M | 约 5.7 bit | 约 34% | 质量优先,显存允许时使用 |
| Q6_K | 约 6.6 bit | 约 39% | 接近原始质量的保守选择 |
| Q8_0 | 8 bit | 约 50% | 高质量生成,可作为微调前基线 |
| F16 | 16 bit | 100% | 精度基准,体积最大 |
官方链接
| 资源 | 链接 |
|---|---|
| GitHub 仓库 | github.com/ggml-org/llama.cpp |
| 官网 | llama.app |
| 官方文档 | 仓库 docs 目录 |
| Hugging Face 组织 | huggingface.co/ggml-org |
| Releases 预编译二进制 | github.com/ggml-org/llama.cpp/releases |
| 示例模型 | Qwen3.5-0.8B-GGUF |
常见问题(FAQ)
问:llama.cpp 和 Ollama 是什么关系? Ollama 是在上层把模型拉取、版本管理、服务封装成极简命令的工具,其底层推理引擎正是 llama.cpp。想理解原理、做深度参数调优、嵌入 C/C++ 程序或者在无 Python 环境的机器上部署,直接使用 llama.cpp 更灵活;只想一键对话,Ollama 更省心。
问:为什么模型要用 GGUF 格式? GGUF 是 llama.cpp 生态主推的单文件权重格式,把模型参数、词表、元信息、量化张量打包在一个文件里,加载快、便于分发,也是目前绝大多数本地模型在 Hugging Face 上提供的标准格式。
问:没有独立显卡能跑吗? 可以。默认编译的 CPU 后端即可纯内存推理,小模型(0.8B-3B)在普通笔记本上可完成对话;7B 以上模型建议 16 GB 内存起步,速度以 token/s 计,通常比 GPU 慢一个数量级。
问:显存装不下整个模型怎么办?
用 -ngl 参数控制卸载到 GPU 的层数,剩余层由 CPU 内存承担,形成混合推理;也可以直接选择更小的量化等级(Q4_K_M、Q3_K_S)或更小参数量的模型。
问:量化等级 Q4_K_M 为什么最常用? Q4_K_M 在体积、速度与生成质量之间平衡最好,主观感受接近 F16 的程度高于其他 4 bit 档位,社区绝大多数桌面部署默认采用;质量优先选 Q5_K_M / Q6_K,体积优先选 Q3_K_S / Q2_K。
问:llama-server 提供 OpenAI 兼容接口吗?
提供。服务启动后访问 /v1/chat/completions、/v1/completions 等路径,请求格式与 OpenAI Chat Completions 一致,把 SDK 的 base_url 指向 http://127.0.0.1:8080/v1 即可接入。
许可证
llama.cpp 仓库采用 MIT 许可证,允许自由使用、复制、修改、合并、发布、分发、再授权与商用,仅需在软件副本中保留版权声明与许可文本。需要注意的是:通过它加载的各个模型权重分别遵循其自身许可证(如 Llama 系列为 Meta 社区许可、Qwen 系列多为 Apache 2.0 等),商用前请以对应模型卡的标注为准;llama.cpp 自身仅提供推理代码与计算库,不捆绑任何模型权重。