

VLMEvalKit:OpenCompass 团队开源的大视觉-语言模型一键评测工具包|部署与使用全指南
项目仓库: https://github.com/open-compass/VLMEvalKit
开源协议:Apache 2.0(按仓库 LICENSE) · 交付形态:Python 包
vlmeval · 定位:大视觉-语言模型(LVLM)一键评测 ·
支持模型:200+(含商业 API 与开源模型) · 支持基准:70+ 图像与视频基准 ·
推理加速:LMDeploy / vLLM 多节点分布式 · 官方报告:arxiv.org/abs/2407.11691
官方维护状态说明:VLMEvalKit 由上海 AI 实验室 OpenCompass 团队维护,2025–2026 年持续迭代,已支持 InternVL3、Qwen2.5-VL、LLaMA4、Gemini-2.5-Pro、Kimi-VL、Grok 等新模型,并新增 Video-MME-v2、SeePhys、PhyX 等基准。本文命令取自官方 README。
1 项目简介
VLMEvalKit 是一个开源的大视觉-语言模型评测工具包,Python 包名为
vlmeval。它让用户可以在多个基准上一键评测
LVLM,无需在多个仓库下做繁琐的数据准备。VLMEvalKit 对所有 LVLM
采用基于生成的评测,并同时提供精确匹配与 LLM
答案抽取两种评分方式。开发者只需实现一个 generate_inner()
函数即可接入新模型,数据下载、预处理、推理、指标计算由工具包自动完成。
非官方 / 第三方边界声明:VLMEvalKit 代码开源;被测模型权重与商业 API 归各厂商所有。本文不提供模型权重。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | VLMEvalKit(Python 包 vlmeval) |
| 仓库地址 | github.com/open-compass/VLMEvalKit |
| 项目定位 | 大视觉-语言模型一键评测工具包 |
| 开源协议 | Apache 2.0 |
| 支持模型 | 200+(商业 API + 开源模型) |
| 支持基准 | 70+ 图像与视频基准 |
| 推理加速 | LMDeploy(InternVL、QwenVL、LLaMA4)、vLLM(QwenVL、LLaMA4) |
| 多节点分布式 | 支持(2025/05 起) |
| 技术报告 | arxiv.org/abs/2407.11691 |
| 在线榜单 | HF OpenVLM Leaderboard |
1.2 适用场景
- VLM 开发者需要在 MMBench、MMMU、SEEDBench、Video-MME 等主流基准上横向对比模型。
- 多模态团队需要快速接入新模型,只需实现一个
generate_inner()。 - 需要在大规模 / 长输出 / 思维链模型上加速评测(LMDeploy / vLLM 多节点)。
- 需要可复现的开源评测结果,避免在多个仓库间重复造轮子。
1.3 能力边界(官方口径)
- 工具包不追求复现第三方论文原始精度数字:部分基准用 PPL 评测(如 SEEDBench),而 VLMEvalKit 统一用生成式评测,因此分数会有差异。
- 默认对所有 VLM 使用同一 prompt 模板;若某模型有专用模板,结果可能与论文不同。
- 不同 VLM 对
transformers/torchvision/flash-attn版本有硬性要求,需按 README 推荐版本安装。
2 功能特性
2.1 一键评测与可复现
- 一条命令在多个基准上评测 LVLM,自动处理数据下载、预处理、推理与指标计算。
- 提供精确匹配与 LLM 答案抽取两种评分。
2.2 广泛模型与基准覆盖
- 200+ 模型:商业 API(OpenAI、Claude、Gemini、豆包等)与开源模型(InternVL、Qwen-VL、LLaVA、MiniCPM-V、GLM-4v、Molmo、Aria、PaliGemma 等)。
- 70+ 基准:MMBench、MMMU-Pro、WeMath、HLE-Bench、Video-MME-v2、SeePhys、PhyX、NaturalBench、VisOnlyQA 等。
2.3 思维链与长输出处理(2025/09 新增)
- 通过环境变量
SPLIT_THINK=True启用对思维链模型的<think>...</think>标签拆分,提升评测准确性。 - 通过环境变量
PRED_FORMAT=tsv将预测文件保存为 TSV,避免.xlsx单元格 32767 字符上限导致长输出(>16k/32k tokens)被截断。
2.4 分布式推理加速
- 2025/05 起支持基于 LMDeploy 或 vLLM
的多节点分布式推理;在模型配置中加
use_lmdeploy或use_vllm即可启用。
2.5 国内数据加速
- 设置环境变量
VLMEVALKIT_USE_MODELSCOPE可从 ModelScope 下载视频基准。
3 官方界面预览
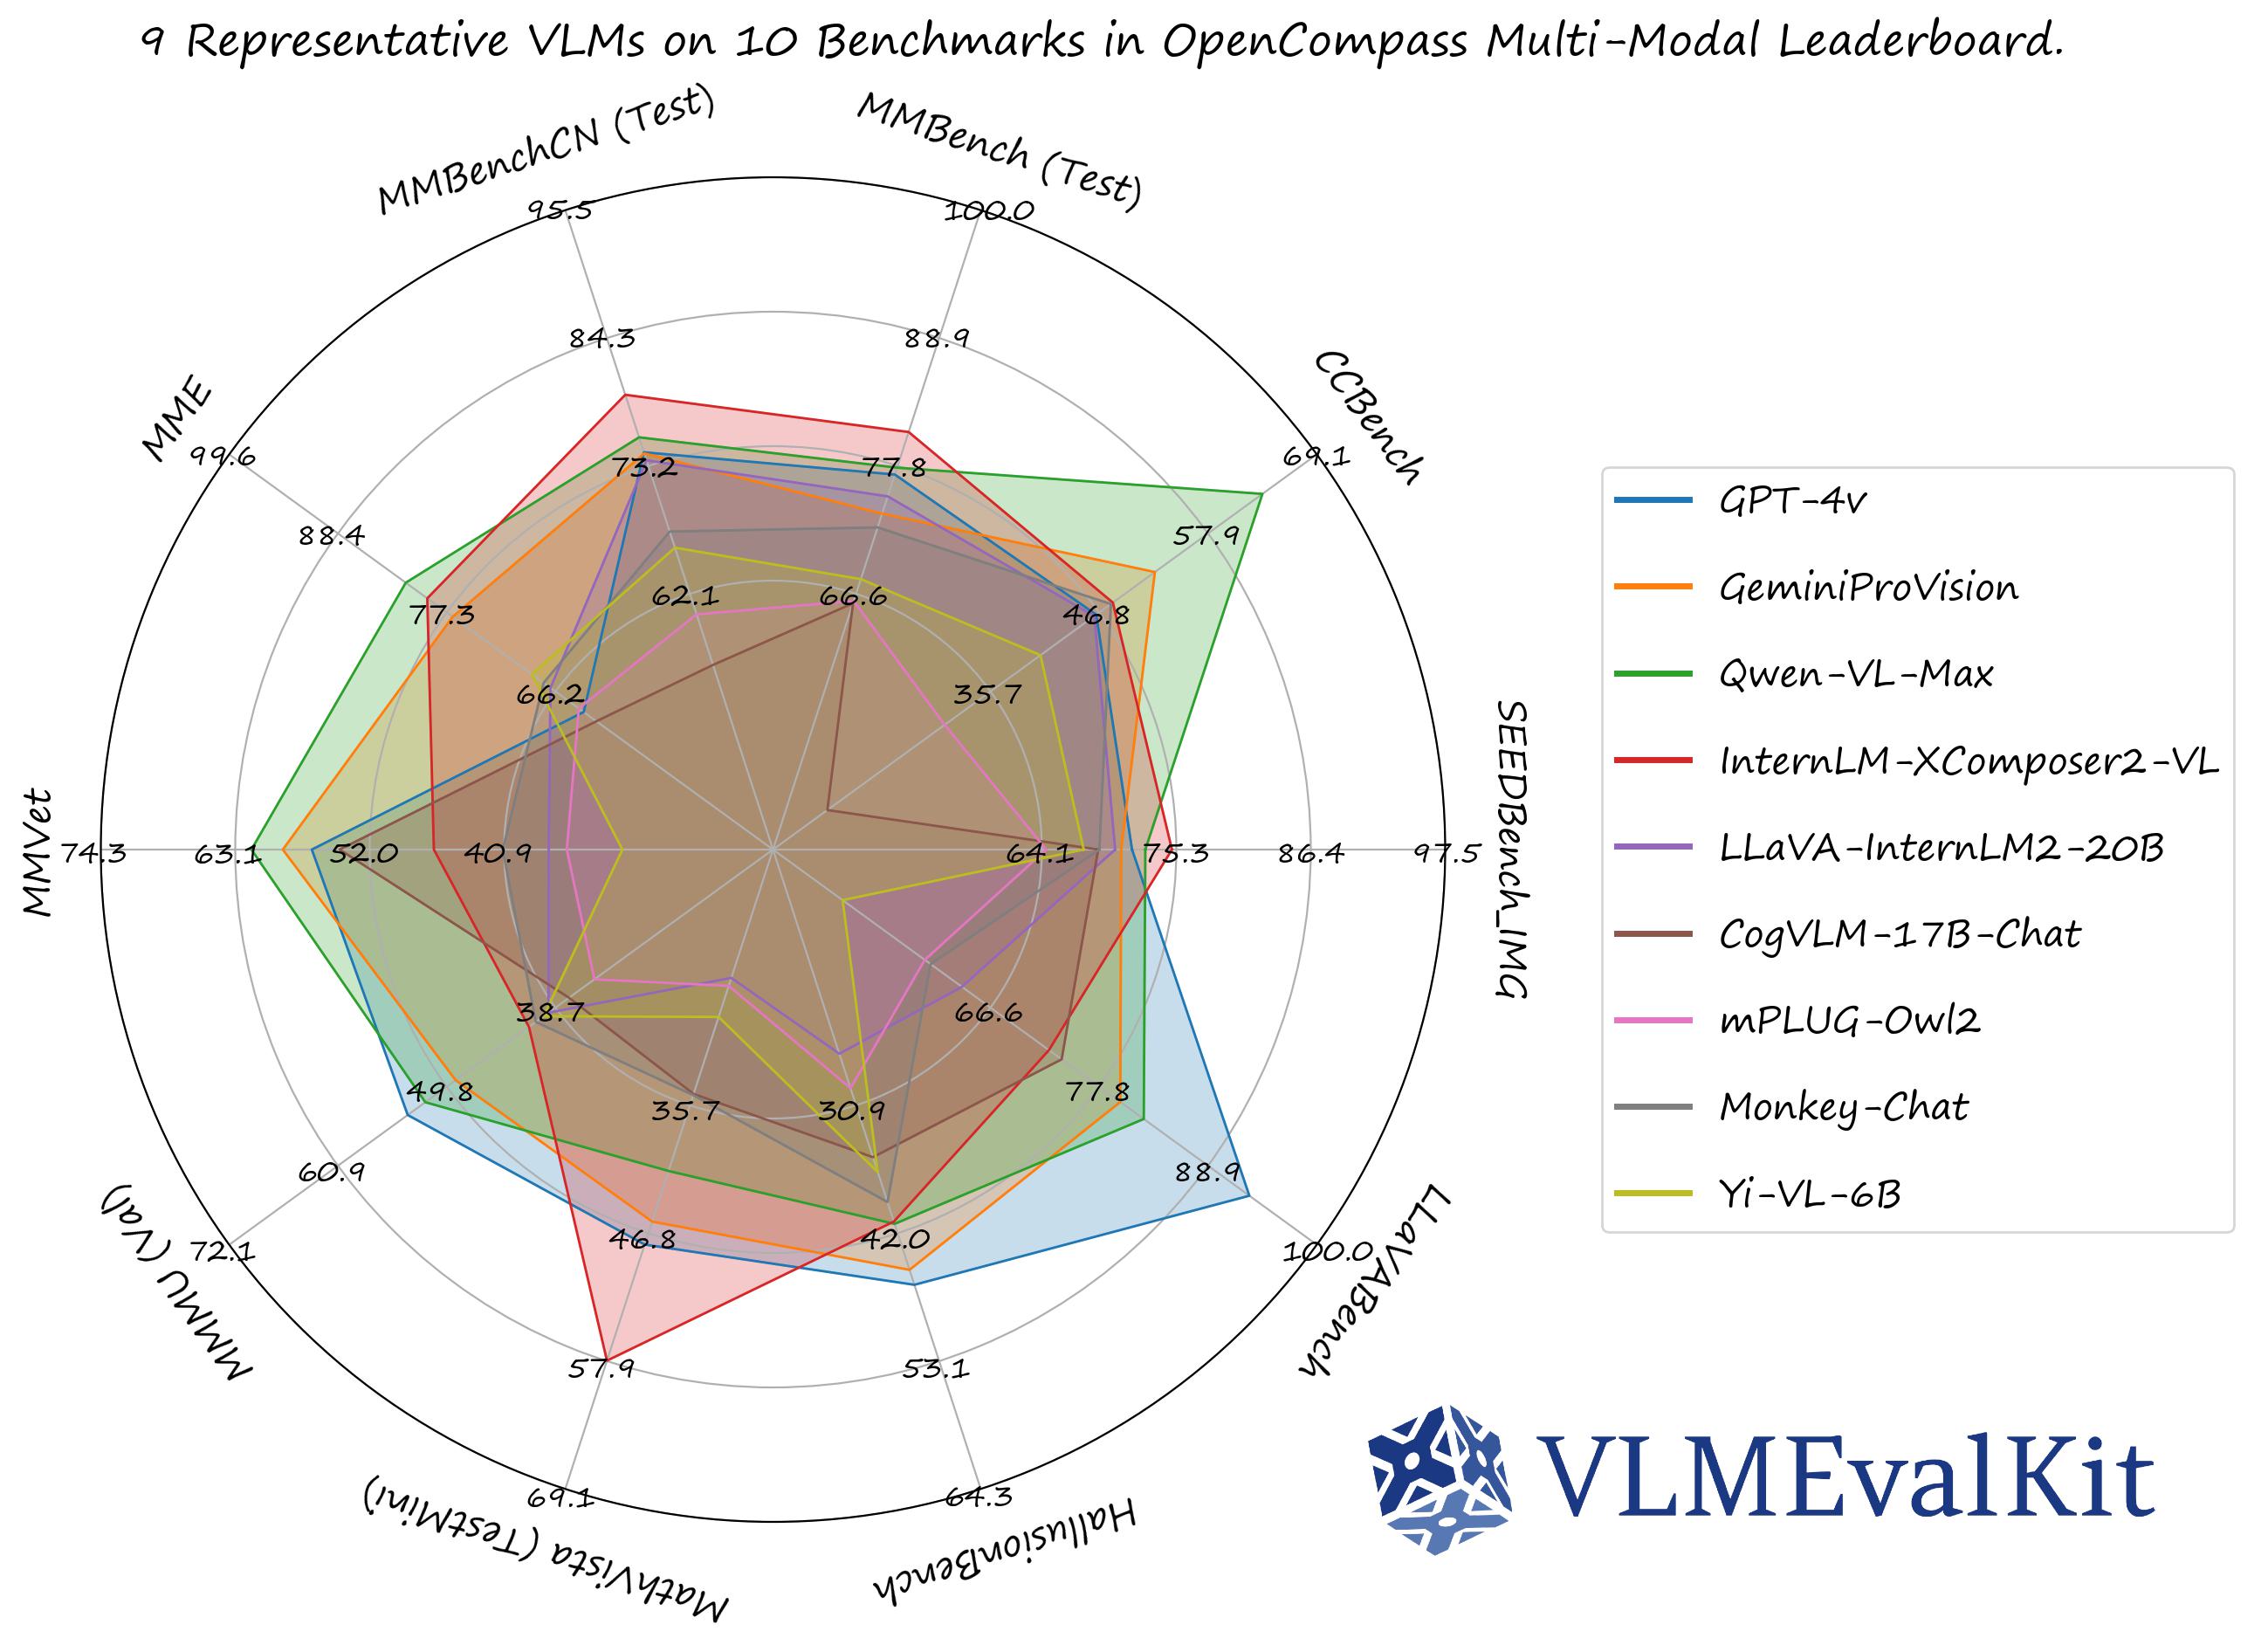
图 1 为官方 README 顶部的 VLMEvalKit Logo。
4 官方跳转链接汇总
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库主页 | github.com/open-compass/VLMEvalKit | 源码、examples、config |
| 快速开始 | docs/en/Quickstart.md | 安装与首个评测 |
| 开发指南 | docs/en/Development.md | 自定义模型与基准 |
| 在线榜单 | HF OpenVLM Leaderboard | 多模态榜单 |
| 视频榜单 | HF OpenVLM Video Leaderboard | 视频理解榜单 |
| 评测记录 | HF VLMEval/OpenVLMRecords | 历史评测数据 |
| 官方榜单 | rank.opencompass.org.cn/leaderboard-multimodal | OpenCompass 多模态榜 |
| 功能矩阵 | 飞书多维表 | 支持模型与基准清单 |
| 技术报告 | arxiv.org/abs/2407.11691 | ACM MM 2024 |
| Discord | discord.gg/evDT4GZmxN | 社区 |
5 前置要求与服务器配置
5.1 软件前提
- Linux(推荐 Ubuntu 20.04/22.04)。
- Python 3.10+。
- NVIDIA GPU + CUDA(评测开源模型时;API 评测不需要 GPU)。
- 按被测模型选择对应的
transformers/torchvision/flash-attn版本。
5.2 transformers 版本要求(官方 README 摘录)
| transformers 版本 | 适用模型 |
|---|---|
| 4.33.0 | Qwen、Monkey、InternLM-XComposer、mPLUG-Owl2、OpenFlamingo v2、IDEFICS、VisualGLM 等 |
| 4.37.0 | LLaVA、ShareGPT4V、CogVLM、EMU2、Yi-VL、MiniCPM-V1/V2、DeepSeek-VL、InternVL、Cambrian、VILA 等 |
| 4.40.0 | IDEFICS2、Bunny-Llama3、MiniCPM-Llama3-V2.5、Phi-3-Vision |
| 4.48.0 | LLaVA-Next 系列 |
| latest | PaliGemma、Chameleon、Video-LLaVA-7B-HF、Ovis、Mantis、MiniCPM-V2.6、GLM-4v-9B、Llama-3.2 等 |
| ≥5.2.0 | Qwen3.5 系列 |
5.3 硬件建议
| 场景 | 推荐配置 |
|---|---|
| 仅 API 评测 | 普通 CPU 服务器 |
| 7B–13B 开源 VLM | 单张 24GB 显存 GPU |
| 70B 级 VLM | 多卡 A100 / H100 80GB |
| 多节点分布式 | 多节点 GPU 集群 + LMDeploy / vLLM |
6 方式一:pip 安装与 Python 调用
6.1 安装
# 推荐在独立 conda 环境中安装
conda create -n vlmeval python=3.10 -y
conda activate vlmeval

pip install vlmeval
6.2 最小 Python 示例
from vlmeval.config import supported_VLM
model = supported_VLM['idefics_9b_instruct']()

# 单图
ret = model.generate(['assets/apple.jpg', 'What is in this image?'])
print(ret)

# 多图
ret = model.generate(['assets/apple.jpg', 'assets/apple.jpg',
                      'How many apples are there in the provided images?'])
print(ret)
6.3 思维链与长输出开关
# 思维链模型(QwQ、R1 类)
export SPLIT_THINK=True

# 长输出模型(>16k tokens)
export PRED_FORMAT=tsv

# 国内视频基准走 ModelScope
export VLMEVALKIT_USE_MODELSCOPE=True
7 方式二:源码安装与基准评测
7.1 源码安装
git clone https://github.com/open-compass/VLMEvalKit.git
cd VLMEvalKit
pip install -e .
7.2 跑基准评测
完整命令行参数见 Quickstart。典型形式为指定模型名与基准名,工具包自动下载数据并输出结果。
7.3 多节点分布式加速
在模型配置(vlmeval/config.py)中为目标模型加
use_lmdeploy 或 use_vllm
标志,即可启用对应推理后端;具体支持矩阵见 README(LMDeploy 支持
InternVL、QwenVL、LLaMA4;vLLM 支持 QwenVL、LLaMA4)。
8 配置项说明
| 环境变量 | 作用 |
|---|---|
SPLIT_THINK=True |
拆分 <think>...</think>
标签,提升思维链模型评测准确性 |
PRED_FORMAT=tsv |
预测结果存 TSV,避免 xlsx 单元格 32767 字符截断 |
VLMEVALKIT_USE_MODELSCOPE |
视频基准从 ModelScope 下载 |
OPENAI_API_KEY 等 |
商业 API 评测时的密钥 |
模型配置中的 use_lmdeploy / use_vllm
标志用于启用分布式推理后端。
9 常用运维命令
# 查看已安装版本
pip show vlmeval

# 查看 GPU 占用
nvidia-smi

# 查看已下载数据集
ls data/

# 停止评测任务
# Ctrl+C;多进程时 pkill -f "vlmeval"
10 常见故障排查
- 模型加载失败 / transformers 报错:按 README
表格选择与被测模型匹配的
transformers版本;不同模型不能混用同一环境。 - 长输出被截断:设置
PRED_FORMAT=tsv。 - 思维链模型分数偏低:设置
SPLIT_THINK=True,必要时参考 InternVL 实现自定义split_think函数。 - 视频基准下载慢:设置
VLMEVALKIT_USE_MODELSCOPE=True。 - Aria 模型需
flash-attn:
pip install flash-attn --no-build-isolation。 - 结果与论文不一致:VLMEvalKit 统一用生成式评测,部分论文用 PPL;这是设计取舍,不是 bug。
11 风险与合规说明
- API 费用:评测商业 API 模型会产生费用;大规模基准成本可观。
- 数据隐私:图片与问题会发送到第三方 API,敏感数据请勿用于 API 评测。
- 模型许可:开源 VLM 权重按各自许可使用;VLMEvalKit 代码 Apache 2.0。
- 版本依赖复杂:不同模型对 transformers / torchvision / flash-attn 版本要求不同,建议按模型建独立环境。
- 本文非官方文档:命令与配置以 github.com/open-compass/VLMEvalKit 最新 README 与 Quickstart 为准。