
vLLM:高吞吐 LLM 推理服务引擎|部署与使用全指南
基于 PagedAttention 与连续批处理,把单张 GPU 的大模型并发吞吐拉满,自带 OpenAI 兼容接口,是生产环境部署 LLM 服务的主流选择。
| 项目 | 信息 |
|---|---|
| 官方仓库 | vllm-project/vllm |
| 官方文档 | docs.vllm.ai |
| 官网 | vllm.ai |
| 支持模型清单 | supported_models |
| 语言 / 许可 | Python / Apache-2.0 |
▲ 图 0:vLLM 官方文字 Logo(浅色版,官方品牌素材)
项目简介
vLLM 是目前应用最广的开源 LLM 推理服务引擎之一,最初由加州大学伯克利分校 Sky Computing Lab 提出,如今由 vllm-project 社区持续维护。截至 2026 年 10 月 25 日,其 GitHub 仓库已收获约 9.54 万 star(95,395),fork 数约 2.39 万(23,915),在大模型服务化赛道上长期处于第一梯队。它背后的核心论文《Efficient Memory Management for Large Language Model Serving with PagedAttention》已成为推理引擎领域的经典文献。
与面向个人桌面的本地运行工具不同,vLLM 的设计目标是在服务器 GPU 集群上稳定地服务大量并发请求:在线聊天机器人、RAG 知识库后端、Agent 平台、批量离线推理、模型评测与微调流水线,都是它的典型场景。部署完成后,它对外暴露一套与 OpenAI 兼容的 HTTP 接口,已有基于 OpenAI SDK 编写的应用几乎无需改动即可把后端切换过来。
vLLM 服务端本身不捆绑模型权重,启动时按指定的模型名从 Hugging Face 等公开仓库拉取;引擎侧重显存管理、批处理调度、多卡并行与生产级观测,而把模型本身留给使用者按需选择。
核心能力与特性
- PagedAttention 显存管理:把 KV Cache 像操作系统虚拟内存一样按固定分页管理,显著消除显存碎片,同等显存下可承载更长上下文与更多并发请求。
- Continuous Batching 连续批处理:不等整批请求全部完成再拼批,新请求随时插入正在执行的批次,请求长短不一时 GPU 利用率依然保持高位。
- OpenAI 兼容 API:
vllm serve直接暴露/v1/chat/completions、/v1/completions、/v1/embeddings等端点,支持 SSE 流式输出。 - 覆盖主流开源模型:Llama、Qwen、DeepSeek、Mistral、Gemma、Grok、GPT-OSS 等常见架构均有适配,最新支持范围以官方模型清单为准。
- 量化与并行推理:支持 AWQ、GPTQ、FP8、INT8、compressed-tensors 等量化方案;提供张量并行、流水线并行与多机多卡调度,
--tensor-parallel-size一行参数即可拆分大模型。 - 多硬件后端:以 NVIDIA GPU 为主力场景,同时提供 AMD ROCm、Intel Gaudi 与 XPU、Google TPU、华为昇腾 NPU、Apple Silicon 与 CPU 后端,CPU 后端主要用于小模型调试。
- 生产级运行时:内置 Prometheus 指标、LoRA 热加载、前缀缓存、结构化输出、投机解码、日志统计等能力,适合长期在线服务。
- 容器与集群部署:提供官方 Docker 镜像与 Helm Chart,可直接接入 Kubernetes 集群做副本扩缩容与负载均衡。
硬件与系统要求
vLLM 以 GPU 场景为核心优化方向,纯 CPU 或 Apple Silicon 后端仅建议用于小模型验证与开发调试。
| 项目 | 最低要求 | 推荐配置 |
|---|---|---|
| GPU | CPU 后端 / Apple Silicon(0.5B-1.5B 小模型调试) | NVIDIA 算力 7.5+:T4、RTX 20xx、A100、L4、H100、B200;生产环境建议 A100 80GB / H100 多卡 |
| 显存 | 7B 量化模型(AWQ)约 6 GB 起步 | 7B FP16 约 14 GB;70B 级模型需多卡张量并行 |
| 内存 | 32 GB 系统内存 | 64 GB 以上,配合模型加载与批量调度 |
| 操作系统 | Linux 发行版 | Linux(Ubuntu 22.04 / 24.04 等),NVIDIA 驱动 + CUDA 12.8 / 13 工具链 |
| 运行环境 | Python 3.12 | Python 3.12 + uv 或 pip,虚拟环境隔离 |
| 磁盘 | 模型权重另计:7B 约 15 GB(FP16),70B 约 140 GB | 预留高速 SSD 空间与模型缓存目录 |
完整部署方式
环境准备
vLLM 官方推荐 Python 3.12 环境与 uv 包管理器;NVIDIA 机器需先装好显卡驱动、CUDA 12.8 或 13,并配置好容器工具链(如使用 Docker)。
# 确认 Python 版本为 3.12
python3 --version

# 安装 uv(官方推荐的高速包管理器)
curl -LsSf https://astral.sh/uv/install.sh | sh
方式一:pip 安装并下载预编译内核(推荐)
# 创建 Python 3.12 虚拟环境并激活
uv venv .venv --python 3.12
source .venv/bin/activate

# 安装 vLLM 主包(README 推荐命令)
uv pip install vllm

# 下载 CUDA 预编译内核,避免首次启动时现场编译算子
vllm download-kernels

# 验证安装
vllm --help
方式二:官方 Docker 镜像部署
# 以 NVIDIA GPU 为例,需提前安装 NVIDIA Container Toolkit
# 挂载 Hugging Face 缓存目录,暴露 8000 端口,启动 7B 对话模型
docker run --rm --gpus all \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:latest \
  --model Qwen/Qwen2.5-7B-Instruct --port 8000 --host 0.0.0.0
方式三:源码编译(进阶,参与开发或定制算子)
git clone https://github.com/vllm-project/vllm.git
cd vllm

# 以可编辑模式安装;源码编译依赖匹配的 CUDA 工具链,耗时较长
pip install -e . --no-build-isolation
使用方法
启动 OpenAI 兼容服务
# 启动对话模型服务,监听 8000 端口,设置显存占用上限与上下文长度
vllm serve Qwen/Qwen2.5-7B-Instruct \
  --host 0.0.0.0 --port 8000 \
  --gpu-memory-utilization 0.9 \
  --max-model-len 32768

# 服务地址:http://localhost:8000
# OpenAI 兼容端点:http://localhost:8000/v1/chat/completions
# 用 curl 发起一次对话请求
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen/Qwen2.5-7B-Instruct",
    "messages": [{"role": "user", "content": "你好,介绍一下你自己"}],
    "temperature": 0.7
  }'
OpenAI SDK 接入
服务启动后,现有 OpenAI 客户端只需把 base_url 指向 vLLM 地址即可,模型名填服务加载的模型标识:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="EMPTY",  # vLLM 默认不校验密钥,占位即可
)

resp = client.chat.completions.create(
    model="Qwen/Qwen2.5-7B-Instruct",
    messages=[{"role": "user", "content": "用一句话介绍 vLLM"}],
    stream=False,
)
print(resp.choices[0].message.content)
量化与张量并行
显存紧张时可选择量化模型与量化方案;大模型跨多卡拆分时用张量并行参数:
# 两卡张量并行运行 70B 级模型,指定 AWQ 量化方案
vllm serve Qwen/Qwen2.5-72B-Instruct \
  --tensor-parallel-size 2 \
  --quantization awq \
  --port 8000

# 其他常用量化:gptq / fp8 / int8 / compressed-tensors
# 并发与调度相关参数:--max-num-seqs、--max-model-len、--enable-prefix-caching
Kubernetes / Helm 部署架构
面向生产集群时,官方提供 Helm Chart 将 vLLM 以 Deployment 形式部署。典型流程为:先由独立 Job 把模型权重与配置文件从对象存储(如 S3)下载到持久卷(Persistent Volume);Pod 内的 Init Container 等待下载任务完成后,再启动正式的 Deployment Container 加载模型对外服务。
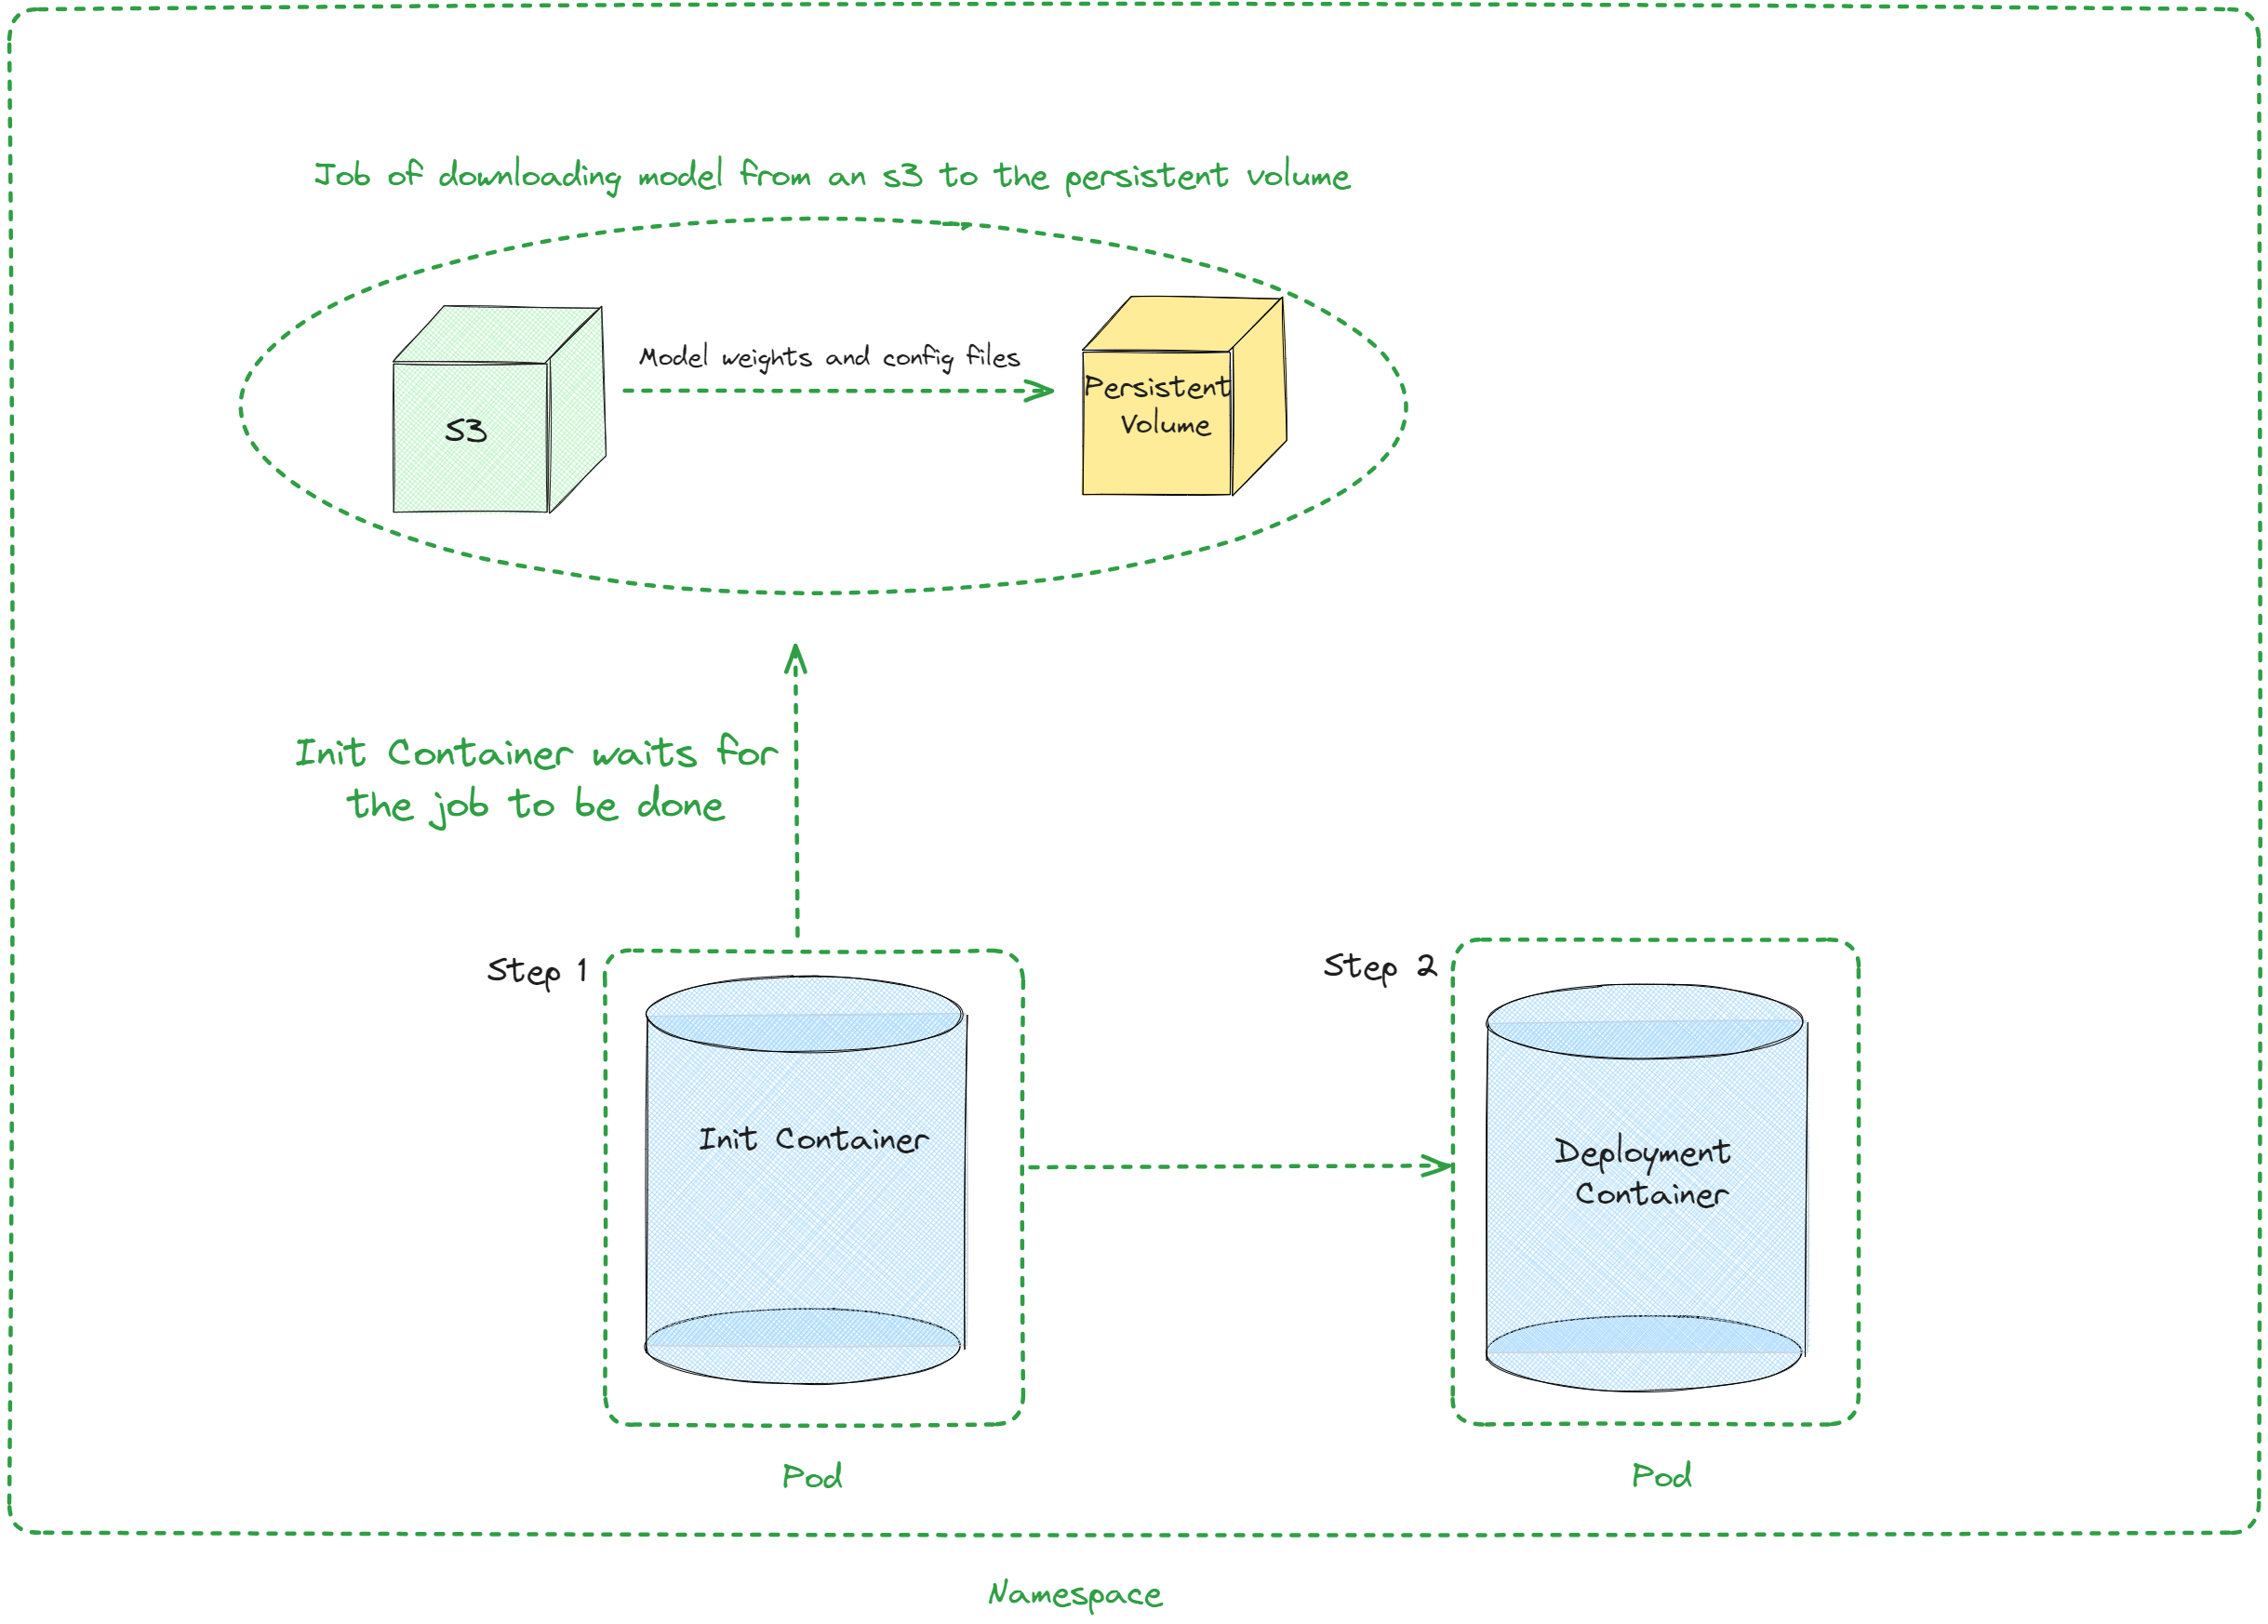
▲ 图 1:vLLM 在 Kubernetes / Helm 下的部署架构:S3 下载模型到持久卷,Init Container 等待完成后再启动 Deployment Container(官方架构图)
官方链接
| 资源 | 链接 |
|---|---|
| GitHub 仓库 | github.com/vllm-project/vllm |
| 官网 | vllm.ai |
| 官方文档 | docs.vllm.ai/en/latest |
| 支持模型清单 | supported_models.html |
| 研究论文 | PagedAttention (arXiv:2309.06180) |
常见问题(FAQ)
问:vLLM 和 Ollama、llama.cpp 有什么区别? Ollama、llama.cpp 面向个人本地桌面,主打一条命令跑小模型、轻量化与跨 CPU/GPU 后端;vLLM 面向服务器生产环境,主打高并发吞吐、多卡并行与服务化调度,主要运行在 NVIDIA GPU 上。个人尝鲜用前者,团队在线服务选 vLLM 这类引擎更合适。
问:vLLM 安装后会自带模型权重吗?
不会。引擎本身只提供推理服务与调度能力,启动命令里的 --model 指定哪个模型,就从 Hugging Face 等仓库拉取哪个模型的公开权重;模型各自的许可证需要单独遵守。
问:没有 NVIDIA 显卡能跑 vLLM 吗? 可以在 CPU 后端、Apple Silicon、AMD ROCm、Intel XPU/Gaudi、TPU、华为昇腾等后端运行,但性能、模型覆盖度与成熟度均以 NVIDIA 最佳;CPU 后端只适合 1B 级小模型的功能验证,不要用于生产并发场景。
问:显存不够加载大模型怎么办?
优先选用 AWQ、GPTQ、FP8 等量化版本;其次用 --tensor-parallel-size 把模型拆分到多张卡;也可以下调 --max-model-len 上下文长度与 --gpu-memory-utilization 上限,并配合 --max-num-seqs 限制并发序列数。
问:vLLM 接口兼容 OpenAI 吗?支持流式输出吗?
兼容。/v1/chat/completions、/v1/completions、/v1/embeddings 等路径与参数对齐 OpenAI 协议,SDK 只需替换 base_url;调用时设置 stream: true 即可获得 SSE 流式返回。
问:怎么确认我要用的模型被 vLLM 支持? 查阅官方支持模型清单,常见的 Llama、Qwen、DeepSeek、Mistral、Gemma 系列均已适配;清单之外的模型可能需要等待社区补全或自行注册模型实现。
许可证
vLLM 仓库采用 Apache-2.0 许可证,允许自由使用、复制、修改、合并、发布、分发、再授权与商用,并包含明确的专利授权条款;使用时需在软件副本中保留版权声明与许可文本。需要注意的是:通过 vLLM 加载的各模型权重分别遵循其自身许可证,商用前请以对应模型卡的标注为准,vLLM 仓库本身不捆绑任何模型文件。