
LlamaIndex:构建 RAG 与 Agentic 应用的开源框架|部署与使用指南
一套把私有文档变成可检索索引、再交给大模型生成答案的 Python 框架:加载、索引、存储、查询、生成五步打通,云端 API 与本地 Ollama 模型都能接入。
| 项目 | 信息 |
|---|---|
| 官方仓库 | run-llama/llama_index |
| 官方文档 | developers.llamaindex.ai/python/framework |
| 官网 | developers.llamaindex.ai |
| GitHub Star / Fork | 52,651 star / 8,423 fork(截至 2026-10-25) |
| 语言 / 许可 | Python / MIT |
| 最近推送 | 2026-10-23 |

▲ 图 0:LlamaIndex 官方方形 Logo(官方 Logo)
项目简介
LlamaIndex 是一套面向 RAG(检索增强生成)与 Agentic 应用的 Python 开源框架,核心任务是把私有文档——PDF、Word、Markdown、TXT、网页、数据库记录等——接入大模型:框架负责文档加载、切块、嵌入、建索引与检索,大模型负责基于检索到的片段组织回答。截至 2026 年 10 月 25 日,仓库已收获约 5.27 万 star(52,651)、8,423 个 fork,是构建知识库问答、文档助手与多步推理 Agent 最主流的开源框架之一。
框架本身不携带任何模型权重,也不绑定单一模型厂商:大模型与嵌入模型都通过独立的集成包接入,云端可选 OpenAI、Anthropic、Gemini 等提供商并使用对应 API Key;本地场景可配合 Ollama 运行开源大模型,搭配 HuggingFace 本地嵌入模型,实现全程离线的私有化 RAG。
需要说明的是,LlamaIndex 团队近年把主要精力转向企业级文档解析平台 LlamaParse(OCR、结构化抽取、文档 Agent),开源框架仍作为开放工具包持续维护;除框架外,团队还提供开源轻量解析器 LiteParse 与文档解析基准评测,供开发者按需组合使用。
核心能力与特性
- RAG 全流程组件化:文档加载器、切块器、节点后处理、索引、查询引擎、响应合成器都以可替换组件形式提供,按场景自由拼装。
- 多种索引类型:向量索引、关键词索引、列表索引、树索引、知识图谱索引、文档摘要索引等,支持索引之间组合与嵌套。
- 模型与向量库解耦:官方维护三百余个集成包,覆盖主流 LLM、嵌入模型与向量数据库,包括 PGVector、Chroma、Qdrant、Milvus、Weaviate、Pinecone 等。
- Agent 工作流编排:内置工具调用、查询路由、子查询分解与工作流编排能力,可构建多步推理、自主调用工具的 Agentic 应用。
- 存储可持久化:默认索引保存在内存中,可一键持久化到磁盘或外部向量库,进程重启后直接重载,无需重新嵌入全部文档。
- 本地模型友好:通过 Ollama 集成包接入本地大模型,通过 HuggingFace 集成包接入本地嵌入模型,内网与断网环境也能跑通完整 RAG 链路。
- 配套解析生态:LlamaParse 云端平台负责复杂 PDF、扫描件、表格与图表的高质量解析;LiteParse 是开源的轻量免费解析器,可作为本地替代。
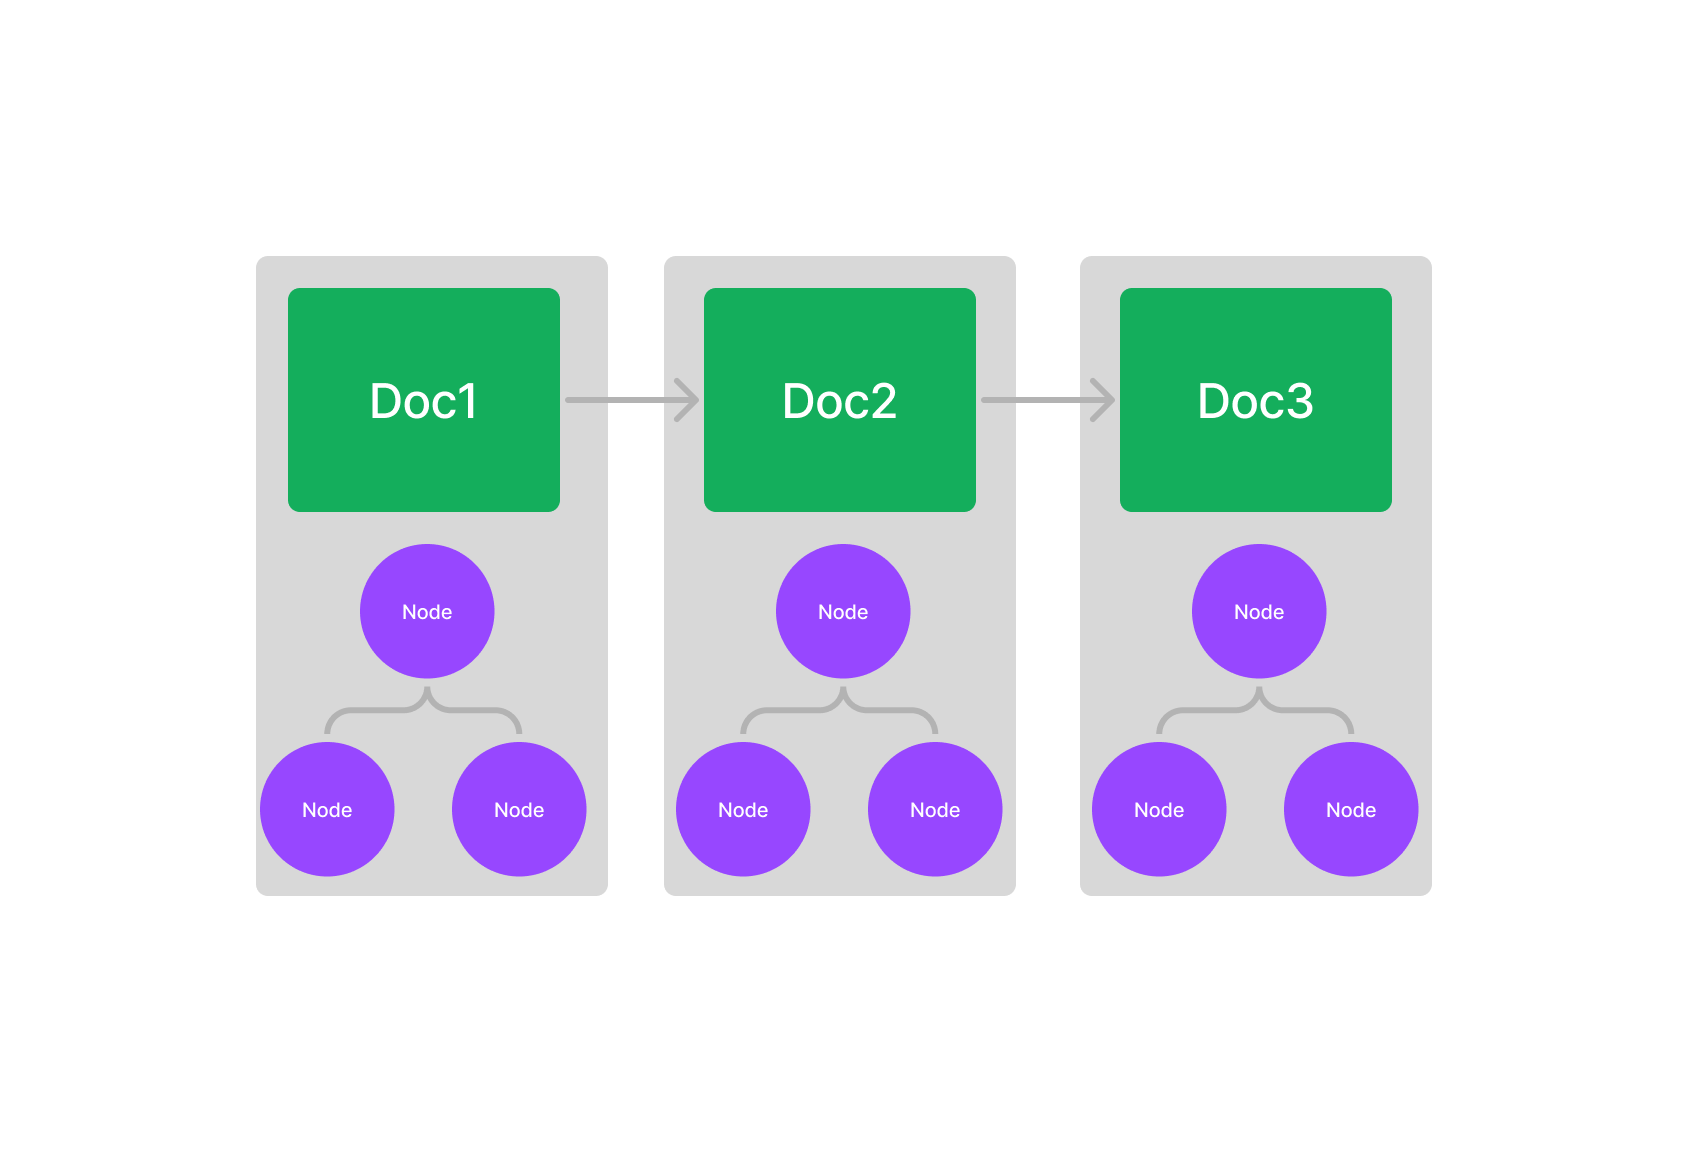
▲ 图 1:文档拆分节点并逐层组织成索引的结构示意(官方架构图)
硬件与系统要求
LlamaIndex 是纯 Python 框架,自身资源占用很低;是否需要高配硬件,取决于你使用云端 API 还是本地模型:
| 项目 | 最低要求 | 推荐配置 |
|---|---|---|
| CPU | 双核 x86-64(仅调用云端 API) | 4 核以上;本地跑嵌入模型与小 LLM 建议 8 核 |
| 内存 | 4 GB(云端 API 模式) | 8 GB 以上;本地嵌入模型 + 本地 7B 大模型建议 16 GB |
| GPU | 可选,纯云端 API 无需独显 | NVIDIA 显卡可加速本地嵌入模型与小模型推理 |
| 操作系统 | Windows、macOS、Linux,Python 3.10 至 3.13(要求 >=3.10,<4.0) |
同左 |
| 磁盘 | 5 GB 起(Python 环境与依赖缓存) | 10 GB 以上;本地模型权重另计,7B 量化约 4 GB |
完整部署方式
环境准备:Python 虚拟环境
先确认本机 Python 版本满足 >=3.10,<4.0,再创建独立虚拟环境,避免污染系统 Python:
# 查看 Python 版本
python --version

# 创建虚拟环境
python -m venv .venv

# Linux / macOS 激活虚拟环境
source .venv/bin/activate

# Windows PowerShell 激活方式
# .venv\Scripts\Activate.ps1
方式一:Starter 包一键安装(新手推荐)
llama-index 是官方 starter 包,包含核心框架与一批常用集成,适合快速上手:
# 升级 pip 后安装 starter 包
pip install -U pip
pip install -U llama-index
方式二:核心包 + 按需集成(生产环境推荐)
精简部署时先安装 llama-index-core 核心包,再按实际需要挑选集成包,避免引入用不到的依赖:
# 安装核心框架
pip install -U llama-index-core

# 按需安装集成包(示例:OpenAI、Ollama、HuggingFace 嵌入模型)
pip install llama-index-llms-openai
pip install llama-index-llms-ollama
pip install llama-index-embeddings-huggingface
集成包与核心包的命名约定:导入语句中带 core 的来自核心包(如 llama_index.core),不带 core 的来自对应集成包(如 llama_index.llms.openai)。
方式三:从源码安装(进阶)
需要阅读源码或参与贡献时,克隆仓库后以可编辑模式安装:
# 克隆官方仓库
git clone https://github.com/run-llama/llama_index.git
cd llama_index

# 可编辑模式安装
pip install -e .
模型与密钥准备
框架不自带模型权重,构建索引前必须先配置好 LLM 与嵌入模型,二选一或混合使用:
- 云端模式:在环境变量中设置对应提供商的 API Key,例如 OpenAI 的
OPENAI_API_KEY;嵌入模型默认跟随所选 LLM 提供商。 - 本地模式:先安装并启动 Ollama,拉取需要的大模型(如
ollama pull llama3.1);嵌入模型由 HuggingFace 集成包在首次运行时自动下载到本地缓存。
使用方法
基础 RAG:OpenAI 模型 + 本地文档目录
把待问答的文档放入 ./data 目录,框架自动完成加载、切块、嵌入与索引构建:
import os

# 设置云端模型 API Key
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"

from llama_index.core import VectorStoreIndex, SimpleDirectoryReader

# 加载 data 目录下的文档(支持 PDF、TXT、DOCX、Markdown 等格式)
documents = SimpleDirectoryReader("./data").load_data()

# 构建向量索引(默认使用内存存储与 OpenAI 嵌入模型)
index = VectorStoreIndex.from_documents(documents)

# 创建查询引擎并提问
query_engine = index.as_query_engine()
response = query_engine.query("总结这份文档的核心结论")
print(response)
配合 Ollama 本地模型全程离线
不调用任何云端接口时,用 Ollama 提供本地大模型,用 HuggingFace 提供本地嵌入模型:
from llama_index.core import Settings, VectorStoreIndex, SimpleDirectoryReader
from llama_index.llms.ollama import Ollama
from llama_index.embeddings.huggingface import HuggingFaceEmbedding

# 接入本地 Ollama 大模型(先执行 ollama pull llama3.1 拉取模型)
Settings.llm = Ollama(model="llama3.1:latest", request_timeout=360.0)

# 使用本地 HuggingFace 嵌入模型,不请求云端嵌入接口
Settings.embed_model = HuggingFaceEmbedding(model_name="BAAI/bge-small-en-v1.5")

# 加载文档并构建索引
documents = SimpleDirectoryReader("./data").load_data()
index = VectorStoreIndex.from_documents(documents)

# 提问并打印回答
query_engine = index.as_query_engine()
print(query_engine.query("文档里提到了哪些部署步骤?"))
索引持久化与重启重载
默认索引只存在于内存,进程退出即丢失。可先持久化到磁盘,下次启动直接加载:
# 将索引保存到 ./storage 目录
index.storage_context.persist(persist_dir="./storage")

# 重启进程后从磁盘重载索引
from llama_index.core import StorageContext, load_index_from_storage

storage_context = StorageContext.from_defaults(persist_dir="./storage")
index = load_index_from_storage(storage_context)
RAG 五步流程对照
一个典型 RAG 应用在框架内对应五个环节:加载(SimpleDirectoryReader 读取各类文档)→ 索引(切块、嵌入并写入向量索引)→ 存储(内存、磁盘或外部向量库)→ 查询(按相似度检索 Top-K 相关片段)→ 生成(LLM 基于检索片段组织回答并给出引用)。各环节组件均可替换为对应集成包提供的实现。
扩展接入其他提供商
文档加载器、向量数据库、LLM、嵌入模型都有独立集成包,可在官方集成目录按场景挑选安装。遇到扫描件、复杂表格或图文混排 PDF 解析效果不理想时,可先用 LlamaParse 云端服务解析成结构化文本,再喂入框架;追求本地部署时可使用开源的 LiteParse 解析器。
官方链接
| 资源 | 链接 |
|---|---|
| GitHub 仓库 | github.com/run-llama/llama_index |
| 官网 | developers.llamaindex.ai |
| 框架文档 | developers.llamaindex.ai/python/framework |
| PyPI 包(llama-index) | pypi.org/project/llama-index |
| 集成包目录 | developers.llamaindex.ai/python/framework/community/integrations |
| LlamaParse 云端平台 | cloud.llamaindex.ai |
常见问题(FAQ)
问:LlamaIndex 和 LangChain 有什么区别?
LlamaIndex 的重心在文档数据接入与 RAG 索引检索,索引、节点、检索器等组件划分得更细,适合把私有文档变成可问答的知识库;LangChain 更侧重通用链式编排与工具调用。两者并不互斥,实际项目中也常组合使用。
问:必须购买 OpenAI API Key 才能用吗?
不需要。通过 llama-index-llms-ollama 接入本地 Ollama 大模型,搭配 llama-index-embeddings-huggingface 本地嵌入模型,即可在断网环境下跑通完整 RAG 流程;也可以换成其他 OpenAI 兼容的第三方服务。
问:框架自带模型权重吗?
不带。框架只提供索引、检索与编排逻辑,大模型与嵌入模型都需要通过集成包外接:云端填 API Key,本地先拉取模型再配置对应集成。
问:支持哪些向量数据库?
默认使用内存向量存储;通过集成包可切换到 PGVector、Chroma、Qdrant、Milvus、Weaviate、Pinecone 等外部向量库,索引构建方式保持一致。
问:对 Python 版本有什么要求?
要求 Python >=3.10,<4.0,即 3.10、3.11、3.12、3.13 均可;建议在虚拟环境中安装,避免与系统其他项目冲突。
问:扫描版 PDF 或复杂表格解析不准怎么办?
可先使用 LlamaParse 云端解析服务完成 OCR 与结构化抽取,再把解析结果交给框架建索引;本地场景可尝试开源 LiteParse 解析器作为替代方案。
许可证
LlamaIndex 仓库采用 MIT 许可证(版权归属 Jerry Liu),允许自由使用、修改与商用,源码分发时保留原始版权声明与许可文本即可。需要注意:通过框架接入的各云端模型服务遵循其自身服务条款;本地运行的开源模型权重分别遵循各自许可证,商用前请以模型卡标注为准。