

Trafilatura:学术圈常用的开源正文抽取 Python 库|部署与使用全指南
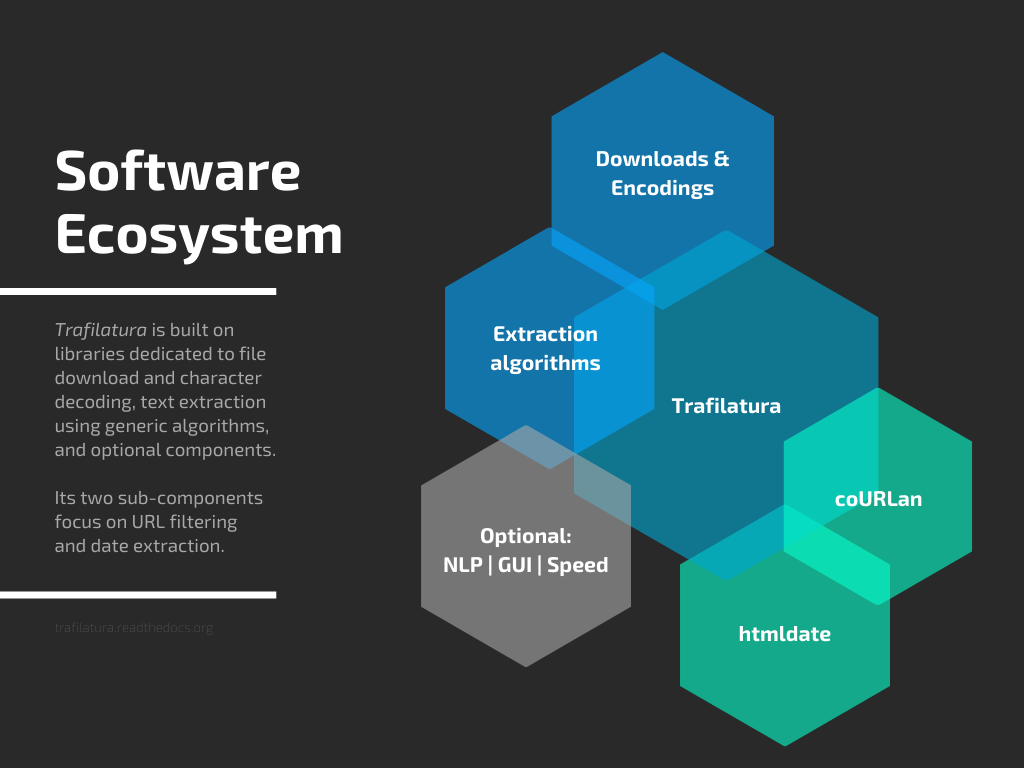
Trafilatura 是一个 Python 包 + 命令行工具,专门做「把 raw HTML 变成干净正文 + 元数据」。它自带 sitemap / RSS / Atom 发现、URL 去重、规则化正文抽取(jusText / readability-lxml 作为兜底),输出 TXT / Markdown / JSON / CSV / XML / XML-TEI。HuggingFace、IBM、Microsoft Research、NVIDIA、Allen Institute、Stanford、Internet Archive 都在引用它。
1. 项目简介与定位
官方一句话:Discover Web Content, Extract Text and Metadata. 它不是浏览器自动化工具,不跑 JS;它是一个离线 HTML 清洗器,专注于把抓回来的网页里真正的正文抽出来,扔掉导航、页脚、侧边栏、广告。
1.1 核心信息一览
| 项目 | 内容 |
|---|---|
| 名称 | Trafilatura |
| 仓库 | https://github.com/adbar/trafilatura (任务清单写作 Adaptive/trafilatura,实际仓库归 adbar 维护) |
| 定位 | Web 正文抽取 / 元数据提取 / 轻量爬虫(Python 库 + CLI) |
| 许可证 | Apache-2.0(v1.8.0 起;更早版本 GPLv3+) |
| 运行时 | Python(PyPI 包名 trafilatura) |
| 部署方式 | pip install trafilatura;无独立服务端口 |
| 在线文档 | https://trafilatura.readthedocs.io |
| 论文 | ACL/IJCNLP 2021 Demo,DOI 10.18653/v1/2021.acl-demo.15 |
1.2 适用场景
- 已经用 requests / httpx 把 HTML 抓回来了,想抽正文,不想自己写 readability 规则。
- 构建语料库 / RAG 索引:批量清洗历史 HTML 文件,输出 JSON 或 TEI XML。
- 研究项目里要 sitemap / RSS 发现 + 正文抽取一条龙。
- 需要在 Python 脚本里调用,而不是起一个服务。
1.3 能力边界(官方口径)
- 不跑 JavaScript:SPA 页面抓到的 HTML 是空壳时,Trafilatura 也救不了,要先 headless 渲染。
- 不带代理池 / 反爬:它只负责清洗,不负责抓取网络。
- 主抽取器是自有的规则系统,jusText 与 readability-lxml 作为 fallback。
- 不自带浏览器,因此资源占用极低,可以在大批量离线语料上跑。
2. 开源协议
Apache License 2.0(v1.8.0 起)。更早版本(< v1.8.0)是
GPLv3+。商用前看一眼你 pip install 到的版本号。
3. 官方仓库与链接
- 仓库:https://github.com/adbar/trafilatura
- 文档:https://trafilatura.readthedocs.io
- 快速开始:https://trafilatura.readthedocs.io/en/latest/quickstart.html
- 安装:https://trafilatura.readthedocs.io/en/latest/installation.html
- Python API:https://trafilatura.readthedocs.io/en/latest/corefunctions.html
- CLI 用法:https://trafilatura.readthedocs.io/en/latest/usage-cli.html
- R 用法:https://trafilatura.readthedocs.io/en/latest/usage-r.html
- 基准测试:https://github.com/scrapinghub/article-extraction-benchmark
- 论文:https://aclanthology.org/2021.acl-demo.15/
- 作者赞助:https://github.com/sponsors/adbar
4. 前置要求
- Python 3(具体小版本以 PyPI badge 为准,README 顶部 badge 显示支持现代 Python)。
- 操作系统:Linux / macOS / Windows。
- 不需要浏览器、不需要数据库。
- 可选:lxml 加速(pip 安装时通常会自动带上)。
- 可选附加:语言检测(
trafilatura[all]里包含)。
5. 安装部署
5.1 方式一:pip 安装(推荐)
pip install trafilatura带全部可选依赖(语言检测、加速后端):
pip install trafilatura[all]5.2 方式二:源码安装
git clone https://github.com/adbar/trafilatura.git
cd trafilatura
pip install -e .
5.3 命令行直接用
# 抓一个 URL 并抽正文
trafilatura --url "https://github.blog/2019-03-29-leader-spotlight-erin-spiceland/"

# 输入本地 HTML 文件,输出 JSON
trafilatura --input mypage.html --output result.json --output-format json --with-metadata
CLI 完整参数见 https://trafilatura.readthedocs.io/en/latest/usage-cli.html。
6. 最小示例代码
README 原文:
>>> from trafilatura import fetch_url, extract
>>> downloaded = fetch_url("https://github.blog/2019-03-29-leader-spotlight-erin-spiceland/")
>>> extract(downloaded)
'Erin Spiceland is a software engineer and ...'
>>> extract(downloaded, output_format="json", with_metadata=True)
'{"title": "Leader spotlight: Erin Spiceland", "author": "Jessica Rudder", "text": "Erin Spiceland is a software engineer and ..."}'
写成脚本:
from trafilatura import fetch_url, extract

url = "https://github.blog/2019-03-29-leader-spotlight-erin-spiceland/"
html = fetch_url(url)

# 只要正文纯文本
text = extract(html)
print(text)

# 带元数据 + JSON
result = extract(html, output_format="json", with_metadata=True)
print(result)
常用 extract 参数(来自官方文档):
| 参数 | 作用 |
|---|---|
output_format |
txt / markdown / json /
csv / xml / xmltei |
with_metadata |
抽取 title / author / date / site name / categories |
include_comments |
是否保留评论区 |
include_links |
是否保留链接 |
include_images |
是否保留图片 |
favor_precision / favor_recall |
精确优先 vs 召回优先 |
7. 配置项说明
7.1 爬取相关函数
sitemap_search(domain):从 sitemap.xml / sitemap.txt 发现 URL。feed_search(domain):从 RSS / Atom / JSON Feed 发现 URL。crawl_url(url):跟随链接爬取,自动去重与过滤。
7.2 抽取相关函数
extract(html):主入口,自动选最佳算法。bare_extraction(html):更低级的抽取原语。baseline(html):读 readability-lxml 兜底。justext_wrapper(html):走 jusText 兜底。
7.3 输出格式
README 列出:TXT / Markdown / CSV / JSON / HTML / XML / XML-TEI。XML-TEI 适合学术语料归档。
8. 常见问题
Q1:抓出来是空字符串? 多半是页面正文靠 JS
渲染,fetch_url 拿到的 HTML 是空壳。先用 headless
Chrome(如 Browserless / Playwright)把渲染后 HTML 存下来,再喂给
extract。
Q2:把侧边栏 / 推荐文章也抽进来了? 调
favor_precision=True,或者用 target_css /
excludetags 等参数限定选择器。
Q3:和 readability-lxml / jusText 什么关系? Trafilatura 自己有规则抽取器,readability-lxml 和 jusText 是它的 fallback 后端。官方在多项基准里报告 Trafilatura 主抽取器优于这两个独立库。
Q4:能批量处理本地 HTML 文件吗? 能。CLI
--input 指向目录或文件即可;Python 里自己
open() 读 HTML 再 extract()。
Q5:能识别语言吗? trafilatura[all]
装齐依赖后支持语言检测。
9. 与同类工具对比
| 工具 | 形态 | 跑 JS | 输出 | 适合谁 |
|---|---|---|---|---|
| Trafilatura | Python 库 + CLI | 否 | TXT / MD / JSON / XML / TEI | 语料构建、RAG 清洗、学术研究 |
| readability-lxml | Python 库 | 否 | HTML 摘要 | Mozilla Readability 的 Python 移植 |
| jusText | Python 库 | 否 | 纯文本 | 老一代正文抽取 |
| newspaper3k | Python 库 | 否 | 标题 + 正文 + 图片 | 新闻抓取,多年未大更新 |
| BeautifulSoup | 解析库 | 否 | 你自己写规则 | 完全可控但要自己写抽取 |
| Jina Reader | URL → Markdown 服务 | 是(云版) | Markdown | 不想自己写抽取,直接拿 URL |
| Firecrawl | HTTP API | 是(云版) | Markdown / JSON / 截图 | 给 LLM 喂数据 |
10. 许可
- v1.8.0 及以后:Apache-2.0。
- v1.8.0 以前:GPLv3+。
- 周边生态(htmldate / courlan / jusText)各有自己的许可证。
11. 责任使用声明
使用 Trafilatura 及其周边爬虫函数抓取网页时,请遵守:
- 尊重目标站点
robots.txt与服务条款,Trafilatura 不自动遵守 robots,需要你自己在fetch_url/ 爬取循环里判断。 - 控制并发与延时,对小型站点不要用 sitemap 全量并发抓。
- 不绕过登录墙、付费墙、验证码去获取付费内容。
- 不批量采集个人隐私数据(评论作者信息、用户主页、联系方式等)。
- 仅将抽取到的公开内容用于合法研究、语料构建与个人学习。
- 二次发布清洗后的文本时遵守原网站版权,注明来源 URL。