

Jina Reader:给任何 URL 加个前缀就变成 LLM 可读 Markdown 的开源服务|部署与使用全指南
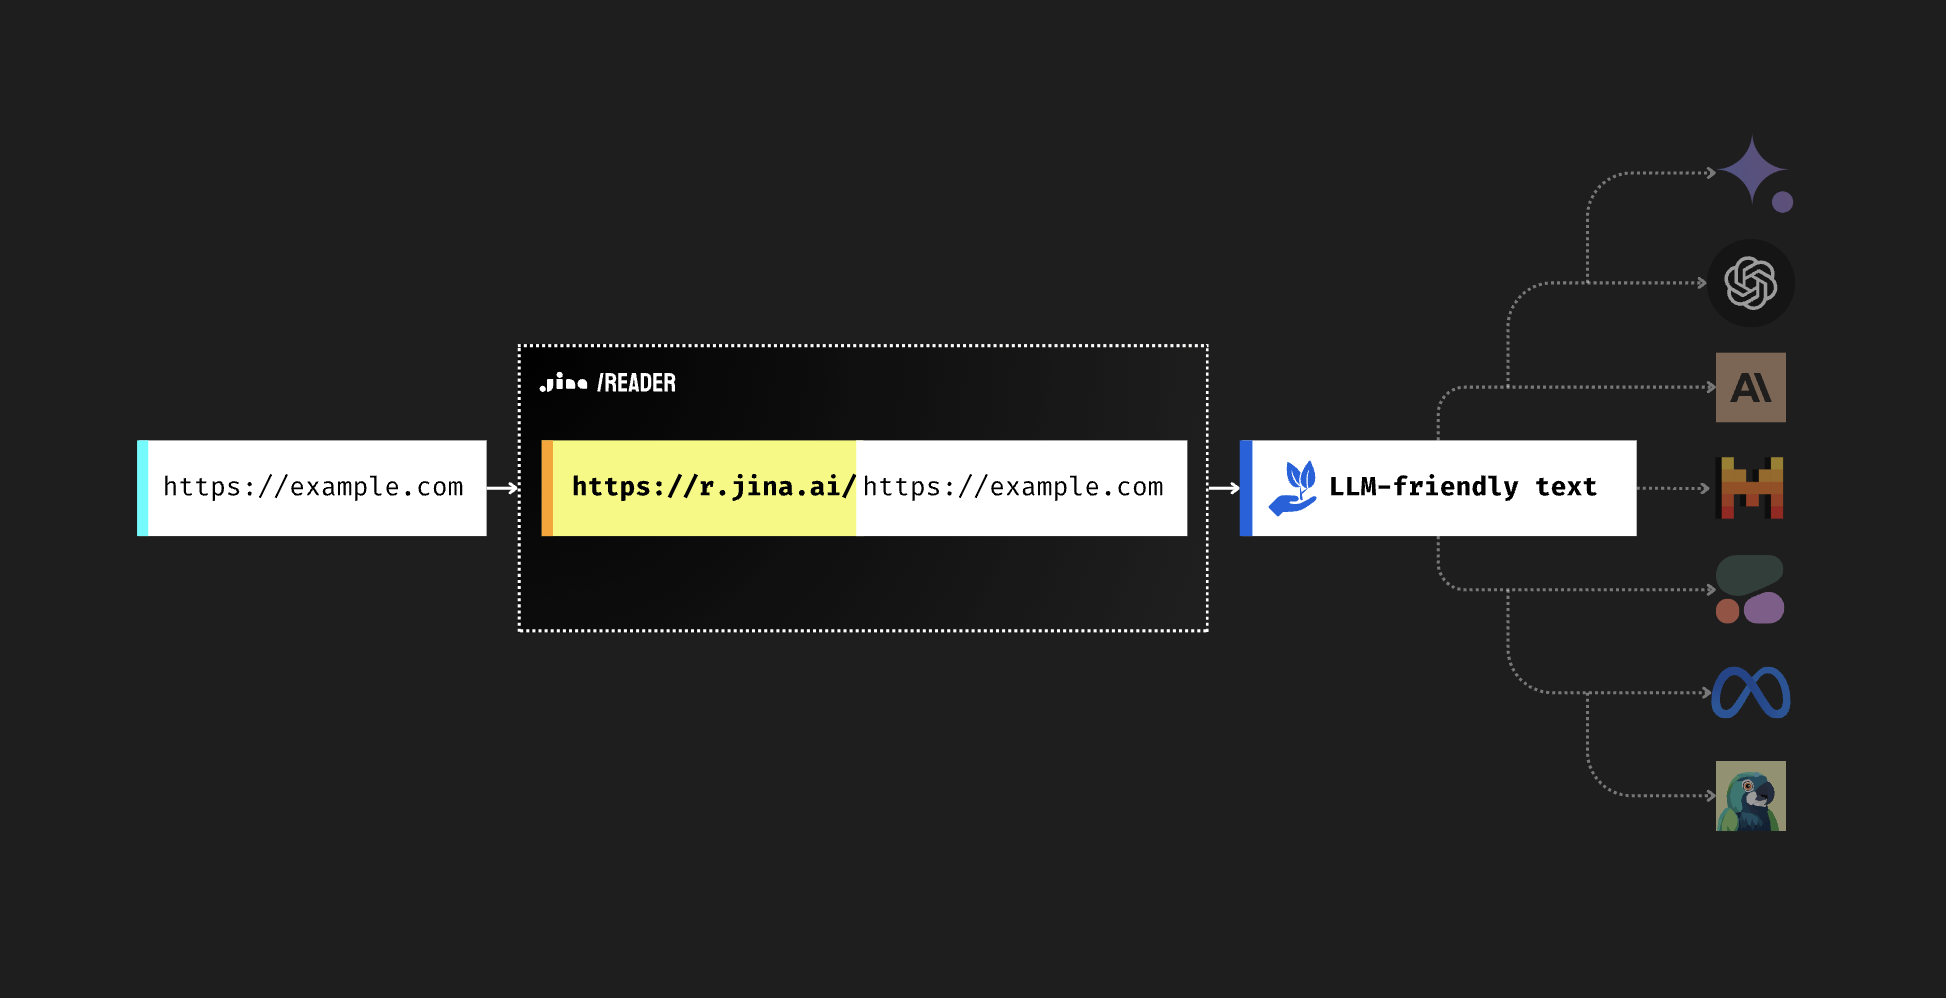
Jina Reader 是 Jina AI 开源的「URL → LLM 友好输入」服务。你只要在任意
URL 前面拼上 https://r.jina.ai/,就能拿到洗干净的
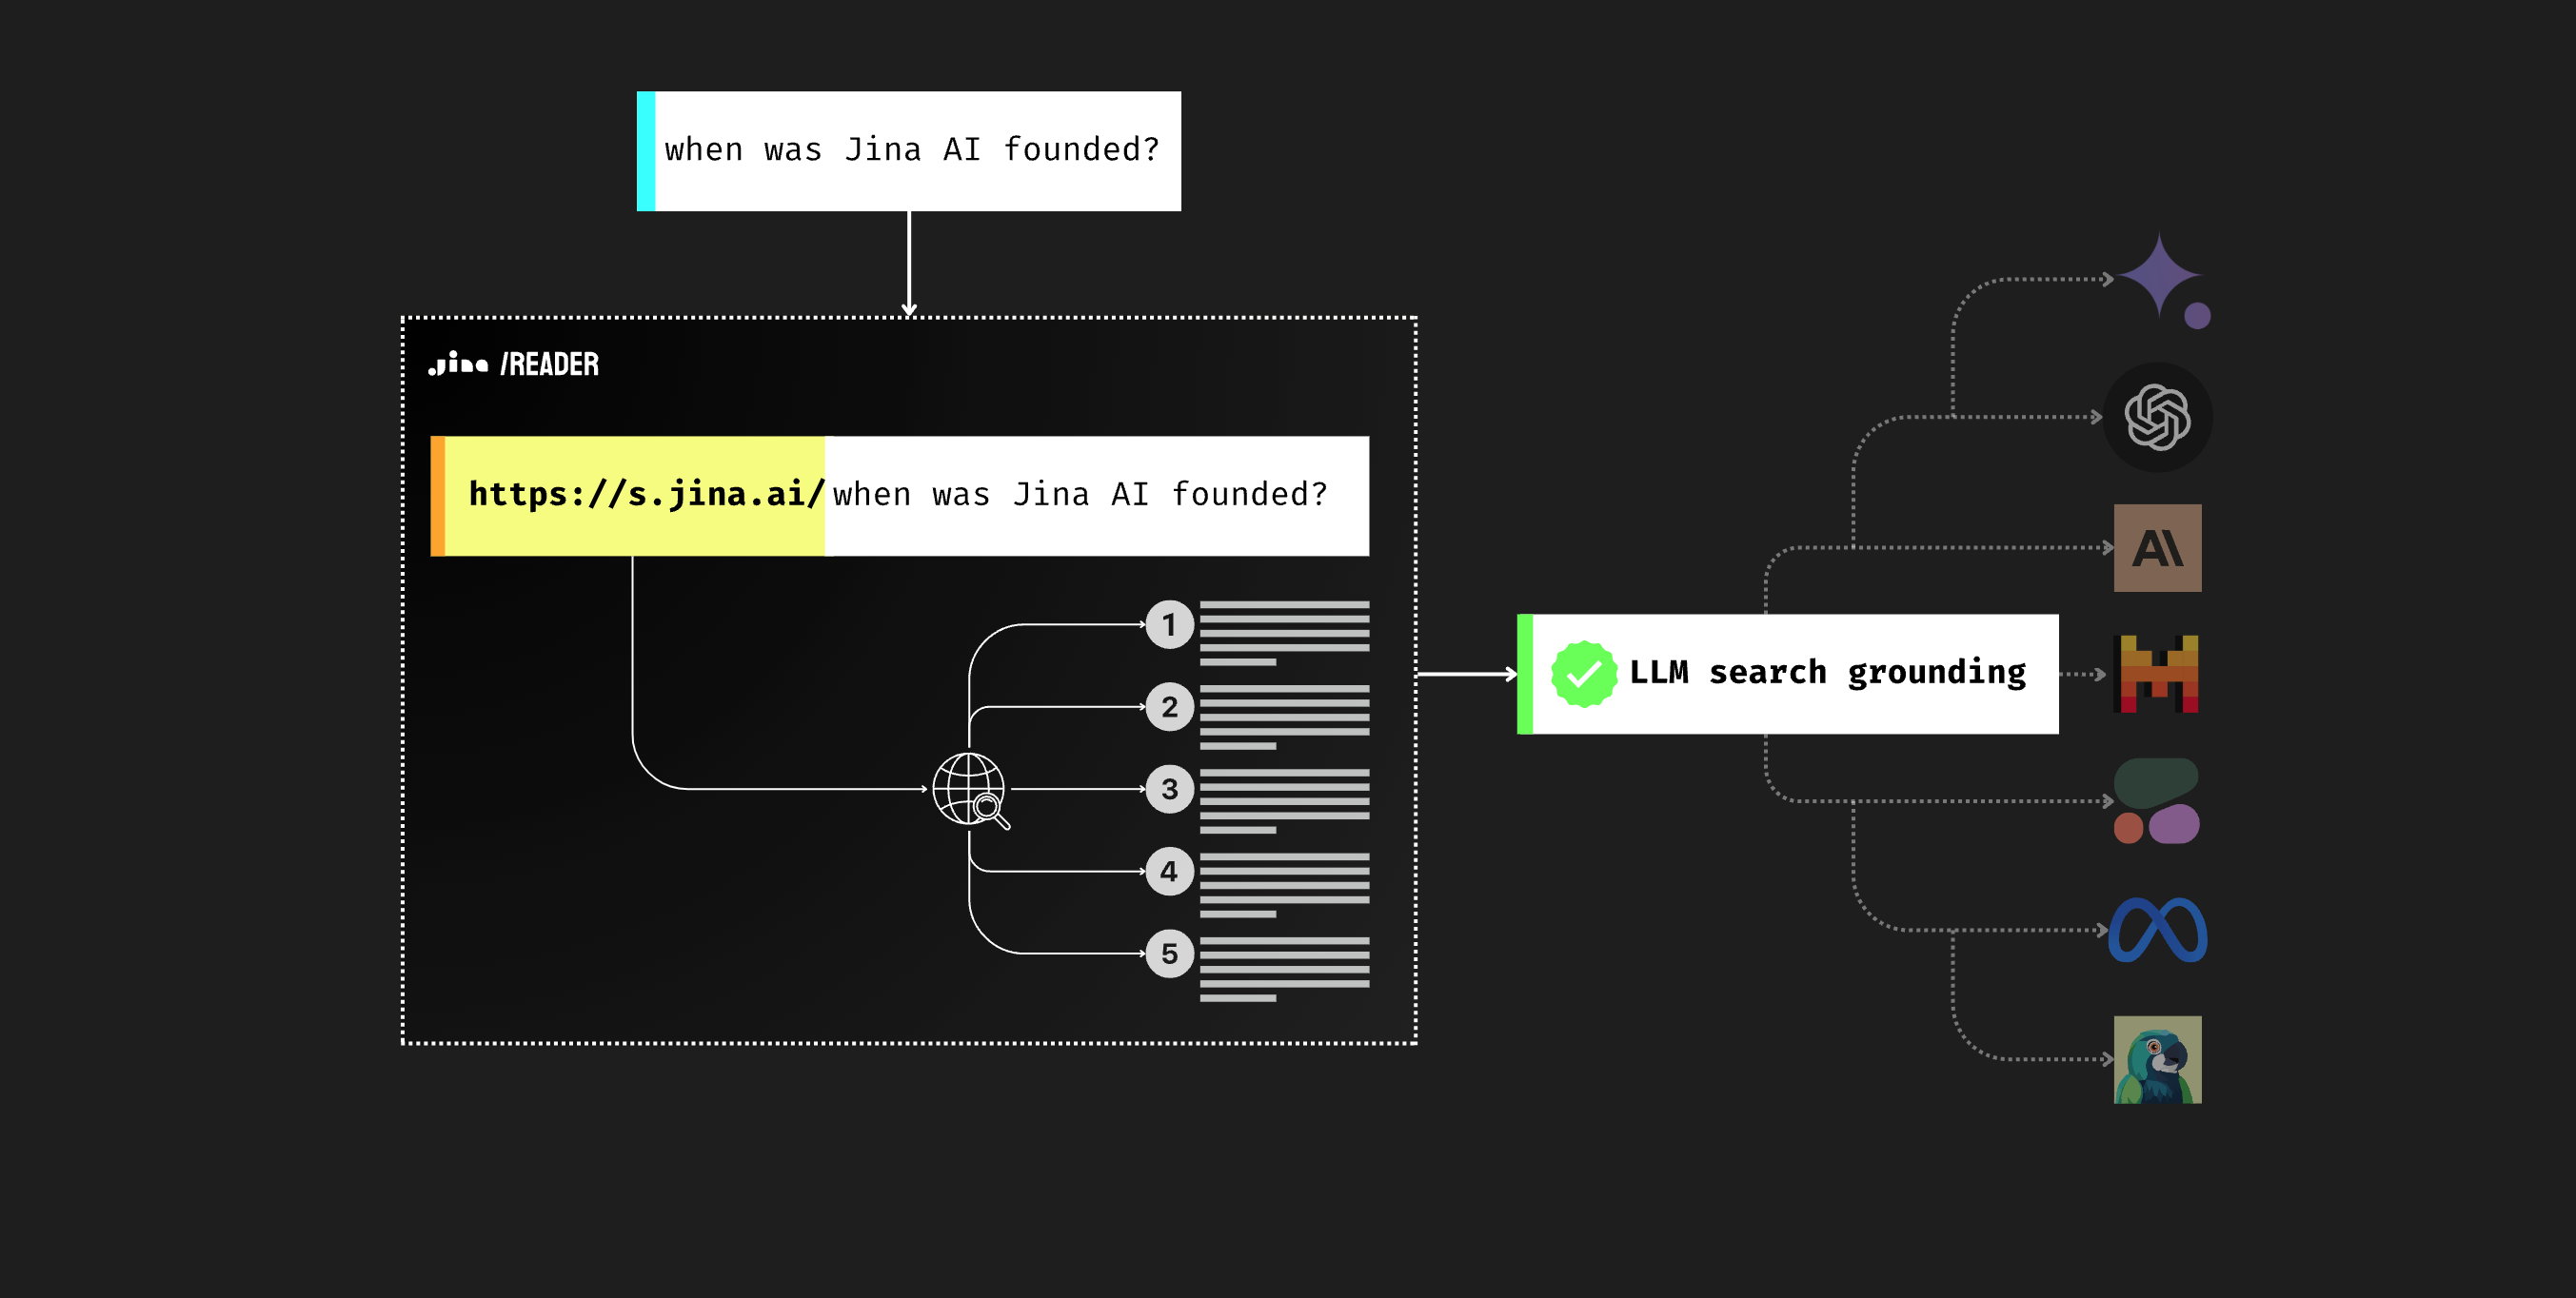
Markdown;在搜索词前面拼
https://s.jina.ai/,就能拿到「搜索结果 +
每个结果页正文」的合并 Markdown。开源版可以一行 Docker
命令自托管,自带无头 Chrome、LibreOffice、CJK 字体。
1. 项目简介与定位
官方一句话:Your LLMs deserve better input. Reader 做两件事:
- Read:把任意 URL 转成 LLM 友好的
Markdown(
https://r.jina.ai/https://your.url)。 - Search:用 query 搜网,自动抓前 5
条结果的正文(
https://s.jina.ai/your+query)。
1.1 核心信息一览
| 项目 | 内容 |
|---|---|
| 名称 | Jina Reader |
| 仓库 | https://github.com/jina-ai/reader |
| 定位 | URL → Markdown / 搜索 → Markdown 的 LLM 上下文服务 |
| 许可证 | Apache-2.0 |
| 运行时 | Node.js(容器内打包 headless Chrome + LibreOffice + CJK 字体) |
| 部署方式 | Docker 镜像 ghcr.io/jina-ai/reader:oss |
| 容器端口 | 8080(h2c / HTTP/2 cleartext)、8081(HTTP/1.1 fallback) |
| 云服务 | https://r.jina.ai、https://s.jina.ai |
| 在线 Demo | https://jina.ai/reader#demo |
1.2 适用场景
- 给 RAG / 向量库喂数据:不用自己写爬虫、不用管 JS 渲染,一个 URL 前缀搞定。
- 给 AI Agent 加「读网页」工具:比直接喂 HTML 省 token。
- 把 PDF、Word、Excel、PPT 转成 Markdown:URL 指向
.pdf或 POST 文件即可。 - 批量做站内搜索:
https://s.jina.ai/query?site=jina.ai&site=github.com。
1.3 能力边界(官方口径)
- 开源版是 stateless 或 bucket-cached 模式;SaaS 版的 MongoDB 存储层不包含在开源仓库里。
- 匿名流量有速率限制;带 API Key 才能用内部代理、住宅 IP 轮换等高级能力。
- 对强反爬站点(Cloudflare 5s 盾、验证码),开源版只能靠
x-engine: browser+ 等待选择器硬刚,绕不过去时要自己接代理。
2. 开源协议
Apache-2.0(仓库根目录 LICENSE)。商用友好。
3. 官方仓库与链接
- 仓库:https://github.com/jina-ai/reader
- 在线服务:https://r.jina.ai 、 https://s.jina.ai
- 在线 Demo:https://jina.ai/reader#demo
- API 表单:https://jina.ai/reader#apiform
- 实时 API 文档:https://r.jina.ai/docs
- Cookbook:仓库内
cookbooks.md - 架构说明:仓库内
architecture.md - 环境变量:仓库内
CONTRIBUTING.md
4. 前置要求
4.1 直接用云服务(零部署)
- 任意能访问
r.jina.ai的机器。 - 可选:在 https://jina.ai/reader#pricing 申请 API Key,提升配额。
4.2 自托管
- 装了 Docker 的机器。
- 内存建议 ≥ 2GB(要跑 headless Chrome)。
- 可选:一个 S3 兼容桶(MinIO / AWS S3)做页面缓存。
- 源码开发模式:Node.js(nvm 管理)+ 可选 Docker(仅用于本地 MinIO 缓存)。
5. 安装部署
5.1 方式一:直接用云服务(推荐入门)
把任意 URL 前面加 https://r.jina.ai/ 即可,例如:
https://r.jina.ai/https://en.wikipedia.org/wiki/Artificial_intelligence搜索:
https://s.jina.ai/Who%20will%20win%202024%20US%20presidential%20election%3FcURL:
curl https://r.jina.ai/https://example.com5.2 方式二:Docker 自托管(README 原文)
拉镜像:
docker pull ghcr.io/jina-ai/reader:oss镜像暴露两个端口:
8080—— h2c(HTTP/2 cleartext),生产级多路复用;curl直连需要--http2-prior-knowledge。8081—— HTTP/1.1 fallback,同样的 handler,给不支持 h2c 的客户端用。
快速试玩(映射 HTTP/1.1 端口):
docker run --rm -p 3000:8081 ghcr.io/jina-ai/reader:oss
# 然后:
curl http://localhost:3000/https://example.com
压测 / 生产形态(同时映射两个端口):
docker run --rm -p 3000:8080 -p 3001:8081 ghcr.io/jina-ai/reader:oss无额外配置时容器完全无状态:每个请求都实时抓目标 URL,不缓存、不限流。
5.3 方式三:带 S3 缓存的自托管
docker run --rm -p 3000:8081 \
  -e GCP_STORAGE_ENDPOINT=https://s3.example.com \
  -e GCP_STORAGE_BUCKET=reader-cache \
  -e GCP_STORAGE_ACCESS_KEY=... \
  -e GCP_STORAGE_SECRET_KEY=... \
  ghcr.io/jina-ai/reader:oss
完整环境变量表见仓库 CONTRIBUTING.md。
5.4 方式四:源码本地开发
git clone git@github.com:jina-ai/reader.git
cd reader
npm install
# 可选:起本地 MinIO 做缓存
docker compose up -d
npm run dev
首次构建需要下载非再分发资源(MaxMind GeoLite 库、思源黑体、UA 列表):
npm run assets:download6. 最小示例代码
6.1 最基础:URL → Markdown
curl https://r.jina.ai/https://en.wikipedia.org/wiki/Main_Page6.2 JSON 模式
curl -H "Accept: application/json" https://r.jina.ai/https://en.m.wikipedia.org/wiki/Main_Page6.3 等 SPA 渲染完再返回
# 等 10 秒
curl 'https://r.jina.ai/https://example.com/' -H 'x-timeout: 10'

# 等某个元素出现
curl 'https://r.jina.ai/https://example.com/' -H 'x-wait-for-selector: #content'
6.4 站内搜索
curl 'https://s.jina.ai/When%20was%20Jina%20AI%20founded%3F?site=jina.ai&site=github.com'6.5 给图片自动加 VLM 描述
curl -H "X-With-Generated-Alt: true" https://r.jina.ai/https://en.m.wikipedia.org/wiki/Main_Page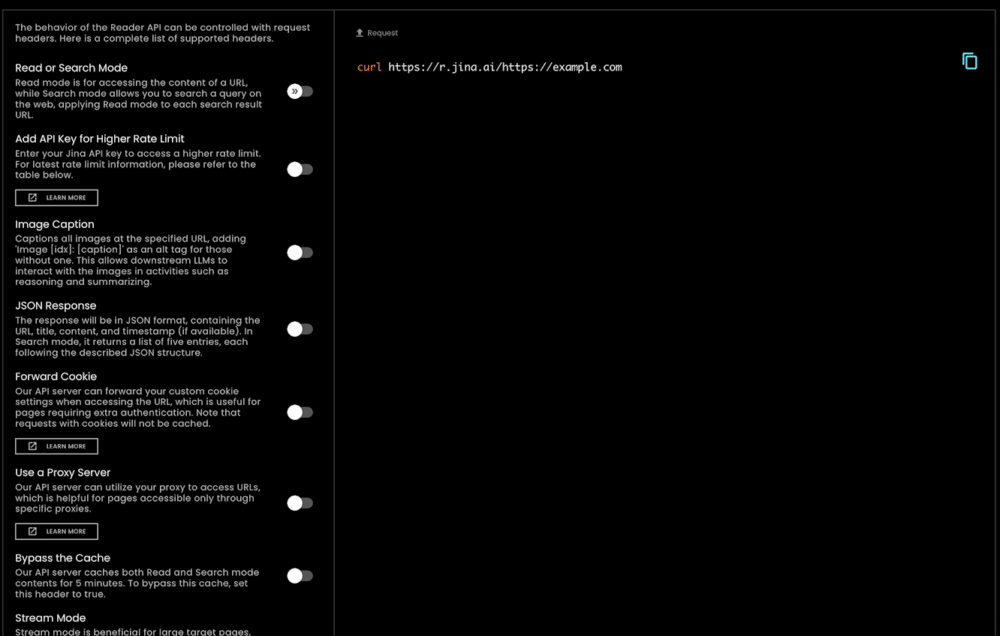
7. 配置项说明(请求头)
README 列出的常用请求头(完整列表见
src/dto/crawler-options.ts):
| Header | 取值 | 作用 |
|---|---|---|
x-respond-with |
markdown / html / text /
screenshot / pageshot /
frontmatter / markdown+frontmatter |
选择输出格式 |
x-engine |
browser / curl / auto |
强制渲染引擎 |
x-proxy-url |
代理 URL | 走自己的代理 |
x-cache-tolerance |
整数秒 | 可接受的缓存陈旧度 |
x-no-cache |
true |
绕过缓存 |
x-target-selector |
CSS 选择器 | 只返回匹配元素内的内容 |
x-wait-for-selector |
CSS 选择器 | 等元素渲染完再返回 |
x-timeout |
整数秒(≤180) | 最大等待时间 |
x-max-tokens |
整数(≥500) | 截断到这个 token 数 |
x-token-budget |
整数 | 超预算直接拒绝 |
x-respond-timing |
html / visible-content /
mutation-idle / resource-idle /
media-idle / network-idle |
何时返回 |
x-with-generated-alt |
true |
给图片加 VLM 描述 |
x-retain-images |
all / none / alt |
图片保留策略 |
x-retain-links |
all / none / text /
gpt-oss |
链接保留策略 |
x-preset |
reader / index / research /
agent / spider |
预置方案包 |
x-set-cookie |
Cookie 字符串 | 携带 Cookie(带 Cookie 的请求不缓存) |
8. 常见问题
Q1:免费吗? README 原文:Feel free to use Reader API in production. It is free, stable and scalable. 匿名可用,配额见 Pricing 页。
Q2:抓不到 / 拿到的是空壳怎么办? README 建议顺序:
- 申请 API Key(匿名流量被限得最狠)。
-H 'x-no-cache: true'绕过缓存。-H 'x-engine: browser'强制走无头 Chrome。- 带 Key 用
-H 'x-proxy: auto'走官方住宅代理;或-H 'x-proxy: us'指定国家。 - 自己买代理用
-H 'x-proxy-url: http://user:pass@host:port'。
Q3:支持 PDF / Word / Excel / PPT 吗? 支持。URL 以
.pdf 结尾自动用 PDF.js 解析;Office 文档走 LibreOffice
转换。也可以直接 POST file 字段上传文件。
Q4:开源版和 SaaS 差什么? 开源版是 stateless / bucket-cached;SaaS 版的 MongoDB 存储、内部代理池、住宅 IP、反滥用系统不在仓库里。
Q5:容器跑起来 8080 端口 curl 不通? 8080 是
h2c,普通 curl 不会自动握手。要么映射 8081 用
HTTP/1.1,要么加 --http2-prior-knowledge。
9. 与同类工具对比
| 工具 | 形态 | 输出 | 反爬 | 适合谁 |
|---|---|---|---|---|
| Jina Reader | URL 前缀服务(云 + 自托管) | 干净 Markdown,支持 PDF/Office | 云版自带;自托管需自备代理 | RAG / Agent 喂数据,一行 URL 前缀 |
| Firecrawl | HTTP API | Markdown / JSON / 截图,带 Agent 模式 | 云版自带代理池与浏览器池 | 想要「一句话让 Agent 自己找数据」 |
| Trafilatura | Python 库 + CLI | 正文文本 / XML / JSON | 不带浏览器 | 离线 HTML 批量清洗、语料库 |
| Browserless | 浏览器托管 | 原始 HTML / 截图 / PDF | 不做内容清洗 | 已有 Puppeteer/Playwright 脚本 |
| Crawlee for Python | Python 库 | 自定义存储 | 自带会话/代理轮换 | 工程化爬虫 |
10. 许可
Apache-2.0。容器内打包的第三方组件(headless
Chrome、LibreOffice、思源黑体、MaxMind GeoLite
库)遵循各自许可证;GeoLite 与 CJK 字体需要在自托管时通过
npm run assets:download 拉取,遵守 MaxMind
与思源黑体的授权条款。
11. 责任使用声明
使用 Jina Reader(云版或自托管)抓取网页时,请遵守:
- 尊重目标站点
robots.txt与服务条款,不要把 Reader 当成绕过反爬的匿名通道。 - 控制并发与请求频率,匿名模式下尤其不要并发刷小站。
- 不绕过登录墙、付费墙、验证码去获取付费内容。
- 不批量抓取个人隐私数据(用户主页、私信、评论里的手机号邮箱等)。
- 仅将抓取到的公开内容用于合法研究、RAG 索引与个人学习。
- 二次发布时遵守原网站版权要求,注明来源链接。