
TradingAgents 多智能体金融交易框架本地部署指南
一、项目介绍
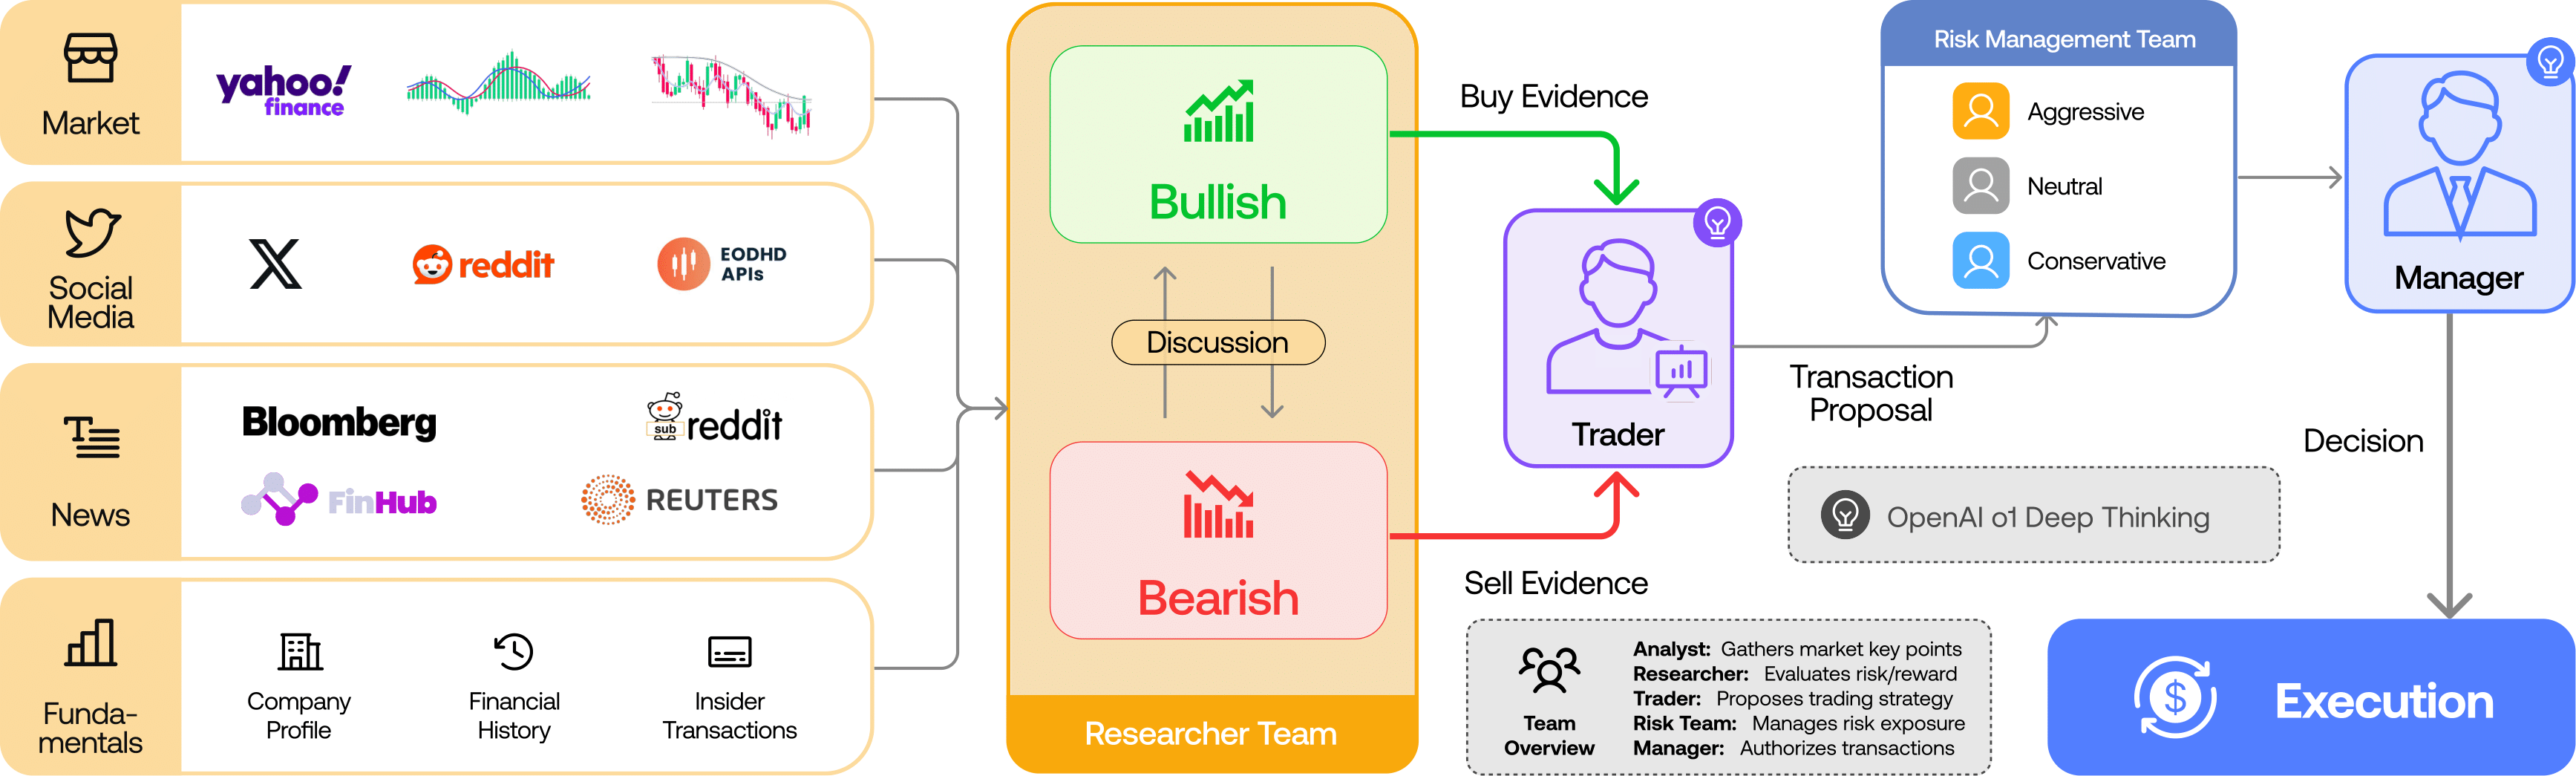
TradingAgents 是 Tauric Research 开源的多智能体 LLM 金融交易框架。它模拟真实交易公司的协作方式:部署一组专职 LLM 智能体——基本面分析师、情绪分析师、新闻分析师、技术分析师,再加上研究员(多空辩论)、交易员、风险管理团队与投资组合经理——让它们各自调用工具、撰写报告、进行结构化辩论,最终对某只股票给出交易决策。
框架基于 LangGraph 构建,强调灵活性与模块化。它支持多家大模型提供商(OpenAI、Google、Anthropic、xAI、DeepSeek、Qwen、GLM、MiniMax、OpenRouter、Ollama 本地模型、Azure OpenAI 等),并内置了 SEC EDGAR 基本面数据、Yahoo Finance 行情、FRED 宏观数据、社交情绪等数据源。
在单一大模型被广泛应用的今天,TradingAgents 代表了另一种思路:复杂决策不该由一个模型独自完成,而应由多个分工明确的智能体协作、辩论、相互制衡。这种架构对研究多智能体系统本身有很高的参考价值,金融只是它的一个试验场。
需要特别说明:TradingAgents 定位为研究用途,交易表现受模型、温度、交易周期、数据质量等多种不确定因素影响,不构成任何金融、投资或交易建议。本文只介绍其本地部署与使用方式。
为什么用多智能体做交易决策
真实的交易决策从来不是一个人拍脑袋。一家交易公司里,有人负责读财报、有人盯新闻、有人看技术指标、有人专做情绪分析,之后多头研究员与空头研究员会辩论,交易员综合各方意见下单,风控团队再从风险角度否决或调整。单一大模型一次回答相当于"一个人同时扮所有角色",容易陷入一致偏误——它自己提论据、自己反驳自己,辩论深度有限。
TradingAgents 把这一组织架构显式拆成多个独立 LLM 智能体:每个分析师只调用自己负责的数据源与工具,报告互不干扰;多空研究员针对同一份报告分别写看多与看空理由,形成真正的对立;交易员与投资组合经理再做最终裁决。这种结构更接近组织行为学中的"异质团队决策",输出的是一份带推理链、可复盘的报告,而不是一个孤立的买/卖信号。对研究多智能体协作机制、评估 LLM 在复杂推理任务中的表现来说,它是一个很好的实验平台。
从研究角度看,这个框架的价值在于把"多智能体协作"从概念变成了可运行、可观测的流程。你可以清楚地看到每个智能体读到了什么数据、写了什么报告、在辩论中被谁反驳、最终决策依据了哪几条理由。这种可解释性对评估 LLM 系统尤其重要——当你想知道"为什么这个系统给出买入建议"时,它不是黑箱,而是一串可以逐节点审查的推理链。对正在搭建自己智能体系统的工程师,它提供了一个现成的参考架构:如何分工、如何传递状态、如何做条件分支与循环辩论。
二、官方信息
| 项目 | 信息 |
|---|---|
| 仓库地址 | TauricResearch/TradingAgents |
| 论文 | arXiv:2412.20138 |
| 官方声明 | 免责声明 |
| 主语言 | Python |
| 构建框架 | LangGraph |
| 最近更新 | 2026-10-27 |
三、项目结构与核心特性
框架把复杂交易任务拆成多个专职角色:
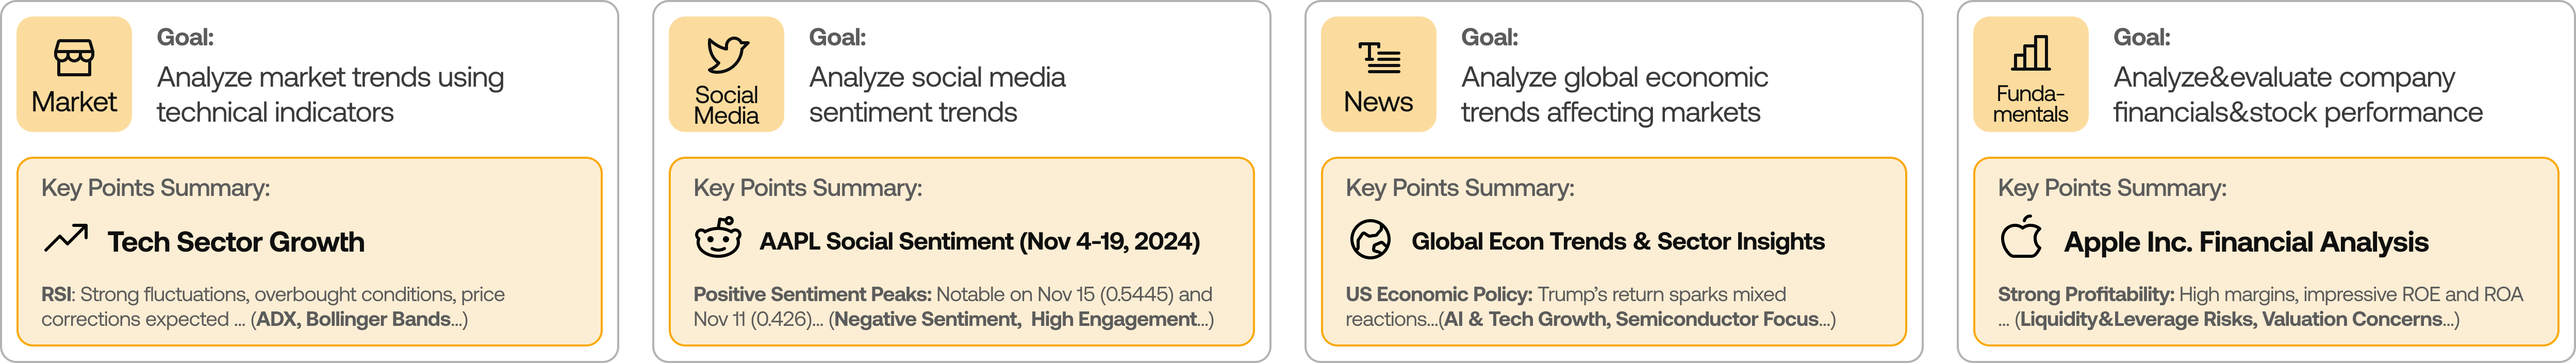
- 分析师团队:基本面分析师(公司财报与内在价值)、情绪分析师(新闻标题、StockTwits、Reddit)、新闻分析师(全球新闻与宏观指标)、技术分析师(MACD、RSI 等指标)。四位分析师并行工作,报告齐备后启动研究辩论。
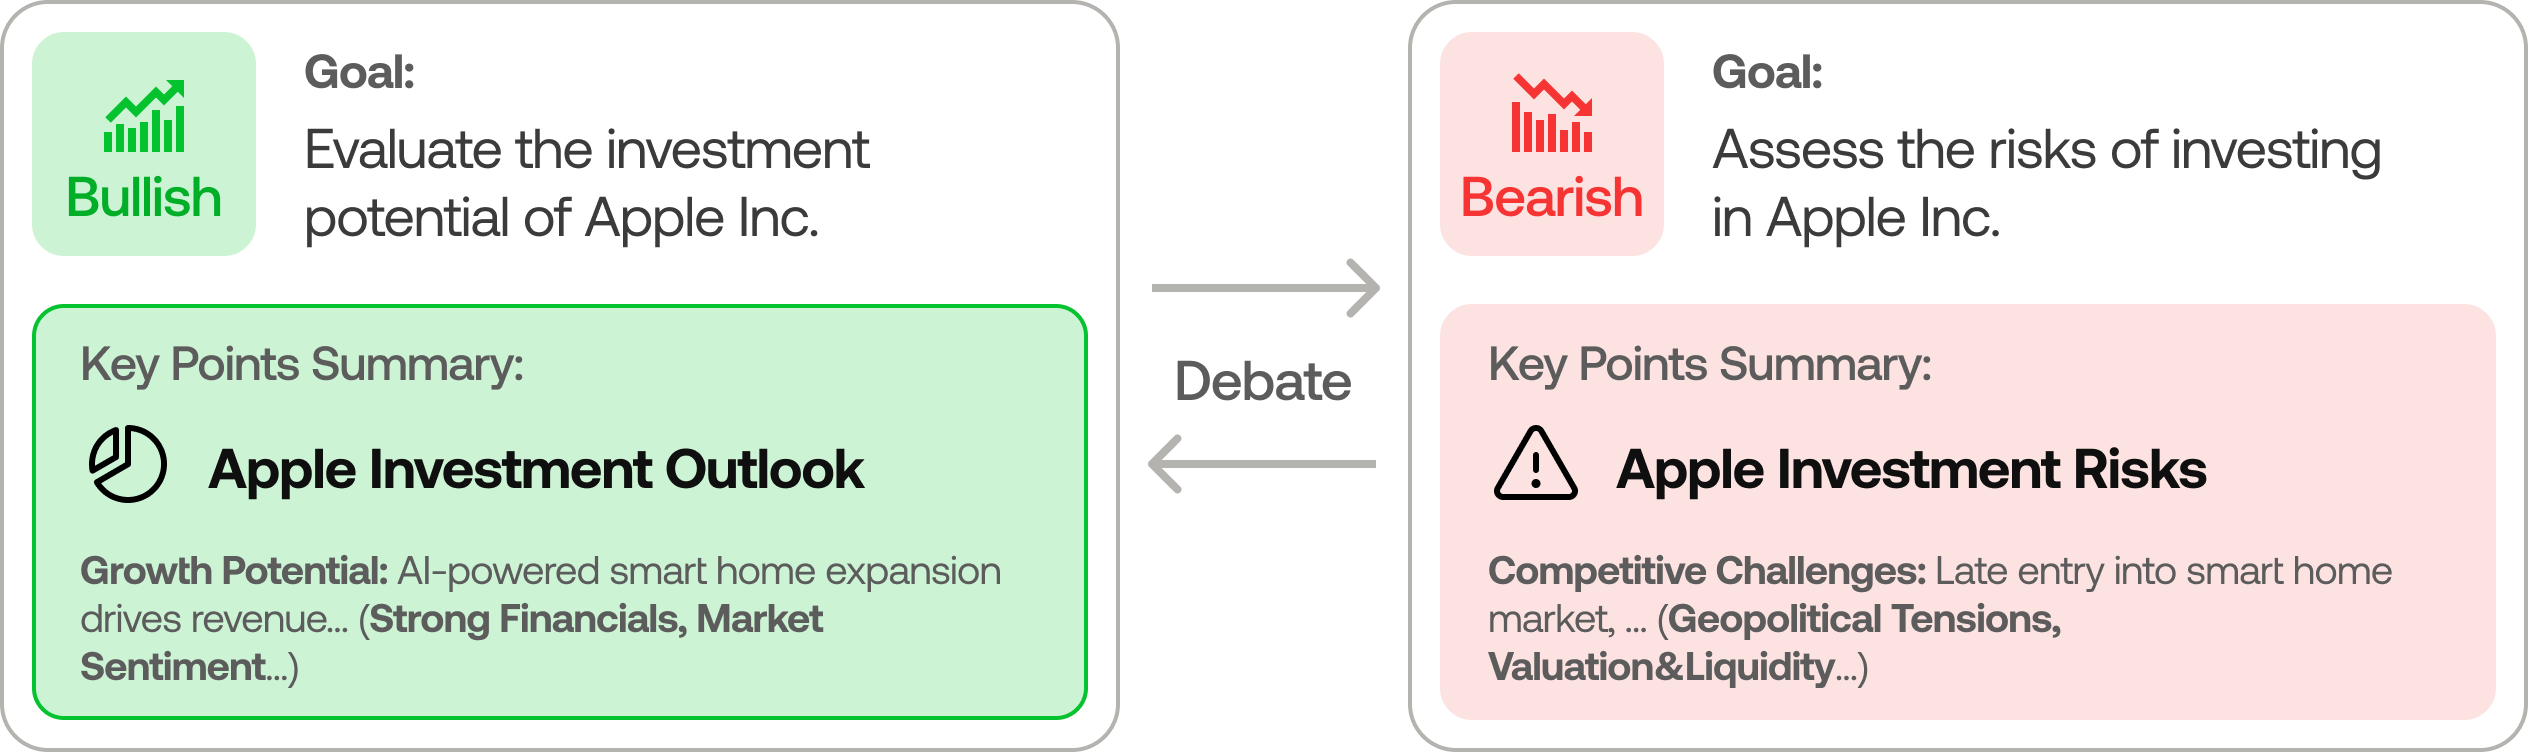
- 研究员团队:多头研究员与空头研究员对分析师报告进行批判性辩论,平衡潜在收益与风险。
- 交易员:综合分析师与研究员报告,决定交易时机与规模。
- 风险管理与投资组合经理:持续评估波动率、流动性等风险因素,投资组合经理最终批准或拒绝交易提案。
核心特性:
- 多提供商 LLM:支持 OpenAI、Google、Anthropic、xAI、DeepSeek、Qwen(国际/国内端点)、GLM、MiniMax、OpenRouter、Ollama、Azure OpenAI,以及你自己的 ChatGPT Plus/Pro 订阅。
- CLI 与 Python 双入口:交互式 CLI 或
tradingagents命令行,也可在 Python 里import tradingagents。 - 检查点恢复:基于 LangGraph 的 checkpoint,崩溃后从中断处续跑。
- 记忆日志:每次决策追加到
~/.tradingagents/memory/trading_memory.md,后续运行会结算历史决策并生成反思。 - 回测:
run_backtest在股票×日期网格上批量跑决策并按 alpha 评分。 - Docker 支持:提供
docker compose一键运行,含 Ollama profile。
这些特性让它既能当研究平台读架构,也能当工具跑流程。尤其是 checkpoint 与记忆日志两个机制,把一次运行的中间状态和历史决策都保留下来,方便你事后复盘"系统为什么这么判",这对研究多智能体协作非常关键。
四、环境与版本要求
| 组件 | 版本要求 | 说明 |
|---|---|---|
| Python | 3.11+(推荐 3.13) | 框架硬性要求 |
| LLM API Key | 至少一个提供商 | 如 OPENAI_API_KEY |
| 可选数据 Key | FRED、Alpha Vantage | 免费增强数据源 |
| Docker(可选) | 任意较新版本 | 容器化运行 |
这里 Python 版本要求偏高(3.11 以上,推荐 3.13),是因为框架依赖的 LangGraph 与相关库跟进了较新语法。环境准备时建议直接用 conda 或 uv 建一个 3.11 或 3.13 的干净环境,不要在老环境上硬装,容易出现依赖解析失败。另外 API Key 是硬性前提——没有任何一个 LLM 可用,整个流程就跑不起来,建议先把至少一家的 Key 配好再开始部署。
五、本地部署步骤
1. 克隆仓库
git clone https://github.com/TauricResearch/TradingAgents.git
cd TradingAgents
2. 创建虚拟环境
用 conda:
conda create -n tradingagents python=3.13
conda activate tradingagents
或用 uv:
uv venv --python 3.13
source .venv/bin/activate
3. 安装包
pip install .
# 或用 uv:uv pip install .
4. 配置 API Key
至少设置一个 LLM 提供商的 Key:
export OPENAI_API_KEY=...          # OpenAI
export GOOGLE_API_KEY=...          # Google Gemini
export ANTHROPIC_API_KEY=...       # Anthropic Claude
export DEEPSEEK_API_KEY=...        # DeepSeek
# Qwen 国内/国际、GLM、MiniMax、OpenRouter、Ollama 等按需设置
也可以复制 .env.example 为 .env 后填写:
cp .env.example .env
5. (可选)Docker 方式
cp .env.example .env   # 填入 Key
docker compose run --rm tradingagents
本地 Ollama 模型用专用 profile:
docker compose --profile ollama run --rm tradingagents-ollama
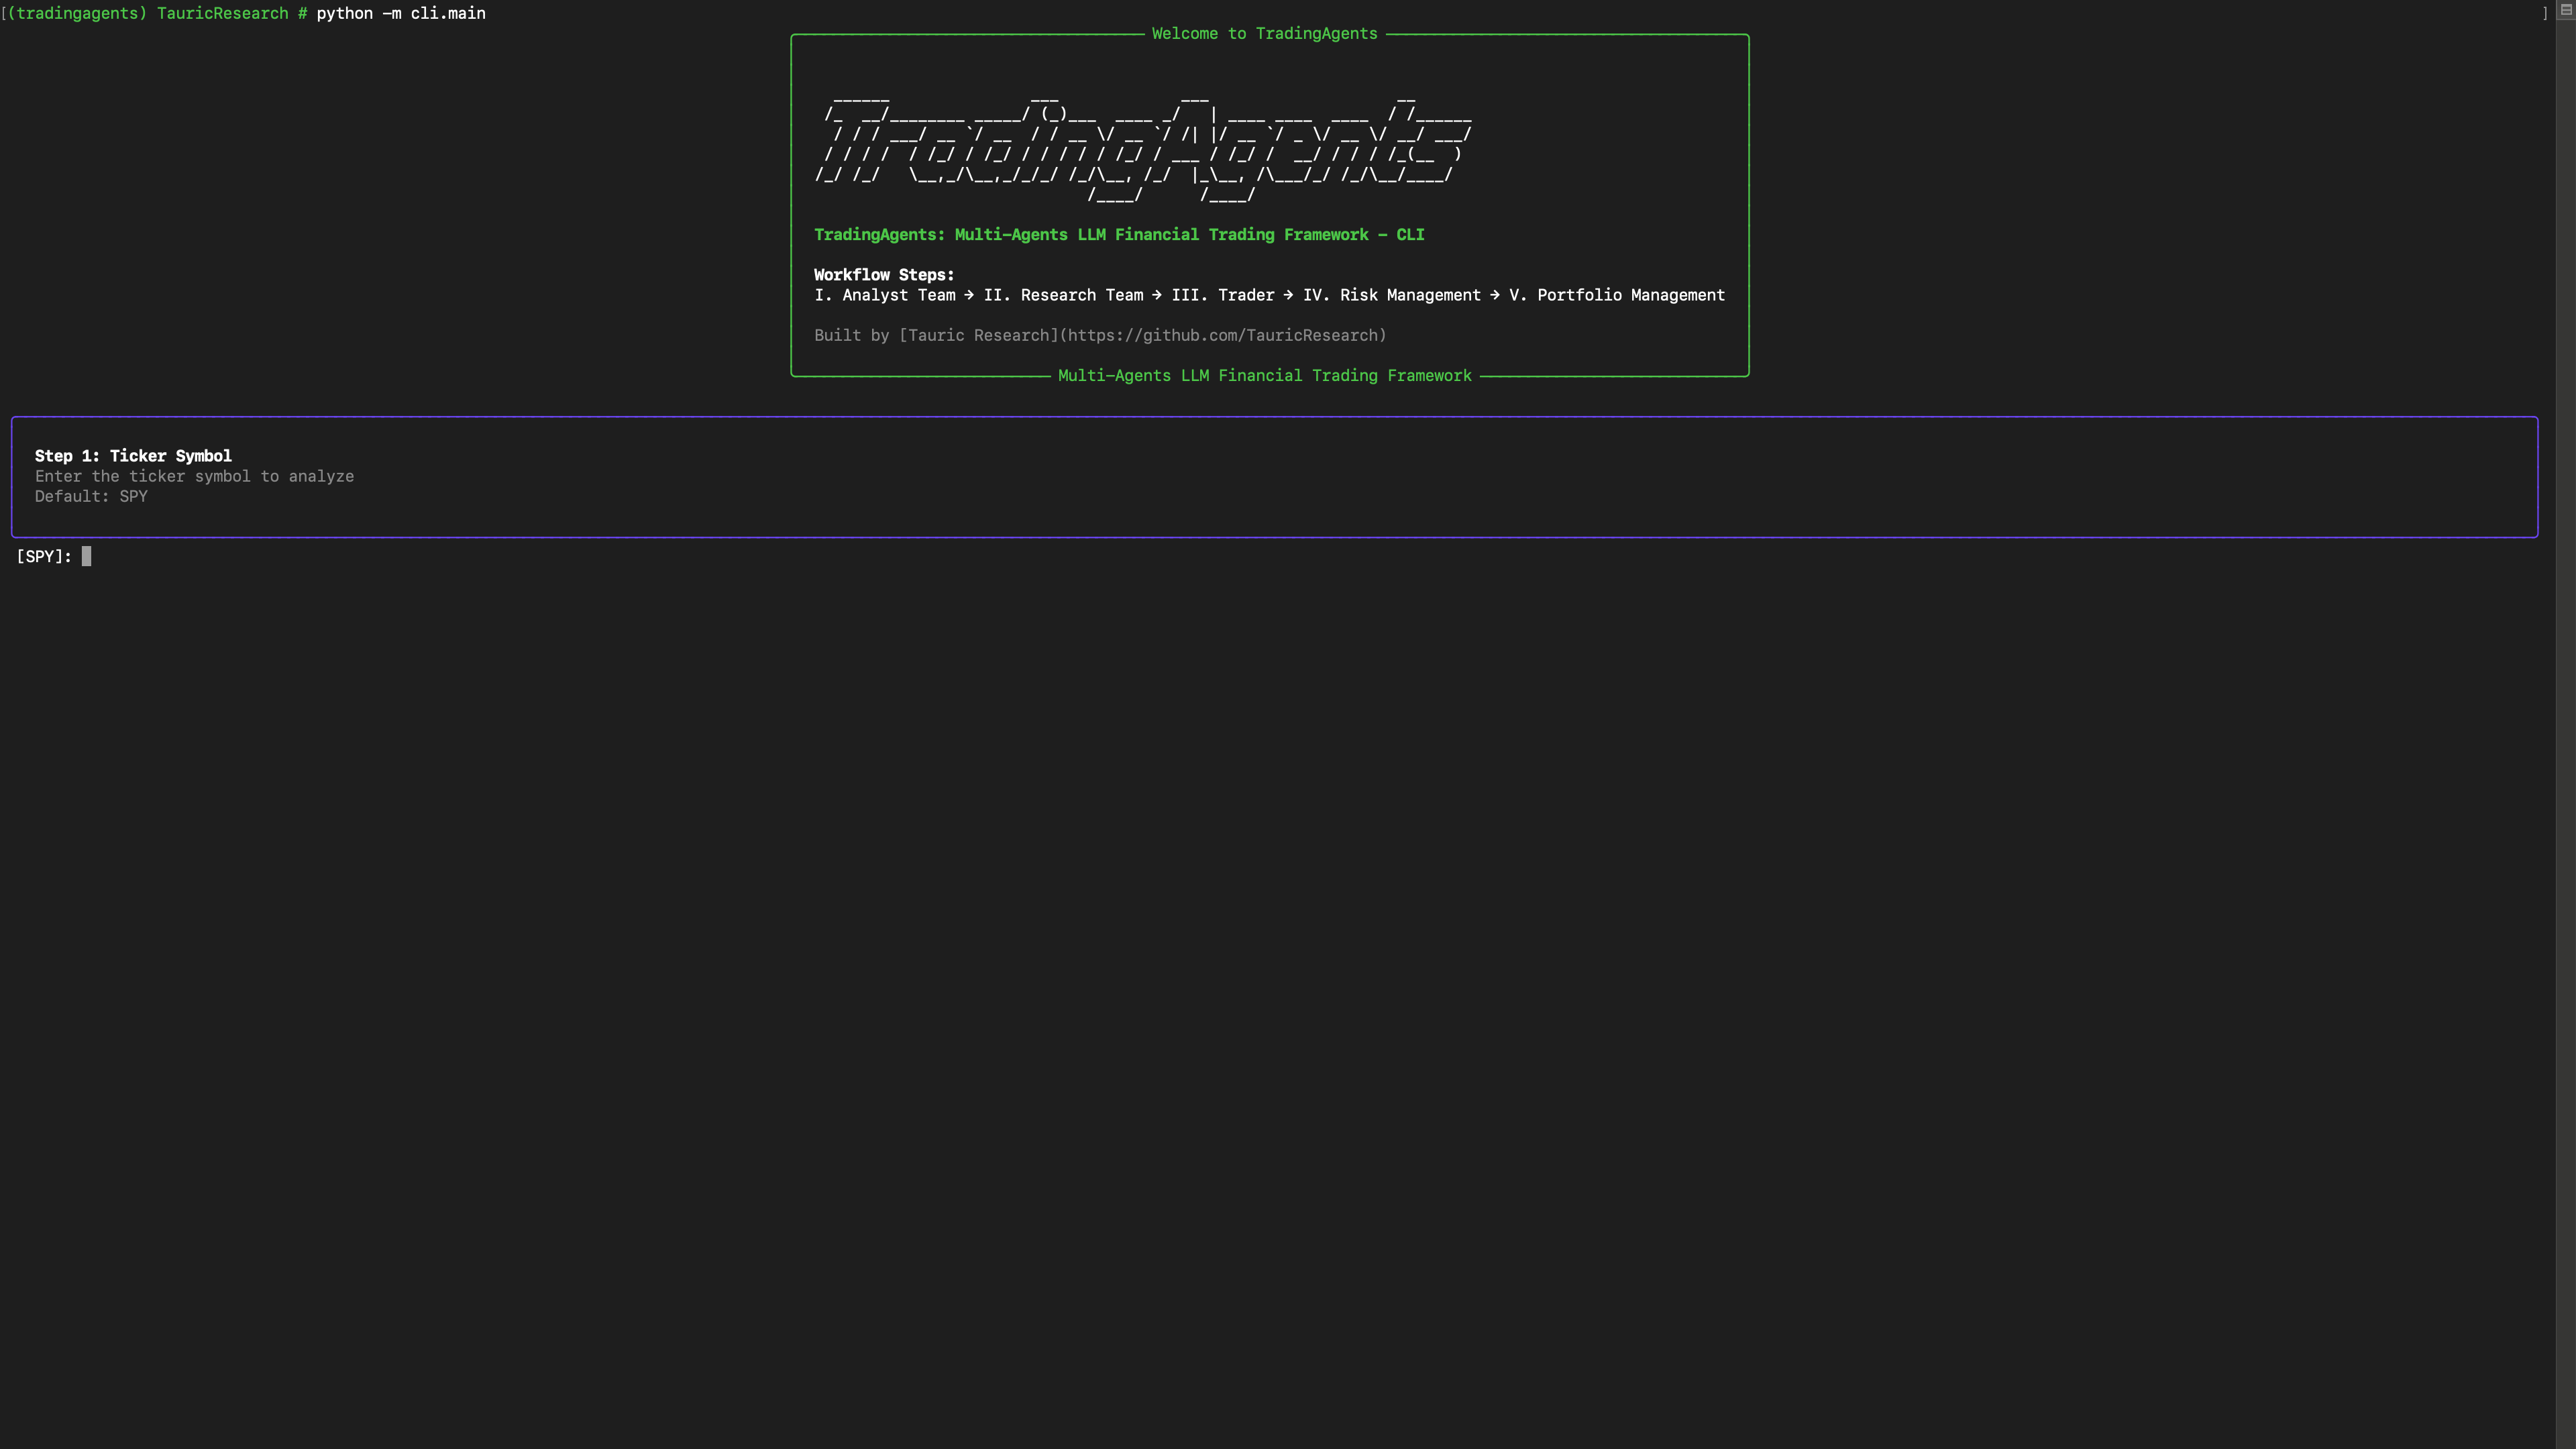
6. 启动交互式 CLI
tradingagents          # 已安装的命令
# 或从源码直接运行
python -m cli.main
启动后按提示选择股票代码、分析日期、LLM 提供商、研究深度等。上一次的选择会作为默认值,直接回车即可。
第一次运行建议把研究深度调到最低、辩论轮数设为一轮,先观察整个流程是否能跑通、报告格式是否正常。完整流程会调用多个智能体并消耗较多 token,一上来就用最贵的模型和最多轮次,一旦中间报错就要重来,成本不低。跑通一次后,再逐步升级模型与辩论轮数,这样既能控制花费,也能清楚看到每个环节的输出。
六、API 用法与示例
1. 命令行非交互运行
适合定时任务或脚本:
export TRADINGAGENTS_LLM_PROVIDER=openai \
       TRADINGAGENTS_QUICK_THINK_LLM=gpt-6-luna \
       TRADINGAGENTS_DEEP_THINK_LLM=gpt-6-sol

tradingagents --ticker NVDA --date 2026-09-23 \
  --analysts market,news,fundamentals --save --no-show
常用 flag:
| 参数 | 作用 |
|---|---|
--ticker |
股票代码(支持 .HK/.SS/.SZ/.T 等后缀) |
--date |
分析日期 |
--analysts |
选择启用的分析师 |
--save |
保存报告 |
--no-show |
不弹出结果界面 |
--checkpoint |
启用断点恢复 |
非交互模式适合接进定时任务或批量脚本。把环境变量写进 .env 文件后,一条命令就能跑完一次完整分析,输出报告。--analysts 参数让你按需关闭不需要的分析师——比如只关心技术面时,就不必跑新闻与基本面分析,能省下不少 token。
2. Python 调用
from tradingagents.graph.trading_graph import TradingAgentsGraph
from tradingagents.default_config import DEFAULT_CONFIG

ta = TradingAgentsGraph(debug=True, config=DEFAULT_CONFIG.copy())
state, decision = ta.propagate("NVDA", "2026-09-01")
print(decision)
ta.save_reports(state, "NVDA")
3. 自定义配置
config = DEFAULT_CONFIG.copy()
config["llm_provider"] = "openai"
config["deep_think_llm"] = "gpt-6-sol"      # 复杂推理模型
config["quick_think_llm"] = "gpt-6-luna"    # 快速任务模型
config["max_debate_rounds"] = 2

# 让经理层用 Claude,其余用 OpenAI
config["deep_think_provider"] = "anthropic"
config["deep_think_llm"] = "claude-opus-5-5"

ta = TradingAgentsGraph(debug=True, config=config)
_, decision = ta.propagate("NVDA", "2026-09-01")
print(decision)
4. 回测
from tradingagents.backtest import iter_grid, run_backtest, summarize

dates = iter_grid("2026-06-01", "2026-08-01", every_n_days=7)
result = run_backtest(["NVDA", "AAPL"], dates, config,
                      selected_analysts=["market", "news"])
print(summarize(result).render())
CLI 等价命令:
tradingagents backtest NVDA,AAPL --start 2026-06-01 --end 2026-08-01 --every 7
控制成本与可复现性的实践
一次完整运行会让四位分析师、多空研究员、交易员、风控经理分别调用模型,加上多轮辩论,token 消耗不小。建议先用 quick_think_llm 指向便宜快速的模型跑通流程,再把 deep_think_llm(经理层用的复杂推理模型)换成更强的模型。max_debate_rounds 从 1 开始调,确认输出格式正常后再加到 2 到 3 轮。分析日期固定在历史某天,可以避免"新闻随时间变化"带来的不可复现;如果要做严格对比,把 temperature 设低甚至为 0。
回测时注意:框架明确说明回测结果不保证复现任何公开收益数字,因为模型采样与实时数据都在变。它的价值是让你在一个可控的网格上观察"多智能体流程是否比单模型更稳",而不是预测涨跌。把它当成研究多智能体协作的实验台,而不是赚钱策略。
框架的技术内核:为什么是 LangGraph
TradingAgents 选 LangGraph 作为底层,是因为多智能体流程本质是一张带条件分支的有向图:分析师并行执行后汇合、研究员辩论若干轮后进入交易员、交易员提案后由风控决定通过还是驳回。LangGraph 用节点表示智能体、边表示状态流转,天然支持这种循环与分支。它还自带 checkpoint 机制——这就是为什么崩溃后能从中断处续跑,因为每一步的中间状态都被持久化了。
理解这一点,你就能读懂仓库里的 trading_graph.py:每个角色是一个节点函数,接收全局状态、调用 LLM 与工具、把结果写回状态;边函数决定下一个节点走向(比如辩论是否继续)。想定制自己的智能体,不必从零搭框架,只要在这张图里加节点、改边、换提示词即可。这也是它比"一个巨大 system prompt"式方案更可扩展的原因——角色之间的职责、工具、提示词都是隔离的。
读懂状态流转,比纠结预测结果更有收获。
七、常见问题 FAQ
下面整理了初次部署与运行时最常遇到的几个疑问,供快速排查参考。框架涉及多个智能体与外部数据源,报错往往来自 API Key 缺失、模型未配置或数据接口限流,下面给出常见应对。
Q1:运行一次大概要花多少钱 / 多久?
框架会让多个分析师、研究员、交易员、经理分别调用 LLM,并进行多轮辩论,token 消耗显著。建议先用小模型(quick_think_llm)跑通流程,再决定是否升级到推理型模型。具体成本取决于所选模型与辩论轮数。
Q2:为什么同一只股票两次运行结果不一样?
LLM 采样本身不确定,加上新闻、社交数据随时间变化。这是研究工具的预期行为,不是 bug。可通过降低 temperature、指定非推理型模型来提高可复现性。
Q3:支持哪些股票市场?
Yahoo Finance 覆盖的市场都支持,用带交易所后缀的代码:美股 AAPL、港股 0700.HK、A股 600519.SS、东京 7203.T、加密货币 BTC-USD 等。
Q4:SEC EDGAR 数据为什么要设置 User-Agent?
SEC 要求请求方标识身份。默认会发送一个联系地址,建议设置自己的:
export SEC_EDGAR_USER_AGENT="Your Name your@email.com"
Q5:可以用本地 Ollama 模型吗?
可以。设置 llm_provider: "ollama",默认端点 http://localhost:11434/v1,用 ollama pull <name> 拉模型。也支持任何 OpenAI 兼容端点(vLLM、LM Studio 等),用 openai_compatible 提供商并设置 backend_url。
最后再强调一次:TradingAgents 是研究多智能体协作的实验台,不是赚钱工具。它的价值在于让你观察"多个分工明确的 LLM 如何协作完成一个复杂决策任务",并把这套架构借鉴到自己的智能体系统里。跑通它、读懂它的状态流转、尝试增减智能体,比纠结它预测得准不准更有收获。
以上就是这个多智能体交易框架的本地部署与运行要点。把它当作研究多智能体协作的实验台,比纠结预测准确率更有价值。
八、相关链接
- 仓库主页:github.com/TauricResearch/TradingAgents
- 研究论文:arXiv:2412.20138
- 更新日志:CHANGELOG.md
- 免责声明:tauric.ai/disclaimer
- Discord 社区:加入聊天
本文命令与配置对照仓库 README 整理,模型名称与接口可能随版本变化,且本框架仅用于研究,不构成投资建议。