
TraceAnything:超详细部署与使用教程
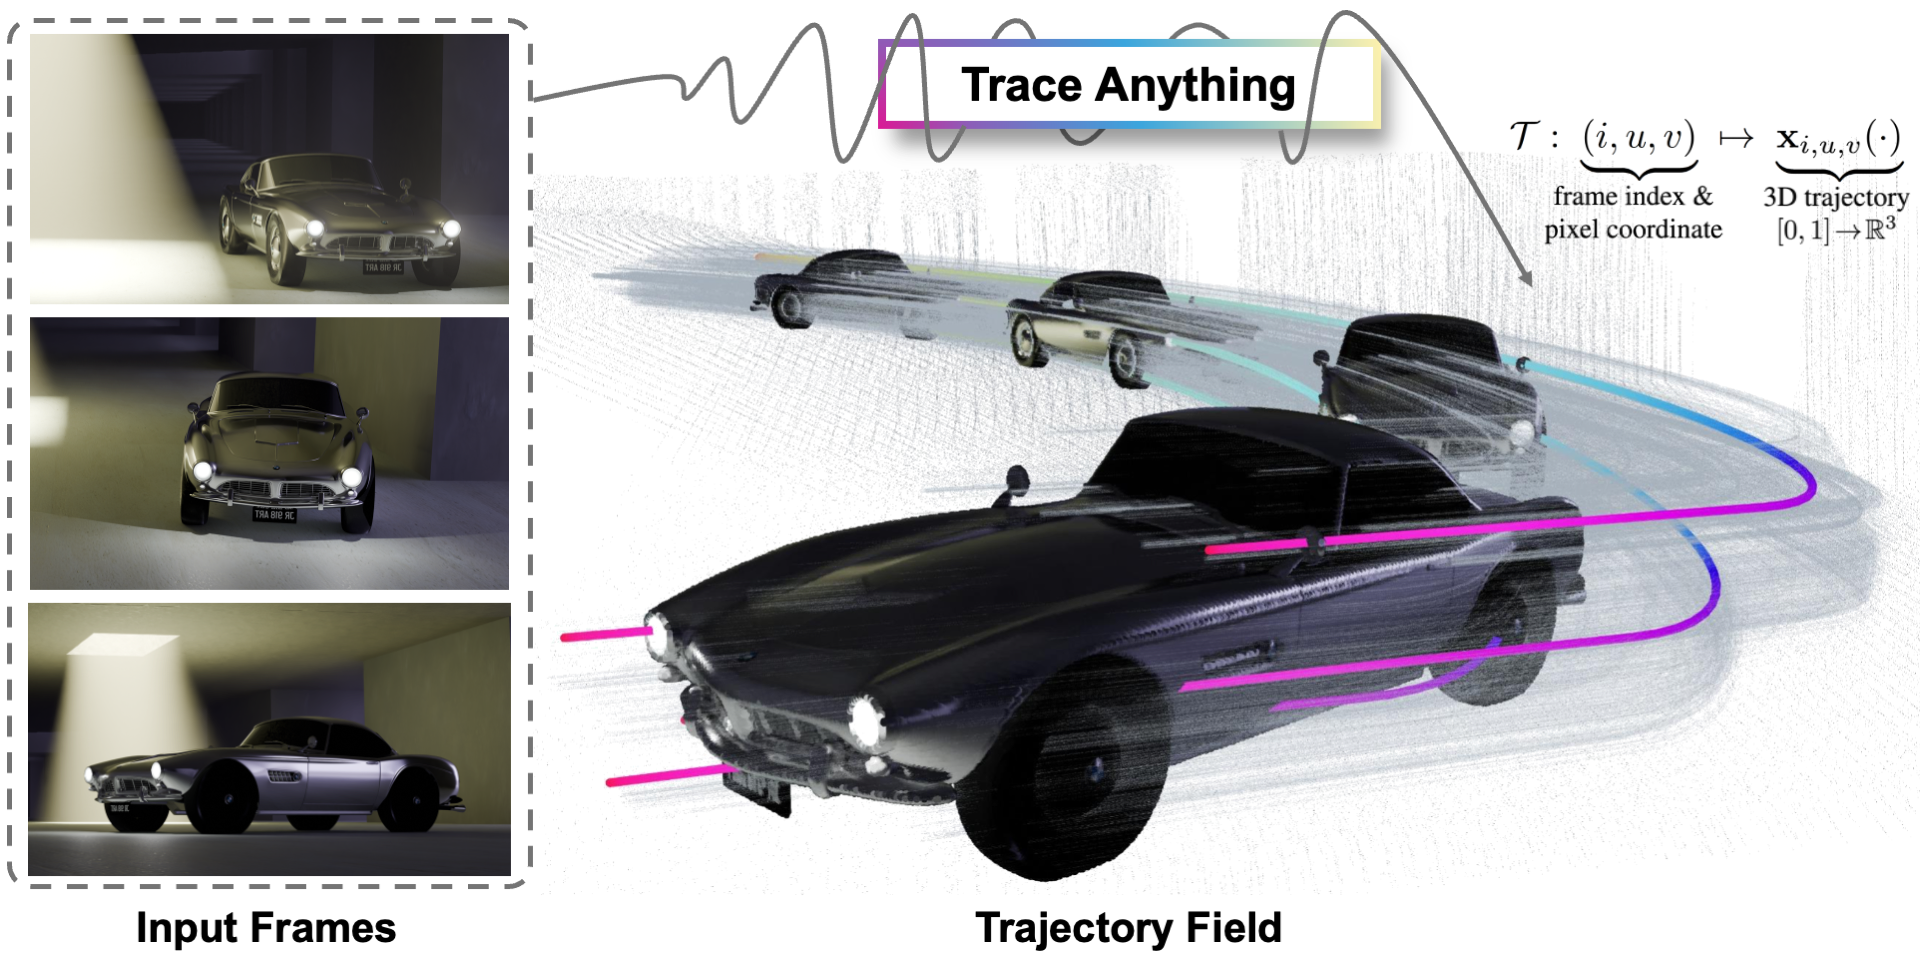
TraceAnything(Trace Anything)是字节跳动 Seed 团队联合港科大、浙大、达特茅斯学院推出的 4D 视频表示模型(arXiv:2510.13802,ICLR 2026):它提出「轨迹场(trajectory field)」——把视频中每一像素在帧间的轨迹映射为连续、参数化的 3D 曲线。单次前向传播即可为任意视频、图像对或非结构化图像集估计轨迹场,并在交互式 3D 查看器中逐点追踪任意像素的运动轨迹。官方提供完整 PyTorch 推理代码(Apache-2.0)与预训练权重(CC BY-NC 4.0)。

| 所属公司 | GitHub 仓库 | 官方文档/官网 | 开源协议 | Star 数 | 最新版本(截至 2026-10-27) | 主要语言 |
|---|---|---|---|---|---|---|
| 字节跳动(Seed 团队,联合 HKUST / 浙大 / Dartmouth) | github.com/ByteDance-Seed/TraceAnything | 项目主页:trace-anything.github.io ;模型权重:HF depth-anything/trace-anything ;论文:arXiv:2510.13802 | 代码 Apache-2.0;权重 CC BY-NC 4.0(研究/非商用) | 587 | 主分支推理版(2025-10 起) | Python |
目录
一、项目概述
1.1 项目定位
传统「点追踪」(如 CoTracker、SpaTracker)只能回答「某个点在第几帧在哪」;TraceAnything 把问题升维:
- 轨迹场表示:为视频中每个像素估计一条连续参数化的 3D 轨迹(随时间变化的空间位置),构成整个视频的 4D 表示;
- 单前向传播:无需逐帧迭代,一次前向输出整段视频所有点的轨迹;
- 输入灵活:任意视频、图像对、或(未来)非结构化图像集;
- 交互探索:内置基于 Viser 的交互式 3D 查看器,拖动时间轴即可看任意点轨迹的演化。
论文核心问题:如何用一个统一表示,把任意视频「压缩」为可查询、可交互的轨迹场。
1.2 核心功能
| 功能 | 说明 |
|---|---|
| 视频轨迹场估计 | 输入视频帧序列,输出每像素的连续 3D 轨迹参数 |
| 图像对推理 | 两张图片(如立体/连续帧)也可估计轨迹场 |
| 置信度图 | 逐点轨迹置信度,用于过滤噪声背景点 |
| 自动前景掩码 | 基于控制点方差的 Otsu 阈值自动分割前景 |
| 时间戳预测 | 网络自带时间头,估计每帧时间 ∈ [0,1) |
| 交互式 3D 查看器 | 浏览器中旋转视角、拖动时间轴、点大小调节 |
| SAM2 用户掩码 | 可选:点选首帧目标生成逐帧前景掩码 |
1.3 技术架构
- 输入:按时间有序的图像序列(视频帧或图像对),长边统一缩放到 512、再裁剪为 16 的倍数;视图数超过 40 时自动降采样;
- 模型:单次前向输出每个场景的轨迹场;
- 输出
output.pt结构:
| 字段 | 形状 | 含义 |
|---|---|---|
preds[i]['ctrl_pts3d'] |
[K, H, W, 3] |
3D 控制点(轨迹参数) |
preds[i]['ctrl_conf'] |
[K, H, W] |
逐点置信度图 |
preds[i]['fg_mask'] |
[H, W] |
Otsu 自动二值前景掩码 |
preds[i]['time'] |
标量 ∈ [0,1) | 预测时间戳 |
views[i]['img'] |
[-1,1] 张量 |
归一化输入图像 |
项目站在 DUSt3R / Fast3R / VGGT / MonST3R / Easi3R / St4RTrack / POMATO / SpaTrackerV2 等研究基础上(README 致谢列表)。
二、环境要求
| 项目 | 要求 |
|---|---|
| 操作系统 | Linux(官方主力,Ubuntu 20.04/22.04);Windows 建议 WSL2 |
| Python | ≥ 3.10(官方示例用 conda 建 python=3.10) |
| CUDA | 官方测试环境 CUDA 12.8;PyTorch 按 CUDA 版本安装 |
| GPU 显存 | 单卡 ≥ 48GB VRAM(官方示例测试配置;如 A6000/A100/RTX 6000 Ada 级别) |
| 依赖 | einops、omegaconf、pillow、opencv-python、viser、imageio、matplotlib、torchvision |
| 磁盘 | 代码 + 权重 + 示例输入,预留 ≥ 20GB(权重 trace_anything.pt 较大) |
| 网络 | 需能访问 GitHub 克隆仓库、HuggingFace 下载权重(国内可换镜像) |
硬件现实:48GB 显存是硬门槛之一。消费级显卡(24GB)直接跑官方示例大概率 OOM,先确认显存再开工。
三、部署方式
3.1 克隆仓库并建环境
# 1) 克隆仓库
git clone https://github.com/ByteDance-Seed/TraceAnything.git
cd TraceAnything

# 2) 创建并激活 conda 环境
conda create -n trace_anything python=3.10
conda activate trace_anything
3.2 安装 PyTorch 与依赖
# 1) 按本机 CUDA 版本安装 PyTorch(官方测试为 CUDA 12.8)
#    以 cu128 为例,按 https://pytorch.org  selector 给出的命令为准:
pip3 install torch torchvision --index-url https://download.pytorch.org/whl/cu128

# 2) 安装其余依赖
pip install einops omegaconf pillow opencv-python viser imageio matplotlib torchvision
3.3 下载模型权重
官方权重托管在 HuggingFace depth-anything/trace-anything:
# 在仓库根目录建立 checkpoints 目录
mkdir -p checkpoints

# 下载权重(约数百 MB,耐心等待)
curl -L -o checkpoints/trace_anything.pt \
  "https://huggingface.co/depth-anything/trace-anything/resolve/main/trace_anything.pt?download=true"
国内网络访问 HF 慢时,走镜像:
# 方案 A:HF 镜像端点
export HF_ENDPOINT=https://hf-mirror.com
huggingface-cli download depth-anything/trace-anything trace_anything.pt \
  --local-dir checkpoints

# 方案 B:手动浏览器打开 https://huggingface.co/depth-anything/trace-anything 下载后放入 checkpoints/
3.4 验证部署成功
# 1) 权重就位
ls -lh checkpoints/trace_anything.pt

# 2) 依赖可导入
python -c "import torch, einops, omegaconf, cv2, viser, imageio; print('deps ok')"

# 3) 跑官方示例推理
python scripts/infer.py
预期:控制台开始处理 examples/input/ 下各场景,输出写到 examples/output/<scene>/output.pt。
四、使用方法
4.1 基础推理:跑通示例
仓库自带示例输入,目录结构约定为:
examples/
  input/
    scene_name_1/   # 一个场景 = 一组有序帧/图像对
    scene_name_2/
# 跑全部示例场景
python scripts/infer.py
常用参数(均有默认值,可按需覆盖):
| 参数 | 默认值 | 说明 |
|---|---|---|
--config |
configs/eval.yaml |
推理配置文件 |
--ckpt |
checkpoints/trace_anything.pt |
权重路径 |
--input_dir |
examples/input |
输入场景根目录 |
--output_dir |
examples/output |
输出根目录 |
带参运行示例:
python scripts/infer.py \
  --input_dir examples/input \
  --output_dir examples/output \
  --ckpt checkpoints/trace_anything.pt
结果输出:
<output_dir>/<scene>/output.pt          # 轨迹场主结果
<output_dir>/<scene>/masks/*.png        # 各帧自动前景掩码图
输入图片规则(官方 Notes):
- 图片须满足 W ≥ H(竖版图会自动转置);
- 长边统一 resize 到 512,再裁到 16 的倍数(模型要求);
- 视图数超过 40 自动降采样;
- 输入需按时间有序(视频帧/图像对);非结构化无序输入官方后续版本才支持。
4.2 交互可视化:3D 查看器
推理完成后,启动浏览器端交互式查看器:
python scripts/view.py --output examples/output/<scene>/output.pt
常用参数:
| 参数 | 默认 | 说明 |
|---|---|---|
--port |
8020 | 查看器端口 |
--t_step |
0.025 | 时间步长(越小轨迹曲线越细) |
--ds |
2 | 数据降采样倍数(::2 加速) |
远程服务器使用时,SSH 端口转发:
ssh -N -L 8020:localhost:8020 <user>@<server>
# 然后本机浏览器打开 http://localhost:8020
操作方式:
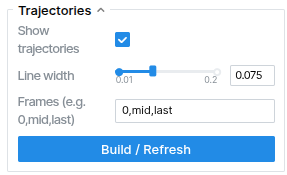
- 在 Trajectory 面板输入帧号,或直接输入
mid/last; - 点击 Build / Refresh 构建轨迹;
- 勾选 Show trajectories 显示轨迹;
- 鼠标拖动旋转视角、拖动时间轴看轨迹演化、调节点大小、按置信度过滤噪声点。
4.3 进阶:SAM2 用户引导掩码(可选)
官方自动掩码(基于控制点方差的 Otsu)不够准时,可用 SAM2 交互框选:
# 1) 安装 SAM2(https://github.com/facebookresearch/sam2)并下载其 checkpoint

# 2) 跑用户掩码脚本:首帧点选目标,生成逐帧掩码
python scripts/user_mask.py --scene examples/output/<scene> \
  --sam2_cfg configs/sam2.1/sam2.1_hiera_l.yaml \
  --sam2_ckpt <path_to_sam2_ckpt>
产物:
<scene>/masks/{i:03d}_user.png:逐帧用户掩码图;- 同时回写
<scene>/output.pt,新增字段preds[i]["fg_mask_user"]; - 可视化时存在
fg_mask_user会自动优先生效。
4.4 适用场景
- 视频运动分析:任一物体/像素在整段视频中的完整运动轨迹;
- 视觉研究:4D 场景表示、长时序点追踪的新 baseline;
- 影视/动效:镜头内物体运动的定量提取;
- 机器人/AR:像素级时空轨迹先验的构建。
五、常见问题排查(FAQ)
Q1:显存不足(CUDA out of memory)
- 原因:官方要求单卡 ≥ 48GB VRAM,24GB 消费卡会爆。
- 解决:① 换 ≥ 48GB 显卡(A6000/A100 等);② 推理时用 --ds 加大降采样;③ 减少单次输入视图数(>40 帧会自动降采样,可手动减少输入)。
Q2:pip 安装 viser / omegaconf 失败
- 原因:Python 版本不对或网络问题。
- 解决:确认在 trace_anything conda 环境内(Python 3.10);换 PyPI 镜像源重试。
Q3:权重下载中断/磁盘不足
- 解决:断点续传重新执行同一 curl 命令;先 df -h 确认大盘;国内用 HF_ENDPOINT=https://hf-mirror.com。
Q4:scripts/infer.py 报输入图方向错误
- 说明:官方约定输入 W ≥ H;竖版图会被自动转置——这是预期行为,不是报错。
Q5:视图数超过 40 帧会怎样? - 脚本自动降采样,不报错;长视频建议自行抽帧到 40 帧以内再跑,效果更可控。
Q6:可视化页面打不开(远程服务器)
- 解决:用 SSH 端口转发 ssh -N -L 8020:localhost:8020 user@server,本机开 http://localhost:8020;云服务器注意安全组放行 8020。
Q7:自动前景掩码不准 - 解决:用 4.3 的 SAM2 用户引导掩码,首帧点选目标后逐帧传播;可视化会优先用用户掩码。
Q8:输出 output.pt 里的字段怎么用?
- 见 1.3 表格:ctrl_pts3d 是轨迹控制点、ctrl_conf 是置信度、fg_mask 是前景掩码;可用 PyTorch 直接加载后自行做后处理与可视化。
Q9:非结构化图片集(无时间顺序)能跑吗? - 官方当前版本假设输入按时间有序;无序输入支持标注为「后续版本发布」。
Q10:Windows 能跑吗? - 官方以 Linux 为准;Windows 建议 WSL2 内按本文步骤安装,避免原生 Windows 环境踩坑。
六、部署注意事项与最佳实践
- 显存是第一门槛:单卡 ≥48GB 再开始;小显存机器不要硬跑示例。
- 输入规范:W ≥ H、长边 512、16 倍数裁剪、≤40 帧,四条都遵守能避开大部分输入报错。
- 权重许可要看清:代码 Apache-2.0 可商用,但权重 CC BY-NC 4.0 仅限研究与非商用,商用前必须联系官方获授权。
- 国内下载走镜像:
HF_ENDPOINT=https://hf-mirror.com解决 HuggingFace 慢/断问题。 - 先跑官方示例再换自己的数据:示例跑通证明环境正确,再把自己的视频抽帧放到
examples/input/新场景目录。 - 可视化配合置信度过滤:噪声点多的场景按
ctrl_conf过滤,轨迹更干净。 - 关注版本更新:非结构化无序输入、更多能力官方在路线图上,定期看仓库 Release。
- 引用规范:使用成果请引用 arXiv:2510.13802(BibTeX 见仓库 README)。
七、参考资料
- GitHub 仓库:https://github.com/ByteDance-Seed/TraceAnything
- 项目主页:https://trace-anything.github.io/
- 论文:https://arxiv.org/abs/2510.13802
- HuggingFace 权重:https://huggingface.co/depth-anything/trace-anything
- 交互式结果演示:https://trace-anything.github.io/viser-client/interactive.html
- YouTube 视频:https://youtu.be/J6y5l2E6qjA
- 可视化工具 Viser:https://github.com/nerfstudio-project/viser
- SAM2(可选掩码):https://github.com/facebookresearch/sam2