
Seed-Coder:超详细部署与使用教程
Seed-Coder(原名 Doubao-Coder)是字节跳动 Seed 团队开源的轻量级代码大模型家族,全部为 8B 量级,包含 Base(预训练基座)、Instruct(指令对齐)、Reasoning(RL 推理增强)三类变体,上下文长度覆盖 32K / 64K。它的核心主张是「让代码模型自己为自己筛选训练数据」(model-centric data curation):用 LLM 而非人工规则来清洗 GitHub 代码、commit 数据与代码相关网页数据,在极少人工干预下把 8B 小模型的代码能力推到同级 SOTA。权重以 MIT 协议完全开源,基于 HuggingFace
transformers与vLLM均可直接加载推理。
| 所属公司 | GitHub 仓库 | 官方文档/官网 | 开源协议 | Star 数 | 最新版本(截至 2026-10-27) | 主要语言 |
|---|---|---|---|---|---|---|
| 字节跳动(Seed 团队) | github.com/ByteDance-Seed/Seed-Coder | 项目主页:bytedance-seed-coder.github.io ;模型集合:HuggingFace ByteDance-Seed/seed-coder ;技术报告:arXiv:2506.03524 | MIT | 约 760 | Seed-Coder-8B 系列(2025-05-08 发布) | Python |
目录
一、项目概述
1.1 项目定位
Seed-Coder 仓库是字节 Seed 团队在代码大模型方向的官方开源入口。它与「只放一堆权重」的仓库不同,强调三件事:
- 模型权重:Seed-Coder-8B 全系 4 个模型(Base / Instruct / Reasoning / Reasoning-bf16)的预训练与后训练权重,全部托管在 HuggingFace;
- 数据方法透明:官方在技术报告中公开了「以模型为中心」的数据流水线,包括如何用 LLM 筛选 GitHub 仓库数据、git commit 数据与代码网页数据,尽量减少人工规则;
- 开箱即用推理:官方 README 直接给出
transformers与vLLM两种部署方式,支持张量并行多卡服务。
官方定位很明确:用 8B 小参数做出同级最强代码能力,并把数据配方公开,服务开源代码智能生态。
1.2 核心功能(Seed-Coder-8B 模型家族,以官方 README 为准)
Seed-Coder 共 4 个模型变体,全部 8B 规模:
| 模型名 | 上下文长度 | 下载 | 说明 |
|---|---|---|---|
| Seed-Coder-8B-Base | 32K | HuggingFace | 在模型中心化代码数据上预训练的基座模型 |
| Seed-Coder-8B-Instruct | 32K | HuggingFace | 指令微调,对齐用户意图(日常对话/补全首选) |
| Seed-Coder-8B-Reasoning | 64K | HuggingFace | RL 训练,增强代码推理能力 |
| Seed-Coder-8B-Reasoning-bf16 | 64K | HuggingFace | Reasoning 模型的 bf16 权重版本 |
其他要点:
- Model-centric(以模型为中心):训练数据过滤主要靠 LLM 本身而非人工手写规则,最大限度减少预训练数据构造中的人工成本。
- Transparent(透明):公开 GitHub 数据、commit 数据、代码网页数据的筛选方法细节。
- Powerful(同级最强):在代码生成、代码补全、代码编辑、代码推理、软件工程任务等多种 coding benchmark 上达到 ~8B 开源模型 SOTA,部分指标超过更大模型。
- vLLM 全支持:官方明确说明 Seed-Coder-8B-Instruct 被新一代代码模型推理框架 vLLM 完整支持,可离线批量推理,也可张量并行多卡服务。
- 推理默认采样参数:官方给出
temperature=0.6, top_p=0.8, repetition_penalty=1.05的推荐解码配置。
1.3 技术架构
下图是官方发布的 Seed-Coder 性能总览图(在多种代码 benchmark 上与同级及更大模型的对比,官方宣称 8B 规模 SOTA):
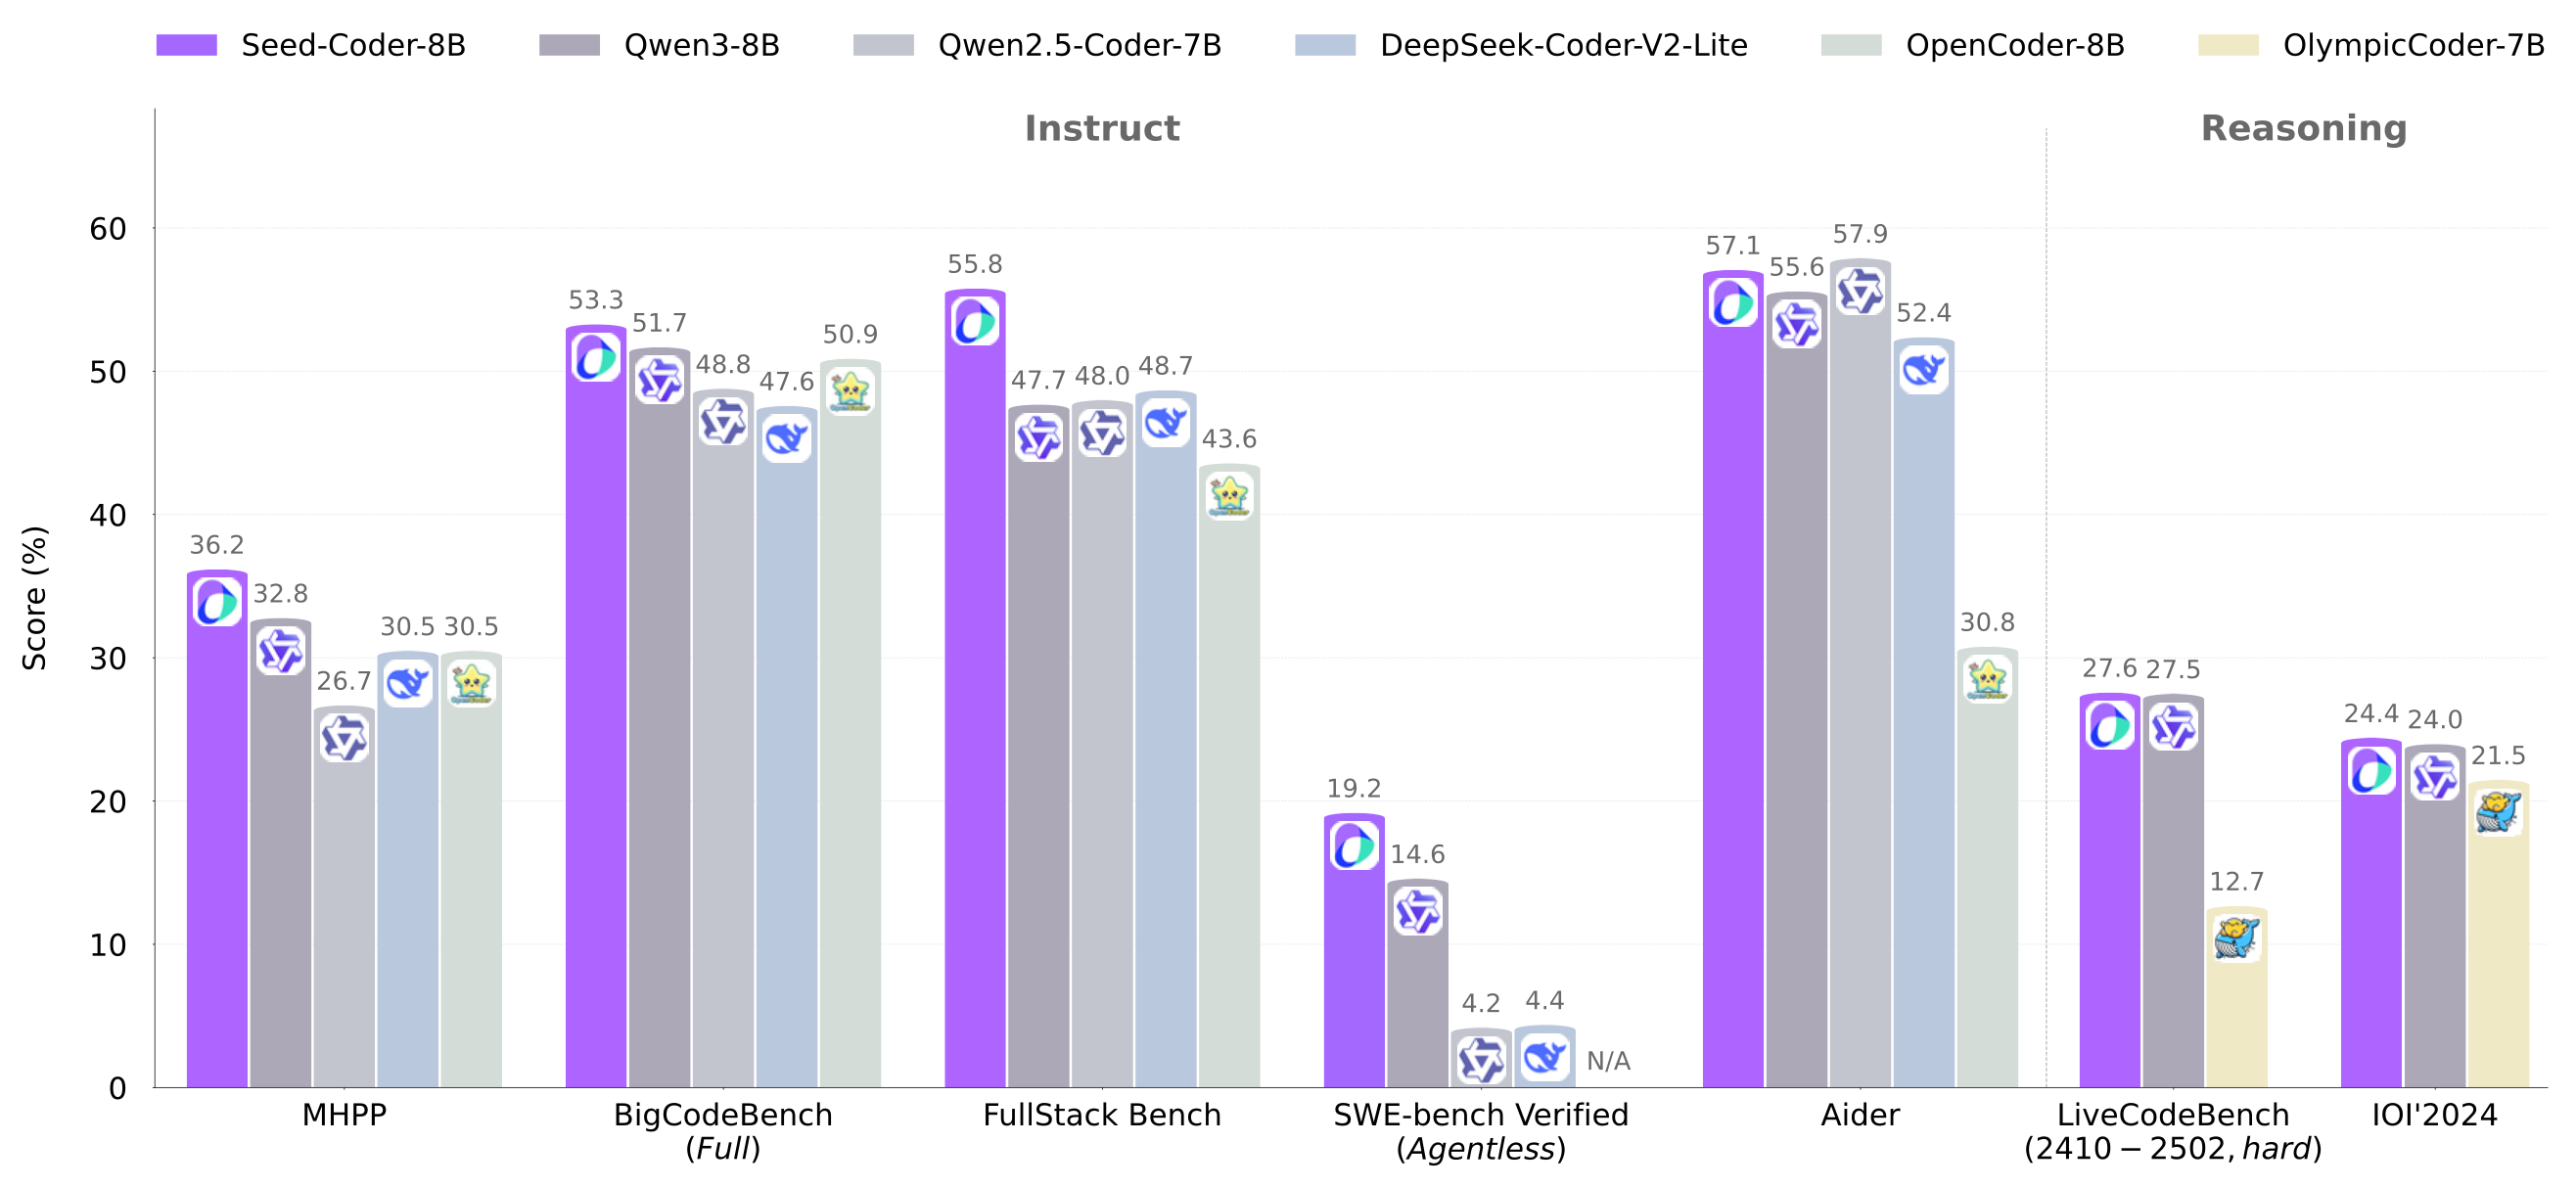
在 HuggingFace 模型卡上,官方给出了 Seed-Coder-8B-Instruct 在主流代码 benchmark 上的具体得分(与 CodeLlama-7B、DeepSeek-Coder-6.7B、Qwen2.5-Coder-7B、Qwen3-8B 等对照):
| 模型 | HumanEval | MBPP | MHPP | BigCodeBench(Full) | BigCodeBench(Hard) | LiveCodeBench(2410–2502) |
|---|---|---|---|---|---|---|
| DeepSeek-Coder-6.7B-Instruct | 74.4 | 74.9 | 20.0 | 43.8 | 15.5 | 9.6 |
| Yi-Coder-9B-Chat | 82.3 | 82.0 | 26.7 | 49.0 | 17.6 | 17.5 |
| Qwen2.5-Coder-7B-Instruct | 88.4 | 83.5 | 26.7 | 48.8 | 20.3 | 17.3 |
| Qwen3-8B | 84.8 | 77.0 | 32.8 | 51.7 | 23.0 | 23.5 |
| Seed-Coder-8B-Instruct | 84.8 | 85.2 | 36.2 | 53.3 | 26.4 | 24.7 |
注:以上为 HuggingFace 模型卡公布的数字;官方 README 提到 2025/05/14 曾修正 BigCodeBench 为 Completion 设定口径,详细分析以技术报告(仓库内
Seed-Coder.pdf)为准。
二、环境要求
| 项目 | 要求 |
|---|---|
| 操作系统 | Linux(官方推理主力,Ubuntu 20.04/22.04 等);Windows 建议用 WSL2 做轻量实验 |
| Python | 3.9–3.12 区间(transformers 与 accelerate 支持的版本) |
| 框架底座 | transformers + accelerate(官方要求安装最新版);生产服务推荐 vllm |
| GPU | 8B 模型 bf16 推理约需 16GB 显存(如 RTX 4090 / A10 即可单卡起步);Reasoning 长上下文(64K)建议更大显存或多卡 |
| 磁盘 | 单个 8B bf16 权重约 16GB,预留 30GB 以上空间;多模型共存按数量翻倍 |
| 网络 | 需能访问 HuggingFace 下载权重;国内可改用 hf-mirror.com 镜像 |
| 其他工具 | huggingface-cli(pip install -U huggingface_hub);多卡服务需 CUDA 与 NCCL 正常 |
重要:8B 模型虽小,但 Reasoning 变体上下文 64K,长上下文推理时 KV Cache 会显著吃显存;先从 Instruct(32K)跑通流程,再按需放大。
模型选型速查(按你的资源对号入座):
| 你的情况 | 推荐模型 |
|---|---|
| 单卡 16GB、日常代码补全/对话 | Seed-Coder-8B-Instruct(32K,最通用) |
| 需要基座做二次微调 | Seed-Coder-8B-Base(32K) |
| 复杂代码推理、要长上下文 | Seed-Coder-8B-Reasoning / Reasoning-bf16(64K) |
| 追求生产吞吐、批量推理 | Instruct + vLLM 张量并行 |
三、部署方式
下面给出三种路径:① 安装依赖与下载权重 → ② transformers 离线推理 → ③ vLLM 高性能服务。
3.1 第一步:安装依赖与下载权重
# 1) 创建虚拟环境(可选但推荐)
python -m venv venv
source venv/bin/activate

# 2) 安装官方要求的推理依赖(最新版 transformers + accelerate)
pip install -U transformers accelerate

# 3) 安装 HuggingFace 命令行(用于下载权重)
pip install -U huggingface_hub

# 4) 下载模型权重到本地(以 Instruct 为例,首次约 16GB)
huggingface-cli download ByteDance-Seed/Seed-Coder-8B-Instruct --local-dir ./Seed-Coder-8B-Instruct
国内网络访问 HuggingFace 慢时,改用镜像端点:
export HF_ENDPOINT=https://hf-mirror.com
huggingface-cli download ByteDance-Seed/Seed-Coder-8B-Instruct --local-dir ./Seed-Coder-8B-Instruct
模型名规则:HuggingFace 上四个模型仓库分别为
ByteDance-Seed/Seed-Coder-8B-Base、Seed-Coder-8B-Instruct、Seed-Coder-8B-Reasoning、Seed-Coder-8B-Reasoning-bf16。下载前在 HF 集合页 核对完整仓库名,不要臆造。
3.2 方式一:用 transformers 部署(官方示例)
官方 README 给出的最小可运行推理脚本(trust_remote_code=True):
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

model_id = "ByteDance-Seed/Seed-Coder-8B-Instruct"

tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
    trust_remote_code=True,
)

messages = [
    {"role": "user", "content": "Write a quick sort algorithm."},
]

input_ids = tokenizer.apply_chat_template(
    messages,
    tokenize=True,
    return_tensors="pt",
    add_generation_prompt=True,
).to(model.device)

outputs = model.generate(input_ids, max_new_tokens=512)
response = tokenizer.decode(outputs[0][input_ids.shape[-1]:], skip_special_tokens=True)
print(response)
说明:
model_id既可以填 HuggingFace 仓库名(自动下载),也可以填 3.1 下载好的本地路径./Seed-Coder-8B-Instruct;trust_remote_code=True必须加,该模型依赖仓库自带的 modeling 代码;- 换成 Reasoning 变体时,把
model_id换成ByteDance-Seed/Seed-Coder-8B-Reasoning(或-bf16)即可。
3.3 方式二:用 vLLM 部署(推荐生产/批量)
先装 vLLM(官方称 Seed-Coder-8B-Instruct 被 vLLM 完整支持):
pip install -U vllm
离线批量推理(官方示例)
from transformers import AutoTokenizer
from vllm import LLM, SamplingParams

# 初始化 tokenizer
tokenizer = AutoTokenizer.from_pretrained("ByteDance-Seed/Seed-Coder-8B-Instruct")

# 官方推荐的解码超参:temperature=0.6, top_p=0.8, repetition_penalty=1.05
sampling_params = SamplingParams(temperature=0.6, top_p=0.8, repetition_penalty=1.05, max_tokens=512)

# 输入模型名或本地路径;也支持 GPTQ / AWQ 量化模型
llm = LLM(model="ByteDance-Seed/Seed-Coder-8B-Instruct")

# 准备 prompt
prompt = "#write a quick sort algorithm."

# 批量生成
outputs = llm.generate([prompt], sampling_params)
for output in outputs:
    prompt = output.prompt
    generated_text = output.outputs[0].text
    print(f"Prompt: {prompt!r}\n\nGenerated content: {generated_text!r}")
多卡张量并行服务
长上下文(最高 32K)时用张量并行分摊显存:
llm = LLM(model="ByteDance-Seed/Seed-Coder-8B-Instruct", tensor_parallel_size=8)
张量并行度按实际 GPU 数填写(如 2 张卡就写
tensor_parallel_size=2)。vLLM 同时提供 OpenAI 兼容 API 服务(vllm serve命令),可直接对外暴露/v1/chat/completions,具体参数以 vLLM 官方文档为准。
3.4 验证部署成功
# 1) 权重已就位
ls ./Seed-Coder-8B-Instruct/
# 预期看到 config.json、tokenizer 文件、model-*.safetensors 等

# 2) 依赖可导入
python -c "import transformers, accelerate; print(transformers.__version__)"

# 3) 跑一次最小生成(见 3.2 脚本),能打印出快排代码即整条链路通
四、使用方法
4.1 基础用法:对话式代码生成
沿用 3.2 的脚本,把 messages 换成你的需求即可:
messages = [
    {"role": "user", "content": "用 Python 写一个带缓存的异步 HTTP 重试装饰器"},
]
input_ids = tokenizer.apply_chat_template(
    messages, tokenize=True, return_tensors="pt", add_generation_prompt=True,
).to(model.device)
outputs = model.generate(input_ids, max_new_tokens=1024)
print(tokenizer.decode(outputs[0][input_ids.shape[-1]:], skip_special_tokens=True))
要点:
- 必须用
tokenizer.apply_chat_template(..., add_generation_prompt=True)套对话模板,不要手动拼 prompt; max_new_tokens按期望输出长度调整,代码生成长函数可设到 1024–2048;- Reasoning 模型输出会包含推理过程,需要更长的生成预算。
4.2 常用解码参数(官方推荐)
| 参数 | 官方推荐值 | 说明 |
|---|---|---|
| temperature | 0.6 | 代码生成平衡多样性与稳定性 |
| top_p | 0.8 | 核采样 |
| repetition_penalty | 1.05 | 轻微抑制重复 |
| max_tokens | 512(示例) | 按需调大 |
以上为 vLLM 离线推理示例中官方给出的默认解码超参;transformers 路径下如需同等效果,在
model.generate(...)中对应传入即可。
4.3 进阶功能
- 长上下文处理:Instruct 支持 32K,Reasoning 支持 64K;处理大型代码仓库片段时注意显存,必要时开张量并行。
- 多卡高吞吐服务:用 vLLM 的
tensor_parallel_size或 OpenAI 兼容 server 模式对外服务,适合 IDE 插件、代码补全平台后端。 - 二次微调:Base 模型(
Seed-Coder-8B-Base)适合作为基座,用你的业务代码语料做 SFT;官方技术报告公开了数据配方,可参考构造高质量代码数据集。 - 量化部署:vLLM 路径明确支持 GPTQ / AWQ 量化模型,显存紧张时可加载量化版本进一步降本。
- 模型选型:日常补全/对话用 Instruct;复杂算法推理用 Reasoning;做底座微调用 Base。
4.4 适用场景
- 私有化部署的代码助手底座(MIT 协议可商用,8B 单卡可跑);
- IDE / 编辑器的 AI 代码补全后端(vLLM 高吞吐服务);
- 面向特定技术栈的二次微调(行业代码 SFT);
- 代码推理、竞赛级算法题生成(Reasoning 变体 64K 长上下文);
- 学习「模型中心化数据构造」方法论(官方公开数据流水线)。
五、常见问题排查(FAQ)
Q1:huggingface-cli download 卡住或超时
- 原因:国内访问 HuggingFace CDN 不稳定。
- 解决:export HF_ENDPOINT=https://hf-mirror.com 走镜像;大权重可配合 hf_transfer(pip install hf_transfer 并 export HF_HUB_ENABLE_HF_TRANSFER=1)加速。
Q2:加载 8B 模型报 CUDA out of memory
- 原因:bf16 全量权重约 16GB,再加 KV Cache 容易顶满小显存卡。
- 解决:① 确认 GPU 显存 ≥16GB;② 减小 max_new_tokens / 上下文长度;③ 多卡张量并行;④ 用 vLLM 加载 GPTQ/AWQ 量化版;⑤ 先用小 batch 验证流程。
Q3:trust_remote_code=True 不加会报错吗?
- 说明:会。该模型依赖仓库自带的 modeling 代码,from_pretrained 与 from_pretrained tokenizer 时都必须传 trust_remote_code=True,否则加载失败。
Q4:transformers 版本太旧/太新不兼容
- 原因:模型带 remote code,对 transformers 版本敏感。
- 解决:按官方要求 pip install -U transformers accelerate 升到最新;若遇到 remote code 报错,核对 HuggingFace 模型卡上标注的库版本。
Q5:生成的代码停在半截 / 重复循环
- 解决:调大 max_new_tokens;按官方推荐加 repetition_penalty=1.05;temperature 不要设成 0(代码任务建议 0.6 左右)。
Q6:vLLM 启动报模型不支持
- 原因:vLLM 版本过旧。
- 解决:pip install -U vllm 升到最新版;官方称 Seed-Coder-8B-Instruct 已被 vLLM 完整支持,旧版可能未收录该模型架构。
Q7:多卡张量并行 NCCL / 通信报错
- 解决:确认多卡环境 CUDA 与 NCCL 版本配套、卡间互通;先单卡跑通离线推理,再把 tensor_parallel_size 设为实际 GPU 数启动。
Q8:Reasoning 模型输出特别长、很慢 - 原因:Reasoning 变体先做推理再给答案,64K 上下文生成本身耗时。 - 解决:把它用在需要推理的难题上;日常补全用 Instruct 即可,不要拿 Reasoning 跑简单任务浪费算力。
Q9:Windows 下能否跑? - 说明:官方以 Linux 为主;Windows 用户建议 WSL2 或远程 Linux 服务器,不要在原生 Windows 硬跑多卡服务。
Q10:想接到 Dify / NextChat / 自建 IDE 插件
- 做法:用 vLLM 起 OpenAI 兼容服务(vllm serve ByteDance-Seed/Seed-Coder-8B-Instruct),把应用 API Base URL 指向 http://<服务器IP>:8000/v1,模型名填 ByteDance-Seed/Seed-Coder-8B-Instruct 即可。
Q11:权重下载到一半磁盘满了
- 解决:先 df -h 确认目标盘剩余(单模型约 16GB);下载支持断点续传,补磁盘后重跑同一命令即可;用 --local-dir 直接下到大盘。
Q12:如何确认自己跑的是不是官方最新权重?
- 做法:在 HuggingFace 模型卡页看文件提交记录;或 huggingface-cli download 时观察输出的 commit hash,与模型卡主页最新 commit 比对。
六、部署注意事项与最佳实践
- 模型选择务实:8B 虽小,但 Instruct/Reasoning/Base 定位不同,日常补全用 Instruct,不要拿 Base 直接对话,也不要拿 Reasoning 跑简单任务。
- 显存账要算清:bf16 8B 约 16GB 权重,长上下文(尤其 64K Reasoning)KV Cache 额外吃显存,生产前用真实上下文长度压测。
- 必须加 trust_remote_code:transformers 加载时 tokenizer 与 model 两处都要传,否则报错。
- 解码参数用官方推荐:
temperature=0.6, top_p=0.8, repetition_penalty=1.05,别套通用聊天模型的默认值。 - 生产走 vLLM:离线实验用 transformers,上线服务务必用 vLLM(官方明确支持 + 张量并行),吞吐与显存效率远高于裸 transformers。
- 版本配套:
transformers/accelerate/vllm都升到最新;模型带 remote code,版本不对容易出奇怪报错。 - MIT 协议可商用:权重 MIT 许可,允许商用,但需保留版权与许可声明;对外服务时遵守许可证条款。
- 数据合规:微调语料注意版权与合规要求;对外提供代码生成服务时保留使用记录。
- 磁盘预留:单模型约 16GB,多模型共存(Base/Instruct/Reasoning)预留 60GB 以上。
- 关注版本节奏:仓库与 HuggingFace 集合页会更新模型与说明,升级前看 News 栏(如 2025/05/14 曾修正 BigCodeBench 口径)。
七、参考资料
- GitHub 仓库:https://github.com/ByteDance-Seed/Seed-Coder
- 项目主页:https://bytedance-seed-coder.github.io/
- HuggingFace 模型集合:https://huggingface.co/collections/ByteDance-Seed/seed-coder-680de32c15ead6555c75b0e4
- Seed-Coder-8B-Instruct 模型卡:https://huggingface.co/ByteDance-Seed/Seed-Coder-8B-Instruct
- Seed-Coder-8B-Base 模型卡:https://huggingface.co/ByteDance-Seed/Seed-Coder-8B-Base
- Seed-Coder-8B-Reasoning 模型卡:https://huggingface.co/ByteDance-Seed/Seed-Coder-8B-Reasoning
- 技术报告(arXiv):https://arxiv.org/abs/2506.03524
- vLLM 官方文档:https://docs.vllm.ai/
- 字节 Seed 团队:https://seed.bytedance.com/