
Seed Diffusion Preview:超详细部署与使用教程
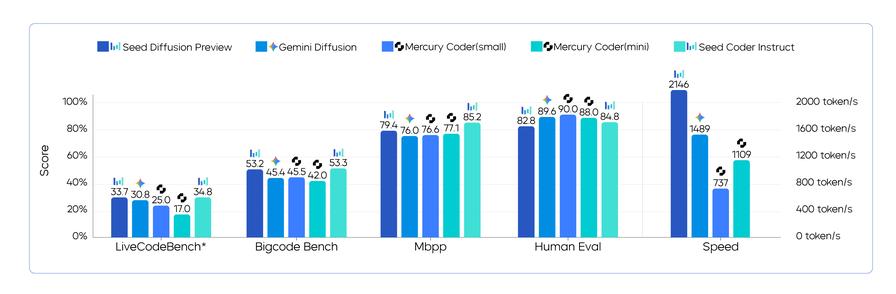
Seed Diffusion Preview 是字节跳动 Seed 团队于 2025 年 7 月 31 日发布的实验性扩散语言模型:以结构化的代码生成为实验领域,系统性验证「离散扩散」作为下一代语言模型基础框架的可行性。官方公布其代码推理速度可达 2146 tokens/s,相比同等规模自回归模型提升 5.4 倍,同时在 LiveCodeBench、BigCode Bench、MBPP、HumanEval 等多个代码基准上与同规模自回归模型相当,并在代码编辑任务(CanItEdit)上反超自回归模型。技术报告(arXiv:2508.02193)已公开,在线 Demo 开放体验,截至目前未开放代码仓库与模型权重下载。

| 所属公司 | GitHub 仓库 | 官方文档/官网 | 开源协议 | Star 数 | 最新版本(截至 2026-10-27) | 主要语言 |
|---|---|---|---|---|---|---|
| 字节跳动(Seed 团队) | 以官方 API/模型权重发布(未公开代码与权重,无 GitHub 仓库) | 项目主页:seed.bytedance.com/seed_diffusion ;官方博客:2146 Tokens/s 扩散语言模型发布 ;在线 Demo:studio.seed.ai/exp/seed_diffusion ;技术报告:arXiv:2508.02193 | 未公开(技术报告公开,模型在线 Demo 体验) | 无公开仓库,不适用 | Seed Diffusion Preview(2025-07-31 发布) | 不适用(未开放部署) |
目录
一、项目概述
1.1 项目定位
自回归(AR)语言模型受串行解码的延迟制约;离散扩散模型则天然支持并行解码,但长期存在「理论收益与实际加速脱节」的问题。Seed Diffusion Preview 的定位不是又一个代码模型,而是一次技术路线验证:
- 实验领域:结构化代码生成(结构清晰、因果依赖强、便于评测);
- 核心命题:离散扩散能否成为下一代语言模型的基础框架;
- 成果:2146 tokens/s 推理速度(约为同规模 AR 的 5.4 倍),且质量不掉队——在「速度-质量」帕累托前沿上确立新基准。
1.2 核心功能(官方公布数据)
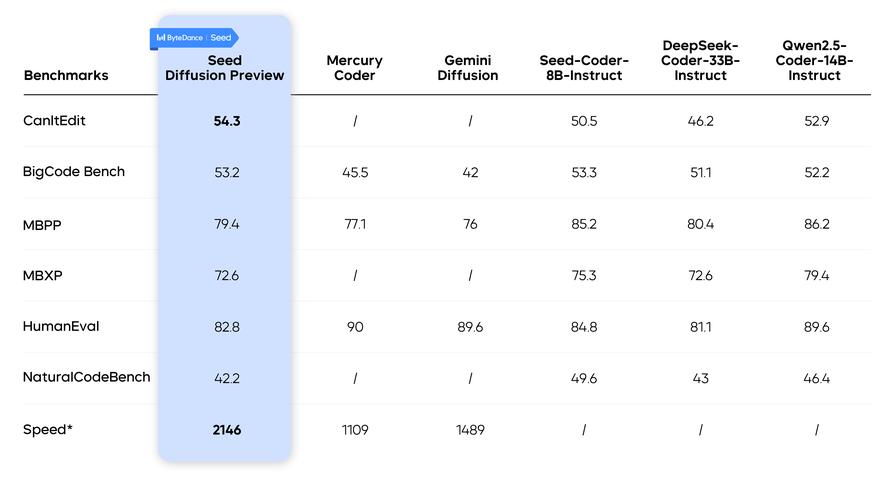
官方主基准成绩(与 Gemini Diffusion、Mercury Coder/CoderT、Seed-Coder-8B-Instruct、DeepSeek-Coder-33B-Instruct、Qwen2.5-Coder-14B-Instruct 对照):
| 基准 | Seed Diffusion Preview | Mercury Coder | Gemini Diffusion | Seed-Coder-8B-Instruct | 说明 |
|---|---|---|---|---|---|
| CanItEdit(代码编辑) | 54.3 | / | / | 50.5 | 全局规划类编辑任务,扩散路线占优 |
| BigCode Bench | 53.2 | 45.5 | 42 | 53.3 | 通用代码生成 |
| MBPP | 79.4 | 77.1 | 76 | 85.2 | 基础编程题 |
| MBXP | 72.6 | / | / | 75.3 | 多语言扩展 |
| HumanEval | 82.8 | 90 | 89.6 | 84.8 | 经典手写题 |
| NaturalCodeBench | 42.2 | / | / | 49.6 | 真实自然代码场景 |
| 推理速度 (tokens/s) | 2146 | 1109 | 1489 | / | 约为同规模 AR 的 5.4 倍 |
官方实验结论要点:
- 并行解码潜力充分释放,速度为同规模自回归模型的 5.4 倍;
- 高速不以质量为代价:多个业界基准与领先 AR 模型相当,代码编辑类任务反超;
- CanItEdit 上 pass@1 比 AR 模型高 4.8 个百分点(54.3 vs. 50.5),代码逻辑理解与修复能力显著增强。
1.3 技术架构(四大关键技术)
① 两阶段课程学习:从模式填充到逻辑编辑
| 阶段 | 做法 | 作用 |
|---|---|---|
| 阶段一:掩码扩散训练 | 动态噪声调度把部分代码 token 替换为 [MASK],做掩码填充 |
学会局部上下文与代码模式补全 |
| 阶段二:编辑扩散训练 | 基于编辑距离约束的插入/删除操作构造噪声 | 强制模型重审所有 token,打破「未掩码 token 一定正确」的伪相关依赖 |
② 约束顺序扩散(Constrained-Order Diffusion):纯随机顺序生成忽略了代码「变量先声明后使用」的因果先验;后训练阶段基于模型感知合成并筛选偏好生成轨迹,蒸馏让扩散模型学会正确的依赖顺序。
③ 同策略学习高效并行解码(On-policy Learning):目标是在保证质量的同时最小化生成步数 |τ|,并用验证器模型 V 把关;直接最小化步数会训练不稳定,因此采用基于轨迹不同步骤间编辑距离的代理损失函数。官方曲线显示随训练推进加速比从 +202% 一路提升到 +423%。
④ 从理论加速到工程实现:块级(block-wise)并行扩散采样,块间保持因果顺序;不做块专属训练以保留推理时任意分块灵活性;KV-caching 复用已生成块信息;配套内部扩散采样基础设施做整体系统优化。
下图是官方完整基准成绩表(含速度):
二、环境要求
Seed Diffusion Preview 目前未开放私有化部署,使用方式为官方在线 Demo;对应要求如下:
| 项目 | 要求 |
|---|---|
| 使用方式 | 官方在线 Demo:https://studio.seed.ai/exp/seed_diffusion/ |
| 设备 | 任意可联网电脑浏览器 |
| 账号 | 按 Demo 页面提示登录(字节账号体系) |
| 输入 | 自然语言代码需求描述(代码生成/代码编辑场景) |
| 本地 GPU | 不需要——所有推理在字节云端完成 |
| 研究者 | 可下载技术报告 arXiv:2508.02193 复现方法研究 |
说明:截至 2026-10-27,HuggingFace
ByteDance-Seed组织下未见 Seed Diffusion Preview 权重仓库(组织内仅有 Seed-Coder-8B 系列等早期代码模型);模型是否开放权重、以何种形式开放,以项目主页与官方博客后续公告为准。
三、部署方式
由于模型未开源代码与权重,本节给出官方在线 Demo 的完整接入与使用流程,以及面向研究者的论文复现路径。
3.1 方式一:官方在线 Demo(零部署即用)
1) 打开 https://studio.seed.ai/exp/seed_diffusion/ ;
2) 按页面提示完成登录;
3) 在对话框输入代码需求(例如:写一个 Python 快速排序函数 / 修复这段代码里的 bug);
4) 提交后观察生成过程:扩散模型并行解码,1 秒可生成超百行代码;
5) 复制结果到本地工程验证。
官方 Demo 定位即「体验 2146 tokens/s 的扩散式代码生成」,适合第一时间感受非自回归生成的节奏。
3.2 方式二:技术报告研读(面向研究者)
# 下载技术报告 PDF
curl -L -o seed_diffusion_preview.pdf "https://arxiv.org/pdf/2508.02193"
报告中可复现的研究要点:
- 两阶段扩散训练的数据构造(掩码噪声调度、编辑距离约束的插入/删除);
- 约束顺序轨迹的合成与蒸馏流程;
- 同策略学习的代理损失函数与验证器设计;
- 块级并行采样方案、KV-caching 与不同块大小的推理时延分析。
3.3 方式三:关注并等待后续开放
- 项目主页:https://seed.bytedance.com/seed_diffusion
- 官方博客列表:https://seed.bytedance.com/zh/blog_list/foundation
- HuggingFace 组织:https://huggingface.co/ByteDance-Seed
- 官方明确表示 Seed Diffusion 项目将继续探索 scaling 规律与复杂推理场景应用
一旦权重/代码开放,第一落点会在上述渠道;在那之前,任何「Seed Diffusion 开源权重」均非官方。
3.4 验证「接入成功」
- Demo 页面可正常登录并发起代码生成请求;
- 返回的代码在本地语言环境(Python 等)可运行;
- 主观感受生成速度:官方公布 2146 tokens/s,约为同规模 AR 模型 5.4 倍。
四、使用方法
4.1 基础用法:代码生成
在 Demo 中直接用自然语言描述需求:
写一个 Python 函数:输入整数列表,返回其中所有偶数的平方和。
预期:模型快速生成结构清晰的 Python 代码,可直接复制运行。
4.2 进阶用法:代码编辑(扩散路线的强项)
CanItEdit 类任务需要全局规划——把旧代码片段与编辑要求一起给出:
旧代码:
def fib(n):
    if n <= 1: return n
    return fib(n-1) + fib(n-2)

要求:把它改造成带缓存(memoization)的高效版本,并加上类型标注。
官方数据显示:正是在这类需要通览全局再修改的任务上,扩散模型的并行全局视野优势最大(CanItEdit 54.3,反超 AR 模型)。
4.3 常用 Prompt 要点
| 技巧 | 说明 |
|---|---|
| 说清语言与运行环境 | 如「Python 3.10」「CUDA 环境下的 C++」 |
| 代码编辑任务给出完整旧代码 | 扩散模型依赖全局上下文做并行重写 |
| 明确验收标准 | 输入输出示例、边界条件写进 Prompt |
| 一次一个函数 | 复杂工程拆分多次生成 |
4.4 适用场景
- 体验下一代语言模型范式(非自回归扩散生成);
- 快速生成/修复结构化代码,感受 2000+ tokens/s 的生成节奏;
- 研究者跟踪离散扩散路线,复现论文中的训练与采样方案;
- 为下一代代码助手选型做技术储备(速度-质量帕累托前沿参考)。
五、常见问题排查(FAQ)
Q1:Seed Diffusion Preview 可以本地部署吗?
- 截至 2026-10-27,未开放代码与权重,HuggingFace ByteDance-Seed 组织下无对应仓库。只能通过官方在线 Demo 体验;不要使用第三方所谓「开源权重」。
Q2:它和 Seed-Coder-8B 是什么关系? - 同属 Seed 团队代码模型家族,但技术路线不同:Seed-Coder-8B 是常规自回归代码模型(已在 HF 开放权重);Seed Diffusion Preview 是实验性离散扩散模型,目标是验证新范式。二者不要混淆。
Q3:2146 tokens/s 是什么水平? - 官方口径下约为同规模自回归模型的 5.4 倍(对比 Mercury Coder 1109、Gemini Diffusion 1489);官方同时提示:不同评测条件(数据集、硬件、格式约束 Prompt)存在差异,横向比较需谨慎。
Q4:为什么叫 Preview? - 官方定位是「实验性预览版」:路线验证性质,能力与规模仍在迭代,后续会继续探索 scaling 规律与复杂推理场景。
Q5:模型支持中文吗? - 官方博客与项目页均以中英双语发布;Demo 面向代码场景,自然语言指令中英均可,代码产物为多语言代码。
Q6:想复现论文,需要什么? - 先读 arXiv:2508.02193 全文;论文给出训练方案、损失函数与系统优化细节,但未提供训练代码与权重,复现需自行实现并准备算力。
Q7:在线 Demo 生成的代码能直接用于生产吗? - 建议作为参考实现,上线前按生产规范做评审、测试与安全审计;模型处于 Preview 阶段,质量以官方基准数据为准。
六、部署注意事项与最佳实践
- 只走官方渠道:项目页、官方博客、官方 Demo 是唯三入口;警惕仿冒「开源版」。
- 把它当「范式预览」而非「生产模型」:实验性定位决定了它当前更适合体验与研究跟踪。
- 代码编辑任务喂完整上下文:扩散模型的全局并行优势在「看全旧代码再改」时最大,Prompt 里不要只贴片段。
- 引用数据要注明口径:2146 tokens/s、5.4 倍加速均为官方实验条件下结果,对外引用时保留条件说明。
- 关注开源节点:官方已表态将持续推进该项目,权重/代码若开放,第一落点在 HuggingFace
ByteDance-Seed与项目主页。 - 论文复现合规:复现研究请引用 arXiv:2508.02193;训练数据与自研实现注意合规。
- 与 Seed-Coder 互补看待:现阶段要可用的开源代码模型,Seed-Coder-8B 系列(HF 有权重)是更务实的选择;Seed Diffusion Preview 代表未来路线。
七、参考资料
- 官方项目主页:https://seed.bytedance.com/seed_diffusion
- 官方博客(英文,完整版):https://seed.bytedance.com/en/blog/seed-research-seed-diffusion-preview-released-a-diffusion-language-model-delivering-breakthrough-2-146-tokens-s-inference-speed
- 官方博客(中文列表):https://seed.bytedance.com/zh/blog_list/foundation
- 在线 Demo:https://studio.seed.ai/exp/seed_diffusion/
- 技术报告:https://arxiv.org/pdf/2508.02193
- HuggingFace 官方组织(核查权重是否开放):https://huggingface.co/ByteDance-Seed
- Seed 模型家族总览:https://seed.bytedance.com/zh/seed_model_portfolio