
Stable-DiffCoder:超详细部署与使用教程
Stable-DiffCoder 是字节跳动 Seed 团队开源的扩散式代码大模型(Code Diffusion LLM / Mask Diffusion LLM),基于 Seed-Coder 的架构、数据与训练管线,新增了一个「块扩散持续预训练(Block Diffusion CPT)」阶段,配合定制 warmup 与块级裁剪噪声调度。它把扩散模型(diffusion LLM)用到代码生成上:在与自回归(AR)对照模型完全相同的架构与数据下,仅用 CPT + SFT 两个阶段,就在 HumanEval、MBPP、BigCodeBench 等主流代码 benchmark 上超过了自家 AR 基线 Seed-Coder-8B-Instruct 以及众多 ~8B 级 AR / 扩散代码模型。权重以 MIT 协议开源,基于 HuggingFace
transformersv5.3.0 推理。
| 所属公司 | GitHub 仓库 | 官方文档/官网 | 开源协议 | Star 数 | 最新版本(截至 2026-10-27) | 主要语言 |
|---|---|---|---|---|---|---|
| 字节跳动(Seed 团队) | github.com/ByteDance-Seed/Stable-DiffCoder | 项目主页:bytedance-seed.github.io/Stable-DiffCoder ;模型集合:HuggingFace ByteDance-Seed/stable-diffcoder ;技术报告:arXiv:2601.15892 | MIT | 约 86 | Stable-DiffCoder-8B 系列(2026-01-22 发布;2026-03-09 适配 transformers v5.3.0) | Python |
目录
一、项目概述
1.1 项目定位
Stable-DiffCoder 是字节 Seed 团队在「扩散大语言模型(Diffusion LLM)」方向上的代码模型尝试。它的定位要点:
- 同一架构、同一数据:直接复用 Seed-Coder 的模型架构、数据与训练管线,只把训练范式从自回归换成扩散,从而公平地回答「扩散训练到底能不能提升代码建模质量」;
- 块扩散 CPT:新增一个块扩散持续预训练阶段,带定制 warmup 策略与块级裁剪噪声调度(block-wise clipped noise schedule),让扩散训练稳定且能抬高性能上限;
- 轻量训练阶段:仅用 CPT + SFT(不做 RL)就超过众多 ~8B AR 与扩散代码模型;
- 权重开源:Base 与 Instruct 两个权重托管在 HuggingFace,基于
transformersv5.3.0 直接推理。
官方想证明的事:在严格控制数据与架构的前提下,扩散训练能把代码建模质量推到 AR 训练 alone 达不到的高度;同时 any-order(任意顺序)建模改善了结构化代码的编辑与推理,扩散式噪声损坏还帮助低资源编程语言学习。
1.2 核心功能(Stable-DiffCoder-8B 模型家族,以官方 README 为准)
Stable-DiffCoder 共 2 个模型变体,均为 8B 规模、上下文 8K:
| 模型名 | 上下文长度 | 下载 | 说明 |
|---|---|---|---|
| Stable-DiffCoder-8B-Base | 8K | HuggingFace | 在模型中心化代码数据上预训练的扩散基座模型 |
| Stable-DiffCoder-8B-Instruct | 8K | HuggingFace | 指令微调,对齐用户意图(对话/生成首选) |
模型类型标注为 Mask Diffusion Language Models(掩码扩散大模型),训练阶段为 Pretraining & Post-training,数据来源为公开数据集 + 合成数据。
其他要点:
- Fair & controlled comparison:与 AR 基线完全相同的架构、数据、训练管线,单独隔离「扩散训练」这一变量。
- Block diffusion CPT:定制 warmup + 块级裁剪噪声调度,让扩散训练稳定收敛。
- Actionable training insights:官方系统分析训练动力学,给出可复用的扩散模型训练经验。
- Minimal stages:仅 CPT + SFT 即达到有竞争力的 ~8B 指令模型水平。
- 版本适配:2026/03/09 更新以适配
transformersv4.46.2 → v5.3.0;旧权重 commit 仍可在 HF 页面历史分支找到。
1.3 技术架构
下图是官方发布的 Stable-DiffCoder 性能总览图(在多种代码 benchmark 上与 ~8B AR 模型及扩散代码模型的对比):
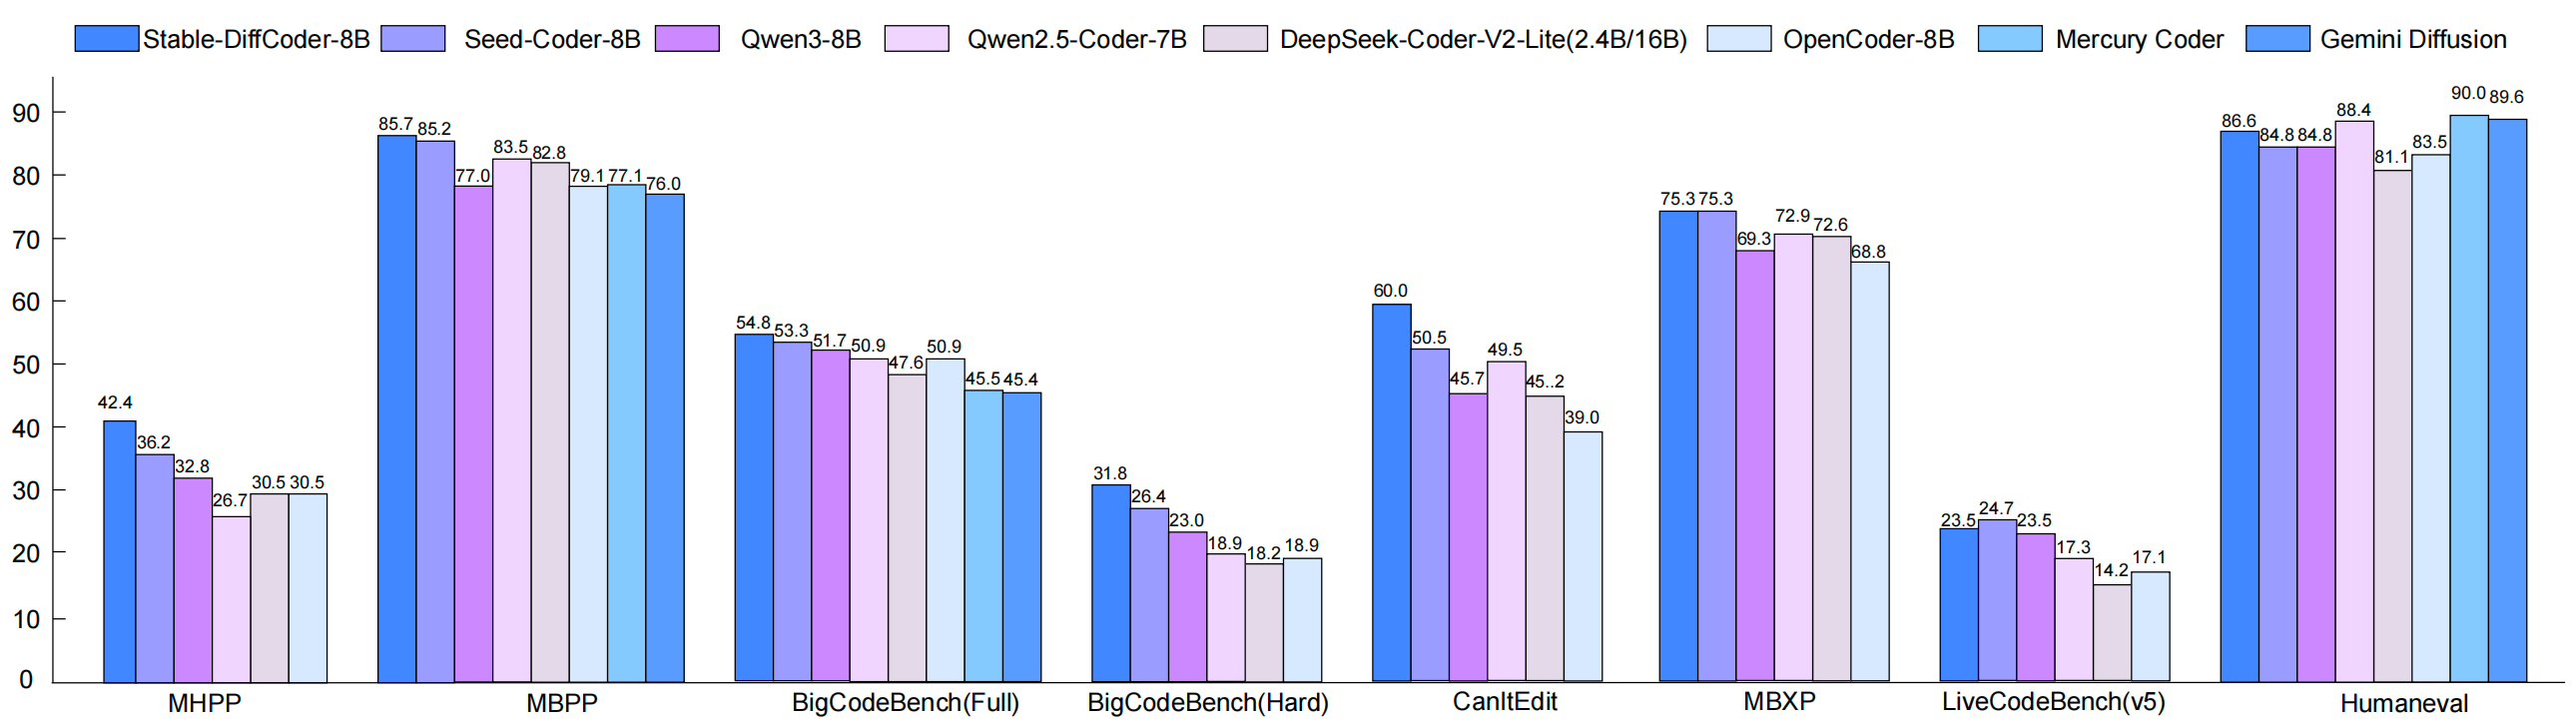
在 HuggingFace 模型卡上,官方给出了 Stable-DiffCoder-8B-Instruct 的具体得分。
与 ~8B AR 模型对比:
| 模型 | HumanEval | MBPP | MHPP | BigCodeBench(Full) | BigCodeBench(Hard) | LiveCodeBench(v5) |
|---|---|---|---|---|---|---|
| DeepSeek-Coder-6.7B-Instruct | 74.4 | 74.9 | 20.0 | 43.8 | 15.5 | 9.6 |
| Qwen2.5-Coder-7B-Instruct | 88.4 | 83.5 | 26.7 | 48.8 | 20.3 | 17.3 |
| Qwen3-8B | 84.8 | 77.0 | 32.8 | 51.7 | 23.0 | 23.5 |
| Seed-Coder-8B-Instruct(AR 基线) | 84.8 | 85.2 | 36.2 | 53.3 | 26.4 | 24.7 |
| Stable-DiffCoder-8B-Instruct | 86.6 | 85.7 | 42.4 | 54.8 | 31.8 | 23.5 |
与 ~8B 扩散代码模型(DLLM)对比:
| 模型 | HumanEval | HumanEval+ | MBPP | MBPP+ | BigCodeBench(Full) |
|---|---|---|---|---|---|
| LLaDA-8B-Instruct | 49.4 | - | 41.0 | - | 16.5 |
| DiffuCoder-7B-Instruct | 72.0 | 65.2 | 75.1 | 61.9 | 35.7 |
| Dream-Coder-7B-Instruct | 82.9 | - | 79.6 | - | 37.1 |
| Fast-dLLMv2 | 43.9 | 40.2 | 50.0 | 41.3 | 49.0 |
| Stable-DiffCoder-8B-Instruct | 86.6 | 82.3 | 85.7 | 72.8 | 54.8 |
详细分析以技术报告(仓库内
Stable_DiffCoder.pdf)为准。
二、环境要求
| 项目 | 要求 |
|---|---|
| 操作系统 | Linux(官方推理主力,Ubuntu 20.04/22.04 等);Windows 建议 WSL2 |
| Python | 3.9–3.12 区间 |
| 框架底座 | transformers ~=5.3.0(官方明确要求,v5.3.0 起支持);旧版 v4.46.2 仅对应历史 commit 权重 |
| GPU | 8B 模型 bf16 推理约需 16GB 显存(如 RTX 4090 / A10 单卡起步);扩散生成需多步迭代,显存与算力按 steps 增加 |
| 磁盘 | 单个 8B bf16 权重约 16GB,预留 30GB 以上 |
| 网络 | 需能访问 HuggingFace 下载权重;国内可用 hf-mirror.com 镜像 |
| 其他工具 | huggingface-cli;扩散生成依赖 trust_remote_code=True 加载仓库自带 modeling 代码 |
重要:Stable-DiffCoder 是 Mask Diffusion LLM,推理方式与自回归模型完全不同——不是逐 token 左到右生成,而是把输出位置先全部掩码,再在多步迭代中逐步「去掩码」填充。部署时必须理解
steps / gen_length / block_length / remasking这些扩散专属参数(见 4.2)。
三、部署方式
下面给出:① 安装依赖与下载权重 → ② transformers 推理(官方示例)。
3.1 第一步:安装依赖与下载权重
# 1) 创建虚拟环境(可选但推荐)
python -m venv venv
source venv/bin/activate

# 2) 安装官方指定版本的 transformers(关键!必须 ~=5.3.0)
pip install transformers~=5.3.0

# 3) 安装 HuggingFace 命令行
pip install -U huggingface_hub

# 4) 下载模型权重(以 Instruct 为例,首次约 16GB)
huggingface-cli download ByteDance-Seed/Stable-DiffCoder-8B-Instruct --local-dir ./Stable-DiffCoder-8B-Instruct
国内镜像:
export HF_ENDPOINT=https://hf-mirror.com
huggingface-cli download ByteDance-Seed/Stable-DiffCoder-8B-Instruct --local-dir ./Stable-DiffCoder-8B-Instruct
旧版说明:官方 README 中保留了
transformers==4.46.2的历史权重 commit(Instruct 与 Base 各有一个历史 tree 链接);新部署一律用 v5.3.0 权重,不要混用旧 transformers 与新权重。
3.2 方式:用 transformers 部署(官方示例)
官方 README / 模型卡给出的最小可运行推理脚本:
# pip install transformers==5.3.0
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

device = 'cuda'
model = AutoModelForCausalLM.from_pretrained(
    'ByteDance-Seed/Stable-DiffCoder-8B-Instruct',
    trust_remote_code=True,
    torch_dtype=torch.bfloat16,
).to(device).eval()
tokenizer = AutoTokenizer.from_pretrained(
    'ByteDance-Seed/Stable-DiffCoder-8B-Instruct',
    trust_remote_code=True,
)

prompt = 'Write a quick sort algorithm.'
m = [{"role": "user", "content": prompt}]
prompt = tokenizer.apply_chat_template(m, add_generation_prompt=True, tokenize=False)
input_ids = tokenizer(prompt)['input_ids']
input_ids = torch.tensor(input_ids).to(device).unsqueeze(0)

out = model.generate(
    input_ids,
    steps=512,
    gen_length=512,
    block_length=4,
    temperature=0.,
    remasking='low_confidence',
    tokenizer=tokenizer,
    shift=False,
    threshold=None,
    eos_id=tokenizer.eos_token_id,
)
print(tokenizer.decode(out[0][input_ids.shape[1]:], skip_special_tokens=True))
说明:
model_id既可以填 HuggingFace 仓库名(自动下载),也可以填 3.1 下载好的本地路径;trust_remote_code=True必须加,扩散模型的 generate 逻辑在仓库自带代码里;- 注意
model.generate(...)的参数与自回归模型完全不同(steps / gen_length / block_length / remasking等),不要套 GPT/Qwen 那套max_new_tokens用法。
3.3 验证部署成功
# 1) 权重已就位
ls ./Stable-DiffCoder-8B-Instruct/
# 预期看到 config.json、tokenizer 文件、model-*.safetensors、自带 modeling_*.py 等

# 2) transformers 版本正确
python -c "import transformers; print(transformers.__version__)"
# 预期 5.3.x

# 3) 跑一次官方最小脚本(见 3.2),能打印出快排代码即整条链路通
四、使用方法
4.1 基础用法:对话式代码生成
沿用 3.2 脚本,把 prompt 换成你的需求:
prompt = '用 Python 实现一个带超时与重试的异步 HTTP 请求函数'
m = [{"role": "user", "content": prompt}]
prompt = tokenizer.apply_chat_template(m, add_generation_prompt=True, tokenize=False)
input_ids = tokenizer(prompt)['input_ids']
input_ids = torch.tensor(input_ids).to(device).unsqueeze(0)

out = model.generate(
    input_ids, steps=512, gen_length=512, block_length=4,
    temperature=0., remasking='low_confidence',
    tokenizer=tokenizer, shift=False, threshold=None,
    eos_id=tokenizer.eos_token_id,
)
print(tokenizer.decode(out[0][input_ids.shape[1]:], skip_special_tokens=True))
要点:
- 必须用
tokenizer.apply_chat_template(m, add_generation_prompt=True, tokenize=False)套对话模板; - 注意这里先
tokenizer(...)得到 input_ids 再包成 tensor,与自回归示例略不同,按官方脚本照抄即可; gen_length决定最大生成长度,长代码函数调大(如 1024)。
4.2 扩散推理参数详解(官方模型卡原文)
这是 Stable-DiffCoder 最关键的部分,每个参数都要理解:
| 参数 | 官方默认/示例 | 说明 |
|---|---|---|
steps |
512(示例) | 扩散生成的迭代步数,步数越多越精细但越慢 |
gen_length |
512(示例) | 生成输出的最大长度 |
block_length |
4 | 扩散块长度,默认 4 |
temperature |
0.0 | 生成温度,默认 0.0(确定性输出) |
remasking |
'low_confidence' |
重新掩码策略,可选 'low_confidence' 或 'random',默认 'low_confidence'(原理参考 LLADA) |
tokenizer |
必传 | 用于文本编解码的 tokenizer 对象 |
shift |
False | 是否把输出右移一位(类似 AR),默认 False |
threshold |
None | 解码阈值(范围 0–1.0),默认 None;值越小解码越快(原理参考 Fast-dLLM) |
eos_id |
tokenizer.eos_token_id |
序列结束 token 的 id |
调参建议:
- 想要更快出图(出代码):把
threshold设成较小值(如 0.1–0.5,参考 Fast-dLLM 思路),可显著减少迭代; - 想要更高质量:保持
steps=512、remasking='low_confidence'、temperature=0.; block_length一般保持默认 4,这是块扩散的核心粒度。
4.3 进阶功能
- 加速推理:利用
threshold参数(Fast-dLLM 思路)减少扩散步数,在质量损失可控前提下提速; - 低资源编程语言:官方称扩散式噪声损坏有助于低资源编程语言学习,对冷门语言生成可尝试;
- 结构化代码编辑:any-order 建模对结构化代码(如 JSON、AST、嵌套函数)的编辑与推理更友好;
- 二次微调:Base 模型可作为扩散代码模型的基座,按官方 CPT+SFT 配方做领域适配;
- 公平对照实验:与 Seed-Coder-8B-Instruct 同架构同数据,适合做「AR vs 扩散」的代码建模研究。
4.4 适用场景
- 研究扩散大语言模型(Diffusion LLM)在代码生成上的可行性;
- 私有化部署的代码生成模型(MIT 可商用,8B 单卡可跑);
- 结构化代码编辑、低资源编程语言生成;
- 学习稳定的扩散训练配方(官方公开 block diffusion CPT 方法);
- 与 AR 基线对照的教学/研究实验。
五、常见问题排查(FAQ)
Q1:transformers 版本不对,加载报错
- 原因:Stable-DiffCoder 要求 transformers~=5.3.0,旧版(如 4.46.2)只对应历史 commit 权重。
- 解决:pip install transformers==5.3.0;不要混用旧 transformers 与新权重。
Q2:忘记加 trust_remote_code=True
- 说明:会直接报错。扩散模型的 generate 逻辑在仓库自带 modeling 代码里,tokenizer 与 model 两处都要传 trust_remote_code=True。
Q3:照抄自回归模型的 max_new_tokens 用法
- 原因:扩散模型 generate 签名完全不同。
- 解决:用官方参数 steps / gen_length / block_length / remasking 等,不要传 max_new_tokens;生成长度由 gen_length 控制。
Q4:生成特别慢
- 原因:扩散模型要多步迭代(示例 steps=512),比自回归慢。
- 解决:① 用 threshold 参数(Fast-dLLM 思路)减少步数;② 调小 gen_length;③ 确认 GPU 是 CUDA bf16 可用设备。
Q5:加载 8B 模型报 CUDA out of memory
- 解决:bf16 权重约 16GB,确认显存 ≥16GB;扩散生成的中间状态也占显存,必要时减小 gen_length / steps;多卡可分片(具体以仓库支持为准)。
Q6:huggingface-cli download 卡住
- 解决:export HF_ENDPOINT=https://hf-mirror.com 走镜像;配合 hf_transfer 加速。
Q7:输出是空的 / 全是特殊符号
- 原因:对话模板或 input_ids 处理不对。
- 解决:严格按官方脚本——先 apply_chat_template(..., tokenize=False) 得到字符串,再 tokenizer(prompt)['input_ids'] 包 tensor;不要跳过 apply_chat_template。
Q8:想用 vLLM / 起 OpenAI 服务 - 说明:官方 README 只给出 transformers 推理示例,未提供 vLLM 服务模板;扩散 LLM 的在线服务生态尚在早期,以 HuggingFace 模型卡与仓库 Issue 为准,不要臆造 vLLM 命令。
Q9:Windows 下能否跑? - 说明:官方以 Linux 为主;Windows 用户建议 WSL2 或远程 Linux 服务器。
Q10:想跑旧版(transformers==4.46.2)权重 - 说明:官方在 README 中保留了历史 commit 链接(Instruct 与 Base 各一个 tree),按需在 HF 页面切到对应 commit 下载;但新部署推荐 v5.3.0。
Q11:权重下载到一半磁盘满了
- 解决:单模型约 16GB,先 df -h 确认;断点续传,补磁盘后重跑同一命令;用 --local-dir 下到大盘。
Q12:与 Seed-Coder 是什么关系? - 说明:Stable-DiffCoder 直接复用 Seed-Coder 的架构、数据与训练管线,只把范式换成扩散;可以把它理解为 Seed-Coder 的「扩散训练版对照实验」,两者同 8B、同数据源。
六、部署注意事项与最佳实践
- transformers 版本是硬约束:必须
~=5.3.0,这是本项目最容易踩的坑,装错版本直接加载失败。 - 理解扩散范式:它不是逐 token 左到右生成,而是多步去掩码;部署前先读 4.2 参数表,别用 AR 模型思维调参。
- trust_remote_code 必加:model 与 tokenizer 两处都要。
- 速度与质量权衡:
threshold(Fast-dLLM 思路)是官方给出的加速旋钮,生产可先质量优先、再逐步提速。 - 对话模板照抄:
apply_chat_template(tokenize=False)+tokenizer(...)['input_ids']这套顺序不要改。 - 显存账:8B bf16 约 16GB,扩散中间状态额外占显存,长生成前先压测。
- MIT 协议可商用:权重 MIT 许可,允许商用,但保留版权与许可声明。
- 数据合规:微调语料注意版权;对外服务保留使用记录。
- 磁盘预留:单模型约 16GB,Base + Instruct 共存预留 40GB 以上。
- 关注版本节奏:仓库 2026/03/09 刚适配 transformers v5.3.0,扩散 LLM 生态迭代快,升级前看 News 与 Issue。
七、参考资料
- GitHub 仓库:https://github.com/ByteDance-Seed/Stable-DiffCoder
- 项目主页:https://bytedance-seed.github.io/Stable-DiffCoder/
- HuggingFace 模型集合:https://huggingface.co/collections/ByteDance-Seed/stable-diffcoder
- Stable-DiffCoder-8B-Instruct 模型卡:https://huggingface.co/ByteDance-Seed/Stable-DiffCoder-8B-Instruct
- Stable-DiffCoder-8B-Base 模型卡:https://huggingface.co/ByteDance-Seed/Stable-DiffCoder-8B-Base
- 技术报告(arXiv):https://arxiv.org/abs/2601.15892
- LLaDA(remasking 原理参考):https://github.com/ML-GSAI/LLaDA
- Fast-dLLM(threshold 加速原理参考):https://github.com/NVlabs/Fast-dLLM
- 字节 Seed 团队:https://seed.bytedance.com/