
Hyper-SD:超详细部署与使用教程
Hyper-SD 是字节跳动开源的扩散模型加速技术(State-of-the-Art diffusion acceleration),把 FLUX.1-dev、SD3-Medium、SDXL Base 1.0、Stable-Diffusion v1.5 等主流文生图模型通过蒸馏压缩成少步生成 LoRA:最快 1 步即可出图,常见的 2/4/8/12/16 步 LoRA 可把原本 20–50 步的出图流程压缩到个位数,而画质保持接近 SOTA。官方以 LoRA 权重 + 1-step UNet 权重形式发布在 HuggingFace,配合
diffusers直接加载使用,无需改动基座模型。
| 所属公司 | GitHub 仓库 | 官方文档/官网 | 开源协议 | Star 数 | 最新版本(截至 2026-10-27) | 主要语言 |
|---|---|---|---|---|---|---|
| 字节跳动(ByteDance) | 无单一官方代码仓库(以官方权重 / 模型卡形式发布) | 项目页:hyper-sd.github.io ;权重模型卡:HuggingFace ByteDance/Hyper-SD ;技术报告:arXiv:2404.13686 | 以 HuggingFace 模型卡与各基座模型许可为准(LoRA 权重随基座模型发布) | HF 点赞 1365 / 下载 7.3 万(HF 数据,非 GitHub Star) | Hyper-SD 系列 LoRA(2024-04 首发;2024-08 追加 FLUX.1-dev 8/16 步 LoRA) | Python(diffusers 推理示例) |
目录
一、项目概述
1.1 项目定位
Hyper-SD 解决的是「扩散模型出图太慢」的问题。普通 Stable Diffusion 一张图要跑 20–50 步去噪,Hyper-SD 把蒸馏好的少步 LoRA 挂到基座模型上,几步甚至 1 步就能出图:
- 多基座覆盖:官方蒸馏了四个基座——FLUX.1-dev、SD3-Medium、SDXL Base 1.0、Stable-Diffusion v1.5;
- 多档位步数:每个基座提供 1 / 2 / 4 / 8 / 12 / 16 步等不同 LoRA,用户按速度与画质取舍;
- 即插即用:LoRA 权重用
diffusers的load_lora_weights+fuse_lora直接挂载,不改基座权重; - ControlNet 兼容:官方提供 SDXL / SD1.5 下接 Canny ControlNet 的示例,少步加速不影响可控生成。
说明:Hyper-SD 官方没有提供独立的 GitHub 代码仓库,权重与说明都托管在 HuggingFace 模型卡 + 项目页。下文所有命令均来自官方模型卡,不臆造仓库。
1.2 核心功能(官方 Checkpoints 清单)
官方发布的权重(均在 ByteDance/Hyper-SD 仓库内):
| 权重文件名 | 适用基座 | 类型 |
|---|---|---|
Hyper-FLUX.1-dev-Nsteps-lora.safetensors |
FLUX.1-dev | LoRA(8/16 步等) |
Hyper-SD3-Nsteps-CFG-lora.safetensors |
SD3-Medium | CFG 保留 LoRA(4/8/16 步) |
Hyper-SDXL-Nstep-lora.safetensors |
SDXL Base 1.0 | LoRA(1/2/4/8 步) |
Hyper-SD15-Nstep-lora.safetensors |
SD1.5 | LoRA(1/2/4/8 步) |
Hyper-SDXL-1step-unet.safetensors |
SDXL Base 1.0 | 蒸馏好的 1-step UNet(整权) |
其他要点:
- 1 步出图:Unified LoRA(
Hyper-SDXL-1step-lora/Hyper-SD15-1step-lora)配合TCDScheduler,可在 1–8 步间灵活调节步数与eta; - CFG 保留:8/12 步 CFG-LoRA(SDXL / SD1.5)支持 5–8 guidance scale,官方建议作为 SDXL / SD1.5 的标准配置;
- FLUX 支持:8/16 步 FLUX.1-dev LoRA,推荐 LoRA scale ≈ 0.125、guidance scale 保持 3.5;
- SD3 支持:4/8/16 步 CFG LoRA,guidance scale 分别建议 3.0 / 5.0 / 7.0;
- ComfyUI 工作流:官方在仓库
comfyui/目录提供 N-Steps LoRA、1-Step Unified LoRA、1-step SDXL UNet 的 ComfyUI 工作流 JSON。
1.3 技术架构
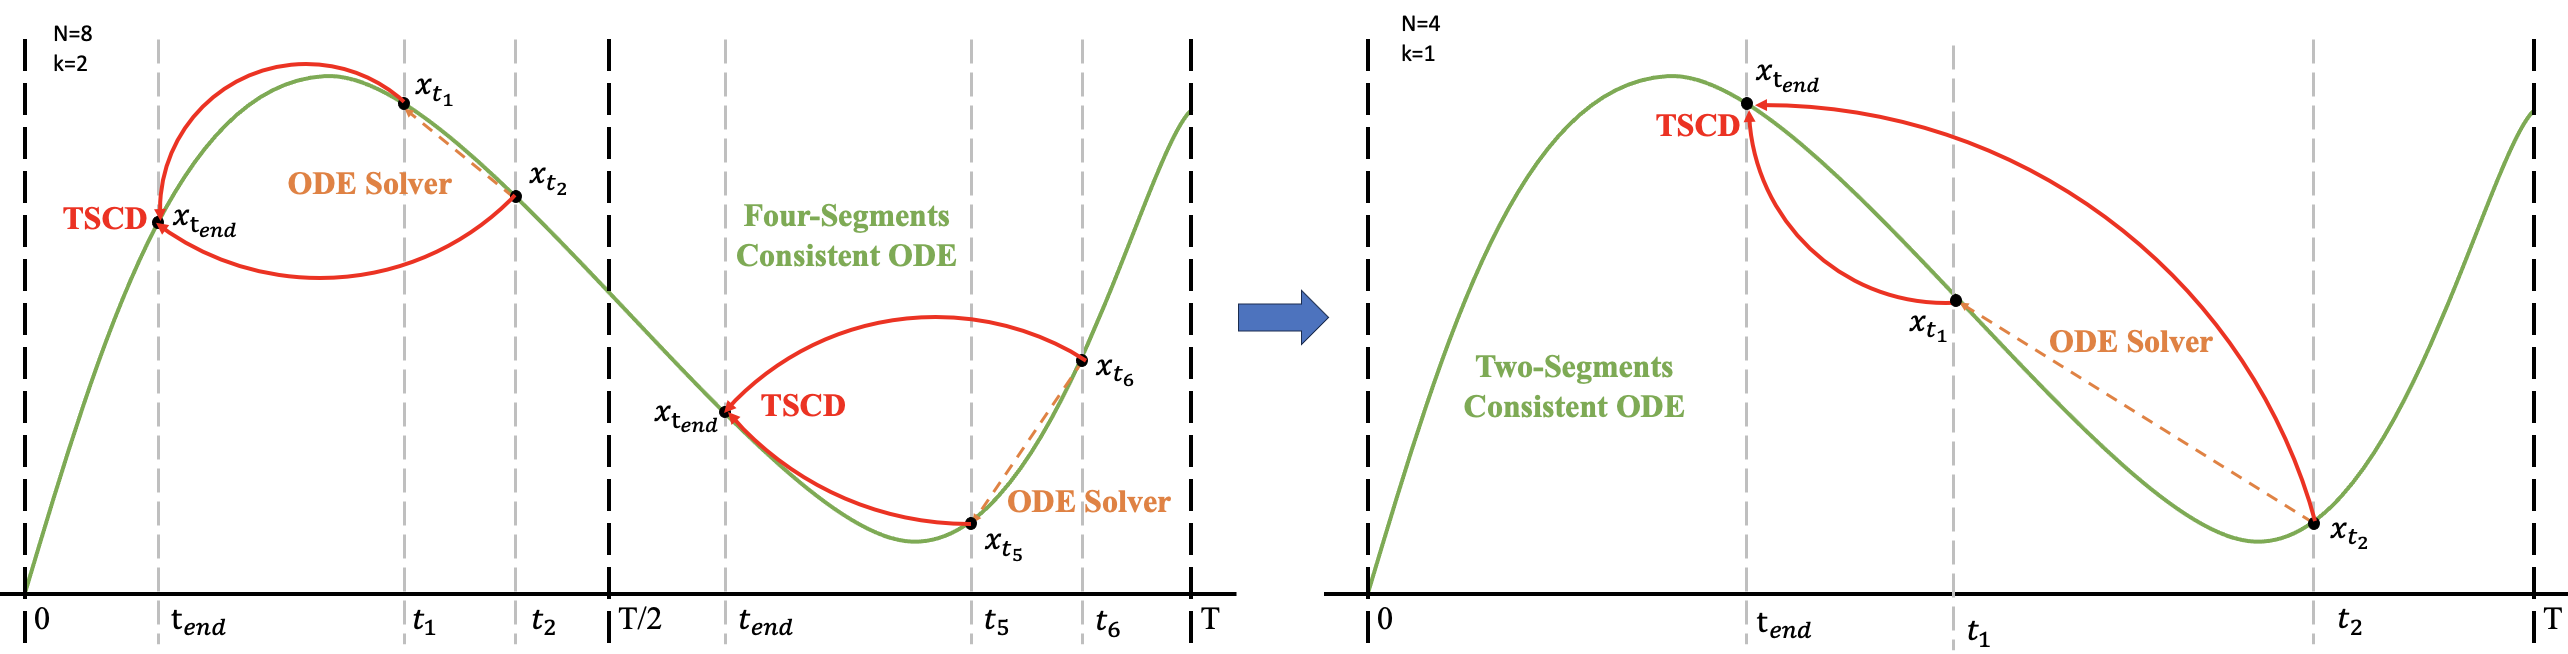
下图是官方项目页发布的 Hyper-SD 技术路线图(展示蒸馏加速的整体 pipeline):
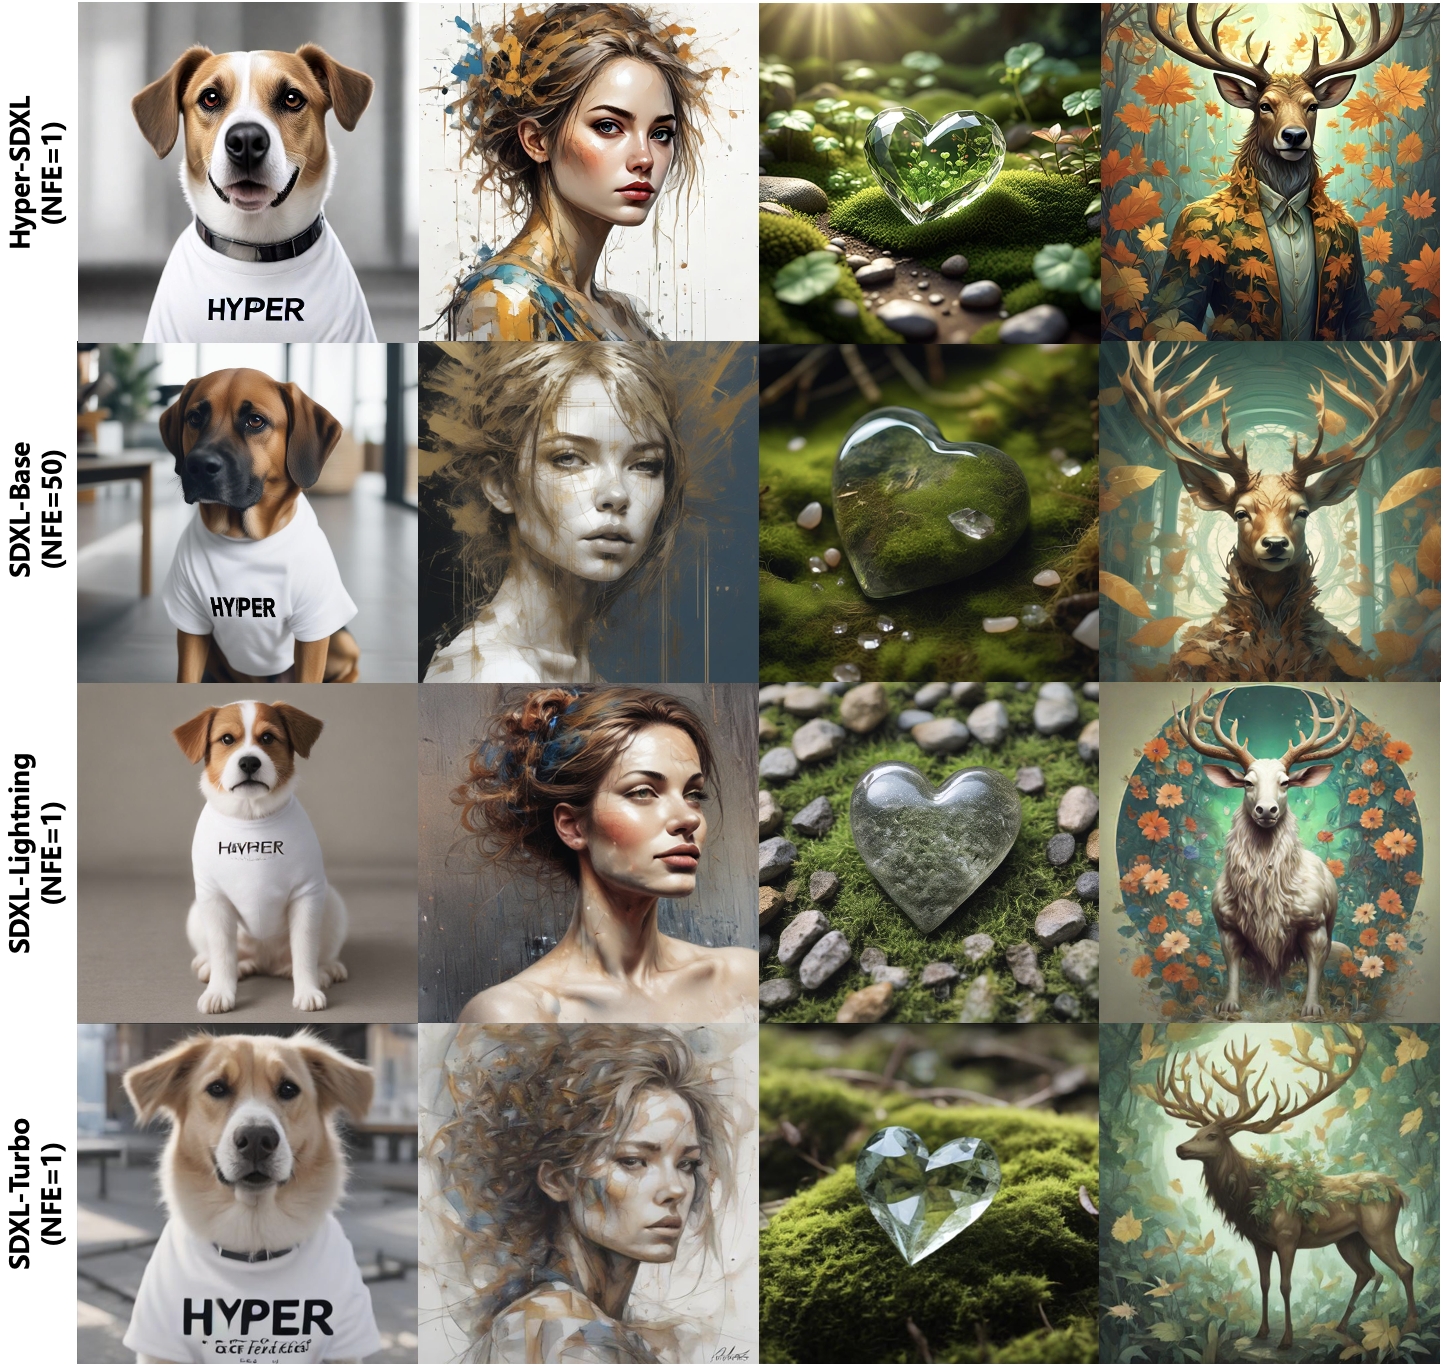
下图是官方项目页发布的 Hyper-SD 在各基座上的出图效果对比(少步生成与多步基线的画质对照):

二、环境要求
| 项目 | 要求 |
|---|---|
| 操作系统 | Linux(官方示例主力,Ubuntu 20.04/22.04);Windows 可用 WSL2 跑 diffusers |
| Python | 3.9–3.11 区间(diffusers 支持版本) |
| 框架底座 | diffusers、transformers、torch、huggingface_hub、safetensors |
| GPU | SD1.5/SDXL 少步出图 8–12GB 显存可起步;FLUX.1-dev 建议 ≥24GB 显存(FLUX 基座本身较大);SD3 中等显存 |
| 磁盘 | 基座模型(SDXL 约 6.5GB、SD1.5 约 4GB、SD3/FLUX 更大)+ 每个 LoRA 数百 MB,预留 30GB 以上 |
| 网络 | 需访问 HuggingFace 下载基座与 LoRA;FLUX.1-dev 与 SD3 是 gated model,需在 HF 页面申请访问权限并填 token |
| 其他工具 | huggingface-cli;ComfyUI 工作流需额外装 ComfyUI-TCD 等自定义节点 |
重要:FLUX.1-dev 与 SD3-Medium 在 HuggingFace 上是门控模型(gated),必须先在模型卡页面点同意协议、拿到访问 token,再在
from_pretrained(..., token="xxx")里填入,否则下载 403。
按资源选基座速查:
| 你的情况 | 推荐 |
|---|---|
| 8GB 显存、先跑通流程 | SD1.5 + Hyper-SD15-2steps-lora |
| 12GB 显存、要高画质 | SDXL + Hyper-SDXL-2steps 或 8steps-CFG-LoRA |
| 24GB 显存、追最新画质 | FLUX.1-dev + Hyper-FLUX.1-dev-8steps-lora |
| 只要 1 步极速出图 | SDXL/SD1.5 + Unified 1step-lora + TCDScheduler |
| 要 ControlNet 可控生成 | SDXL/SD1.5 + 对应步数 LoRA + Canny ControlNet |
三、部署方式
下面以最常用的 SDXL 2 步 LoRA 为主线讲清「装依赖 → 下权重 → 出图」,再补 FLUX / SD3 / 1-step / ControlNet 的差异点。
3.1 第一步:安装依赖
# 1) 虚拟环境
python -m venv venv
source venv/bin/activate

# 2) 安装推理依赖
pip install -U diffusers transformers torch huggingface_hub safetensors accelerate

# 3) (可选)TCDScheduler 在较新 diffusers 中自带;若提示找不到,升级 diffusers
pip install -U diffusers
国内网络:
export HF_ENDPOINT=https://hf-mirror.com
3.2 方式一:SDXL 少步 LoRA(最常用,官方示例)
以 2 步 LoRA 为例(也可换成 4/8 步对应文件):
import torch
from diffusers import DiffusionPipeline, DDIMScheduler
from huggingface_hub import hf_hub_download

base_model_id = "stabilityai/stable-diffusion-xl-base-1.0"
repo_name = "ByteDance/Hyper-SD"
ckpt_name = "Hyper-SDXL-2steps-lora.safetensors"   # 换成 4/8 步对应文件

# 加载基座模型
pipe = DiffusionPipeline.from_pretrained(
    base_model_id, torch_dtype=torch.float16, variant="fp16"
).to("cuda")

# 挂载并融合 Hyper-SD 少步 LoRA
pipe.load_lora_weights(hf_hub_download(repo_name, ckpt_name))
pipe.fuse_lora()

# 关键:DDIM scheduler 的 timestep_spacing 必须设为 trailing
pipe.scheduler = DDIMScheduler.from_config(pipe.scheduler.config, timestep_spacing="trailing")

# 2 步出图(eta 越低细节越多)
prompt = "a photo of a cat"
image = pipe(prompt=prompt, num_inference_steps=2, guidance_scale=0).images[0]
image.save("output.png")
3.3 方式二:1-Step Unified LoRA(1–8 步可调)
import torch
from diffusers import DiffusionPipeline, TCDScheduler
from huggingface_hub import hf_hub_download

base_model_id = "stabilityai/stable-diffusion-xl-base-1.0"
repo_name = "ByteDance/Hyper-SD"
ckpt_name = "Hyper-SDXL-1step-lora.safetensors"

pipe = DiffusionPipeline.from_pretrained(
    base_model_id, torch_dtype=torch.float16, variant="fp16"
).to("cuda")
pipe.load_lora_weights(hf_hub_download(repo_name, ckpt_name))
pipe.fuse_lora()

# 用 TCD scheduler 获得更好画质
pipe.scheduler = TCDScheduler.from_config(pipe.scheduler.config)

eta = 1.0   # 多步推理时 eta 越低细节越多
image = pipe(prompt="a photo of a cat", num_inference_steps=1, guidance_scale=0, eta=eta).images[0]
image.save("output.png")
3.4 方式三:FLUX.1-dev 少步 LoRA
import torch
from diffusers import FluxPipeline
from huggingface_hub import hf_hub_download

base_model_id = "black-forest-labs/FLUX.1-dev"
repo_name = "ByteDance/Hyper-SD"
ckpt_name = "Hyper-FLUX.1-dev-8steps-lora.safetensors"

# FLUX.1-dev 是门控模型,填你自己的 HF token
pipe = FluxPipeline.from_pretrained(base_model_id, token="xxx")
pipe.load_lora_weights(hf_hub_download(repo_name, ckpt_name))
pipe.fuse_lora(lora_scale=0.125)   # 官方推荐 scale≈0.125
pipe.to("cuda", dtype=torch.float16)

image = pipe(prompt="a photo of a cat", num_inference_steps=8, guidance_scale=3.5).images[0]
image.save("output.png")
3.5 方式四:SD3 少步 CFG LoRA
import torch
from diffusers import StableDiffusion3Pipeline
from huggingface_hub import hf_hub_download

base_model_id = "stabilityai/stable-diffusion-3-medium-diffusers"
repo_name = "ByteDance/Hyper-SD"
ckpt_name = "Hyper-SD3-8steps-CFG-lora.safetensors"   # 4/8/16 步对应

pipe = StableDiffusion3Pipeline.from_pretrained(base_model_id, token="xxx")
pipe.load_lora_weights(hf_hub_download(repo_name, ckpt_name))
pipe.fuse_lora(lora_scale=0.125)
pipe.to("cuda", dtype=torch.float16)

# 官方建议:4/8/16 步对应 guidance scale 3.0 / 5.0 / 7.0
image = pipe(prompt="a photo of a cat", num_inference_steps=8, guidance_scale=5.0).images[0]
image.save("output.png")
3.6 方式五:SD1.5 少步 LoRA
与 SDXL 几乎一致,只换基座与 LoRA 文件名:
import torch
from diffusers import DiffusionPipeline, DDIMScheduler
from huggingface_hub import hf_hub_download

base_model_id = "runwayml/stable-diffusion-v1-5"
repo_name = "ByteDance/Hyper-SD"
ckpt_name = "Hyper-SD15-2steps-lora.safetensors"

pipe = DiffusionPipeline.from_pretrained(
    base_model_id, torch_dtype=torch.float16, variant="fp16"
).to("cuda")
pipe.load_lora_weights(hf_hub_download(repo_name, ckpt_name))
pipe.fuse_lora()
pipe.scheduler = DDIMScheduler.from_config(pipe.scheduler.config, timestep_spacing="trailing")

image = pipe(prompt="a photo of a cat", num_inference_steps=2, guidance_scale=0).images[0]
image.save("output.png")
3.7 验证部署成功
# 1) 跑通任一示例脚本,当前目录生成 output.png
ls -la output.png

# 2) 若能在几秒内出图(2 步/1 步),说明 Hyper-SD 少步加速已生效
# 对比:同样基座用默认 20–50 步会明显慢很多
四、使用方法
4.1 基础出图
沿用 3.2 的 SDXL 脚本,改 prompt 即可。关键调用:
image = pipe(prompt="a photo of a cat, soft lighting, highly detailed",
             num_inference_steps=2, guidance_scale=0).images[0]
image.save("output.png")
要点:
num_inference_steps必须与 LoRA 档位匹配(2 步 LoRA 就传 2,8 步就传 8);- 普通少步 LoRA(非 CFG 版)
guidance_scale=0;CFG 版(如Hyper-SDXL-8steps-CFG-lora)才用 5–8 的 guidance scale; - DDIM scheduler 必须
timestep_spacing="trailing",否则出图错乱。
4.2 常用参数与档位选择
| 你的需求 | 权重文件 | num_inference_steps | guidance_scale | scheduler |
|---|---|---|---|---|
| 极速出图(SDXL) | Hyper-SDXL-1step-lora | 1–8 | 0 | TCDScheduler |
| 极速出图(SD1.5) | Hyper-SD15-1step-lora | 1–8 | 0 | TCDScheduler |
| SDXL 平衡 | Hyper-SDXL-2steps / 4steps / 8steps | 对应 2/4/8 | 0 | DDIMScheduler(trailing) |
| SDXL 高质量 CFG | Hyper-SDXL-8steps-CFG-lora | 8 | 5–8 | 官方建议 |
| SD1.5 平衡 | Hyper-SD15-2steps / 4steps / 8steps | 对应 2/4/8 | 0 | DDIMScheduler(trailing) |
| FLUX 加速 | Hyper-FLUX.1-dev-8/16steps-lora | 8/16 | 3.5 | 默认 |
| SD3 加速 | Hyper-SD3-4/8/16steps-CFG-lora | 4/8/16 | 3.0/5.0/7.0 | 默认 |
4.3 进阶:接 ControlNet(以 SDXL Canny 为例)
官方示例——把少步 LoRA 挂到 SDXL Canny ControlNet pipeline 上:
import torch, numpy as np, cv2
from PIL import Image
from diffusers.utils import load_image
from diffusers import (ControlNetModel, StableDiffusionXLControlNetPipeline,
                       AutoencoderKL, DDIMScheduler)
from huggingface_hub import hf_hub_download

# 1) 读原图并抽 Canny 边缘
image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/sd_controlnet/hf-logo.png")
image = np.array(image)
image = cv2.Canny(image, 100, 200)
image = image[:, :, None]
image = np.concatenate([image, image, image], axis=2)
control_image = Image.fromarray(image)

# 2) 建 ControlNet + VAE + SDXL pipeline
controlnet = ControlNetModel.from_pretrained("diffusers/controlnet-canny-sdxl-1.0", torch_dtype=torch.float16)
vae = AutoencoderKL.from_pretrained("madebyollin/sdxl-vae-fp16-fix", torch_dtype=torch.float16)
pipe = StableDiffusionXLControlNetPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", controlnet=controlnet, vae=vae, torch_dtype=torch.float16
).to("cuda")

# 3) 挂 Hyper-SD 2 步 LoRA
pipe.load_lora_weights(hf_hub_download("ByteDance/Hyper-SD", "Hyper-SDXL-2steps-lora.safetensors"))
pipe.scheduler = DDIMScheduler.from_config(pipe.scheduler.config, timestep_spacing="trailing")
pipe.fuse_lora()

# 4) 少步可控生成
image = pipe("A chocolate cookie", num_inference_steps=2, image=control_image,
             guidance_scale=0, controlnet_conditioning_scale=0.5).images[0]
image.save("image_out.png")
官方说明:少步 Hyper-SD 与各类 ControlNet、基座模型高度兼容;Unified LoRA 版本可把 scheduler 换成
TCDScheduler并传eta=1.0。
4.4 ComfyUI 工作流
官方在 HF 仓库 comfyui/ 目录提供:
- N-Steps LoRA 工作流;
- 1-Step Unified LoRA 工作流(需装 ComfyUI-TCD 自定义节点);
- 1-step SDXL UNet 工作流(需装仓库内
ComfyUI-HyperSDXL1StepUnetScheduler自定义节点)。
下载对应 .json 工作流导入 ComfyUI 即可,适合设计师本地出图。
4.5 适用场景
- 需要极速出图的产品/原型设计(1–2 步);
- 高吞吐文生图服务(把 SDXL/FLUX 出图成本压到几十分之一);
- 可控生成工作流(Hyper-SD + ControlNet 少步出图);
- ComfyUI 本地创作(官方工作流);
- 把现有 SD1.5/SDXL 项目无痛加速,不改基座。
五、常见问题排查(FAQ)
Q1:FLUX.1-dev / SD3 下载报 403
- 原因:这两个是门控模型(gated)。
- 解决:先去对应模型卡页面点同意协议、账号通过后,在 from_pretrained(..., token="hf_xxx") 填入你自己的 HF token。
Q2:出图发糊、结构错乱
- 原因:DDIM scheduler 的 timestep_spacing 没设成 trailing,或步数与 LoRA 档位不匹配。
- 解决:按官方示例 pipe.scheduler = DDIMScheduler.from_config(pipe.scheduler.config, timestep_spacing="trailing");num_inference_steps 与 LoRA 文件名步数一致。
Q3:普通少步 LoRA 要不要设 guidance scale?
- 说明:非 CFG 版(如 Hyper-SDXL-2steps-lora)用 guidance_scale=0;只有 CFG 版(*-CFG-lora)才设 5–8。搞反会导致画面过饱和或过曝。
Q4:FLUX LoRA 出图颜色不对
- 原因:LoRA scale 没按官方推荐。
- 解决:pipe.fuse_lora(lora_scale=0.125),guidance scale 保持 3.5。
Q5:显存不够(OOM)
- 原因:FLUX / SDXL 基座本身大。
- 解决:① 先从 SD1.5 + 2步 LoRA 跑通;② 用 torch.float16 / variant="fp16";③ 开 enable_model_cpu_offload();④ FLUX 建议 ≥24GB 显存。
Q6:TCDScheduler 找不到
- 原因:diffusers 版本太旧。
- 解决:pip install -U diffusers;1-step Unified LoRA 必须配 TCDScheduler。
Q7:Unified 1-step LoRA 想多步出图
- 做法:它支持 1–8 步,把 num_inference_steps 调到 4/8,并设 eta=1.0(多步时 eta 越低细节越多)。
Q8:ComfyUI 工作流报错
- 原因:缺自定义节点。
- 解决:按官方说明在 ComfyUI/custom_nodes 装 ComfyUI-TCD(1-step Unified LoRA)或仓库内 ComfyUI-HyperSDXL1StepUnetScheduler(1-step UNet)。
Q9:权重下载慢/卡住
- 解决:export HF_ENDPOINT=https://hf-mirror.com;配合 hf_transfer 加速;基座模型较大,预留充足磁盘。
Q10:1-step UNet 与 1-step LoRA 怎么选?
- 说明:Hyper-SDXL-1step-unet.safetensors 是蒸馏好的整 UNet 权重,仅用于单步推理,需配 LCMScheduler 与 timesteps=[800];Hyper-SDXL-1step-lora 是统一 LoRA,可 1–8 步灵活调,更通用。
Q11:Windows 能跑吗? - 说明:diffusers 支持 Windows,但官方示例以 Linux 为主;建议 WSL2 或直接用 ComfyUI Windows 版。
Q12:想接自己的业务管线批量出图
- 做法:把 3.2 的脚本封装成服务,固定 num_inference_steps 与 scheduler;批量请求时注意 GPU 显存与并发,必要时加队列。
六、部署注意事项与最佳实践
- 基座先行、LoRA 随后:先确认基座模型能正常下载与加载(尤其 FLUX/SD3 门控),再挂 Hyper-SD LoRA,别一上来就组合调试。
- 步数与 LoRA 档位严格对应:2 步 LoRA 就传 2,8 步就传 8,混用是最常见出错点。
- scheduler 设置是硬约束:DDIM 版必须
timestep_spacing="trailing";Unified 1step 版必须TCDScheduler;1-step UNet 必须LCMScheduler。 - guidance scale 分版本:非 CFG 版传 0,CFG 版按官方推荐(SDXL/SD1.5 5–8,SD3 3/5/7,FLUX 3.5)。
- 显存与精度:一律
torch.float16/variant="fp16";显存紧张开enable_model_cpu_offload()。 - FLUX/SD3 要 token:门控模型提前在 HF 页面申请权限,准备好 token。
- ComfyUI 走官方工作流:设计师场景直接用
comfyui/目录的 JSON,少踩自定义节点坑。 - 许可随基座:Hyper-SD 是挂在基座上的 LoRA,最终使用许可遵循对应基座模型(SDXL/SD3/FLUX/SD1.5)的协议,商用前核对基座条款。
- 磁盘预留:基座 + 多档位 LoRA 共几十 GB,别下到一半磁盘满。
- 关注更新:官方 News 持续追加新基座(如 FLUX 8/16 步 LoRA),升级前看 HF 模型卡 News 栏。
七、参考资料
- 项目页:https://hyper-sd.github.io/
- HuggingFace 权重模型卡:https://huggingface.co/ByteDance/Hyper-SD
- 技术报告(arXiv):https://arxiv.org/abs/2404.13686
- FLUX.1-dev 基座:https://huggingface.co/black-forest-labs/FLUX.1-dev
- SD3-Medium 基座:https://huggingface.co/stabilityai/stable-diffusion-3-medium-diffusers
- SDXL Base 1.0 基座:https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0
- SD1.5 基座:https://huggingface.co/runwayml/stable-diffusion-v1-5
- ComfyUI-TCD 自定义节点:https://github.com/JettHu/ComfyUI-TCD
- diffusers 文档:https://huggingface.co/docs/diffusers
- 官方在线 Demo:https://huggingface.co/spaces/ByteDance/Hyper-SDXL-1Step-T2I