MimicMotion 保姆级部署教程:腾讯开源置信感知姿态引导人体运动视频生成,72 帧长视频
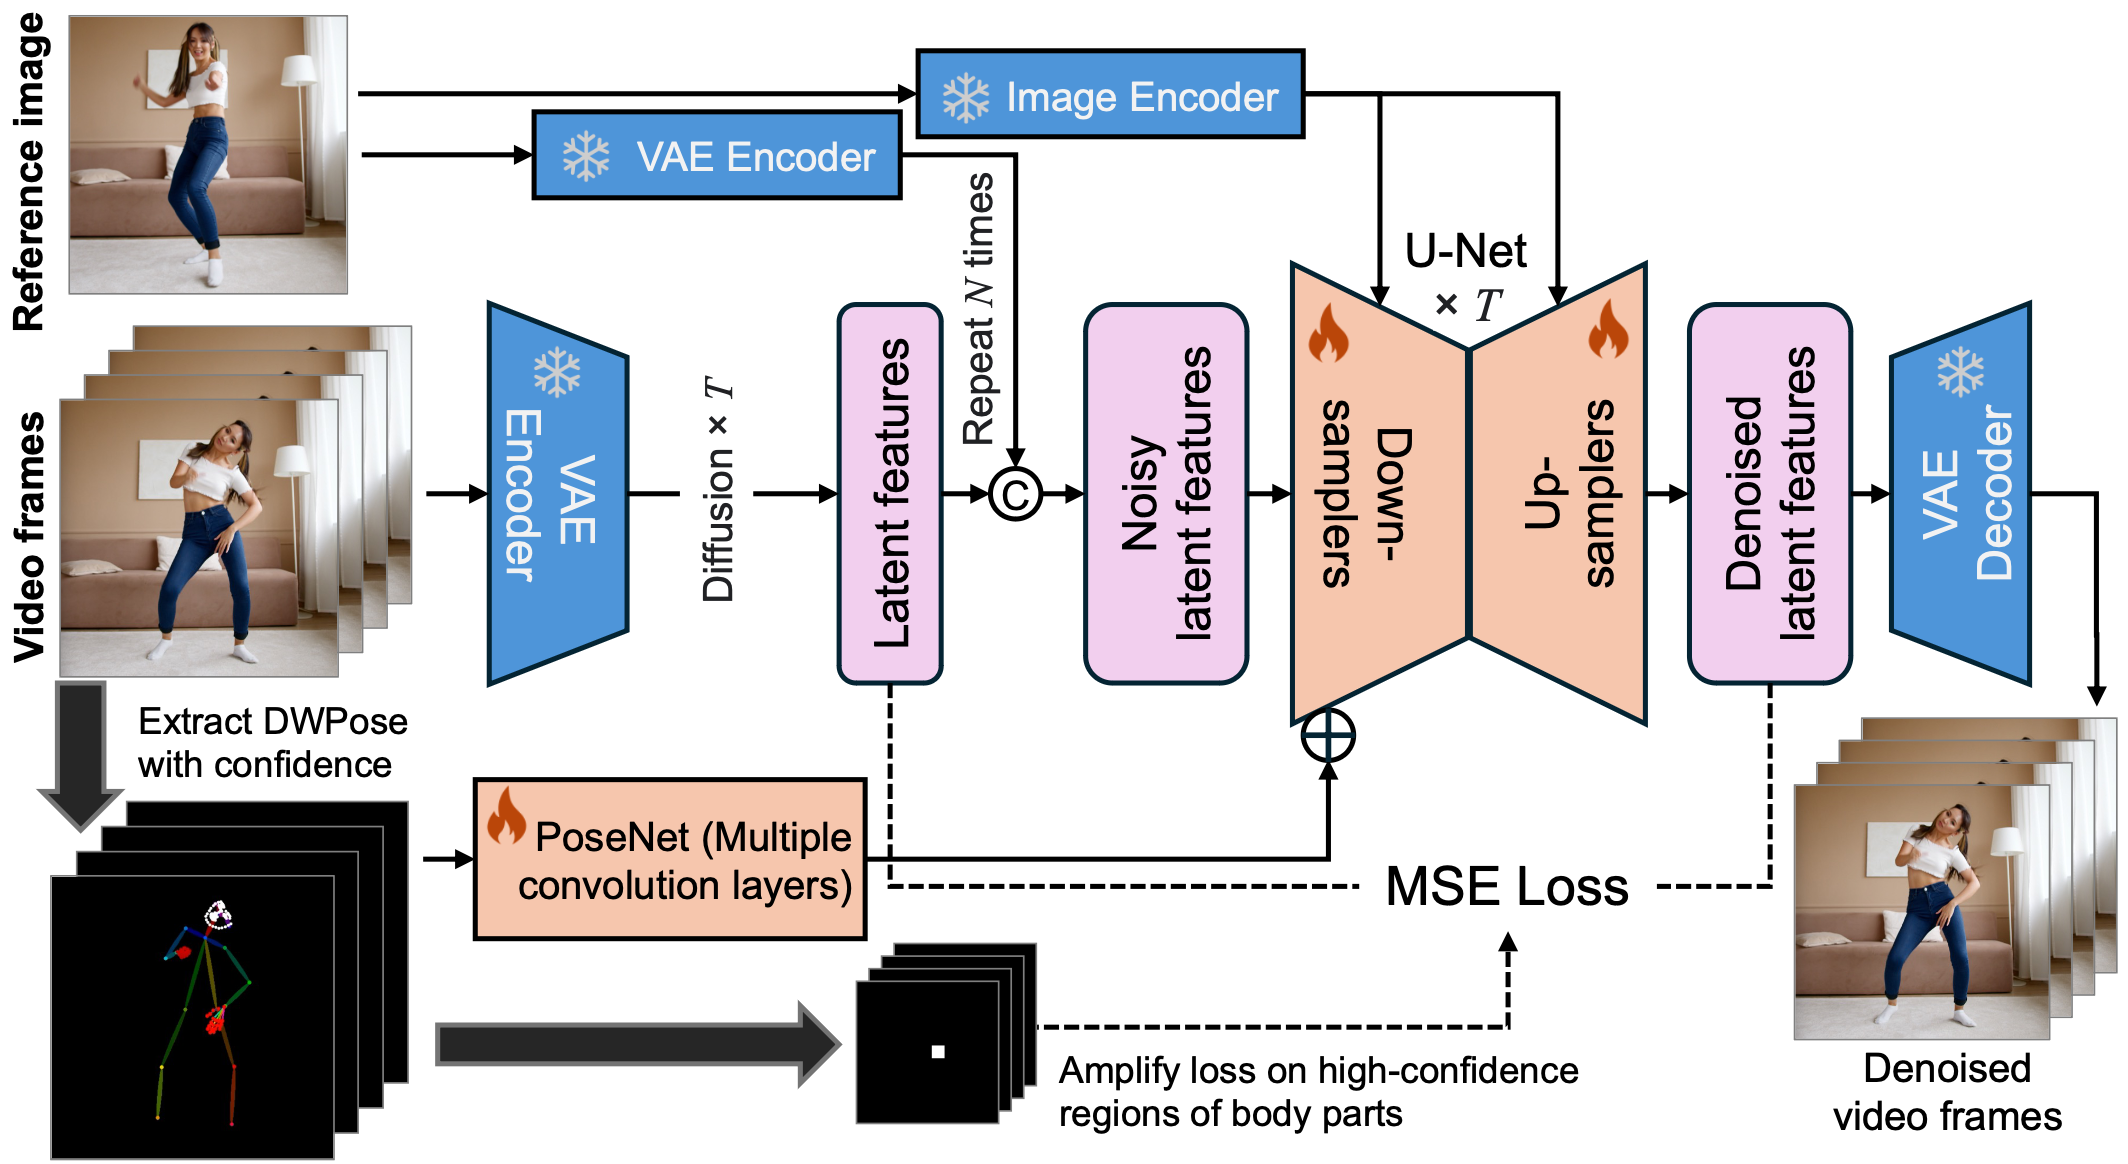
MimicMotion(仓库 Tencent/MimicMotion)是腾讯开源、ICML 2025 收录的人体运动视频生成框架:给一张人物图片 + 一段姿态视频(DWPose 骨架),它就能生成"这个角色按这段姿态动起来"的高清视频,最长支持 72 帧(576×1024)。论文核心是置信感知姿态引导(confidence-aware pose guidance)与渐进潜空间融合——前者让时序更平滑、后者让长视频可分段拼接。它是"图生视频"里专门做人体动作迁移的一支,与本站写过的 AnimateDiff(通用运动模块)用途不同。
一、项目介绍与适用场景
MimicMotion 的输入是:一张人物参考图 + 一段 K 帧姿态序列(DWPose 提取的骨架点);输出是:人物按骨架运动的连续视频。官方 2024 年 7 月发布 v1.1 权重(MimicMotion_1-1.pth),把最大帧数从 16 扩到 72。
适用场景:动漫/虚拟人跳舞视频、动作复刻、影视预演、把一段真人舞蹈动作迁移到卡通角色上。
技术亮点拆解(官方 Overview 原文):
- 置信感知姿态引导:以往的姿态引导方法在大姿态变化时容易崩图,MimicMotion 给每个骨架点加置信度,配合区域损失放大(regional loss amplification),显著缓解图像扭曲;
- 时序平滑:大规模训练数据下模型鲁棒性更强,输出帧之间不闪不跳;
- 渐进潜空间融合:把视频分成多段在潜空间拼接,理论上可生成任意长度的视频,而显存不随长度线性增长;
- 基于 SVD:底层骨架是 Stable Video Diffusion-img2vid-xt-1-1,官方会自动下载,省去手动下 SVD 权重。
二、核心功能逐条拆解
- 姿态引导人体动画:DWPose 骨架驱动人物运动。
- 置信感知姿态引导:降低图像扭曲,时序更平滑(官方 Overview)。
- 72 帧长视频:v1.1 权重支持 576×1024×72 帧。
- 渐进潜空间融合:长视频分段融合,任意长度可扩。
- 16G 显存可跑:官方 4060ti 16G 跑 72 帧 demo。
- CPU VAE 解码兜底:显存不够时把 VAE decoder 放 CPU。
- 基于 SVD:底层用 Stable Video Diffusion-img2vid-xt-1-1。
- 官方 test.yaml:示例配置开箱即用。
三、全套官方链接
| 类型 | 链接 |
|---|---|
| GitHub 仓库 | https://github.com/Tencent/MimicMotion |
| 官方文档 | 仓库 README(https://github.com/Tencent/MimicMotion/blob/main/README.md) |
| 官方 Demo | 项目页:http://tencent.github.io/MimicMotion |
| License | 见仓库 LICENSE(官方未在首页明确标注,以仓库 LICENSE 文件为准) |
四、硬件与环境前置要求
官方 README "Quickstart" 原文:
- 环境:Python 3+,PyTorch 2.x,官方在 Nvidia V100 上验证。
- 显存:72 帧模型生成 35s demo 视频需 16GB 显存(4060ti),4090 上约 20 分钟跑完。
- 最低显存:16 帧 U-Net 模型 8GB,但 VAE decoder 要 16GB——可把 VAE decoder 放 CPU 跑。
- 分辨率:72 帧模型支持最高 576×1024;显存不够可降帧数。
五、多平台部署步骤
官方只提供源码部署(conda env create + 手动下权重),未提供 Docker,本文不展开 Docker 小节。
5.1 源码部署
第 1 步:建环境。
conda env create -f environment.yaml
conda activate mimicmotion
第 2 步:建权重目录。
cd MimicMotions/
mkdir models
第 3 步:下 DWPose 预训练模型。
mkdir -p models/DWPose
wget https://huggingface.co/yzd-v/DWPose/resolve/main/yolox_l.onnx?download=true -O models/DWPose/yolox_l.onnx
wget https://huggingface.co/yzd-v/DWPose/resolve/main/dw-ll_ucoco_384.onnx?download=true -O models/DWPose/dw-ll_ucoco_384.onnx
第 4 步:下 MimicMotion 主权重。
wget -P models/ https://huggingface.co/tencent/MimicMotion/resolve/main/MimicMotion_1-1.pth
第 5 步:SVD 模型 stabilityai/stable-video-diffusion-img2vid-xt-1-1 会自动下载。
最终目录结构(官方原文):
models/
├── DWPose
│   ├── dw-ll_ucoco_384.onnx
│   └── yolox_l.onnx
└── MimicMotion_1-1.pth
HF 连不上时官方提示:export HF_ENDPOINT=https://hf-mirror.com。
5.2 Docker 部署
官方未提供 Docker 部署方式,本文不展开。
六、配置文件全部参数解释
官方 README 提供示例配置 configs/test.yaml,"You can also easily modify the various configurations according to your needs"。官方未在首页逐字段展开 yaml,主要可调点:
| 文件 / 参数 | 作用 | 来源 |
|---|---|---|
configs/test.yaml |
推理示例配置 | README "Model inference" |
inference.py --inference_config |
指定配置文件 | 同上 |
PYTORCH_CUDA_ALLOC_CONF=max_split_size_mb:256 |
显存紧张时的环境变量 | README Tips |
七、启动、后台常驻与开机自启
7.1 启动
python inference.py --inference_config configs/test.yaml
官方原文。显存紧张时先设:
export PYTORCH_CUDA_ALLOC_CONF=max_split_size_mb:256
7.2 后台常驻
MimicMotion 是单次推理脚本,跑完即出视频,无需常驻。
八、功能实操教程
第 1 步:conda env create -f environment.yaml 成功后 conda activate mimicmotion。这一步会按官方 environment.yaml 把 PyTorch 2.x、opencv、diffusers 等依赖一次装好,约需 5-10 分钟,取决于网络。
第 2 步:按第五节把 4 个权重文件(yolox_l.onnx、dw-ll_ucoco_384.onnx、MimicMotion_1-1.pth)放到 models/ 对应位置。再检查一下目录树是否与官方完全一致——多一层少一层都会导致 FileNotFoundError。
第 3 步:准备你自己的素材。参考图选一张正面、清晰、人物完整的 jpg;姿态视频建议先用一段真人舞蹈或动作视频,跑通流程后再换。DWPose 骨架会自动从姿态视频里提取关键点。
第 4 步:编辑 configs/test.yaml,把参考图路径、姿态视频路径、输出路径改成自己的。官方注释里说明可以改分辨率与帧数——先从 16 帧跑通,再逐步加到 72 帧。
第 5 步:python inference.py --inference_config configs/test.yaml,等待采样(4090 上跑 35s demo 视频约 20 分钟)。终端会打印采样进度条,不要中途关窗。
第 6 步:显存不够就降帧数(官方:If you encounter insufficient memory issues, you can appropriately reduce the number of frames);或把 VAE decoder 放 CPU——官方明确"you have the option to run the VAE decoder on CPU",这样 U-Net 推理只要 8G,VAE 后处理慢但能出片。
第 7 步:长视频生成。官方 v1.1 把单段上限从 16 提到 72 帧;超过 72 帧的长视频要靠官方"渐进潜空间融合(progressive latent fusion)"策略分段拼接,官方在 paper 里有详细描述,工程上按段生成后用 ffmpeg 拼接。
九、全套报错故障排查
-
CUDA out of memory原因:72 帧要 16G。 解决:降帧数;设export PYTORCH_CUDA_ALLOC_CONF=max_split_size_mb:256;把 VAE decoder 放 CPU。 -
DWPose 权重 404 / 下载失败 原因:
wget命令里的 URL 带?download=true,需完整复制官方 URL。 解决:手动到 https://huggingface.co/yzd-v/DWPose/tree/main 下载两个 onnx 放到models/DWPose/。 -
SVD 模型自动下载失败 原因:HF 连不上。 解决:
export HF_ENDPOINT=https://hf-mirror.com。 -
MimicMotion_1-1.pth找不到 原因:wget 没下对位置。 解决:确认在MimicMotions/目录下执行、权重在models/根目录(不是 models/DWPose/)。 -
推理速度极慢 原因:V100 等老卡;帧数过高。 解决:官方数据 4090 跑 72 帧约 20 分钟;降帧数到 16/36 先验证流程。
十、升级、回滚与卸载
- 升级:
git pull;官方 v1.1(2024.07.08)替换了 v1 权重,用MimicMotion_1-1.pth。 - 回滚:
git checkout <旧tag>;v1 与 v1.1 权重分目录。 - 卸载:删仓库、
conda env remove -n mimicmotion。
十一、商用许可与合规风险提示
- 代码 License 以仓库 LICENSE 文件为准(官方首页未在 README 文本中明确标注 SPDX 号)。
- 底层依赖 SVD(stabilityai/stable-video-diffusion-img2vid-xt-1-1)与 DWPose,各自许可需一并遵守。
- 人体动作迁移涉及真人肖像,用真实人物参考图与动作视频时注意肖像权与表演者权。
参考链接
- 官方 README:https://github.com/Tencent/MimicMotion/blob/main/README.md
- 权重(HF):https://huggingface.co/tencent/MimicMotion
- DWPose:https://huggingface.co/yzd-v/DWPose
- 论文:https://arxiv.org/abs/2406.19680