
官方信息
| 项目名称 | llm.nvim(前身 hfcc.nvim) |
| 仓库地址 | https://github.com/huggingface/llm.nvim |
| 官方网站 | 后端 llm-ls 仓库 | Hugging Face Inference API |
| 最新更新时间 | 2026-09-23 |
| 项目定位 | Hugging Face 官方出品的 Neovim 大模型代码补全插件,类 Copilot 的灰色幽灵文本补全,可接 Hugging Face API、Ollama、OpenAI 兼容服务与 TGI |
项目背景
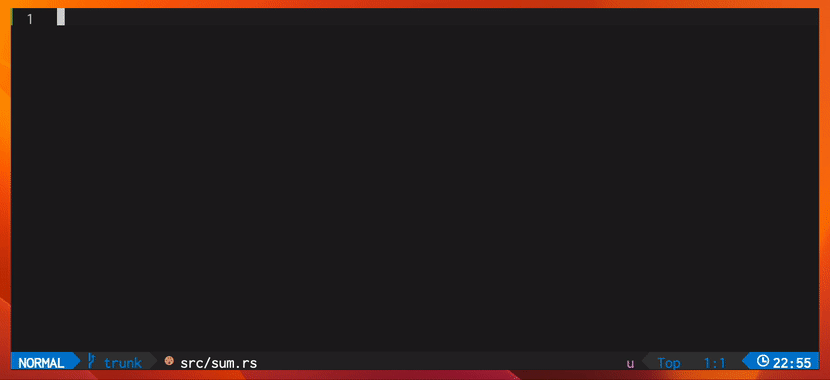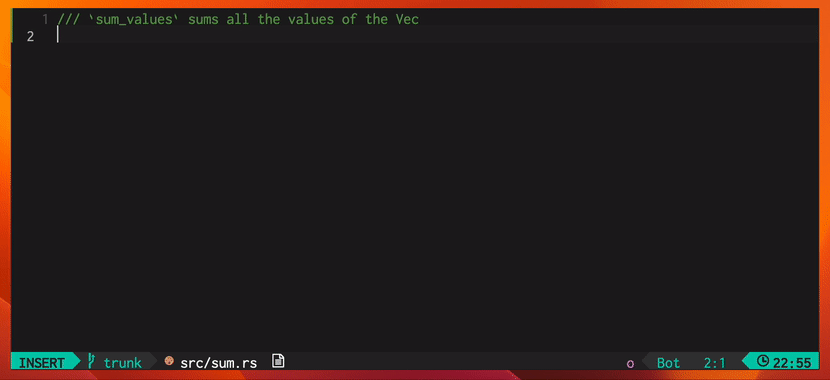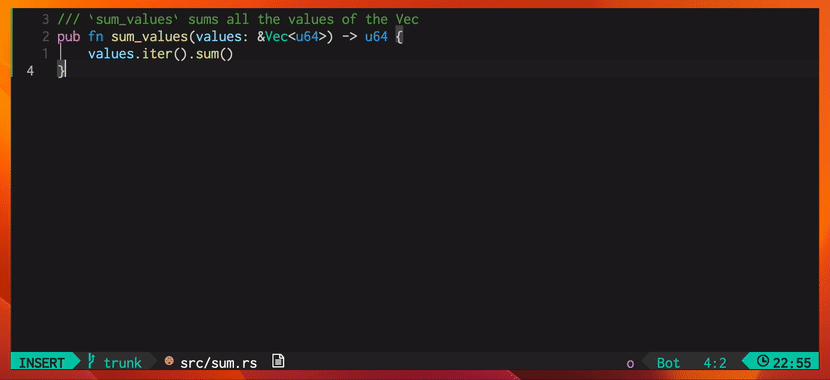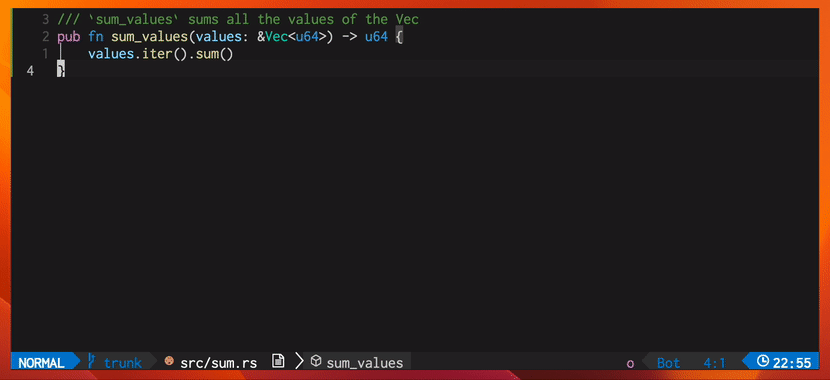
llm.nvim 是由 Hugging Face 官方维护的 Neovim 插件,前身叫做 hfcc.nvim(Hugging Face Code Completion)。它的设计灵感来自 GitHub 官方的 copilot.vim 与 tabnine-nvim,目标只有一个:让你在终端里敲代码时,像在 VS Code 里用 Copilot 一样,自动弹出灰色的"幽灵文本"建议,按 Tab 即可接受。
与其他把整套服务端塞进插件的方案不同,llm.nvim 把"重活"交给了一个独立的语言服务器后端 llm-ls(Rust 编写)。插件本身负责在 Neovim 里渲染建议、管理快捷键,llm-ls 则负责拼接上下文、做 token 计数、向后端模型发 HTTP 请求。这种解耦带来两个好处:一是补全请求很快(Rust 二进制),二是后端可以随意切换——既可以用 Hugging Face 托管的 StarCoder 等开源模型,也可以接到本地跑的 Ollama、llama.cpp(OpenAI 兼容)或自己部署的 TGI。
最关键的是:它不锁定任何一家模型厂商。你可以用 Hugging Face Inference API 的免费额度起步,也可以把 url 指向本地 http://localhost:11434 跑 Ollama,完全本地、零成本、零数据外传。
核心特性
- Ghost-text 幽灵补全:模仿 Copilot 的灰色内联建议,输入时自动在光标后弹出补全,
Tab接受、Shift+Tab忽略。 - 多后端自由切换:支持
huggingface(官方 Inference API)、ollama(本地模型)、openai(OpenAI 兼容接口)、tgi(自建 Text Generation Inference)四种后端。 - 自动适配上下文窗口:后端 llm-ls 使用 tokenizers 精确计算 token 数,保证发给模型的提示永远不超过
context_window。 - FIM(Fill-in-the-Middle)支持:原生支持 StarCoder、CodeLlama 等模型的"中插补全"协议,能根据光标前后的代码同时推断中间内容。
- 二进制自动下载:首次加载时自动从 llm-ls 的 Release 页下载对应平台二进制,存到
stdpath("data")/llm_nvim/bin,无需手动编译。 - 按文件类型启用:通过
enable_suggestions_on_files精确控制只在*.py、*.rs等文件里触发补全,避免打扰文档。 - Mason 集成:可通过
:MasonInstall llm-ls用 mason.nvim 统一管理后端二进制。
环境要求
- Neovim:0.9 及以上版本(推荐 0.10+)。
- 插件管理器:lazy.nvim / packer.nvim / vim-plug 任选其一。
- 网络:首次加载需能访问 GitHub Release 下载 llm-ls 二进制;使用 Hugging Face 后端需能访问 huggingface.co。
- 后端二选一:① Hugging Face 账号与 Access Token(免费额度即可);② 本地安装 Ollama 并拉取代码模型。
- 可选:
curl、mason.nvim。
详细部署步骤
第一步:准备 Neovim 与包管理器
先确认你的 Neovim 版本(需要 0.9+):
nvim --version
# 期望输出类似:NVIM v0.10.2,第一行版本号 >= 0.9.0
如果你还没有 lazy.nvim(推荐),先在 ~/.config/nvim/init.lua 里引导它:
# 创建 lazy.nvim 引导目录(如已存在可跳过)
mkdir -p ~/.config/nvim/lua/plugins

# 拉取 lazy.nvim
git clone --filter=blob:none https://github.com/folke/lazy.nvim.git \
  ~/.local/share/nvim/lazy/lazy.nvim
在 ~/.config/nvim/init.lua 顶部加入:
-- bootstrap lazy.nvim
local lazypath = vim.fn.stdpath("data") .. "/lazy/lazy.nvim"
if not vim.loop.fs_stat(lazypath) then
  vim.fn.system({
    "git", "clone", "--filter=blob:none",
    "https://github.com/folke/lazy.nvim.git", "--branch=stable", lazypath,
  })
end
vim.opt.rtp:prepend(lazypath)
第二步:安装 llm.nvim
新建插件配置文件 ~/.config/nvim/lua/plugins/llm-nvim.lua,内容如下(lazy.nvim 写法):
return {
  'huggingface/llm.nvim',
  opts = {
    -- 见下方“第三步”逐项配置
  },
}
如果你用的是 vim-plug,则在 init.vim 里写:
Plug 'huggingface/llm.nvim'
" 然后在 lua 代码块里 require('llm').setup({ ... })
保存后重启 Neovim,执行 :Lazy sync 安装。首次启动时插件会自动下载 llm-ls 二进制,请保持网络畅通;下载完成后二进制位于:
# Linux/macOS 默认路径
~/.local/share/nvim/llm_nvim/bin/llm-ls

# 可用命令确认是否下载成功
ls -lh ~/.local/share/nvim/llm_nvim/bin/
第三步:配置后端与 API Token
编辑 ~/.config/nvim/lua/plugins/llm-nvim.lua,把 opts 补全为下面这样。下面给出两种最常用方案,二选一即可。
方案 A:使用 Hugging Face 官方 Inference API(最简单,推荐新手)
return {
  'huggingface/llm.nvim',
  opts = {
    api_token = nil,                      -- 不要把 token 硬写在这里!用环境变量更安全
    model = "bigcode/starcoder2-15b",     -- 模型 ID,会拼到 {url}/model/{model}
    backend = "huggingface",              -- 后端 ID
    url = nil,                            -- nil 则用 Inference API 默认地址
    tokens_to_clear = { "<|endoftext|>" },
    request_body = {
      parameters = {
        max_new_tokens = 60,
        temperature = 0.2,
        top_p = 0.95,
      },
    },
    -- FIM 中插补全(Starcoder2 默认配置)
    fim = {
      enabled = true,
      prefix = "<fim_prefix>",
      middle = "<fim_middle>",
      suffix = "<fim_suffix>",
    },
    debounce_ms = 150,                    -- 输入停顿多少毫秒后触发补全
    accept_keymap = "<Tab>",               -- 接受补全
    dismiss_keymap = "<S-Tab>",            -- 忽略补全
    context_window = 8192,                 -- Starcoder2 上下文长度
    enable_suggestions_on_startup = true,
    enable_suggestions_on_files = { "*.py", "*.rs", "*.lua", "*.js", "*.ts" },
  },
}
然后设置 Hugging Face Token(按优先级任选其一):
# 方式一(推荐):写入环境变量,加到 ~/.bashrc 或 ~/.zshrc
export LLM_NVIM_HF_API_TOKEN="hf_xxxxxxxxxxxxxxxxxxxx"

# 方式二:用 huggingface-cli 登录
pip install -U huggingface_hub
huggingface-cli login   # 粘贴你的 token,会写到 ~/.cache/huggingface/token

# 方式三:直接指定模型环境变量(覆盖 opts 里的 model)
export LLM_NVIM_MODEL="bigcode/starcoder2-15b"
Token 在 huggingface.co/settings/tokens 免费创建。注意:免费额度有速率限制,频繁补全可能被限流,可订阅 PRO 解除。
方案 B:使用本地 Ollama(完全离线、零成本)
先安装并启动 Ollama、拉取代码模型:
# 安装 Ollama(Linux)
curl -fsSL https://ollama.com/install.sh | sh

# 拉取代码模型(7B 量化版,显存 8GB 即可跑)
ollama pull codellama:7b

# 确认服务已在 11434 端口监听
curl http://localhost:11434/api/tags
再把插件配置改为:
opts = {
  model = "codellama:7b",
  backend = "ollama",
  url = "http://localhost:11434",   -- llm-ls 会自动拼接 /api/generate
  request_body = {
    options = {
      temperature = 0.2,
      top_p = 0.95,
    },
  },
  fim = {
    enabled = true,
    prefix = "<PRE> ",
    middle = " <MID>",
    suffix = " <SUF>",
  },
  tokens_to_clear = { "<EOT>" },
  context_window = 4096,
  accept_keymap = "<Tab>",
  dismiss_keymap = "<S-Tab>",
}
第四步:启动验证
保存配置后重启 Neovim,打开任意 .py 文件,输入一段注释如:
# write a function to compute fibonacci numbers停顿约 150ms 后,光标后应出现灰色幽灵文本建议。此时:
- 按
Tab:接受整段补全。 - 按
Shift+Tab:忽略本条建议。 - 手动触发:输入命令
:LLMSuggestion。 - 开关自动补全:
:LLMToggleAutoSuggest。
如果没出现建议,可打开 llm-ls 日志排查:
-- 在 opts 里临时加一行,重启后查看后端日志
lsp = {
  cmd_env = { LLM_LOG_LEVEL = "DEBUG" },
}
常见坑与解决办法
- 启动后卡死 / 没反应:多半是 llm-ls 二进制没下下来。手动到 llm-ls Release 下载对应平台文件,放到
~/.local/share/nvim/llm_nvim/bin/llm-ls并chmod +x。 - 401 Unauthorized:Token 没生效。确认环境变量
LLM_NVIM_HF_API_TOKEN已 export,且重启了终端/Nvim。 - 补全出来是空的或报错:检查
model拼写;FIM 的特殊 token(如<PRE>、<MID>)前后空格不能省,CodeLlama 对空格敏感。 - 请求被限流:Hugging Face 免费额度有限,把
enable_suggestions_on_files收窄到常用后缀,或改用本地 Ollama。 - Mason 用户:运行
:MasonInstall llm-ls,然后在配置里写lsp = { bin_path = vim.fn.stdpath("data") .. "/mason/bin/llm-ls" }。
使用方法示例
典型工作流:打开一个 Python 文件,写函数签名后停下——
def quick_sort(arr):
    # 光标停在这里,llm.nvim 会灰色提示 partition、递归调用等实现
按 Tab 接受前几行,继续写下一段注释再触发。配合 :LLMToggleAutoSuggest,可以在读别人代码时关掉自动补全、只在写新代码时打开。整个过程不需要离开终端、不需要打开浏览器,和 Copilot 的体验基本一致。
常见问题 FAQ
Q1:它和 GitHub Copilot 有什么区别?
A:Copilot 用微软/GitHub 专属模型且需订阅;llm.nvim 开源免费,模型可换、可本地部署,数据不经第三方。
Q2:免费额度能用多久?
A:Hugging Face Inference API 对开源模型有免费速率限制,轻度编码补全够用;重度使用建议升级 PRO 或切本地 Ollama。
Q3:支持中文注释触发补全吗?
A:支持。模型会根据注释语义生成代码,中英文注释均可。
Q4:能接 DeepSeek、通义千问吗?
A:可以。任何提供 OpenAI 兼容 /v1/completions 接口的服务,都能用 backend = "openai",把 url 指向其兼容地址。
跳转链接
- GitHub 仓库:https://github.com/huggingface/llm.nvim
- 后端 llm-ls:https://github.com/huggingface/llm-ls
- Hugging Face Token 创建:https://huggingface.co/settings/tokens
- Inference API 文档:https://huggingface.co/docs/api-inference
- Ollama 官网:https://ollama.com