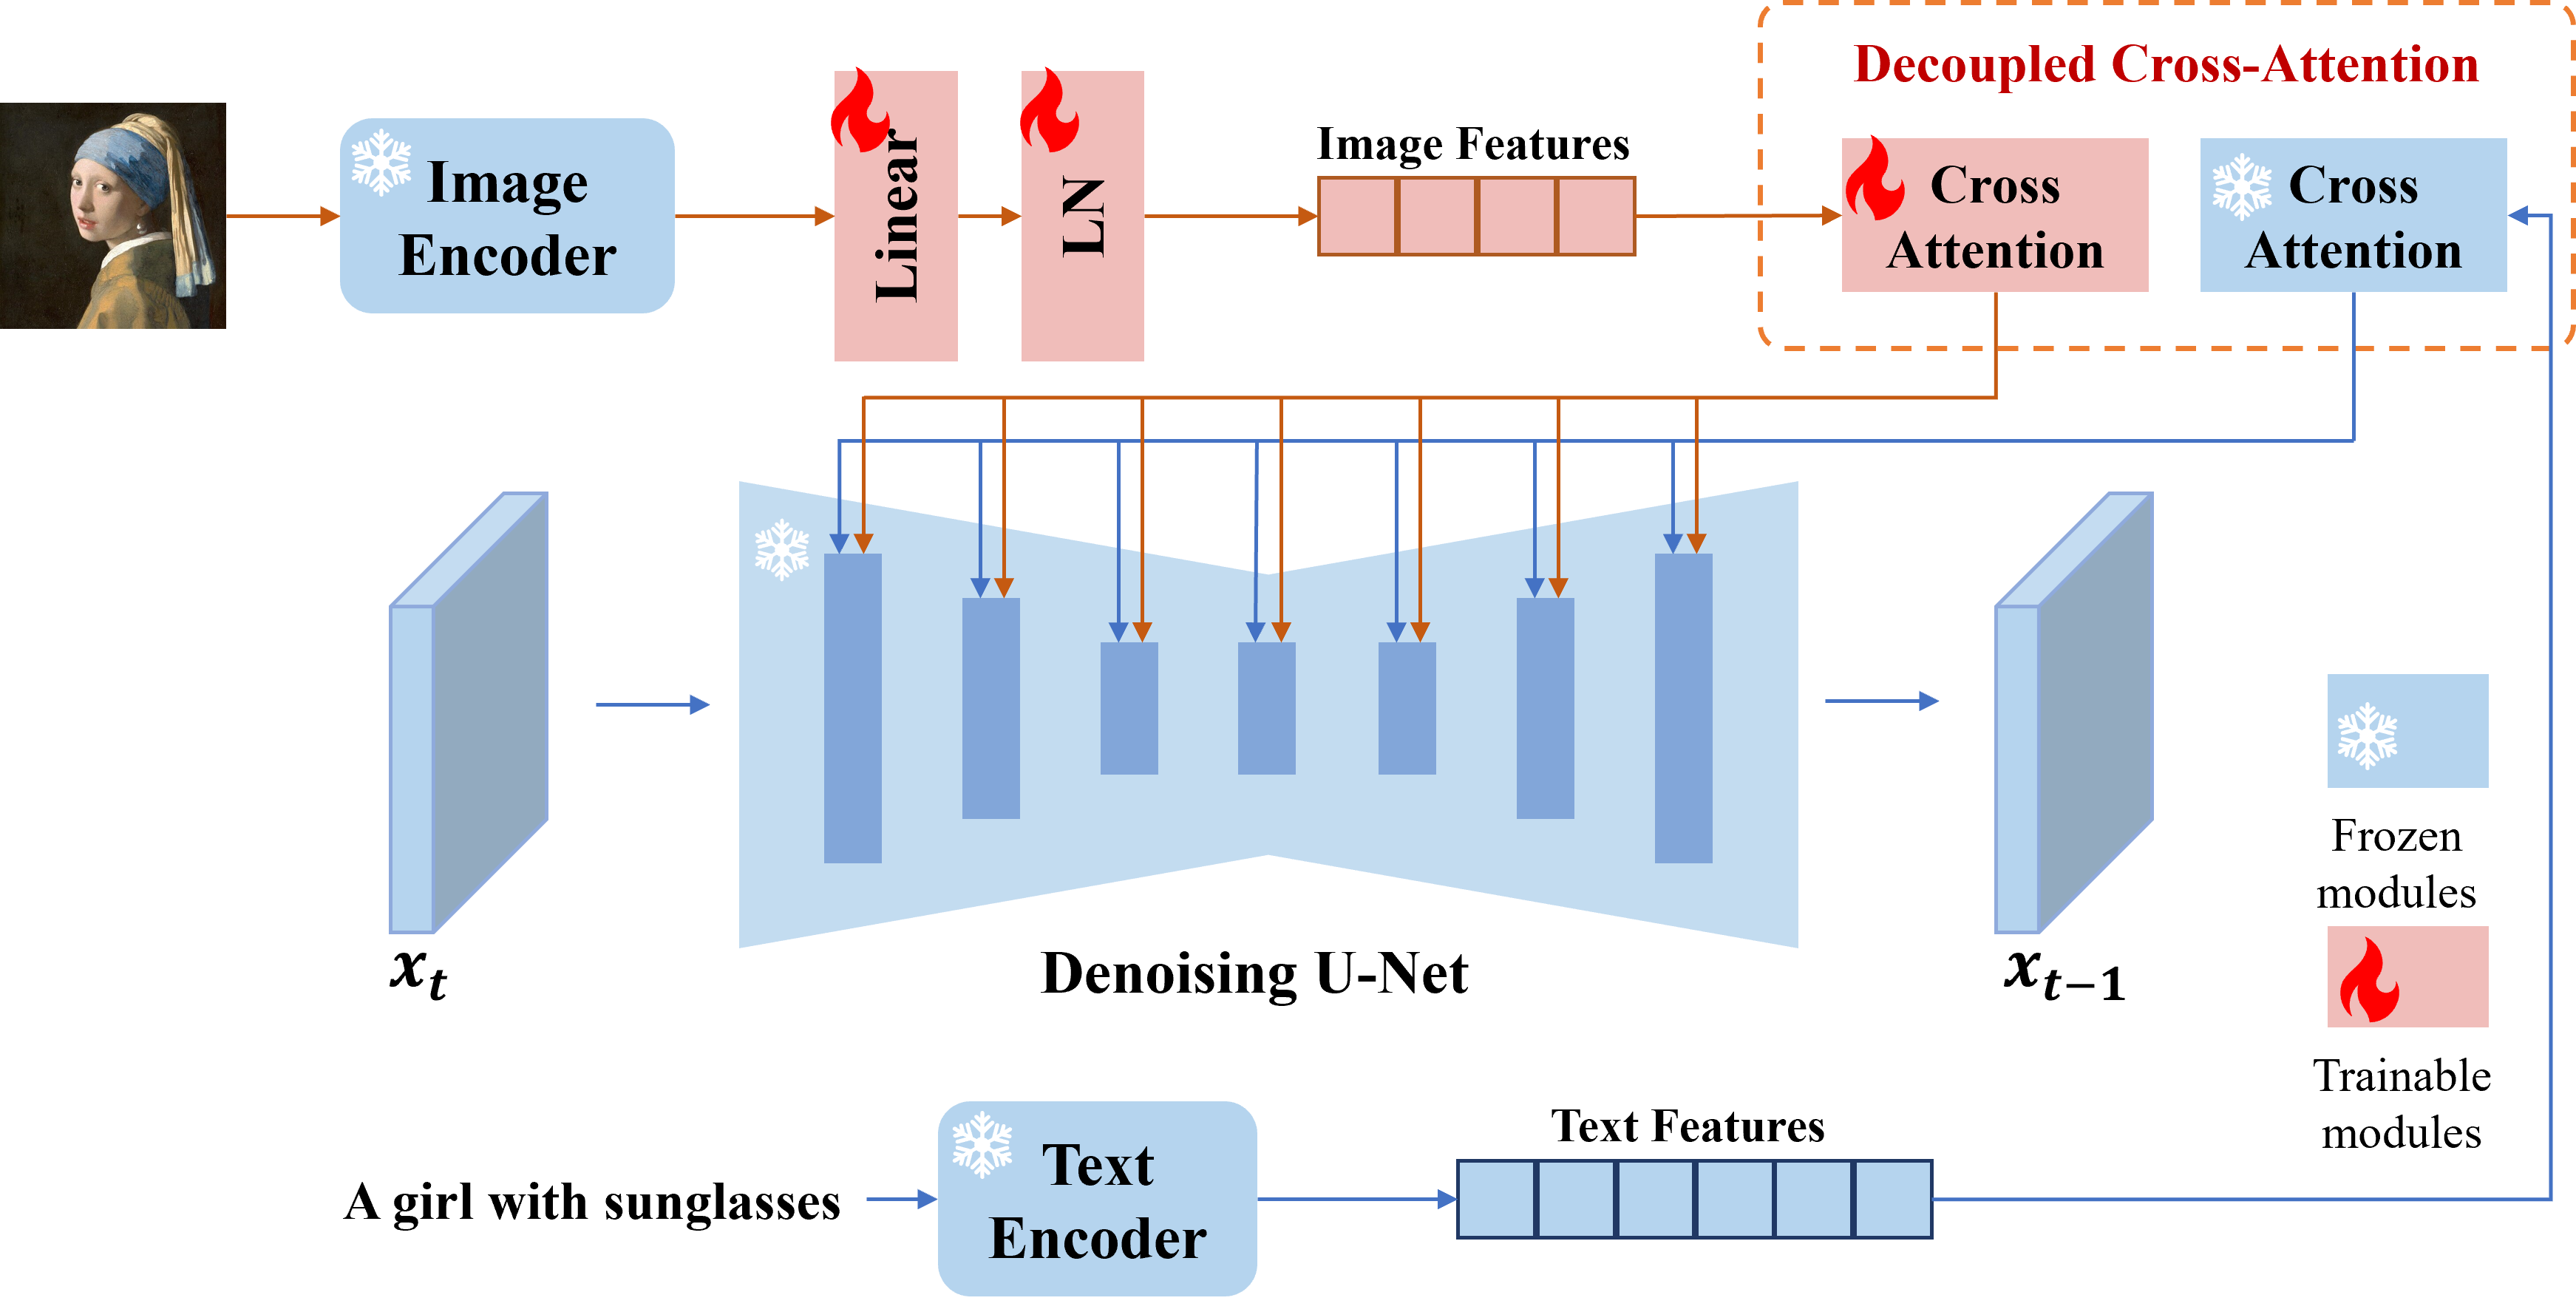


IP-Adapter:给扩散模型加上"图像提示"能力的轻量适配器|部署与使用全指南
项目仓库: https://github.com/tencent-ailab/IP-Adapter
技术报告:arXiv:2308.06721 · 模型权重:Hugging Face
h94/IP-Adapter · 语言:Python · 框架:PyTorch + Hugging
Face Diffusers · 形态:Python 库 + Jupyter Notebook · 维护方:腾讯 AI
Lab
1 项目简介
IP-Adapter(Image-Prompt Adapter)是腾讯 AI Lab 提出的一种轻量适配器:在已经训练好的文生图扩散模型(如 Stable Diffusion 1.5 / SDXL)之上,只增加约 22M 参数,就能让模型接受"一张参考图"作为额外的图像提示,实现图像变体、图生图、局部重绘、多模态提示生成,以及配合 ControlNet / T2I-Adapter 做可控生成。
它的核心思路是把图像提示编码成与文本提示同一空间的向量,再注入到 UNet 的注意力层,因此不需要重新训练整个扩散模型,也不需要为每张参考图收集数据集或做反向训练。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | IP-Adapter(Image-Prompt Adapter) |
| 仓库地址 | github.com/tencent-ailab/IP-Adapter |
| 项目定位 | 为文生图扩散模型提供图像提示能力的轻量适配器 |
| 维护方 | 腾讯 AI Lab(Tencent AI Lab) |
| 技术报告 | arXiv:2308.06721 |
| 模型权重 | h94/IP-Adapter(Hugging Face) |
| 依赖框架 | PyTorch、Hugging Face Diffusers(官方示例基于 diffusers==0.22.1) |
| 支持底座 | Stable Diffusion 1.5、SDXL 1.0 |
| 形态 | Python 库 + Jupyter Notebook 示例;非独立 Web 服务 |
| 默认端口 | 无(库形式,不启动 HTTP 服务) |
1.2 适用场景
- 想在已有的 SD 1.5 / SDXL 工作流里加入"以图生图、风格迁移、参考图生成",但不想为每张图做 LoRA 或 DreamBooth 训练。
- 需要把一张人脸参考图作为提示,生成保持该人物特征的图像(IP-Adapter-Face / FaceID 系列)。
- 需要同时使用文本提示和图像提示做"多模态"生成,例如"参考这张图的构图,按这段文字生成"。
- 已经在 WebUI / ComfyUI 里通过 ControlNet 做结构控制,希望叠加图像提示。
1.3 能力边界(官方口径)
- IP-Adapter 是适配器,不是独立模型:它依赖一个已经训练好的扩散模型底座(SD 1.5 或 SDXL)和对应的图像编码器。
- 官方 README 明确:图像提示在 CLIP 默认中心裁剪下最适合正方形图;非正方形图会丢失中心之外的信息,需要先 resize 到 224×224。
- 它本身不提供 Web 界面;官方使用方式是 Jupyter Notebook 脚本。ComfyUI / WebUI / InvokeAI 中的集成由第三方社区维护。
2 功能特性
- 轻量:约 22M 参数,相对于整个扩散模型可忽略。
- 不重训底座:以适配器形式插入现有 UNet 注意力层,兼容同一底座上微调过的自定义模型。
- 多模态提示:图像提示与文本提示可同时使用,通过
scale调节两者权重。 - 多版本:
- 基础版 IP-Adapter(SD 1.5);
- IP-Adapter-Plus(细粒度特征);
- IP-Adapter-Face / FaceID(人脸参考);
- IP-Adapter for SDXL 1.0;
- IP-Adapter-FaceID-Portrait 系列。
- 生态集成:官方已合入 Hugging Face Diffusers(PR #5713),第三方有 sd-webui-controlnet、ComfyUI(IPAdapter-ComfyUI、ComfyUI_IPAdapter_plus)、InvokeAI、InstantStyle 等。
3 官方界面预览
本项目是库/Notebook 形态,没有独立官方界面。开篇图即为官方 README 中的架构示意图。官方提供的 Colab Notebook 可在线运行示例:
4 官方跳转链接汇总
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库主页 | github.com/tencent-ailab/IP-Adapter | 源码、Notebook 示例、训练脚本 |
| 项目主页 | ip-adapter.github.io | 论文与示例展示页 |
| 技术报告 | arXiv:2308.06721 | 方法论文 |
| 模型权重 | h94/IP-Adapter | 适配器权重与 SDXL 权重 |
| FaceID 权重 | h94/IP-Adapter-FaceID | 人脸参考系列权重 |
| Issues | github.com/tencent-ailab/IP-Adapter/issues | Bug 与反馈 |
| Diffusers 集成 | diffusers PR #5713 | 官方 Diffusers 支持 |
| ComfyUI 集成 | ComfyUI_IPAdapter_plus | 第三方 ComfyUI 节点 |
5 前置要求与服务器配置
5.1 软件前提
- Python 3.8+(官方示例基于 PyTorch 生态)。
- PyTorch(建议与 CUDA 版本匹配的 GPU 版)。
- Hugging Face Diffusers:官方 README 示例基于
diffusers==0.22.1。 - Git LFS:用于从 Hugging Face 克隆模型权重。
- 建议 GPU 推理(SD 1.5 至少 8 GB 显存,SDXL 建议 12 GB 以上)。
5.2 硬件与系统建议
| 项目 | 最低 / 建议 |
|---|---|
| GPU | 支持 CUDA 的 NVIDIA 显卡;SD 1.5 示例 8 GB 显存起,SDXL 建议 12 GB 以上 |
| 磁盘 | 需容纳 SD 1.5 / SDXL 底座模型、VAE、适配器权重,合计约 10–20 GB |
| 操作系统 | Linux(Ubuntu 20.04+)推荐;Windows / macOS(Apple Silicon 可 CPU/Metal 跑但较慢) |
5.3 端口
本项目为库形态,不监听任何 HTTP 端口;不需要开放对外端口。
6 方式一:pip 安装 + Notebook 运行(官方推荐路径)
官方 README 给出的最小可运行路径是安装 diffusers 与 ip-adapter 包,再用 Git LFS 拉取模型权重,最后在 Notebook 中调用。
# 1. 建议使用独立虚拟环境
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate

# 2. 安装官方示例对应的 diffusers 版本
pip install diffusers==0.22.1

# 3. 安装 ip-adapter 包(从 GitHub 源码安装)
pip install git+https://github.com/tencent-ailab/IP-Adapter.git

# 4. 克隆仓库以获得 Notebook 示例
git clone https://github.com/tencent-ailab/IP-Adapter.git
cd IP-Adapter

# 5. 配置 Git LFS 并下载模型权重
git lfs install
git clone https://huggingface.co/h94/IP-Adapter
mv IP-Adapter/models models
mv IP-Adapter/sdxl_models sdxl_models

# 6. 启动 Jupyter,打开对应 demo
jupyter notebook
# 浏览器中打开 ip_adapter_demo.ipynb(SD 1.5)
# 或 ip_adapter_sdxl_demo.ipynb(SDXL 1.0)
官方同时提供 Colab 版本(见第 3 节链接),无需本地 GPU 即可跑通示例。
7 方式二:在 ComfyUI / WebUI 中以第三方插件使用
如果不想写代码,官方 README 明确列出了第三方集成:
- ComfyUI:安装 ComfyUI_IPAdapter_plus 或 IPAdapter-ComfyUI,按插件说明把 `models/` 下的适配器权重放到 ComfyUI 对应目录。
- Stable Diffusion WebUI:sd-webui-controlnet 已支持 IP-Adapter,见 release 说明。
- InvokeAI:v3.2.0 起内置支持。
这些是第三方集成,安装与使用细节以各自仓库 README 为准,不属于本项目官方代码。
8 配置项与关键参数
IP-Adapter 通过 Python 调用,没有 .env 或 YAML
配置文件;关键参数来自官方 Notebook:
| 参数 | 官方建议 | 说明 |
|---|---|---|
scale(图像提示权重) |
只用图像提示时设 1.0;多模态提示时建议
0.5 |
数值越低,输出越多样但与参考图一致性越弱 |
text_prompt |
纯图像提示时可置空或填通用词如 "best quality" | 与图像提示共同作用 |
| 底座模型 | runwayml/stable-diffusion-v1-5(SD1.5)或
stabilityai/stable-diffusion-xl-base-1.0(SDXL) |
与适配器权重版本配套 |
| VAE | stabilityai/sd-vae-ft-mse |
官方 demo 推荐的微调 VAE |
| 图像预处理 | CLIP 默认中心裁剪,非正方形图建议 resize 到 224×224 | 见官方"Best Practice" |
| 训练精度 | 官方训练脚本用 --mixed_precision=fp16 |
多卡训练示例 |
官方训练命令(如需要自行训练适配器):
accelerate launch --num_processes 8 --multi_gpu --mixed_precision "fp16" \
  tutorial_train.py \
  --pretrained_model_name_or_path="runwayml/stable-diffusion-v1-5/" \
  --image_encoder_path="{image_encoder_path}" \
  --data_json_file="{data.json}" \
  --data_root_path="{image_path}" \
  --mixed_precision="fp16" \
  --resolution=512 \
  --train_batch_size=8 \
  --dataloader_num_workers=4 \
  --learning_rate=1e-04 \
  --weight_decay=0.01 \
  --output_dir="{output_dir}" \
  --save_steps=10000
9 常用运维命令
库形态没有服务进程;日常操作主要是环境与模型管理:
# 查看已安装版本
pip show ip-adapter
pip show diffusers

# 升级到 GitHub 最新代码
pip install --upgrade git+https://github.com/tencent-ailab/IP-Adapter.git

# 更新模型权重(进入权重目录后)
cd models && git pull

# 查看显存占用(推理时)
nvidia-smi
10 常见故障排查
- 模型下载慢 / 失败:Hugging Face
直连在部分网络下不稳定,可配置镜像或使用
huggingface-cli配合HF_ENDPOINT环境变量;不要绕过官方权重源改传非官方权重。 - diffusers 版本不兼容:官方示例基于
diffusers==0.22.1;更高版本 API 可能变化,如遇Pipeline字段报错,先按官方版本或迁移到 Diffusers 官方集成 的写法。 - 非正方形参考图效果差:官方 README 建议先把参考图 resize 到 224×224,避免 CLIP 中心裁丢失信息。
- 多模态生成与参考图不一致:调小
scale(如0.5)让文本提示占比上升;一致性不够则调大scale。 - 显存不足:SDXL 1024
分辨率对显存要求高,可降低分辨率或开启
enable_model_cpu_offload()。
11 风险与合规说明
- IP-Adapter 是研究性开源项目,模型权重遵循 Hugging Face 上对应仓库的许可证(SD 1.5 / SDXL 底座另有自己的许可条款),商用前需核对底座模型与适配器权重的授权。
- 官方 Disclaimer 明确:开发者不对用户潜在的滥用承担责任;用户需遵守当地法律并负责任地使用。
- 人脸参考(FaceID / Face)能力可能被用于生成他人肖像,只能使用本人或已获明确授权的图像,不得用于伪造、冒充、侵权等用途。
- 第三方 ComfyUI / WebUI 插件的行为与安全以各自仓库为准。
本文基于官方 README、技术报告与 Hugging Face 模型卡整理,仅供学习与部署参考;部署与商用前请以仓库最新说明与 LICENSE 为准。