
DeepSeek-OCR 是 DeepSeek 从「以 LLM 为中心」视角研究视觉编码器作用的 OCR 模型,2025 年 10 月开源,2026 年 1 月已发布 OCR2。原生支持多分辨率,可把文档、表格、图片转成 Markdown,A100-40G 上 PDF 并发约 2500 tokens/s。
一、项目官方信息
| 项目 | 信息 |
|---|---|
| GitHub 仓库 | https://github.com/deepseek-ai/DeepSeek-OCR |
| 官方网站 | https://www.deepseek.com |
| Hugging Face | https://huggingface.co/deepseek-ai/DeepSeek-OCR |
| 论文 | https://arxiv.org/abs/2510.18234 |
| 开源协议 | MIT(代码与模型) |
| 主要语言 | Python(约 100%) |
| Star 数 | 约 10k(接口曾限流,以仓库页为准) |
二、官方图片
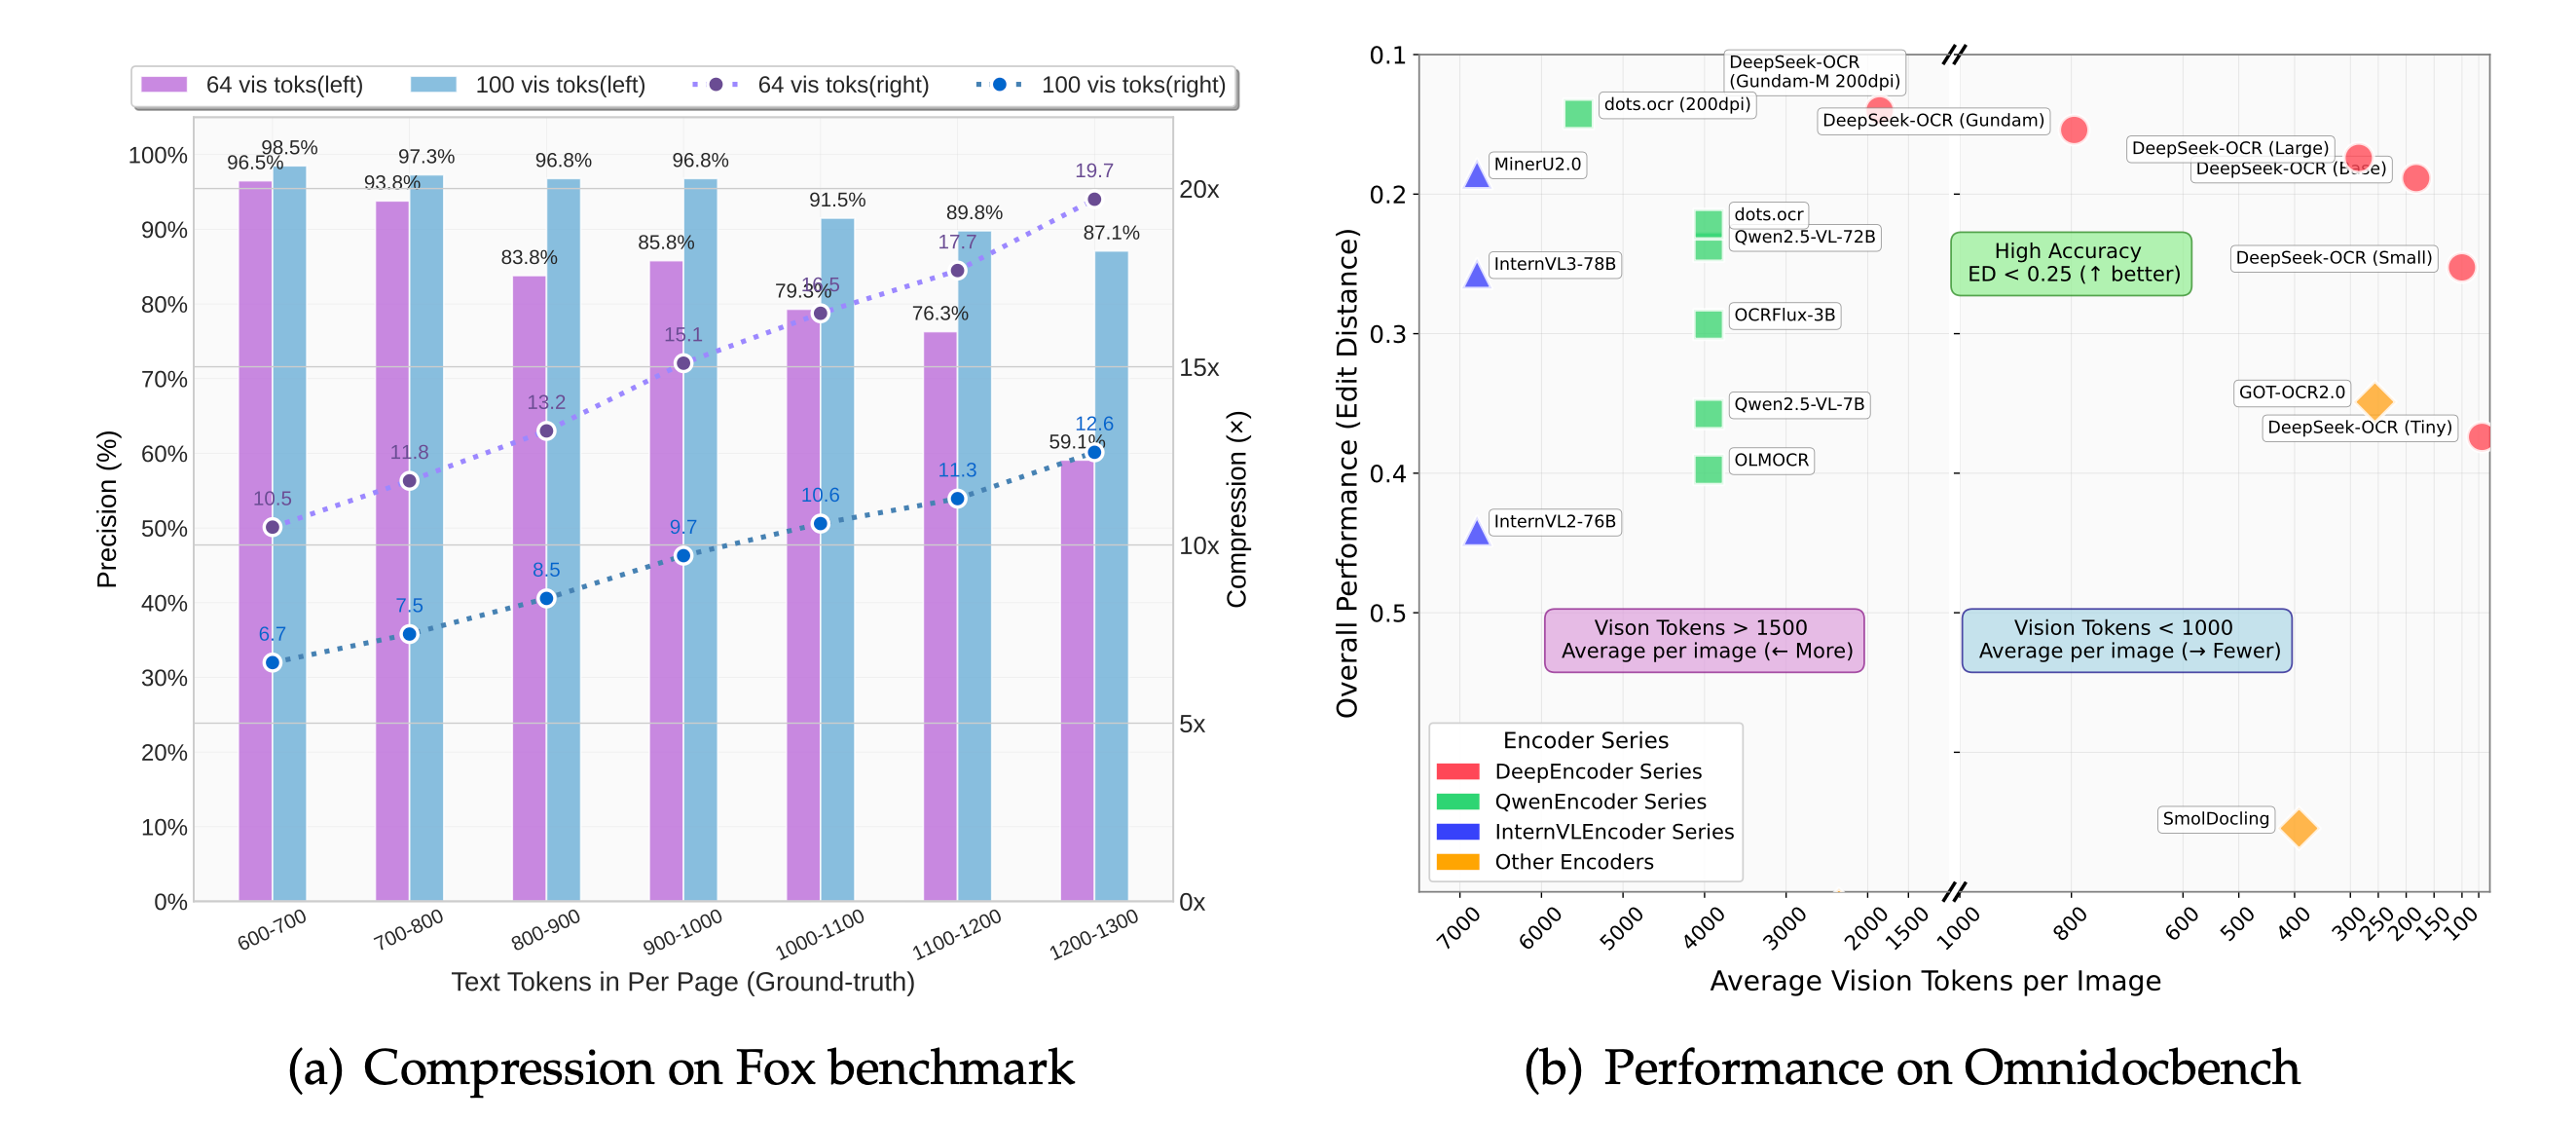
DeepSeek-OCR 架构与视觉压缩示意:
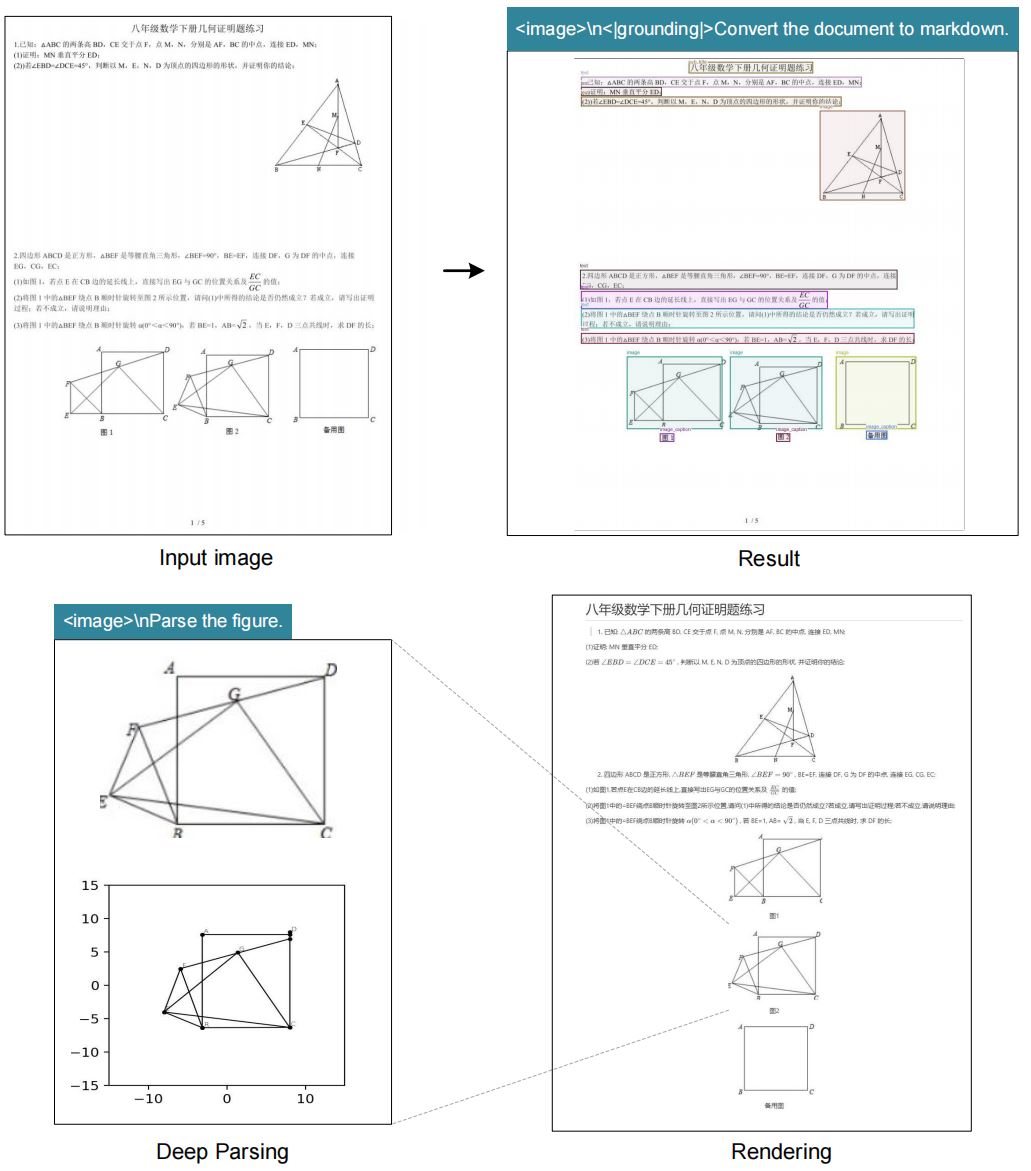
文档识别效果:
三、环境要求
- 官方环境:CUDA 11.8 + PyTorch 2.6.0;
- Python 3.12.9(conda 建环境);
- vLLM 0.8.5(cu118 whl);
- flash-attn 2.7.3;
- 显存:A100-40G 可跑 PDF 并发。
四、完整部署步骤
1. 克隆仓库
git clone https://github.com/deepseek-ai/DeepSeek-OCR.git
2. 建 conda 环境
conda create -n deepseek-ocr python=3.12.9 -y
conda activate deepseek-ocr
3. 安装依赖
pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 \
  --index-url https://download.pytorch.org/whl/cu118
pip install vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl
pip install -r requirements.txt
pip install flash-attn==2.7.3 --no-build-isolation
注:vllm 0.8.5 要求 transformers>=4.51.1,若想 vllm 与 transformers 同环境跑,该报错可忽略。
4. 用官方 vLLM 脚本推理
cd DeepSeek-OCR-master/DeepSeek-OCR-vllm
改 config.py 里的 INPUT_PATH / OUTPUT_PATH。
图片流式输出:
python run_dpsk_ocr_image.py
PDF 并发(A100-40G,约 2500 tokens/s):
python run_dpsk_ocr_pdf.py
批量 benchmark:
python run_dpsk_ocr_eval_batch.py
5. 用上游 vLLM 跑
uv venv
source .venv/bin/activate
uv pip install -U vllm --pre --extra-index-url https://wheels.vllm.ai/nightly
from vllm import LLM, SamplingParams
from vllm.model_executor.models.deepseek_ocr import NGramPerReqLogitsProcessor
from PIL import Image

llm = LLM(model="deepseek-ai/DeepSeek-OCR",
          enable_prefix_caching=False,
          mm_processor_cache_gb=0,
          logits_processors=[NGramPerReqLogitsProcessor])

image_1 = Image.open("path/to/your/image_1.png").convert("RGB")
image_2 = Image.open("path/to/your/image_2.png").convert("RGB")
prompt = "<image>\nFree OCR."
model_input = [
    {"prompt": prompt, "multi_modal_data": {"image": image_1}},
    {"prompt": prompt, "multi_modal_data": {"image": image_2}},
]
sp = SamplingParams(temperature=0.0, max_tokens=8192,
                    extra_args=dict(ngram_size=30, window_size=90,
                                    whitelist_token_ids={128821, 128822}),
                    skip_special_tokens=False)
for o in llm.generate(model_input, sp):
    print(o.outputs[0].text)
6. 用 Transformers 推理
from transformers import AutoModel, AutoTokenizer
import torch, os
os.environ["CUDA_VISIBLE_DEVICES"] = "0"
model_name = "deepseek-ai/DeepSeek-OCR"
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
model = AutoModel.from_pretrained(model_name, _attn_implementation="flash_attention_2",
                                  trust_remote_code=True, use_safetensors=True)
model = model.eval().cuda().to(torch.bfloat16)

prompt = "<image>\n<|grounding|>Convert the document to markdown."
res = model.infer(tokenizer, prompt=prompt, image_file="your_image.jpg",
                  output_path="your/output/dir", base_size=1024, image_size=640,
                  crop_mode=True, save_results=True, test_compress=True)
五、使用方法
支持的分辨率
- Native:Tiny 512×512(64 vision tokens)、Small 640×640(100)、Base 1024×1024(256)、Large 1280×1280(400);
- Dynamic:Gundam,n×640×640 + 1×1024×1024。
常用 Prompt
# 文档转 Markdown
<image>\n<|grounding|>Convert the document to markdown.
# 通用 OCR
<image>\n<|grounding|>OCR this image.
# 无版面
<image>\nFree OCR.
# 图中图表
<image>\nParse the figure.
# 描述
<image>\nDescribe this image in detail.
# 定位
<image>\nLocate <|ref|>xxxx<|/ref|> in the image.
六、常见问题 FAQ
1. vLLM 版本? 官方脚本用 vllm 0.8.5+cu118;上游 vLLM 从 v0.11.1 起原生支持,可用 nightly。
2. 显存要多少? A100-40G 可跑 PDF 并发。
3. OCR2 是什么? 2026/01/27 发布,仓库见 deepseek-ai/DeepSeek-OCR-2。
4. 支持中文吗? 支持,中文文档/表格识别是强项。
5. 输出格式? Markdown,含表格、公式、版面。
6. 与 PaddleOCR/GOT-OCR 区别? DeepSeek-OCR 以 LLM 为中心压缩视觉 token,支持动态分辨率与长文档。