
DeepSeek-Coder-V2 是开源 MoE 代码大模型,在 DeepSeek-V2 中间检查点上继续预训练 6T tokens,代码能力对标 GPT-4-Turbo。提供 16B(Lite,激活 2.4B)与 236B(激活 21B)两档,上下文 128K,支持 338 种编程语言。
一、项目官方信息
| 项目 | 信息 |
|---|---|
| GitHub 仓库 | https://github.com/deepseek-ai/DeepSeek-Coder-V2 |
| 官方网站 | https://www.deepseek.com |
| Hugging Face | https://huggingface.co/deepseek-ai |
| 论文 | https://arxiv.org/abs/2406.11931 |
| 开源协议 | 代码 MIT;模型遵循 Model License(支持商用) |
| 主要语言 | Python(约 100%) |
| Star 数 | 约 7.0k |
二、官方图片
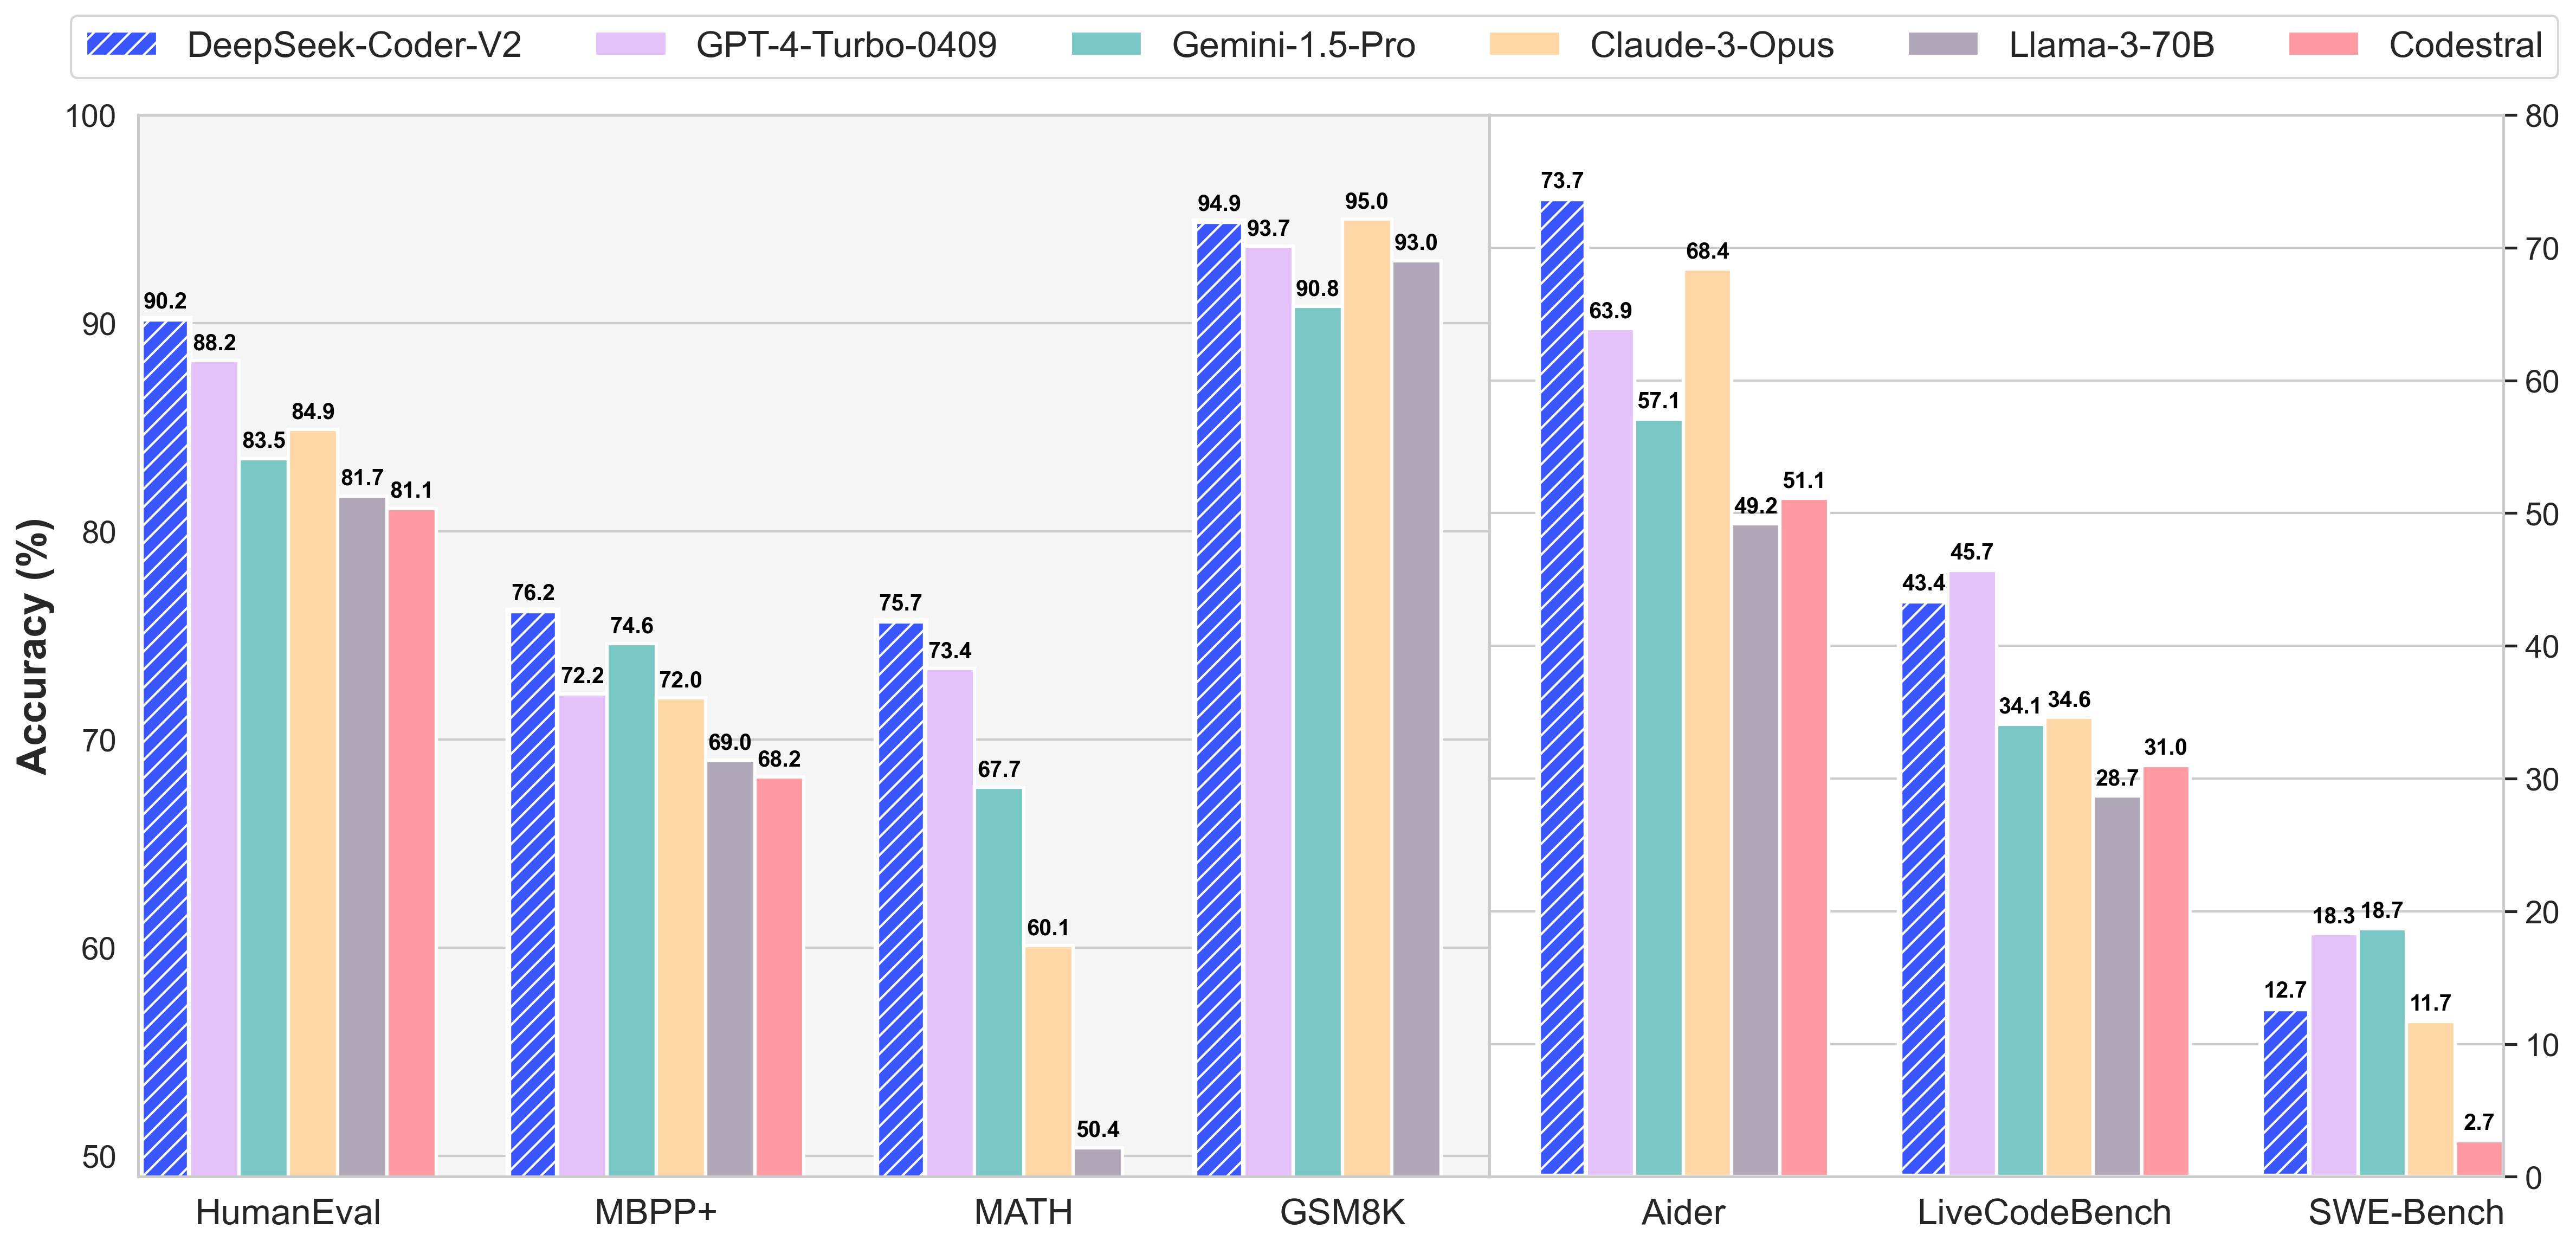
DeepSeek-Coder-V2 与 GPT-4-Turbo、Claude 3 Opus、Gemini 1.5 Pro 的对比:
三、环境要求
- BF16 完整 236B 模型:README 明确需 80GB×8 张 GPU。
- 16B Lite 版:单卡 24GB 即可。
- Python 3.8+、PyTorch、transformers(trust_remote_code)。
- SGLang/vLLM 推荐用于生产部署。
四、完整部署步骤
1. 选择模型
| 模型 | 总参 | 激活 | 上下文 |
|---|---|---|---|
| Coder-V2-Lite-Base | 16B | 2.4B | 128K |
| Coder-V2-Lite-Instruct | 16B | 2.4B | 128K |
| Coder-V2-Base | 236B | 21B | 128K |
| Coder-V2-Instruct | 236B | 21B | 128K |
2. Transformers 代码补全
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
tokenizer = AutoTokenizer.from_pretrained("deepseek-ai/DeepSeek-Coder-V2-Lite-Base", trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    "deepseek-ai/DeepSeek-Coder-V2-Lite-Base",
    trust_remote_code=True, torch_dtype=torch.bfloat16).cuda()
inputs = tokenizer("#write a quick sort algorithm", return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_length=128)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
3. Transformers 对话
tokenizer = AutoTokenizer.from_pretrained("deepseek-ai/DeepSeek-Coder-V2-Lite-Instruct", trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    "deepseek-ai/DeepSeek-Coder-V2-Lite-Instruct",
    trust_remote_code=True, torch_dtype=torch.bfloat16).cuda()
messages=[{"role":"user","content":"write a quick sort algorithm in python."}]
inputs = tokenizer.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt").to(model.device)
outputs = model.generate(inputs, max_new_tokens=512, do_sample=False, top_k=50, top_p=0.95,
                         num_return_sequences=1, eos_token_id=tokenizer.eos_token_id)
print(tokenizer.decode(outputs[0][len(inputs[0]):], skip_special_tokens=True))
4. 用 SGLang 启动 OpenAI 兼容服务
BF16、8 卡张量并行:
python3 -m sglang.launch_server \
  --model deepseek-ai/DeepSeek-Coder-V2-Instruct \
  --tp 8 --trust_remote-code
Lite 版启用 torch.compile:
python3 -m sglang.launch_server \
  --model deepseek-ai/DeepSeek-Coder-V2-Lite-Instruct \
  --trust-remote-code --enable-torch-compile
FP8 版本:
python3 -m sglang.launch_server \
  --model neuralmagic/DeepSeek-Coder-V2-Instruct-FP8 \
  --tp 8 --trust-remote-code --kv-cache-dtype fp8_e5m2
调用:
import openai
client = openai.Client(base_url="http://127.0.0.1:30000/v1", api_key="EMPTY")
resp = client.chat.completions.create(
    model="default",
    messages=[{"role":"user","content":"List 3 countries and their capitals."}],
    temperature=0, max_tokens=64)
print(resp)
5. 用 vLLM 批量推理
from transformers import AutoTokenizer
from vllm import LLM, SamplingParams
model_name = "deepseek-ai/DeepSeek-Coder-V2-Lite-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
llm = LLM(model=model_name, tensor_parallel_size=1, max_model_len=8192,
          trust_remote_code=True, enforce_eager=True)
sp = SamplingParams(temperature=0.3, max_tokens=256, stop_token_ids=[tokenizer.eos_token_id])
prompts = [tokenizer.apply_chat_template([{"role":"user","content":"Who are you?"}], add_generation_prompt=True)]
print([o.outputs[0].text for o in llm.generate(prompt_token_ids=prompts, sampling_params=sp)])
五、使用方法
Chat 模板
<|begin▁of▁sentence|>User: {msg1}
Assistant: {ans1}<|end▁of▁sentence|>User: {msg2}
Assistant:
最后一轮 Assistant: 后不要加空格,否则 Lite 版可能出中英混杂、乱码、重复。
在线 API
DeepSeek 平台提供 OpenAI 兼容 API,按 token 计费。
关键性能
- HumanEval 90.2、MBPP+ 76.2、LiveCodeBench 43.4;
- AIME 2024 4/30;
- 128K 长上下文。
六、常见问题 FAQ
1. 236B 一张卡够吗? 不够,BF16 需 8×80GB。
2. 旧版 Ollama 出中文答英文题? 是 chat 模板空格 bug,升级 Ollama 即可。
3. 支持多少语言?
338 种,列表见 supported_langs.txt。
4. 与 V1(DeepSeek-Coder-33B)比? V2 全面提升:HumanEval 79.3→90.2,上下文 16K→128K。
5. 支持商用吗? 代码 MIT;模型遵循 Model License,支持商用。
6. vLLM 怎么部署? README 推荐 SGLang;vLLM 需合并对应 PR,见 https://github.com/vllm-project/vllm/pull/4650 。
七、跳转链接
- GitHub 仓库:https://github.com/deepseek-ai/DeepSeek-Coder-V2
- Hugging Face:https://huggingface.co/deepseek-ai
- 在线对话:https://chat.deepseek.com
- API 平台:https://platform.deepseek.com
- 论文:https://arxiv.org/abs/2406.11931