本文面向希望在本地或服务器上跑通 Agent Lightning v1.0 的工程实践者,完整记录从环境准备、依赖安装、组件配置到启动验证、接口调用的全过程。项目以"简单优先"为第一原则,核心代码约 3500 行 Python,非常适合作为入门多智能体强化学习训练的起点。无论是算法研究者想复现一个干净可控的实验闭环,还是工程团队希望把已有智能体接入强化学习迭代,这套框架都能显著降低搭建门槛。
一、项目介绍
Agent Lightning 是微软开源的轻量多智能体强化学习训练框架,采用 MIT 许可证发布。它解决的核心问题是:如何在不修改现有智能体业务代码的前提下,用真实的运行环境(harness)对智能体进行强化学习训练。
与传统的大语言模型后训练不同,智能体在实际工作中会调用工具、维护上下文、执行控制流,并与外部环境反复交互。这种多轮、带工具、带环境反馈的轨迹,和单纯在静态数据集上做监督微调差别很大。Agent Lightning 通过在智能体与模型之间插入一层代理,把这些真实交互完整地捕获下来,转化为可用于策略更新的训练样本,让模型在不断试错中学会更合理地规划和调用工具。
官方强调,基于 LangChain、AutoGen、OpenAI Agent SDK 等框架编写的智能体,可以做到零改造接入训练流程,工具、上下文、控制流和环境都继续保留在闭环之中。这意味着你不需要为了训练而把智能体重写成某种特殊格式,原本怎么在线上运行,训练时就怎么运行。
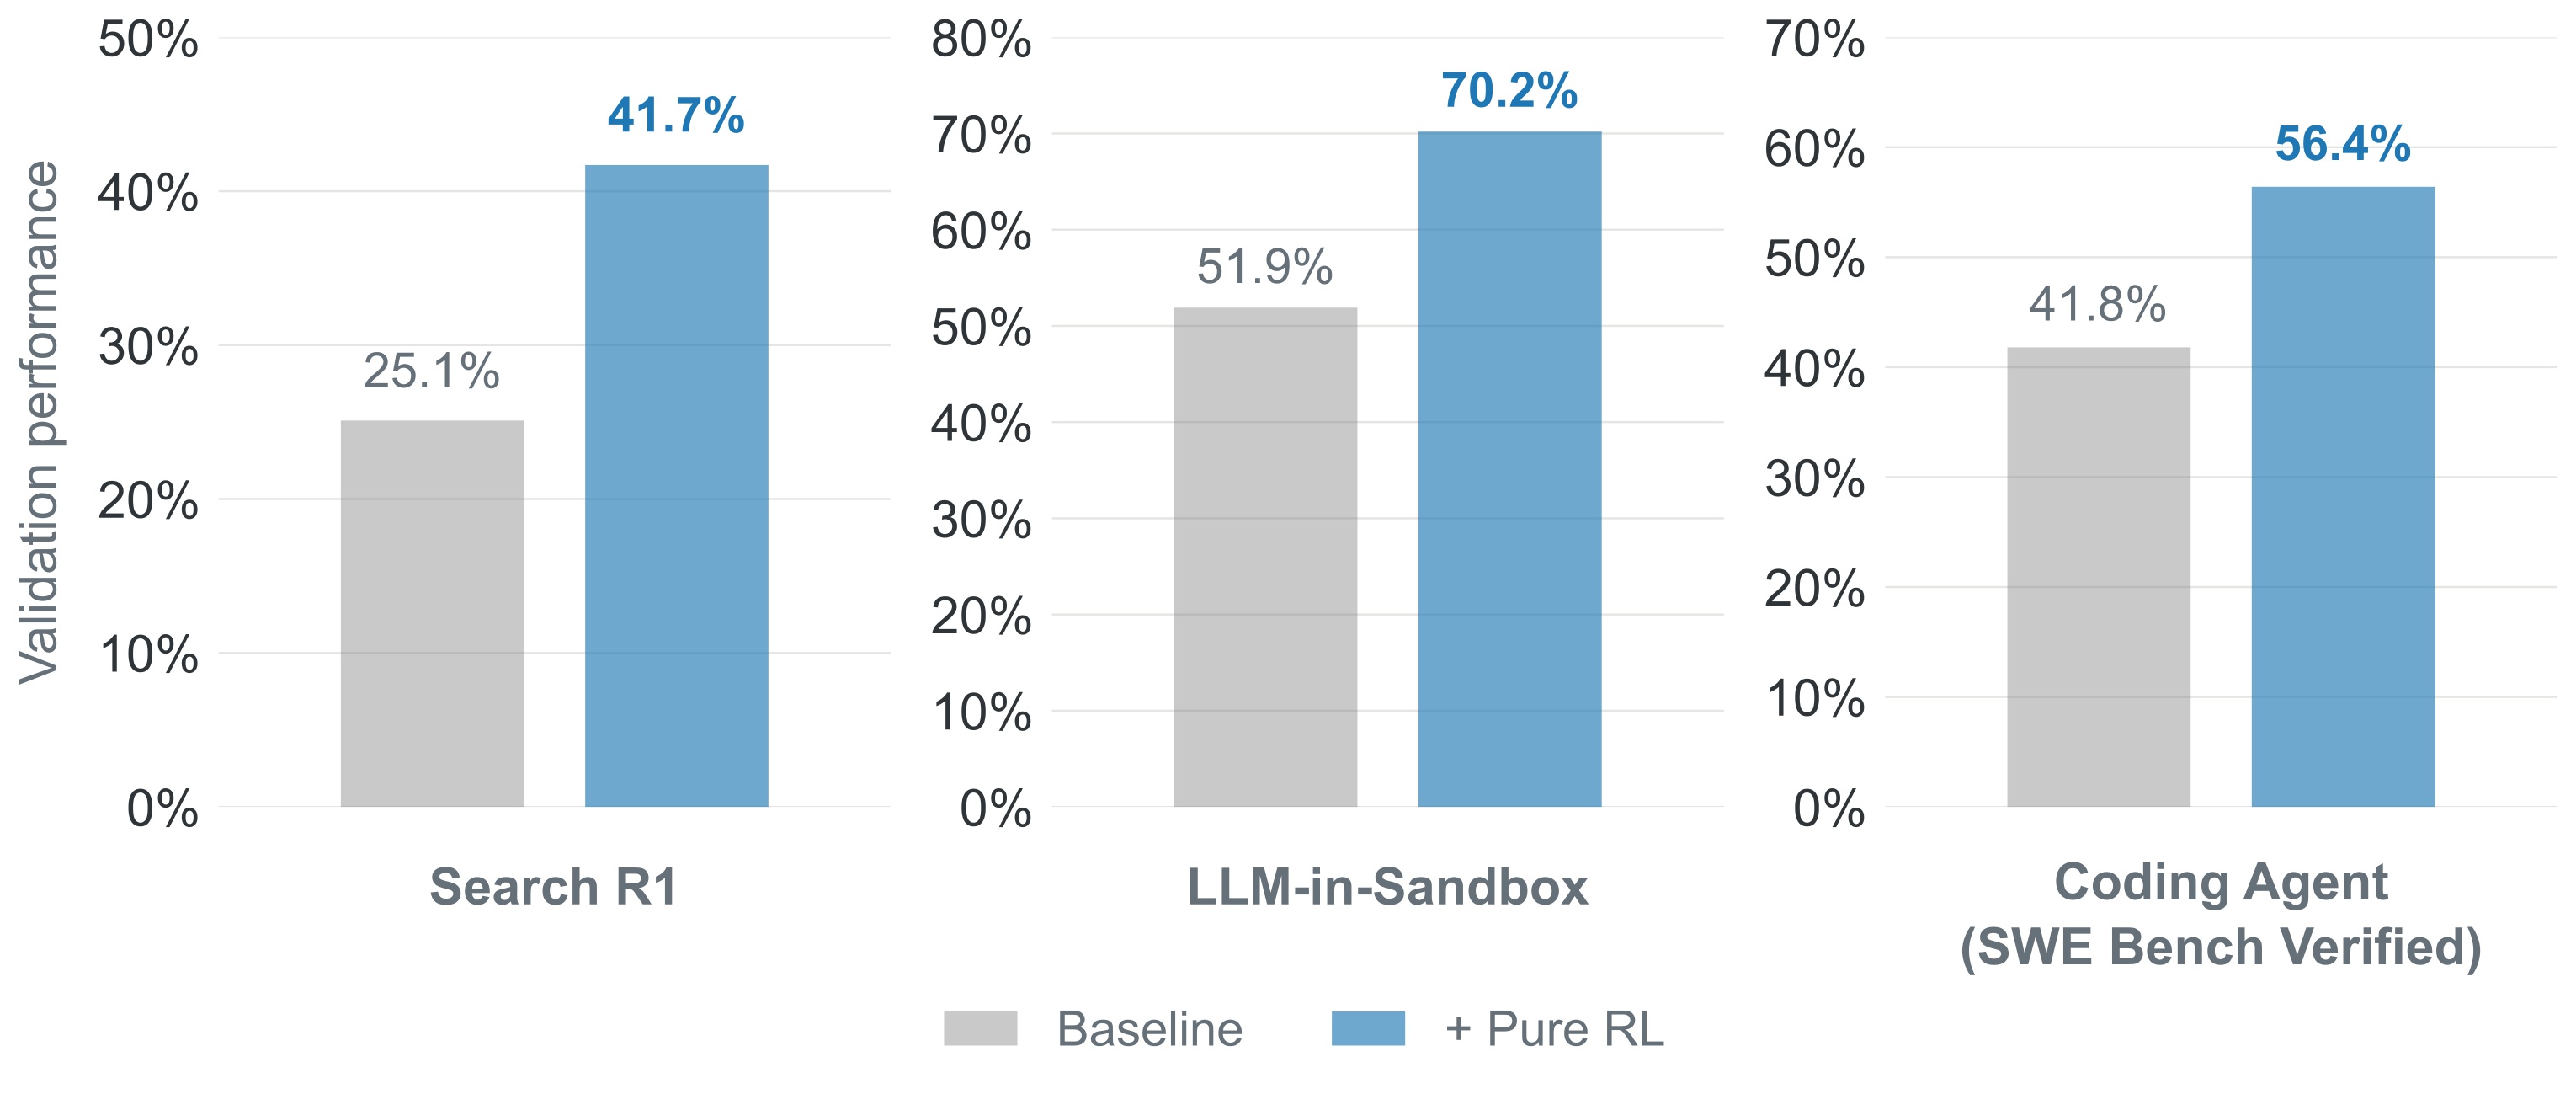
项目在 v1.0 版本进行了完全重构,早期 v0.x 的历史版本请参考单独分支。官方技术报告见 arXiv:2608.17528,完整文档站位于 microsoft.github.io/agent-lightning。2026 年 8 月项目开源,同年 9 月发布了基于 MoE 模型的 coding agent 示例:仅用 1.8K 训练样本,纯强化学习就把 Qwen3.5-35B-A3B 在 SWE-bench Verified 上的成绩从 47.8% 提升到 61.6%;另一个基于 Qwen3.5-9B 的端到端流程则用约 6K 样本,把同一基准从 41.8% 提升到 56.4%。
从官方公布的评测来看,纯强化学习在搜索、沙箱内通用智能体、编程智能体等多个实际训练领域都带来了可观的提升,说明这套采集与训练闭环具有良好的通用性,而不是只能在单一任务上奏效。
二、项目结构与三大核心组件
Agent Lightning v1.0 刻意保持训练架构的简洁,整个系统由三个轻量组件构成。Trainer 创建 rollout(采样回合),Rollout Controller 负责拉起智能体,API Gateway 把智能体与模型之间的交互记录成训练数据,而智能体本身仍然运行在它真实的 harness 里。三者通过网络协作,职责边界清晰,既可以在一台机器上协同调试,也可以拆开到不同节点上扩展。
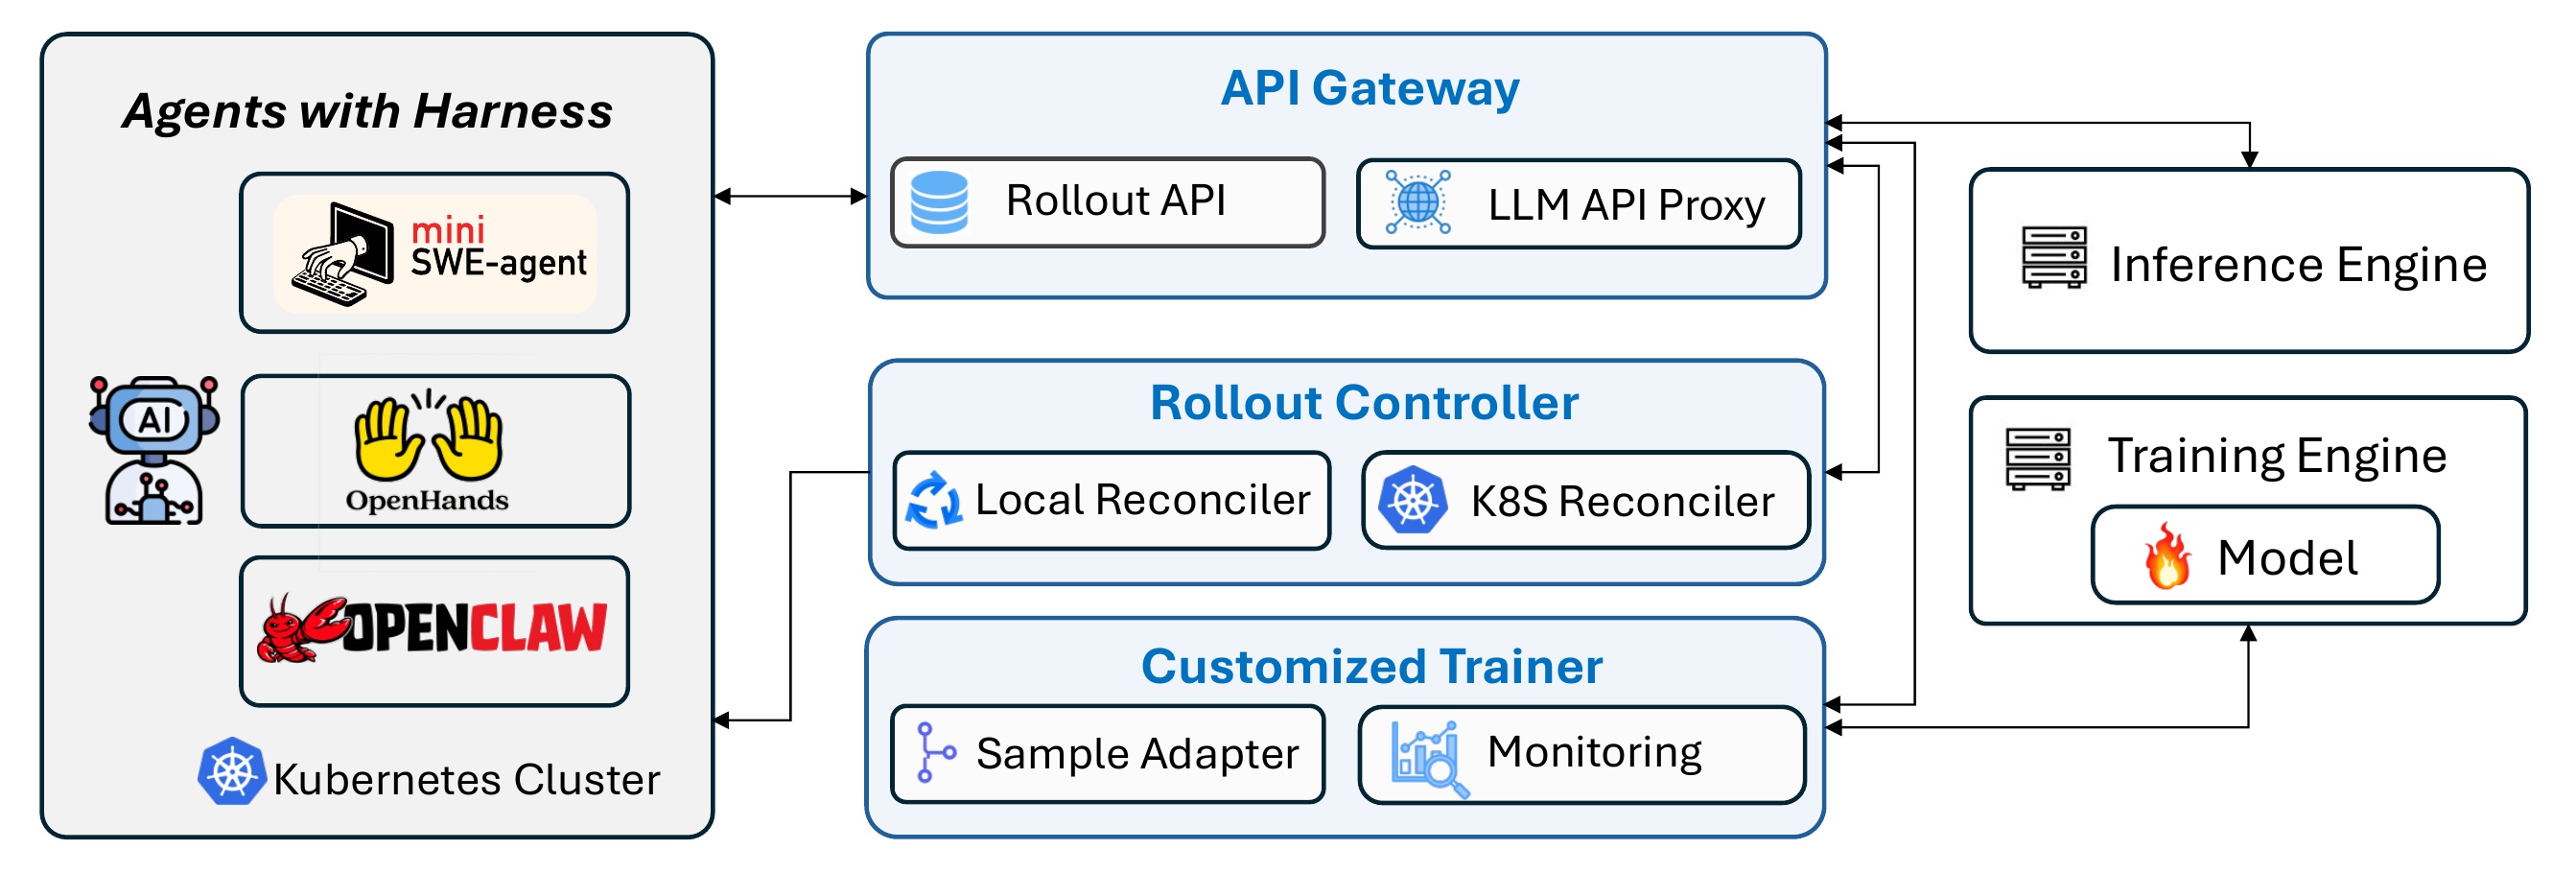
Trainer(训练器):底层运行 verl 与 vLLM,负责构建训练样本并更新策略参数。它是整个训练循环的驱动方,按配置发起一轮轮 rollout,并在收集到足够轨迹后进行聚合、计算奖励、执行策略更新。训练节奏、采样并行度、奖励函数对接都在这里配置。
API Gateway(接口网关):位于智能体与模型服务之间,代理所有发往模型的请求,同时把请求与响应完整捕获下来作为训练数据。智能体只需要把模型接口地址指向 Gateway,无需感知训练流程的存在。它对外保持与 OpenAI 兼容的协议,这是实现零改造接入的关键。
Rollout Controller(采样控制器):负责实际运行智能体。它既可以在本机直接以进程方式拉起 agent,也可以把 agent 作为 Kubernetes Job 调度到集群中执行,从而实现大规模并行采样。当需要同时跑成百上千条采样轨迹时,这种调度能力尤为重要。
数据流上可以这样理解:Trainer 决定"现在要采多少条样本",Controller 据此并行启动多个智能体进程或 Job,智能体在执行任务过程中不断向模型发请求,这些请求全部经过 Gateway 并被记录,任务结束后由环境或评测器给出奖励,最终一条完整的多轮轨迹连同奖励一起回流给 Trainer 用于更新策略。
三、版本与环境要求
开始部署前,请先确认机器满足以下基础条件。官方给出的示例安装基于一台 CUDA 13.0 的 GPU 机器,实际生产中可根据模型规模调整显卡数量。
- 操作系统:Linux,推荐 Ubuntu 22.04 及以上,内核版本需满足 GPU 驱动要求。
- Python 与包管理:使用 uv 作为依赖管理与虚拟环境工具,一条
uv sync即可按锁文件装好全部依赖。 - GPU 与 CUDA:示例环境为 CUDA 13.0;不同 CUDA 版本在安装 verl 时通过脚本参数区分。
- 训练栈:verl 0.8.0 配合 vLLM 作为训练与推理后端,由仓库提供的脚本自动完成安装与编译。
- 容器编排(可选):原生支持 Kubernetes,用于把智能体作为 Job 大规模并行调度;仅做本地验证时可不安装。
需要特别注意,v1.0 是一次完全重构,命令行参数、配置文件结构与 v0.x 不兼容,旧项目迁移时请对照新版文档逐步调整,不要直接沿用老配置。网络方面,训练机需要能够访问 GitHub 与 PyPI 以下载依赖,国内环境可提前配置好镜像加速。
四、本地部署步骤
下面以一台已装好 NVIDIA 驱动、CUDA 13.0 的机器为例,完整走通本地首次运行。建议全程在同一个 uv 虚拟环境中操作,避免 Python 版本混乱。
步骤一:克隆仓库并进入目录。从 GitHub 拉取 main 分支代码:
git clone https://github.com/microsoft/agent-lightning.git
cd agent-lightning
步骤二:用 uv 同步基础依赖。uv 会根据仓库内的锁文件创建虚拟环境并安装 Python 依赖,过程通常比传统 pip 快很多:
uv sync步骤三:安装 verl 与 GPU 栈。仓库提供了一键脚本,第一个参数是 verl 版本,第二个参数是 CUDA 标识。CUDA 13.0 机器执行:
bash scripts/setup_verl.sh 0.8.0 cu130如果你的机器是其他 CUDA 版本,把 cu130 换成对应的标识即可。脚本会编译与 GPU 相关的扩展,耗时较长,期间请保持网络稳定。详细说明见官方安装指南。
步骤四:阅读快速开始并配置组件。安装完成后,建议先跑通最小示例。官方 Quick Start 会引导你在本机完成一次端到端的 rollout:分别配置 Trainer、API Gateway 与 Rollout Controller 的地址与端口,确认三者之间网络互通。组件配置项可参考文档中的 Trainer 配置、Gateway 配置与Controller 配置页面。初次尝试时,建议先把并行度调到最低,确认流程跑通再逐步放大。
步骤五:按顺序启动服务。推荐的启动顺序是先启动 API Gateway,再启动 Rollout Controller,最后拉起 Trainer。顺序很重要:智能体要通过 Gateway 才能请求模型,而 Controller 需要知道 Gateway 的地址;Trainer 则要等前两者就绪后才能发起 rollout。
步骤六:观察日志并验证。Trainer 发起 rollout 后,Controller 拉起智能体,智能体通过 Gateway 请求模型,Gateway 记录交互。当日志中出现轨迹被成功聚合、奖励被正确计算、策略更新完成一轮时,说明本地训练链路已经打通。想先在单卡上验证流程,可以从只需要一块 GPU 的 Calc-X 示例入手,它基于 AutoGen 与 MCP 计算器工具,是一个非常轻量的概念验证。
五、浏览器端与集群部署
Agent Lightning 本身以服务进程方式运行,没有传统意义上的图形化控制台,但官方提供了完整的文档站点来辅助配置与运维。部署完成后,你可以通过浏览器访问 在线文档站,对照各组件配置说明逐项检查参数,遇到字段含义不清时直接查阅对应章节即可。
当采样规模扩大、需要同时跑成百上千个智能体回合时,应把 Rollout Controller 切换到 Kubernetes 模式。此时智能体被封装成 K8s Job 提交到集群,由集群调度器自动分发到不同节点执行。如果你已经在集群上部署了 K8s Dashboard,就可以在浏览器里直接观察这些 Job 的创建、运行与结束状态,配合节点资源使用情况判断并行度是否合理、是否存在节点积压。文档中的异步训练章节还介绍了协同部署下的异步采集与暂停、排空机制,帮助你在不中断训练的情况下从容扩缩容。
六、API 用法(Gateway 代理端点)
接入现有智能体最关键的一步,是把智能体里发往大模型的 Base URL 指向 API Gateway。Gateway 对外暴露与 OpenAI 兼容的接口,因此现有基于 OpenAI SDK 的智能体几乎不需要改动代码,只换地址即可继续运行,同时自动进入训练数据采集链路。
启动 Gateway 后,可以先用 curl 直接验证代理端点是否正常工作。把下面的地址换成你本机 Gateway 实际监听的端口,模型名换成已加载的模型:
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen3.5-9B",
    "messages": [{"role": "user", "content": "用一句话介绍强化学习"}]
  }'
请求会经 Gateway 转发到底层 vLLM 推理服务,同时这轮交互会被记录下来,成为后续 Trainer 聚合训练样本的来源。在你的业务智能体里,只需把客户端初始化时的 base_url 改成 Gateway 地址、api_key 按配置填写,智能体的工具调用、多轮对话逻辑即可原样保留。
对于多轮工具调用的场景,智能体会在一次任务中连续多次请求 Gateway,Gateway 会把同一条轨迹内的多次请求关联起来,保证训练时能还原出完整的对话与工具调用顺序,而不是把它们当成孤立的单轮请求。更多代理与模型路由设置见 API Gateway 配置文档。
七、常见问题 FAQ
问一:我现有的智能体需要大改代码才能训练吗?
不需要。Agent Lightning 的设计目标就是零改造接入。你只需把智能体请求模型的地址指向 Gateway,工具、上下文、控制流和环境都继续在原 harness 中运行,框架在后台静默采集轨迹,业务代码一行都不用动。
问二:一定要用 Kubernetes 吗?
不一定。Rollout Controller 同时支持本地进程模式和 K8s Job 模式。个人开发、算法验证阶段用本地模式即可;需要大规模并行采样、多节点扩展时再切换到 Kubernetes,两种模式共用同一套智能体代码。
问三:CUDA 版本和示例里的 13.0 不一样怎么办?
安装脚本的第二个参数用于区分 CUDA 构建。按你机器实际的 CUDA 版本替换 cu130 即可,其他步骤不变。建议以官方安装指南列出的可选标识为准,不要自行猜测编号。
问四:v0.x 老项目能直接升级到 v1.0 吗?
v1.0 是完全重构,配置与接口不兼容,不能原地升级。仍需使用旧版本的团队请留在 v0.x 分支继续维护;新项目建议直接基于 main 分支的 v1.0 开始,以免背负历史包袱。
问五:显存不足跑不起来怎么办?
可以从最小示例开始,例如 Calc-X 官方说明仅需一块 GPU 即可跑通。确认链路无误后,再逐步放大模型与并行度;多卡、大模型场景参考 coding agent 与 MoE 示例中给出的资源配置与并行策略,避免一上来就加载超大模型导致 OOM。
总体而言,Agent Lightning v1.0 把过去需要自己拼装的采样、捕获、聚合、训练流程收敛成三个职责清晰的轻量组件,让团队可以把精力集中在任务设计与奖励工程上,而不是反复搭建训练脚手架。建议初次使用时从 Calc-X 或 GSM8K 这类单卡小例子跑通全链路,再迁移到自己的真实智能体上。
相关链接