
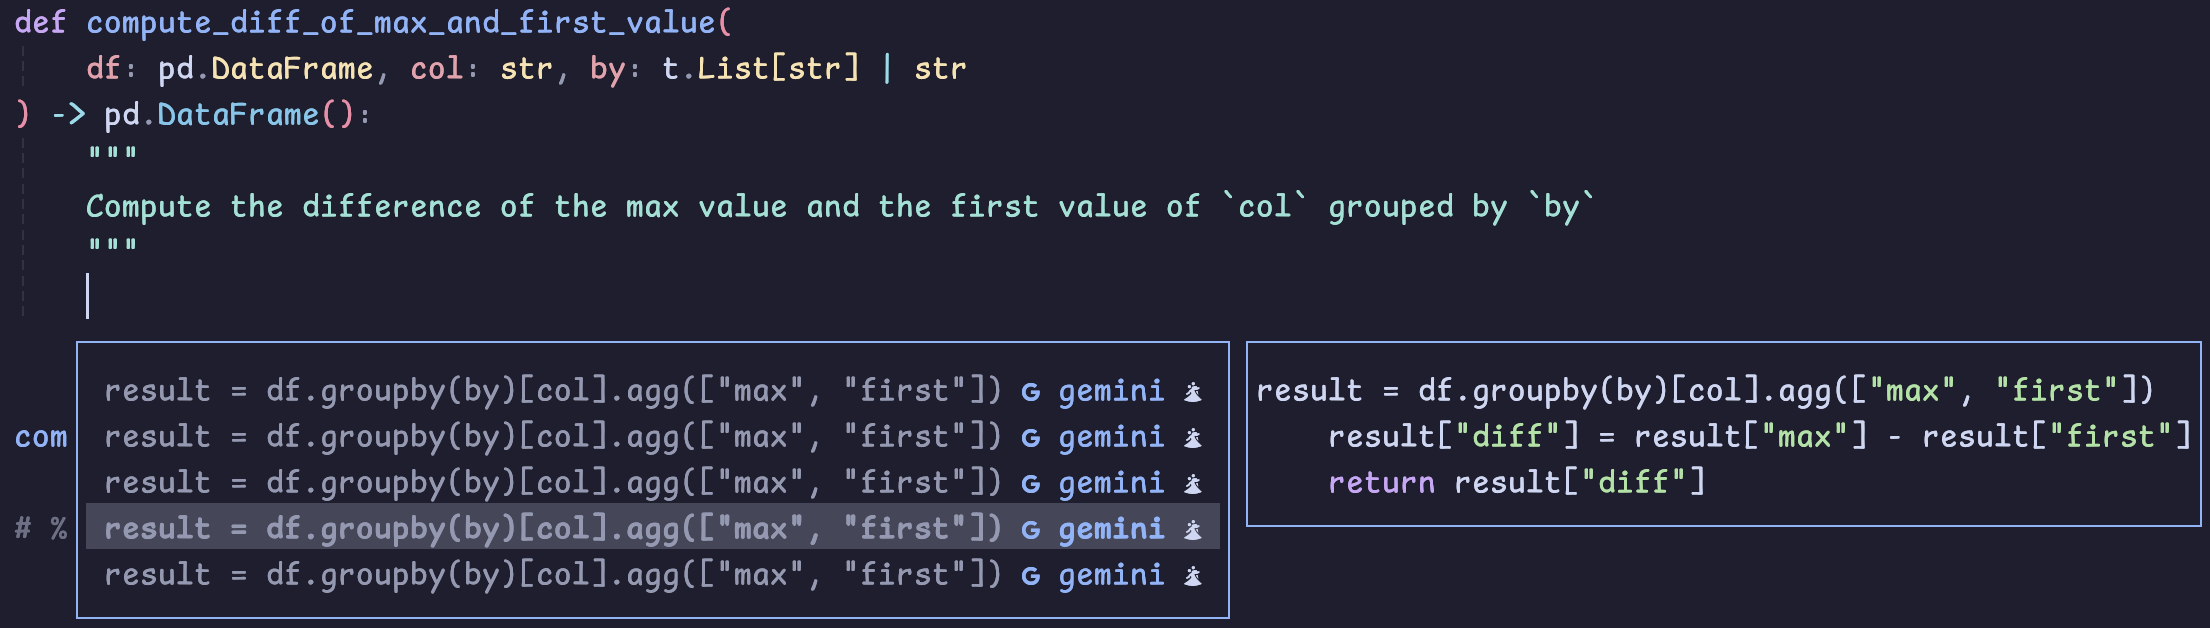
官方信息
| 项目名称 | minuet-ai.nvim(小步舞曲) |
| 仓库地址 | https://github.com/milanglacier/minuet-ai.nvim |
| 官方网站 | GitHub README 文档 |
| 最新更新时间 | 2026-10-07 |
| 项目定位 | Neovim 上"随敲随补"的 AI 代码补全插件,支持 OpenAI、Claude、Gemini、Codestral、Ollama、Llama.cpp 与任意 OpenAI 兼容服务,无需后台专有二进制 |
项目背景
Minuet(小步舞曲)的口号是 "Dance with Intelligence in Your Code 💃"——像小步舞曲一样,让 AI 补全跟着你的敲键节奏优雅地流动在代码里。它由开发者 milanglacier 维护,目标是做一个不绑定任何模型厂商、不依赖后台专有进程的 Neovim 补全方案。
和 llm.nvim 不同,Minuet 干脆连后端二进制都不要了——它只通过 curl 直接向你选定的 LLM 服务商发 HTTP 请求。这意味着:你用 DeepSeek 官方 API 就填 DeepSeek 的 Key,用本地 Ollama 就填 localhost:11434,用 OpenRouter 聚合就填 OpenRouter 的地址,插件本身不抽成、不缓存、不启动守护进程。
它的另一个特点是"前端兼容":既能作为 nvim-cmp / blink.cmp 的一个补全源,也能以独立的 virtual-text 幽灵文本前端工作,还能当 Neovim 0.11+ 的内置 LSP 补全服务器。最近版本还加入了"Duet 下一行预测"实验特性,以及对 DeepSeek V4、Qwen2.5-Coder 等 FIM 模型的专门适配。
核心特性
- 双补全模式:既支持基于 chat 模型的补全(专门优化的提示词),也支持 FIM(Fill-in-the-Middle)中插补全,适配 DeepSeek、Codestral、Qwen 等模型。
- 多 Provider 支持:OpenAI、Claude、Gemini、Codestral、Ollama、Llama.cpp,以及任何 OpenAI 兼容接口(DeepSeek 官方、OpenRouter、Opencode 等)。
- 无需后台二进制:只用
vim.system调 curl,不再依赖 plenary.nvim,进程干净、易排查。 - 多前端可选:
virtual-text(幽灵文本)、nvim-cmp、blink.cmp、Neovim 内置补全、mini.completion。 - 流式输出:补全可以边生成边显示,慢模型也不卡。
- 逐行接受:长建议可以一行一行增量接受,按自己的节奏拉取。
- 输入同步:当你继续输入的内容和建议开头匹配时,Minuet 会保持补全同步而不是丢弃,减少重复请求。
- Duet 下一行预测:实验性地预测你接下来要编辑的位置(next-edit prediction)。
环境要求
- Neovim:0.10+(内置补全需 0.11+,inline_completion 需 0.12+)。
- 插件管理器:lazy.nvim 推荐;也支持 Rocks.nvim(
Rocks install minuet-ai.nvim)。 - 可选补全前端:nvim-cmp 或 blink.cmp(用 virtual-text 前端则不需要)。
- API Key:至少一个支持的 LLM 服务商的 Key(DeepSeek / OpenRouter / Gemini 等)。
- 本地模型(可选):Ollama 或 llama.cpp 服务。
详细部署步骤
第一步:安装插件
lazy.nvim 用户新建 ~/.config/nvim/lua/plugins/minuet.lua:
return {
  'milanglacier/minuet-ai.nvim',
  config = function()
    require('minuet').setup {
      -- 配置见下方
    }
  end,
  -- 可选:用 nvim-cmp / blink.cmp 作为前端时再加
  -- { 'hrsh7th/nvim-cmp' },
  -- { 'Saghen/blink.cmp' },
}
Rocks.nvim 用户直接在 Nvim 里执行:
:Rocks install minuet-ai.nvim第二步:配置 virtual-text 幽灵文本前端(最省事,推荐)
下面这套配置不依赖 nvim-cmp,直接在光标后显示灰色建议:
require('minuet').setup {
  virtualtext = {
    auto_trigger_ft = {},          -- 想自动触发就填 { 'python', 'lua', 'rust' }
    keymap = {
      accept          = '<A-A>',   -- 接受整段补全
      accept_line     = '<A-a>',   -- 只接受一行
      accept_n_lines   = '<A-z>',   -- 接受 N 行(再按数字+回车)
      prev            = '<A-[>',   -- 上一条建议 / 手动触发
      next            = '<A-]>',   -- 下一条建议 / 手动触发
      dismiss         = '<A-e>',   -- 忽略
    },
  },
}
第三步:配置 Provider(以 DeepSeek 为例)
Minuet 的核心是 provider。下面给出三个最常用方案。
方案 A:DeepSeek 官方 FIM 接口(便宜、快,推荐)
# 先设置环境变量
export DEEPSEEK_API_KEY="sk-xxxxxxxxxxxxxxxx"
require('minuet').setup {
provider = 'openai_fim_compatible',
provider_options = {
openai_fim_compatible = {
api_key = 'DEEPSEEK_API_KEY', -- 填环境变量名,不要硬写 Key
name = 'deepseek',
optional = {
max_tokens = 256,
top_p = 0.9,
},
},
},
}方案 B:OpenRouter 聚合(可白嫖 Gemini 免费额度)
export OPENROUTER_API_KEY="sk-or-xxxxxxxx"require('minuet').setup {
provider = 'openai_compatible',
request_timeout = 2.5,
throttle = 1500, -- 调大省钱、防限流
debounce = 600,
provider_options = {
openai_compatible = {
api_key = 'OPENROUTER_API_KEY',
end_point = 'https://openrouter.ai/api/v1/chat/completions',
model = 'deepseek/deepseek-v4-flash',
name = 'Openrouter',
optional = {
max_tokens = 56,
top_p = 0.9,
provider = { sort = 'throughput' },
reasoning_effort = 'none', -- 关闭思考,降低首 token 延迟
},
},
},
}方案 C:本地 Ollama(完全离线)
ollama pull qwen2.5-coder:7brequire('minuet').setup {
provider = 'openai_fim_compatible',
n_completions = 1, -- 本地模型省资源只出 1 条
context_window = 512, -- 先从小上下文试起
provider_options = {
openai_fim_compatible = {
api_key = 'TERM',
name = 'Ollama',
end_point = 'http://localhost:11434/v1/completions',
model = 'qwen2.5-coder:7b',
optional = { max_tokens = 56, top_p = 0.9 },
},
},
}第四步:(可选)接入 nvim-cmp / blink.cmp
如果你用 nvim-cmp,把 minuet 加进 sources 并调大超时:
require('cmp').setup {
  sources = {
    { name = 'minuet' },
    -- 其他原有 source
  },
  performance = {
    fetching_timeout = 2000,        -- LLM 比 LSP 慢,要调大
  },
  mapping = {
    ['<A-y>'] = require('minuet').make_cmp_map(),  -- 手动触发补全
  },
}
blink.cmp 用户在 sources.default 里加 'minuet',并在 providers.minuet 里把 score_offset = 50 调高优先级即可。
第五步:启动验证
重启 Nvim,新建一个 test.py,输入:
def is_prime(n):
    # 光标停在这里,按 <A-[> 手动触发补全
按 <A-[> 手动召唤建议,灰色 ghost-text 出现后按 <A-A> 接受。常用命令:
:Minuet change_provider—— 切换 Provider。:Minuet change_model—— 切换模型。:Minuet virtualtext—— 开关 virtual-text 前端。:Minuet duet—— 实验性下一行预测。
常见坑与解决办法
- 补全半天出不来:LLM 首 token 延迟高。把
request_timeout调到 2.5s 以上;chat 模型记得关闭 thinking(reasoning_effort='none')。 - nvim-cmp 里输入有明显卡顿:把
fetching_timeout调到 2000,并把 minuet 设为手动触发(从自动 sources 移除)。 - 401 / 认证失败:
api_key字段填的是环境变量名而不是 Key 本身,确认export生效。 - 本地模型补全质量差:从
context_window = 512起步,确认显存能跑得动qwen2.5-coder:7b。 - 缩进错乱:Neovim 0.11 内置补全有上游 bug,对 Python 这类缩进敏感语言建议只用 virtual-text 前端。
使用方法示例
日常写代码时,敲完函数名和注释后停顿,<A-]> 召唤下一条建议,<A-a> 一行行接受,不合适按 <A-e> 丢掉。需要在多个模型间横评时,用 :Minuet change_provider 一键在 DeepSeek 与 Gemini 之间切换,对比哪个补全更合手。
常见问题 FAQ
Q1:它和 Copilot 哪个便宜?
A:用 DeepSeek FIM 或 OpenRouter 免费模型时成本接近零,且可本地跑;Copilot 需月订阅。
Q2:需要后台常驻一个服务吗?
A:不需要。Minuet 每次补全才发一次 curl 请求,进程退出即停止,不占内存。
Q3:支持中文注释补全吗?
A:支持,chat 模型对中文注释理解很好;FIM 模型则更依赖上下文代码。
Q4:能接公司自建的 OpenAI 网关吗?
A:能。把 end_point 改成公司网关的 /v1/chat/completions 地址即可。
跳转链接
- GitHub 仓库:https://github.com/milanglacier/minuet-ai.nvim
- nvim-cmp:https://github.com/hrsh7th/nvim-cmp
- blink.cmp:https://github.com/Saghen/blink.cmp
- DeepSeek 开放平台:https://platform.deepseek.com
- OpenRouter:https://openrouter.ai
- Ollama:https://ollama.com