官方信息表
| 项目 | 说明 |
|---|---|
| 项目名称 | Zstandard(命令行名为 zstd) |
| 一句话定位 | 快速的无损压缩算法,目标在实时压缩场景下达到 zlib 级或更好的压缩率 |
| 所属组织 | Meta(Facebook) |
| 代码仓库 | facebook/zstd |
| 实现语言 | C |
| 官方网站 | facebook.github.io/zstd |
| 格式标准 | RFC 8878 |
| 开源协议 | BSD 或 GPLv2 双许可 |
| 命令行产物 | .zst、.gz、.xz、.lz4 文件 |
配图

项目背景
Zstandard,简称 zstd,是 Meta 开源的一个快速无损压缩算法。README 在开篇就给出了它的目标:“a fast lossless compression algorithm, targeting real-time compression scenarios at zlib-level and better compression ratios.” 也就是说,它想在“实时可用的速度”和“比 zlib 更好的压缩率”之间取得平衡——既有接近 LZ4 那种极快的速度档,也有更高压缩率的档位,让你按场景自己选。
它在 64 位系统上提供基于 Huff0 的 Huff0 熵编码,并配套一个 libzstd 静态/动态库,同时附带 zstd 命令行。README 强调它的压缩格式是稳定的、已写入 RFC 8478,今天压出来的 .zst 文件将来都能被兼容实现解压。它还通过 Google 的 oss-fuzz 持续做模糊测试,对畸形输入的鲁棒性有保障。这意味着你可以放心把它用在长期归档、跨系统交换数据这类对稳定性要求高的场景里。
日常命令行用法很简单:zstd 文件 就把它压成 文件.zst,zstd -d 文件.zst 解压;zstd -19 文件 用更高压缩级别压得更小;zstd -1 --fast 文件 走最快档;cat 日志 | zstd > 日志.zst 可以接管道做流式压缩。README 还说明它兼容多线程:-T0 让它自动用满 CPU 核数,多核大文件压缩能快很多。这种“一条命令搞定、速度和压缩率可调、还自动多核”的特点,让它逐渐替代 gzip 成为新机器上的默认归档工具。
开发者用 libzstd 时,核心 API 是 ZSTD_compress 和 ZSTD_decompress,或流式的 ZSTD_compressStream* 系列,适合在服务端边收边压。它还提供训练字典、自定义内存分配器、高级参数控制,README 的 CONTRIBUTING 里给出了编译、测试、生成 CLI 等完整流程。
总的来说,zstd 是一个把“速度”和“压缩率”做成连续可调档位的现代压缩算法:你可以用 -1 求快、用高等级求小、用 --fast 做实时场景、用字典模式压小数据、用 -T0 多核并行。它在 Meta 和各大云生产环境里经过验证,又被 oss-fuzz 持续加固,是今天做数据压缩时的首选之一。
从压缩级别看,README 给出的对比很直观:级别越高压缩率越好但越慢,负的 --fast 档则反过来。你可以先拿自己的真实数据跑一遍基准,选一个“速度够用、压缩率满意”的档位,而不是盲目用最高级。
无论是命令行归档,还是在服务端用 libzstd 做实时压缩,zstd 都能给出稳定、可调、经过生产验证的表现,是现代 C 生态里压缩领域的代表性项目。
zstd 的背后是一个非常快的熵编码阶段,由作者的 Huff0 和 FSE 库提供。这种把 LZ77 类匹配和现代熵编码结合起来的设计,让它在速度和压缩率上都能打得很出色。README 特别强调,zstd 的格式是稳定的,并且已经写进了 RFC 8878,社区里已经有多种独立实现,本仓库是它的参考实现。
这个参考实现以开源的 C 库形式发布,采用 BSD 或 GPLv2 双许可,同时附带一个命令行工具,能够生成和解码 .zst、.gz、.xz、.lz4 文件。README 还给出了其他编程语言的绑定列表,如果你不想用 C,可以在官网首页找到对应语言的移植。zstd 今天已经部署在 Meta 以及许多大型云基础设施里,用来压缩各种格式和用途的海量数据,并且持续被 Google 的 oss-fuzz 做模糊测试以加固安全。
从实际使用角度看,zstd 的定位是“一个可以按场景调参的压缩工具箱”。如果你追求的是归档备份、冷数据存储这种“尽量小”的目标,可以用高压缩率档位,让 CPU 多花点时间换更小的体积;如果你追求的是日志实时压缩、消息队列、数据库页压缩这种“不能卡住业务”的场景,就用 --fast 这类负档位,把速度拉满、压缩率放低。README 想传达的核心就是:你不需要在“快”和“小”之间二选一,zstd 把这中间的连续档位都铺好了,按自己的延迟和空间预算去选即可。
核心特性逐条翻译
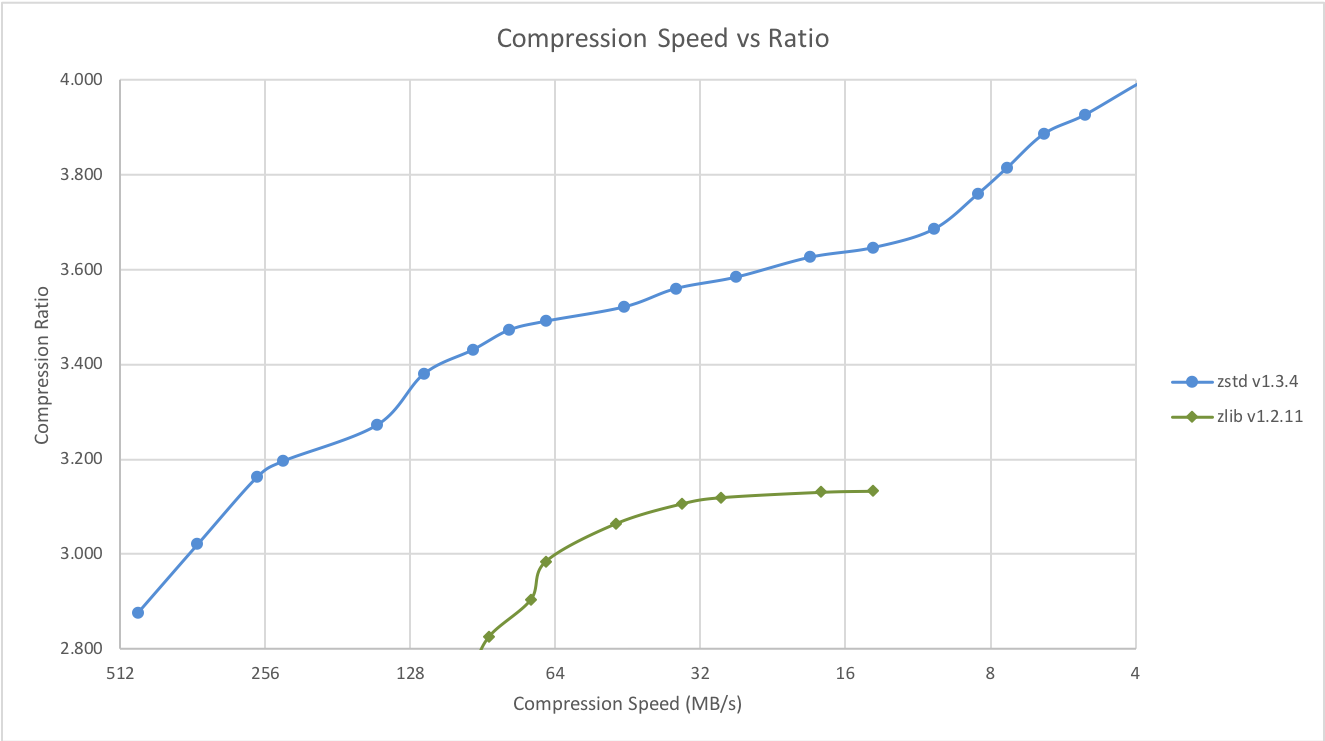
README 用一张基准测试表和一段说明展示了 zstd 的能力,下面逐条翻译并展开。
速度与压缩率可按小档位调节。 README 给出的基准是在一台 Core i7-9700K、Ubuntu 24.04 的机器上,用 lzbench 工具在 Silesia 压缩语料上跑的:zstd 1.5.7 -1 的压缩率约 2.896,压缩速度 510 MB/s,解压速度 1550 MB/s;对比 zlib 1.3.1 -1,压缩率约 2.743,压缩速度只有 105 MB/s,解压 390 MB/s。也就是说,在同样的“快速档”下,zstd 压缩率略好、压缩和解压都快得多。
负压缩级别 --fast=# 提供更快的速度。 README 说明可以用 --fast=# 指定负压缩级别,用更低的压缩率换取更快的压缩和解压速度。例如 --fast=1 压缩率约 2.439,压缩 545 MB/s、解压 1850 MB/s;--fast=4 压缩率约 2.146,压缩 665 MB/s、解压 2050 MB/s。这些档位面向“速度优先”的实时场景。
--fast 档位特别适合那些“压一下是为了少占网络/带宽,但不能让 CPU 卡住业务”的场景:比如实时日志传输、消息队列里的小包压缩。这时候你不在乎多压百分之几,只在乎压和解都别拖慢主流程。
高压缩率档位。 README 同时说明 zstd 也能在牺牲压缩速度的前提下提供更强的压缩率,速度和压缩率的取舍可以按很小的档位调节;而且解压速度在所有设置下都基本保持不变,这是大多数 LZ 类压缩算法(如 zlib、lzma)共有的特性。
这个“解压快、且稳定”的特性非常关键:很多系统和服务都把 zstd 用在“写入时压、读取时解”的链路上,比如日志系统、消息队列、数据库存储。因为解压速度不会随压缩等级升高而明显变慢,你可以在写入时用高等级换小体积,读取时依然享受很快的解压,而不用担心“压得越狠、读得越慢”。
字典训练模式。 README 说明小数据难压,因为压缩算法要从历史数据学习,新数据集开头没有历史可学。zstd 提供训练模式:你给它一批同类小样本(每个样本一个文件),它会训练出一个“字典”,压缩和解压前先加载这个字典,小数据的压缩率就会大幅提升。README 用 github-users 样本集(约 1 万条、每条约 1KB)做了演示,并说明字典越针对特定数据越有效,不存在“万能字典”,所以按数据类型各部署一个字典收益最大。
字典训练的三步法是 README 重点给出的:
# 1. 用训练集创建字典
zstd --train FullPathToTrainingSet/* -o dictionaryName
# 2. 用字典压缩
zstd -D dictionaryName FILE
# 3. 用字典解压
zstd -D dictionaryName --decompress FILE.zst
这种模式在微服务、RPC、物联网小报文场景里价值很大:单独压每个小 JSON/小包都压不动,但用一份事先训练好的字典,就能把小包压得又小又快。
环境要求与部署
zstd 的主构建系统是 make,README 明确建议在构建系统允许时优先用 make;同时也提供了 cmake、meson、vcpkg、conan 等多种方式。
方式一:用 make 编译(官方推荐)
在支持标准 make(或 gmake)的系统上,直接在仓库根目录执行 make,就会在根目录生成 zstd 命令行工具,并在 lib/ 下生成 libzstd 库。其他常用目标包括:
make            # 生成 zstd 与 libzstd
make install    # 安装 zstd 命令行、库和 man 手册
make check      # 在本机做最基本的行为测试
方式二:用 cmake
README 提供了 cmake 工程,仓库根目录现在有一个最小的 CMakeLists.txt,转发到 build/cmake,所以可以直接用标准的 cmake -S .:
cmake -S . -B build-cmake
cmake --build build-cmake
默认 CMAKE_BUILD_TYPE 设为 Release。README 还给出了 macOS 上构建 Universal2(同时支持 Apple Silicon 和 Intel)的命令,用 Ninja 生成并指定 CMAKE_OSX_ARCHITECTURES="x86_64;x86_64h;arm64"。
方式三:包管理器与其他构建方式
README 还列出了:Meson(工程在 build/meson,默认 release)、vcpkg(./vcpkg install zstd)、Conan(conan install --requires="zstd/[*]" --build=missing)、Windows 下的 Visual Studio(推荐从 cmake 生成解决方案)、Buck(buck build programs:zstd)、以及 Bazel(通过 Bazel Central Registry 引入)。
使用方法
最基本的用法就是压缩和解压:
zstd 文件            # 生成 文件.zst
zstd -d 文件.zst     # 解压
字典训练的三步法是 README 重点给出的:
# 1. 用训练集创建字典
zstd --train FullPathToTrainingSet/* -o dictionaryName
# 2. 用字典压缩
zstd -D dictionaryName FILE
# 3. 用字典解压
zstd -D dictionaryName --decompress FILE.zst
如果你想快速验证安装是否正确,可以跑 make check;如果不方便用 make,README 说明可以执行 src/tests 目录下的 playTest.sh,并通过环境变量 $ZSTD_BIN 和 $DATAGEN_BIN 告诉测试脚本 zstd 和 datagen 二进制在哪里。
命令行工具在日常使用里其实非常简单:zstd 文件名 会在同目录生成一个 文件名.zst,默认保留原文件;zstd -d 文件名.zst 把它解压回来。你也可以用 -# 数字指定压缩等级(-1 最快、-19 更高压缩率),或者用 --long 开启更长的匹配窗口来应对大文件。对于想把 zstd 嵌进自己程序的开发者,README 把 libzstd 的模块化构建选项写在了 lib/README.md,把命令行的编译变量写在了 programs/README.md,需要裁剪或定制二进制时去看这两份文件即可。
因为 zstd 同时提供 C 库和命令行,它的使用场景分成两层:日常运维直接用命令行压缩日志、归档文件;开发者则把 libzstd 链进自己的服务,在内存里做实时压缩。无论是哪一层,README 都强调它的格式是稳定的、已写入 RFC,你今天压的数据,将来用任何兼容实现都能解压。
总的来说,zstd 是一个把“速度”和“压缩率”做成连续可调档位的现代压缩算法:你可以用 -1 求快、用高等级求小、用 --fast 做实时场景、用字典模式压小数据。它在 Meta 和各大云生产环境里经过验证,又被 oss-fuzz 持续加固,是今天做数据压缩时的首选之一。
常见问题(FAQ)
问:zstd 和 zlib、lz4 比有什么优势? README 的基准显示:在快速档 -1 下,zstd 压缩率略高于 zlib(约 2.896 对 2.743),但压缩和解压速度都快得多(510/1550 MB/s 对 105/390 MB/s);在速度优先档 --fast=# 下,它又能接近 lz4 的吞吐。你可以按场景在“更快”和“更小”之间选档。
问:为什么压缩小数据效果不好?怎么改善? README 解释:压缩算法要从过去的数据学习,小数据开头没有历史可学,所以天生难压。解决办法是用 zstd 的训练模式:收集一批同类小样本,zstd --train 训练出字典,之后压缩和解压都用 -D 加载这个字典,小数据压缩率会大幅提升。
问:zstd 的格式稳定吗?会变吗? README 明确说明 zstd 格式是稳定的,并已写入 RFC 8878,社区已有多种独立实现,本仓库是参考实现。
问:怎么构建 zstd? README 把 make 作为主构建系统:直接 make 生成 zstd 和 libzstd,make install 安装,make check 测试;也支持 cmake、meson、vcpkg、conan、Visual Studio、buck、bazel 等方式。
问:zstd 的许可证是什么? README 说明 Zstandard 采用 BSD 或 GPLv2 双许可,你可以按自己的需要二选一。开发在 dev 分支进行,不允许直接向 release 分支提交。
问:zstd 的安全性如何? README 说明它已在 Meta 及许多大型云基础设施里压缩海量数据,并且持续被 Google 的 oss-fuzz 做模糊测试,针对安全问题持续加固。
问:zstd 能和 gzip、xz 这些旧格式互操作吗? 命令行工具除了自己的 .zst,README 说明它也能产出和解码 .gz、.xz、.lz4 文件,方便你在已有流程里逐步替换;但跨格式的本质是调用对应后端,最佳体验仍然是用原生的 .zst。
问:想给 zstd 贡献代码,该往哪个分支提? README 说明 dev 分支是所有贡献合并进 release 之前的集成分支,不允许直接向 release 提交,具体流程见 CONTRIBUTING。
跳转链接
- 官方代码仓库:facebook/zstd
- 官方网站与其他语言绑定:facebook.github.io/zstd
- 格式标准:RFC 8878
- 熵编码库:Cyan4973/FiniteStateEntropy
- 模糊测试项目:oss-fuzz/zstd
- vcpkg:Microsoft/vcpkg
- Conan:conan.io
- 压缩率曲线图:CSpeed2.png