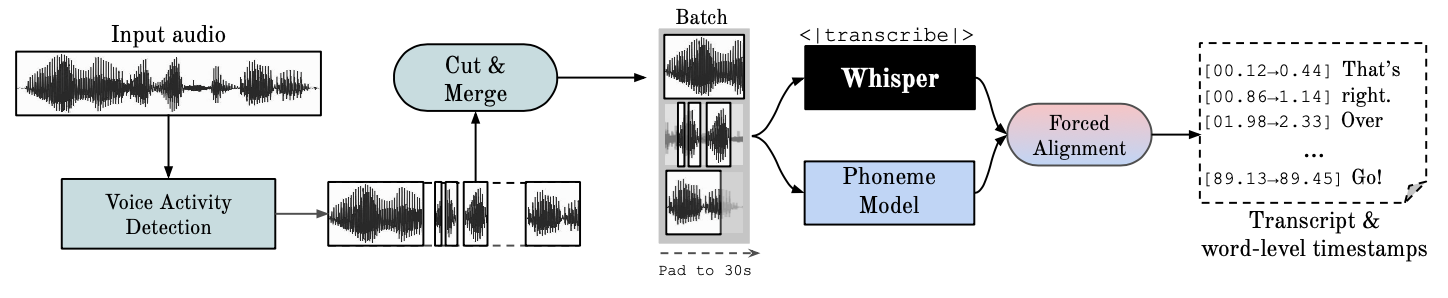


WhisperX:带词级时间戳与说话人分离的快速语音识别|部署与使用全指南
项目仓库: https://github.com/m-bain/whisperX
论文:arXiv:2303.00747 · INTERSPEECH 2023 · 许可证:BSD-4-Clause · 后端:faster-whisper · 对齐:wav2vec2 · 说话人:pyannote-audio
1 项目简介
WhisperX 在 OpenAI Whisper 基础上提供:批处理推理(large-v2 达 70x 实时)、词级时间戳(wav2vec2 强制对齐)、说话人分离(pyannote-audio)、VAD 预处理减少幻觉。large-v2 在 beam_size=5 下显存 <8GB。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | WhisperX |
| 仓库地址 | github.com/m-bain/whisperX |
| 论文 | arXiv:2303.00747 |
| 许可证 | BSD-4-Clause |
| 后端 | faster-whisper |
| 速度 | 70x 实时(large-v2) |
| 显存 | <8GB(large-v2, beam=5) |
| CUDA | 12.8 |
1.2 适用场景
- 带词级时间戳的转录。
- 多人会议转写(说话人分离)。
- 快速批量 ASR。
2 功能特性
- 70x 实时:faster-whisper 批处理。
- 词级时间戳:wav2vec2 强制对齐。
- 说话人分离:pyannote-audio。
- VAD 预处理:减少幻觉。
- 上下文感知批处理(2026):改善标点与专有名词。
3 官方界面预览
开篇图为官方流水线图。
4 官方跳转链接汇总
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库 | github.com/m-bain/whisperX | 源码 |
| faster-whisper | github.com/guillaumekln/faster-whisper | 后端 |
| pyannote-audio | github.com/pyannote/pyannote-audio | 说话人 |
5 前置要求
- CUDA 12.8(GPU 加速)。
- Python。
6 方式一:pip 安装
pip install whisperx或用 uvx 运行。
7 方式二:命令行
whisperx audio.mp3 --model large-v2 --output_dir output8 常见故障排查
- 说话人分离:需 pyannote Hugging Face token。
- CUDA:官方要求 12.8。
9 风险与合规说明
- BSD-4-Clause 许可;说话人分离需授权。
- 不得用于未经授权的录音转写。
本文基于官方 README 整理,仅供学习与部署参考;以仓库最新说明为准。