
版本:v1.0 | 更新日期:2026年10月23日
基于 Gemini three(剧本/分镜/多模态)与 GPT Images two(画面生成)两款核心工具,完整覆盖「小说文本 → 漫剧成片」的全流程:内容构思、环境准备、部署方案、生成步骤、进阶优化与常见问题。附带全部官方跳转链接。
一、视频内容核心解读
原视频《我靠!AI漫剧赛道直接大结局了?》的核心信息可归纳为 5 大能力:
💡 一句话总结:用这两款工具,你只需要写小说,剩下的分镜、画面、成片全部自动完成。
二、两大核心工具介绍
2.1 Gemini three —— 剧本与多模态引擎
定位:Google 出品的多模态大模型,负责理解小说、生成剧本、识别图像与视频。
在漫剧中的角色:读取你上传的小说 → 拆解剧情 → 输出带镜头描述、台词、提示词的分镜剧本;后续还能辅助图片/视频内容识别与一致性校验。
官方入口:https://ai.google.dev/(开发者)|https://gemini.google.com/(网页版)
2.2 GPT Images two —— 画面生成引擎
定位:OpenAI 出品的图像生成/编辑模型,负责把分镜提示词变成具体画面。
在漫剧中的角色:根据分镜描述生成角色三视图、场景图、道具图,并按需切换画风、保持角色形象统一。
官方入口:https://platform.openai.com/docs/guides/images(API 文档)|https://chat.openai.com/(网页版)
三、准备工作(账号与密钥)
3.1 注册账号并获取密钥
⚠️ 密钥属于敏感信息,不要泄露、不要提交到公共仓库。充值/额度管理都在各自的「Billing」页面进行。
3.2 本地环境要求
四、部署方案(云端 / 本地)
方案一:云端部署(推荐,适合批量生产)
云端部署的核心优势是不占本地资源,服务器 7×24 小时在线,适合批量生成多集漫剧。
① 购买并初始化服务器
# 更新系统
sudo apt update && sudo apt upgrade -y

# 安装基础依赖
sudo apt install python3 python3-pip python3-venv nodejs npm git -y
② 创建并激活 Python 虚拟环境
mkdir -p ~/aimanju && cd ~/aimanju
python3 -m venv venv
source venv/bin/activate
③ 配置 API 密钥
# 写入环境变量(二选一:.env 文件或直接 export)
echo "GEMINI_API_KEY=你的_GEMINI密钥" >> .env
echo "OPENAI_API_KEY=你的_OPENAI密钥" >> .env

# 每次启动前加载
set -a; source .env; set +a
④ 启动服务
# 前台启动(调试)
python3 app.py --port 8080

# 后台运行(长期挂机推荐)
nohup python3 app.py --port 8080 >> run.log 2>&1 &
部署完成后,通过
http://服务器IP:8080访问管理界面。建议在云厂商安全组中放行 8080 端口。
方案二:本地部署(适合个人测试 / 低成本)
本地部署不依赖云服务器,但需要一定显卡配置,适合先体验再决定是否上云。
# 1. 安装 Ollama 并拉取本地模型(可选,用于离线剧本)
curl -fsSL https://ollama.com/install.sh | sh
ollama pull qwen3:32b

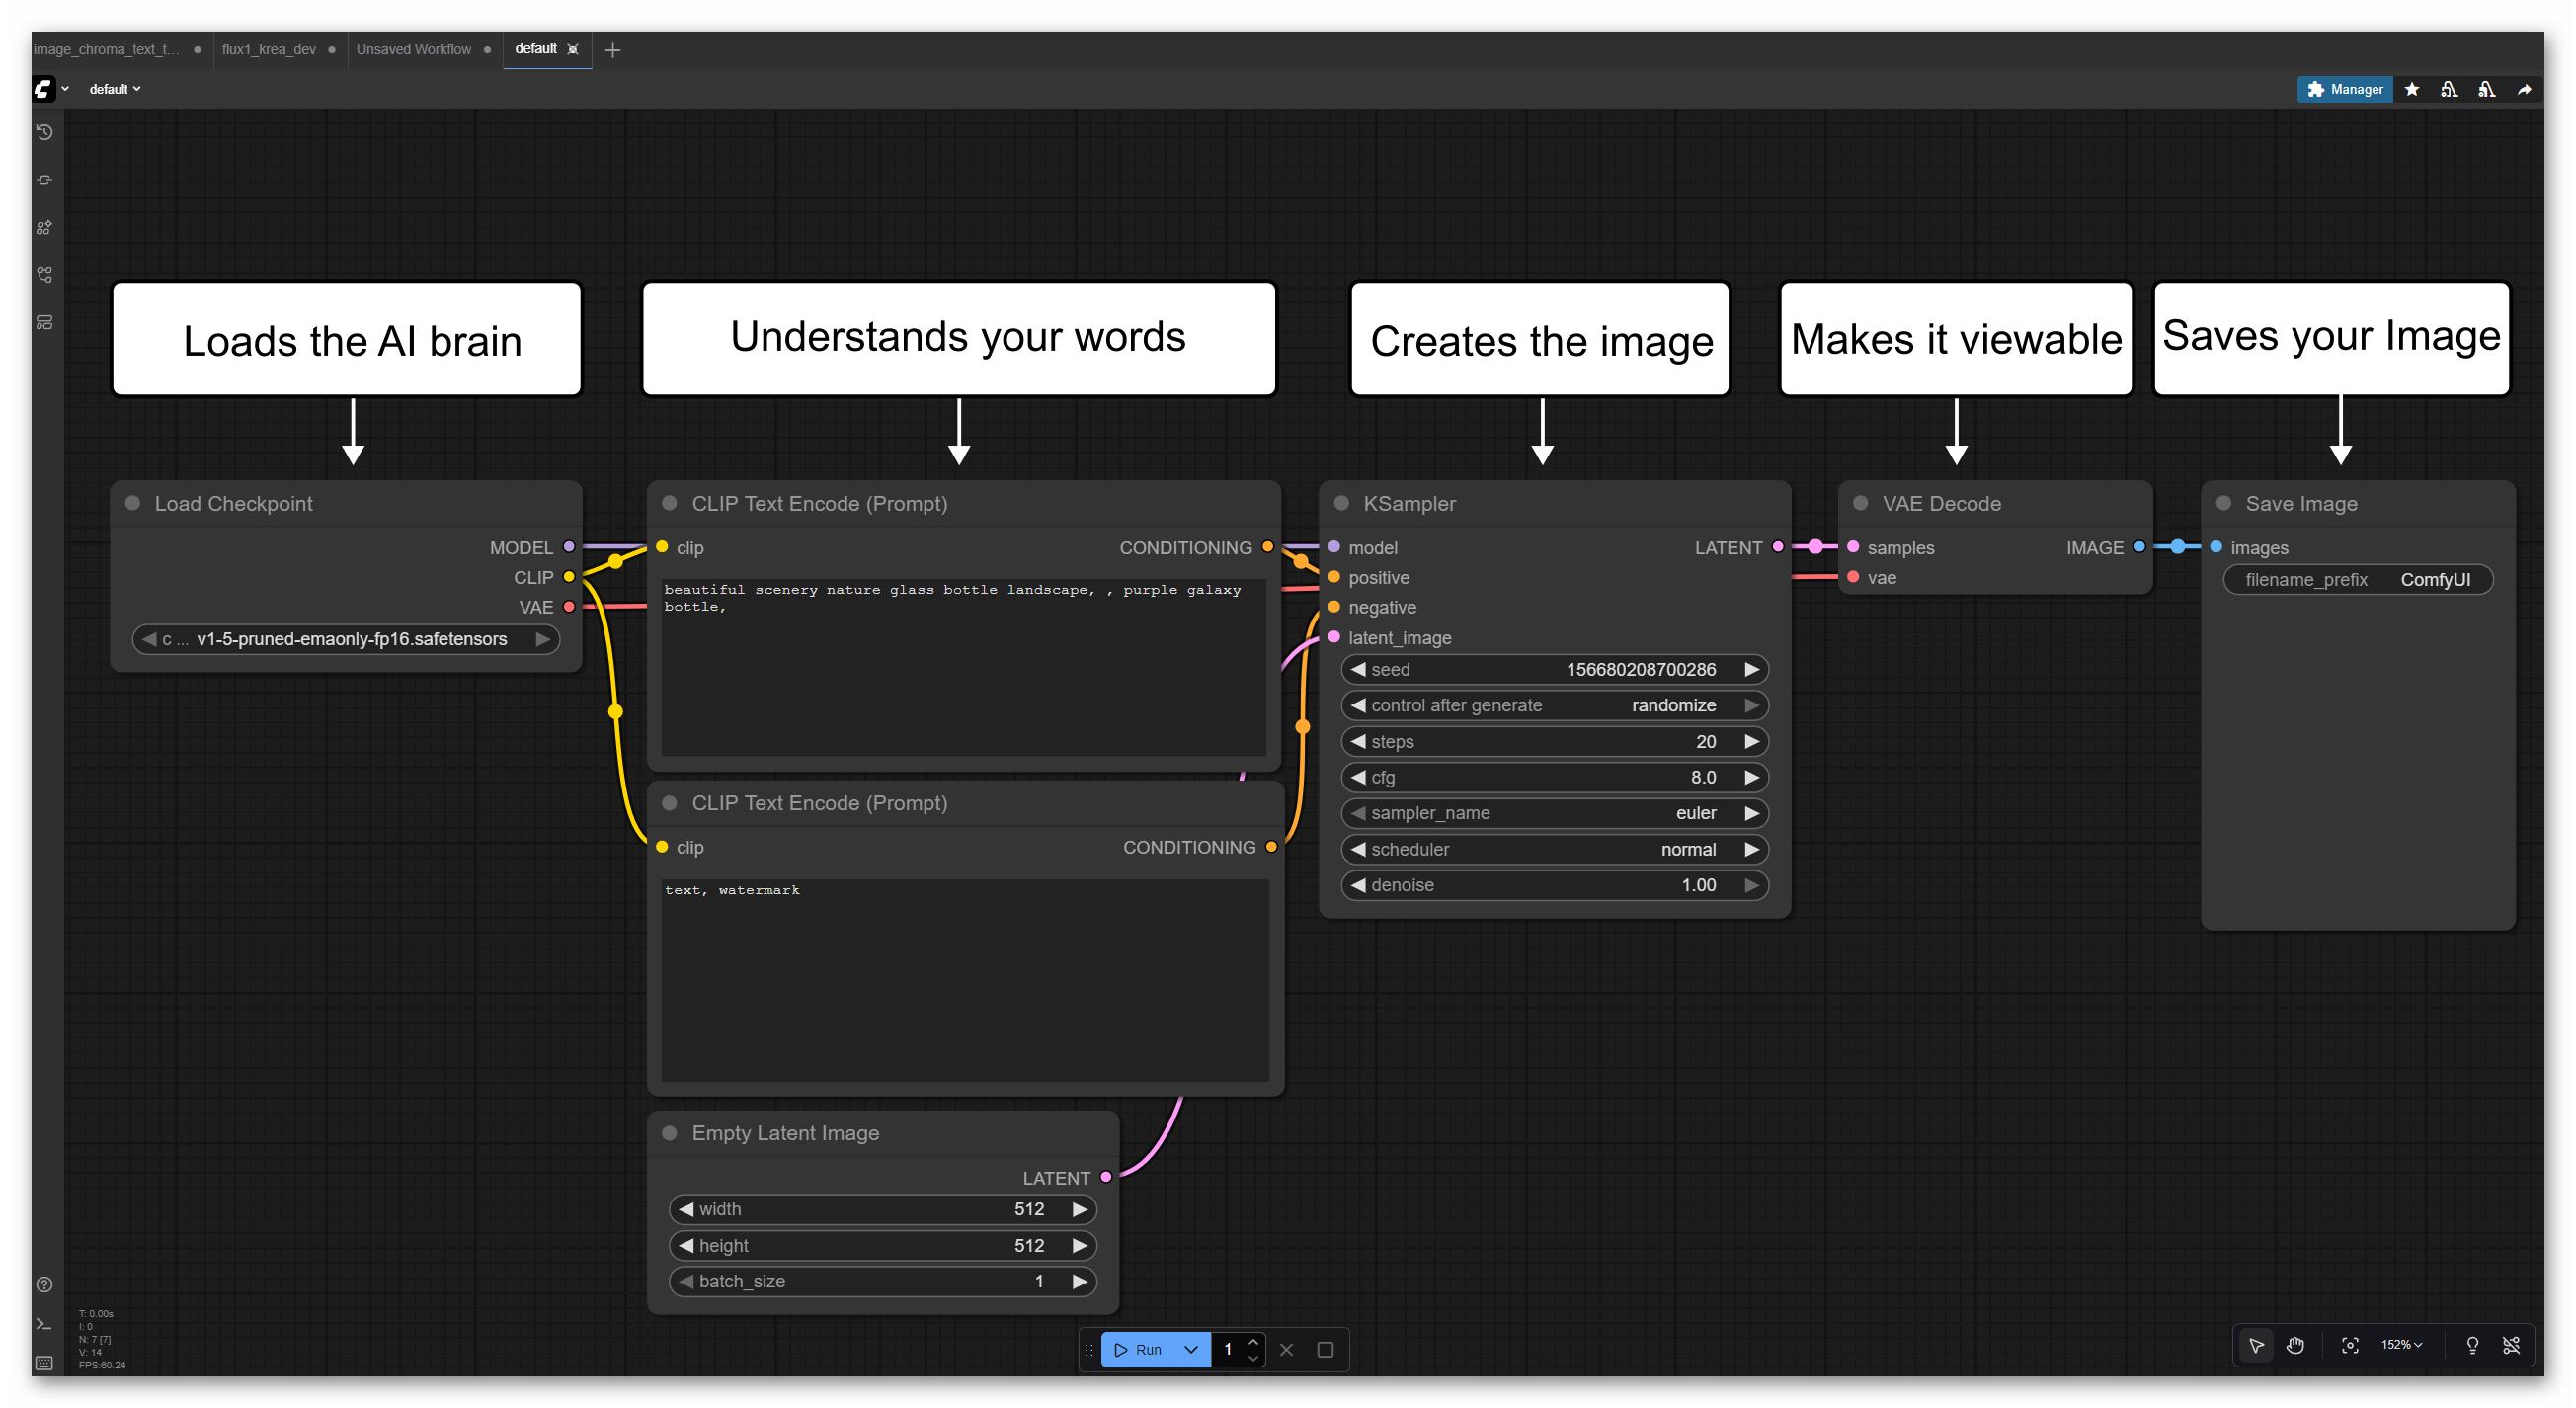
# 2. 克隆 ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI
pip install -r requirements.txt

# 3. 启动(根据显卡选择)
# Windows 双击 run_nvidia_gpu.bat(N卡)或 run_cpu.bat(纯CPU)
python main.py --cuda-device 0
五、完整生成流程
整个漫剧制作遵循 「剧本 → 角色 → 分镜 → 合成 → 导出」 五步流水线。
第 1 步:剧本生成(Gemini three)
打开工具界面,点击「创建作品」。
上传小说文本,或直接输入故事梗概。
选择「自动模式」,点击「开始创作」。
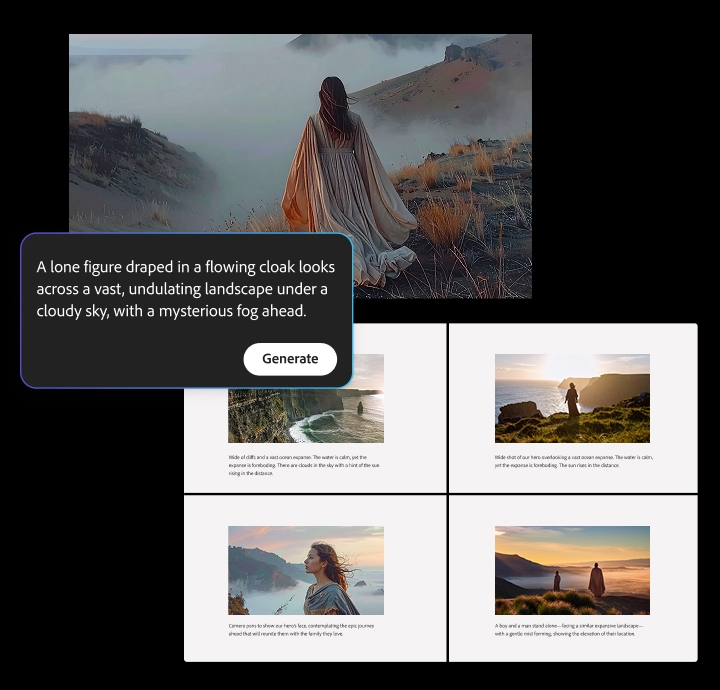
Gemini three 自动输出电影级分镜剧本,包含:镜头号、画面描述、台词、提示词。
第 2 步:角色与场景素材生成(GPT Images two)
进入「角色管理」,点击「一键生成人物三视图」。
输入角色描述(例:
古风女子,红衣,金饰,眉目清冷)。GPT Images two 生成正面、侧面、背面三张设定图,作为角色统一基准。
同样方式生成场景图、道具图,并保存为角色素材库。
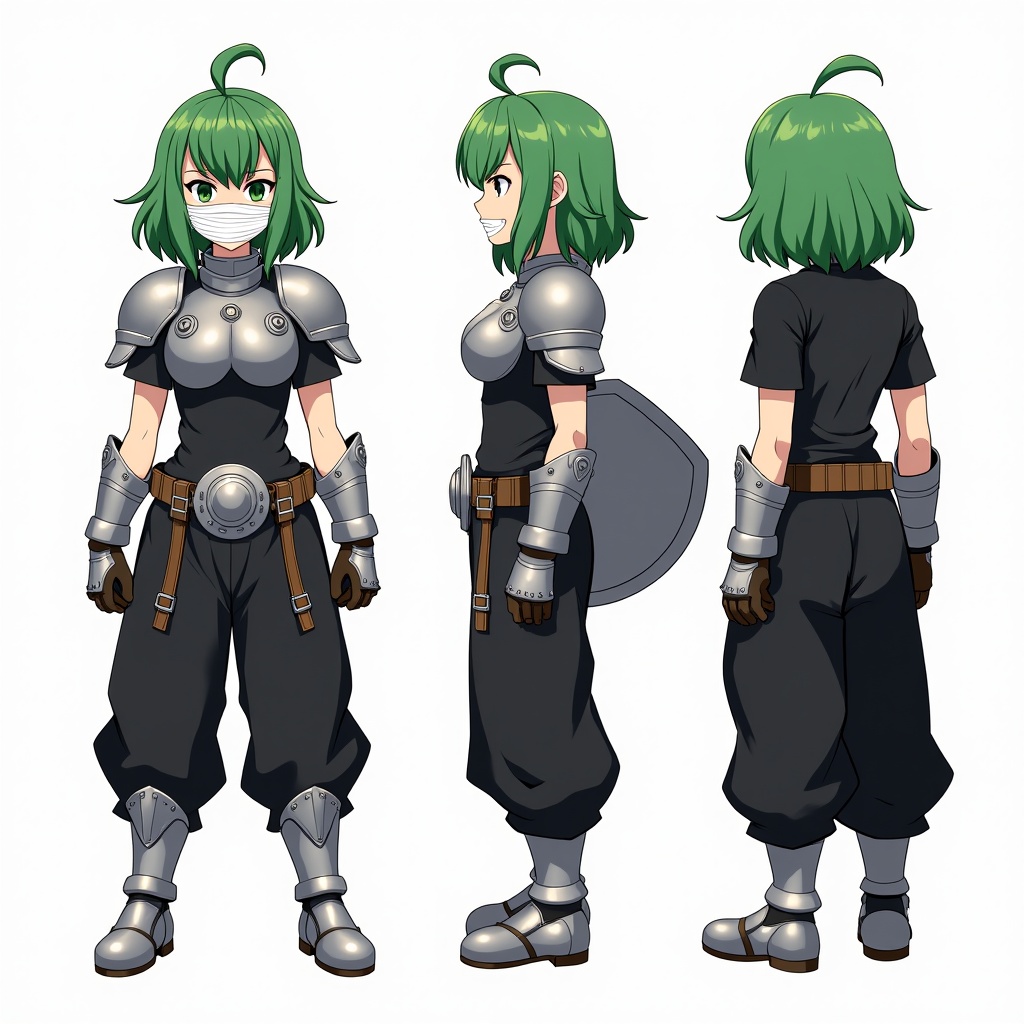
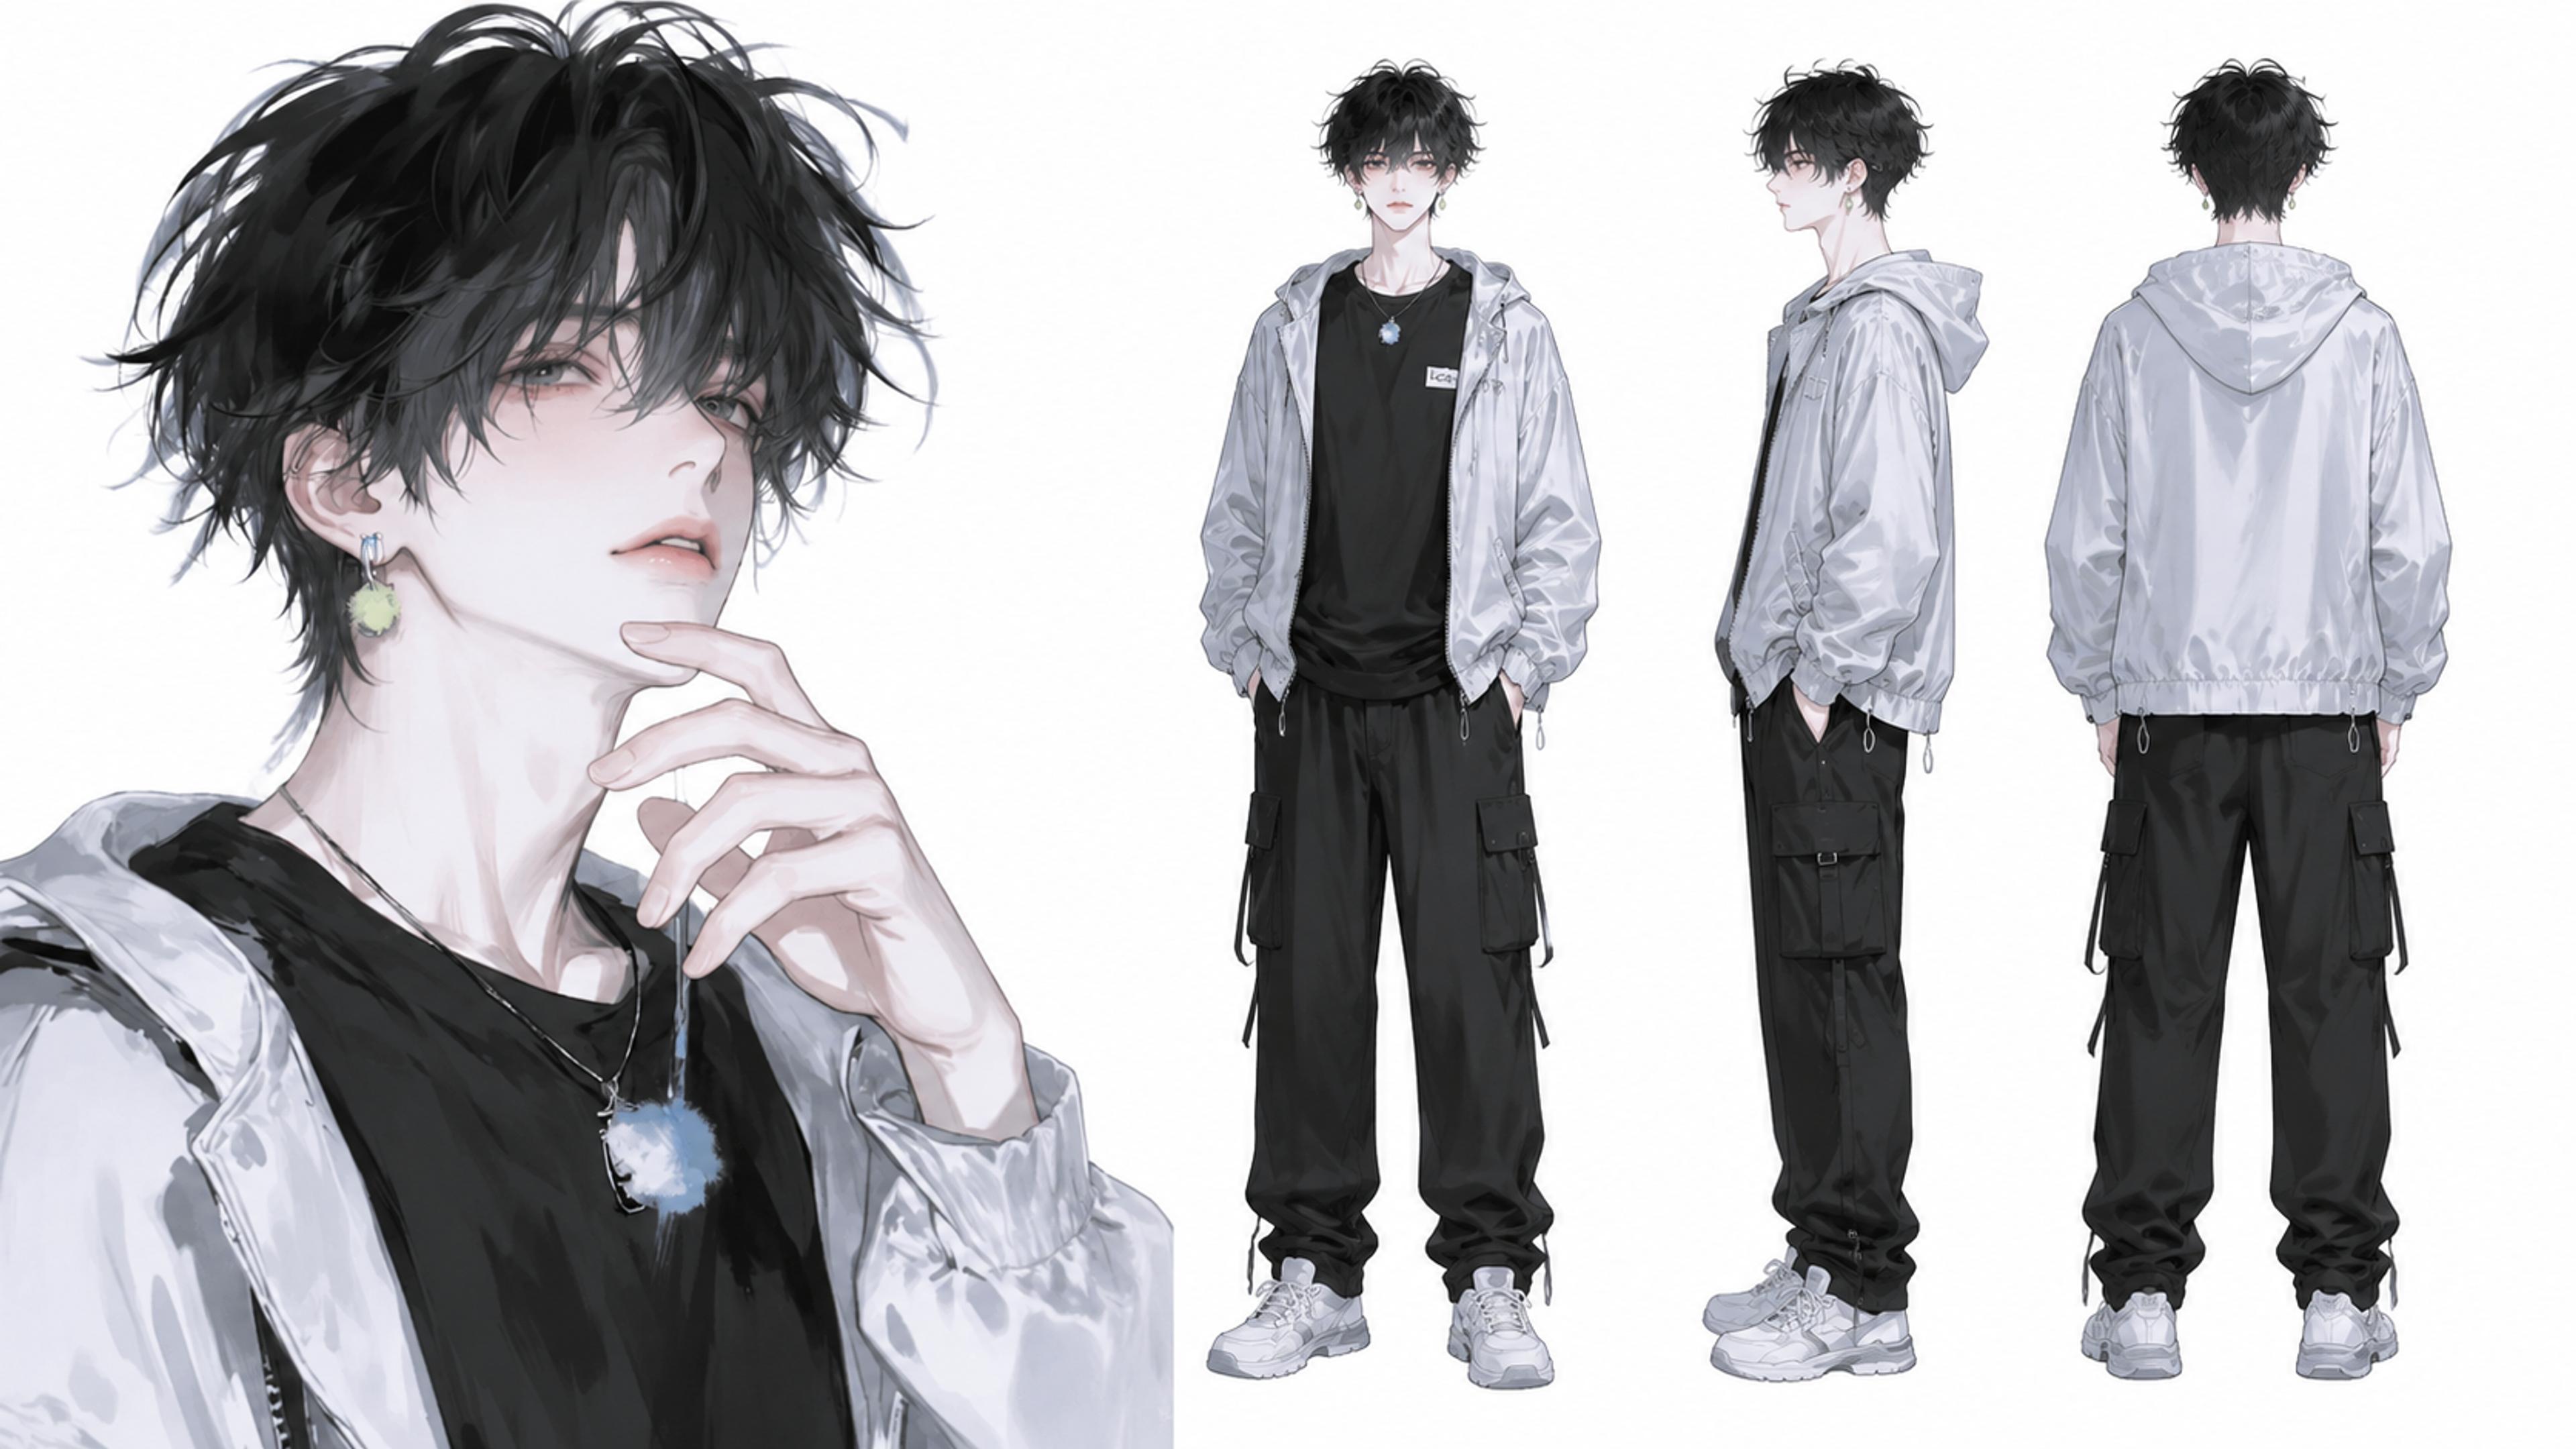
🔑 关键:三视图一旦确定,后续所有分镜画面都需引用同一组设定图,这是保证「人物从头到尾一致」的核心。
第 3 步:分镜画面生成
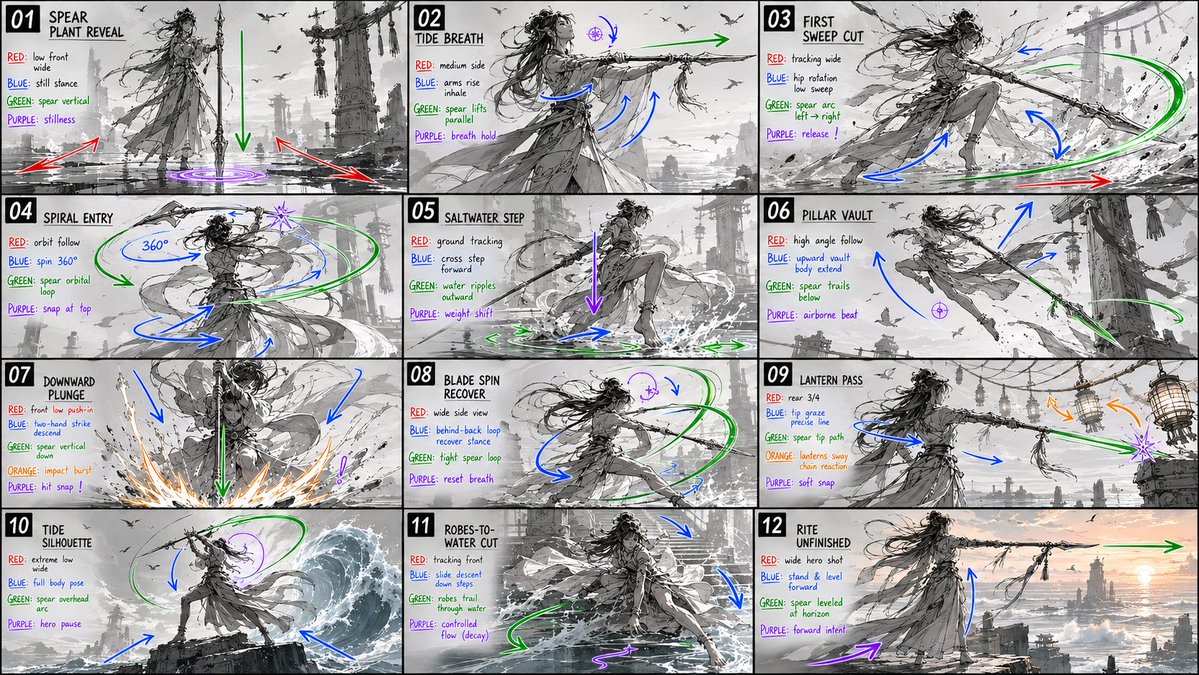
进入「分镜编辑」页面,选中某个镜头。
点击「生成画面」,工具调用 GPT Images two 出图。
支持一键切换画风:古风、赛璐璐、国风 3D、日漫等。
第 4 步:视频合成
所有分镜图生成完毕后,点击「生成视频」。
设置参数:
分辨率:1080P 竖屏 9:16(漫剧主流)
帧率:24fps
工具自动完成:镜头拼接 → 转场添加 → 背景音乐匹配。
第 5 步:导出成片
点击「导出」→「导出视频」,得到 MP4 文件。
也可同步导出分镜图、人物素材、剧本文本等资源,方便存档与二次剪辑。
六、进阶技巧与画质优化
6.1 批量生成(分布式队列)
使用 Celery + Redis 搭建任务队列,把「每集漫剧」作为独立任务排队生成:
from celery import Celery

app = Celery('manga_producer', broker='redis://localhost:6379/0')

@app.task(bind=True, max_retries=3)
def produce_episode(self, story_text: str, episode_id: str):
    script = generate_script(story_text)      # 剧本
    for scene in script["scenes"]:
        render_scene(scene)                   # 分镜画面
    final_video = compose_video(script)       # 合成
    return final_video
6.2 角色一致性优化
生成角色时设置「参考权重」为 0.7–0.8,稳定形象。
保存角色的 LoRA 模型,后续生成直接调用,进一步提升一致性。
6.3 画质提升
使用 GPT Images two 的高清模式,生成分辨率设为 2048×2048。
后期可用 Topaz Video Enhance AI 做超分增强。
6.4 工作流模板复用
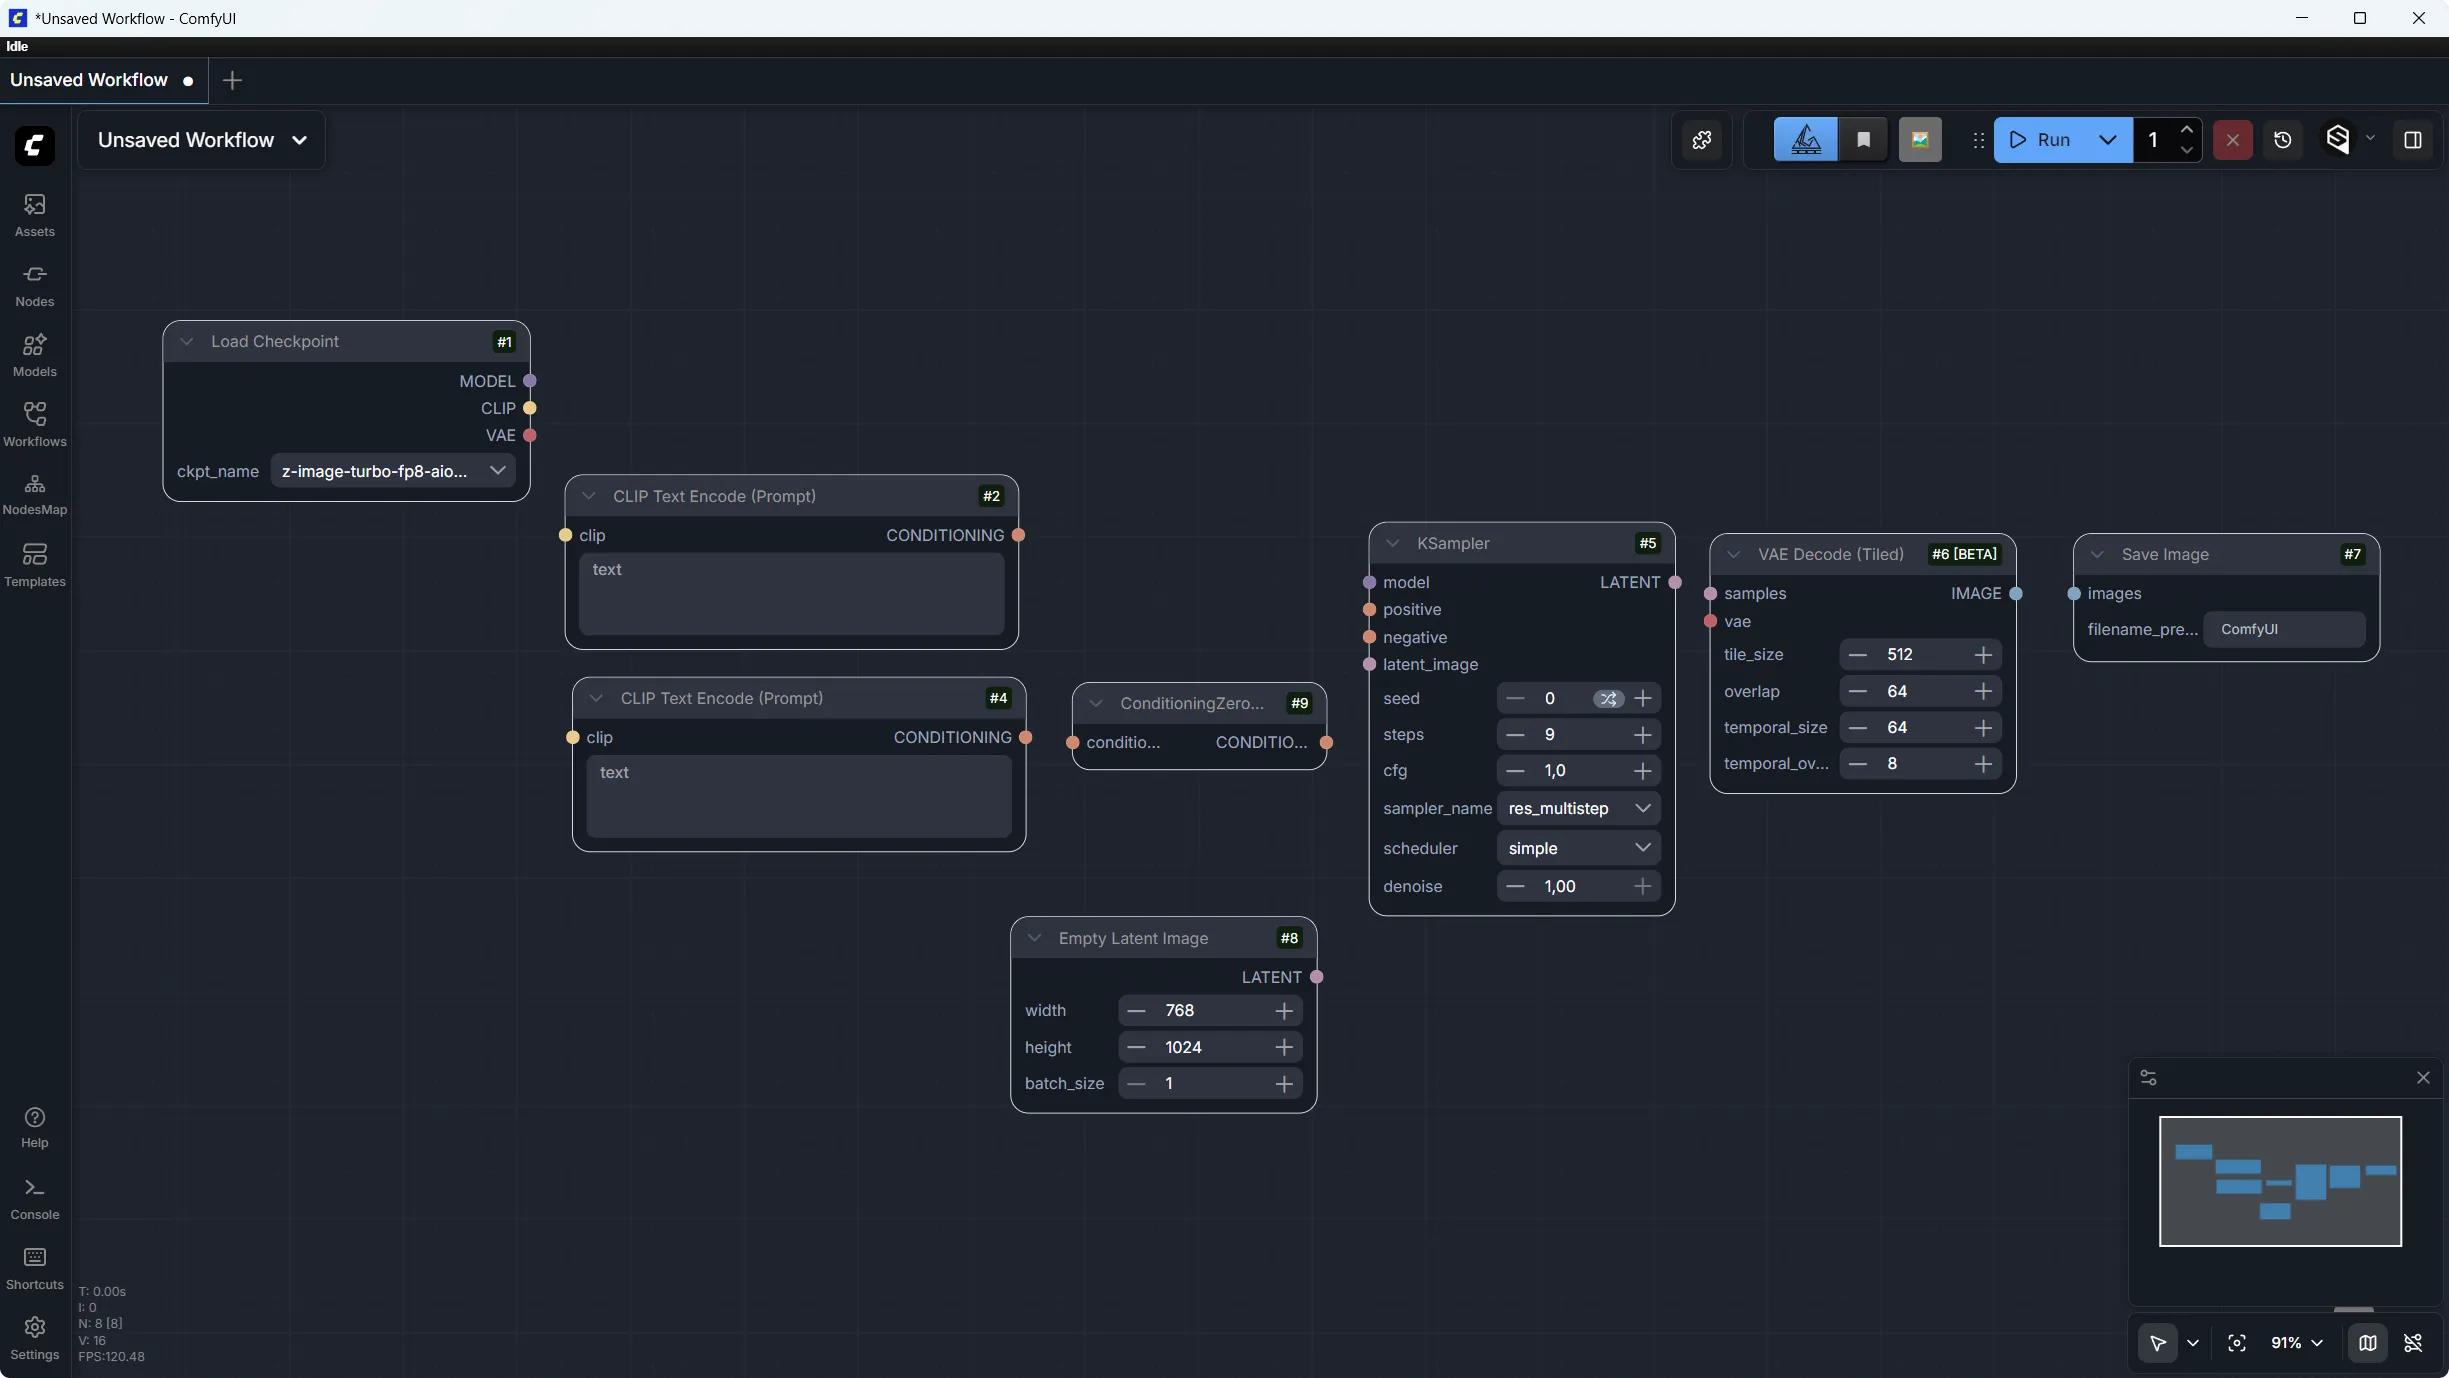
把一次成功的「节点 + 参数」保存为工作流模板,后续新集直接加载复用,大幅提升效率。
七、常见问题排查
八、官方链接汇总
Gemini three 相关
开发者入口:Google AI Studio
Gemini API 文档:https://ai.google.dev/gemini-api/docs
GPT Images two 相关
平台入口:OpenAI Platform
Images API 文档:https://platform.openai.com/docs/guides/images
网页版:chat.openai.com
本地工具
Ollama —— 本地模型
ComfyUI —— 可视化生成
Topaz Video AI —— 画质增强
云服务器
免责声明:本指南根据公开视频内容整理,文中「Gemini three」「GPT Images two」等名称及具体功能以官方实际发布为准,操作请以官方最新文档为最终依据。