
整理时间:2026-10-22 | 覆盖:DeepSeek-V4.1-Flash / V4 家族权重、DeepInfer 推理框架、API 接入 本文所有示意图为自绘,数据与链接来自 DeepSeek 官方发布页、Hugging Face、ModelScope、GitHub。
一、一分钟速览
一句话结论:想省事就直接调 API(deepseek-flash);要私有化,先确认手里有没有 SM100(B200/GB200)或昇腾 950 —— 这是官方 DeepInfer 目前支持的硬件;只有 H100/H200 的话,走官方 minimal inference 或等社区栈适配。
二、最新开源动态
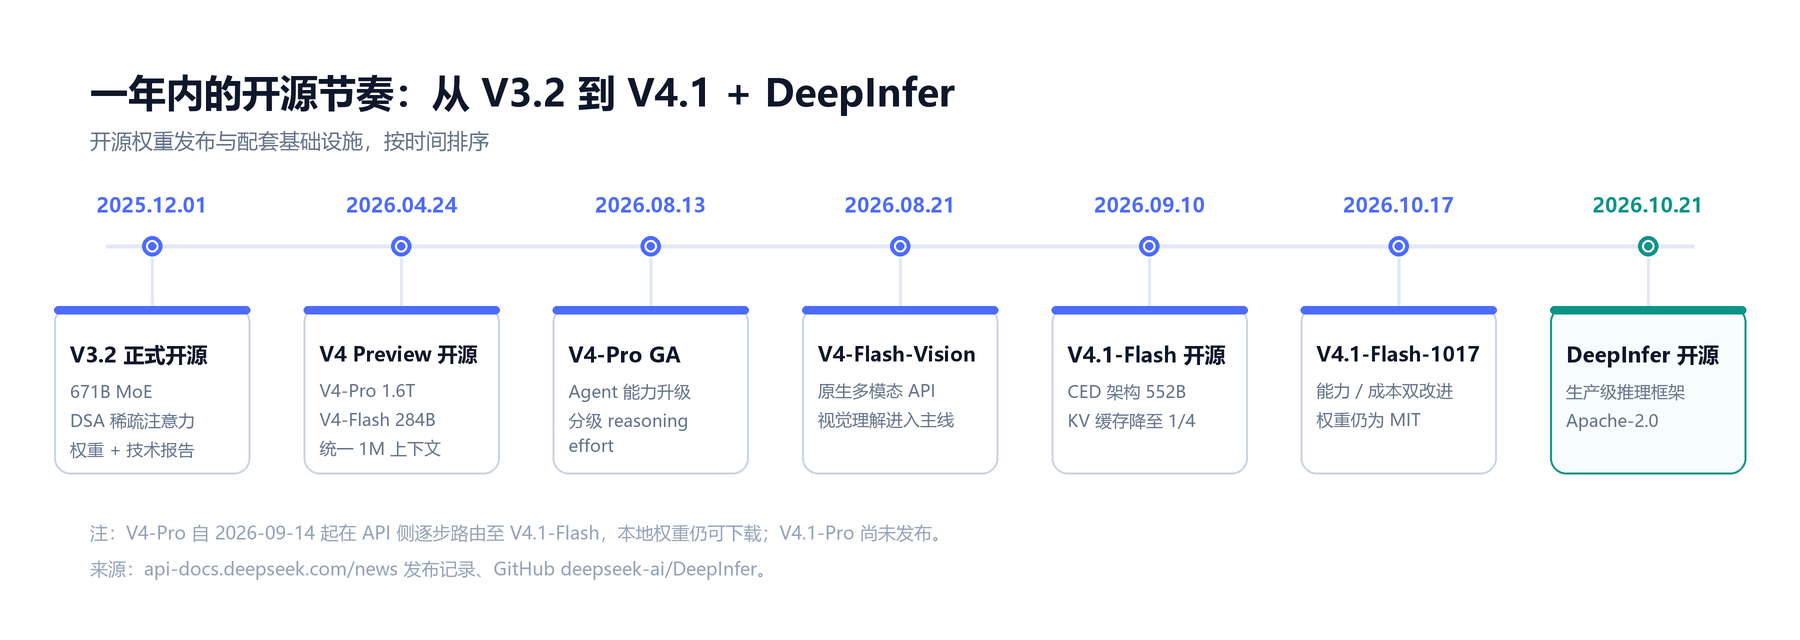
图 1 · 2025-12 至 2026-10 的开源节点(来源:api-docs.deepseek.com/news 发布记录、GitHub)
2.1 DeepSeek-V4.1-Flash-1017(2026-10-17,最新权重)
官方定位是 V4.1-Flash 的小版本更新,主打"能力/成本帕累托改进":推理、代码、Agent、视觉四项基准全面提升,同时缩短任务执行时间与输出长度。
权重:MIT,Hugging Face / ModelScope 双通道
关键基准(官方表格):HLE w/o tools 42.6、Terminal-Bench 4.0 42.3、DeepSWE v1.1 77.0、ProgramBench 29.1、NL2Repo-Bench 68.2
同期上线:官方 Search & Fetch API(每 1,000 次调用 $0.75;通过 DeepSeek Harness / Claude Code / Codex 的服务端工具调用免费至 2026-10-31 16:00 UTC)
2.2 DeepInfer(2026-10-21,最新框架)
这是 DeepSeek 第一次把生产环境在用的推理系统开源出来:
支持模型:DeepSeek-V4.1-Flash
硬件:NVIDIA SM100(B200/GB200)、华为昇腾 950
特性:Attention DP / 平衡 CP、MoE EP + EPLB、DSpark 投机解码与置信度调度验证、SWA bounded replay、异步调度、batch-invariant、确定性采样、结构化输出(regex / JSON Schema / EBNF)
内核栈:FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect + 自研 TileLang kernel
明确未包含:KV cache 系统、PD 分离(引擎侧大部分已实现)、多副本负载均衡 —— 这三块需要自己补
血缘:最初主要基于 vLLM 构建,参考了 SGLang 与 TensorRT-LLM
2.3 版本回看:V4 → V4.1 的三次跳跃
注意:V4-Pro 自 2026-09-14 起在 API 侧逐步路由至 V4.1-Flash,V4.1-Pro 尚未发布;V4-Pro 的本地权重仍可正常下载使用。
三、开源模型矩阵与下载链接
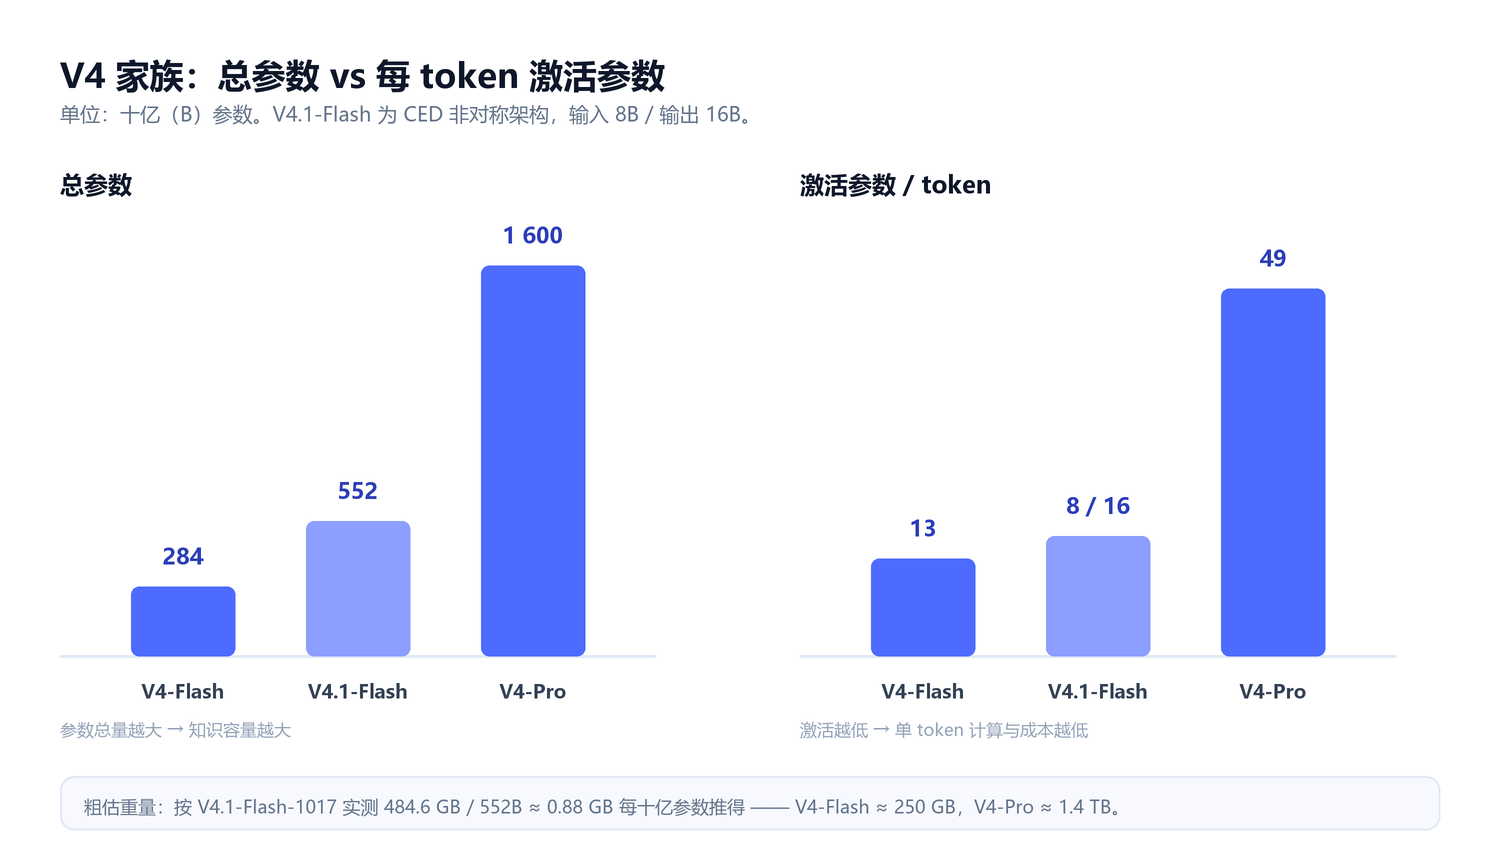
图 2 · 总参数与每 token 激活参数对比;V4.1-Flash 的 8B/16B 是 CED 架构带来的非对称激活
3.1 模型清单
集合页(一次看全家族):https://huggingface.co/collections/deepseek-ai/deepseek-v4
3.2 技术报告
3.3 选哪个?
只有一张卡到八张卡,想真的跑起来 → 老实说,V4.1-Flash 原权重 485 GB 放不下,请用 API(第七节)或看第十节。
要私有化、有 Blackwell/昇腾集群 → V4.1-Flash-1017 + DeepInfer(第八节)。
做研究、要读代码、验证 kernel → V4.1-Flash-1017 + 官方 minimal inference(第九节)。
要最大知识容量、能凑多机 → V4-Pro / V4-Pro-Base。
要微调 → 优先 Base 系列(FP8 Mixed,无 FP4 反量化损耗)。
四、为什么 V4.1 这么便宜:架构拆解
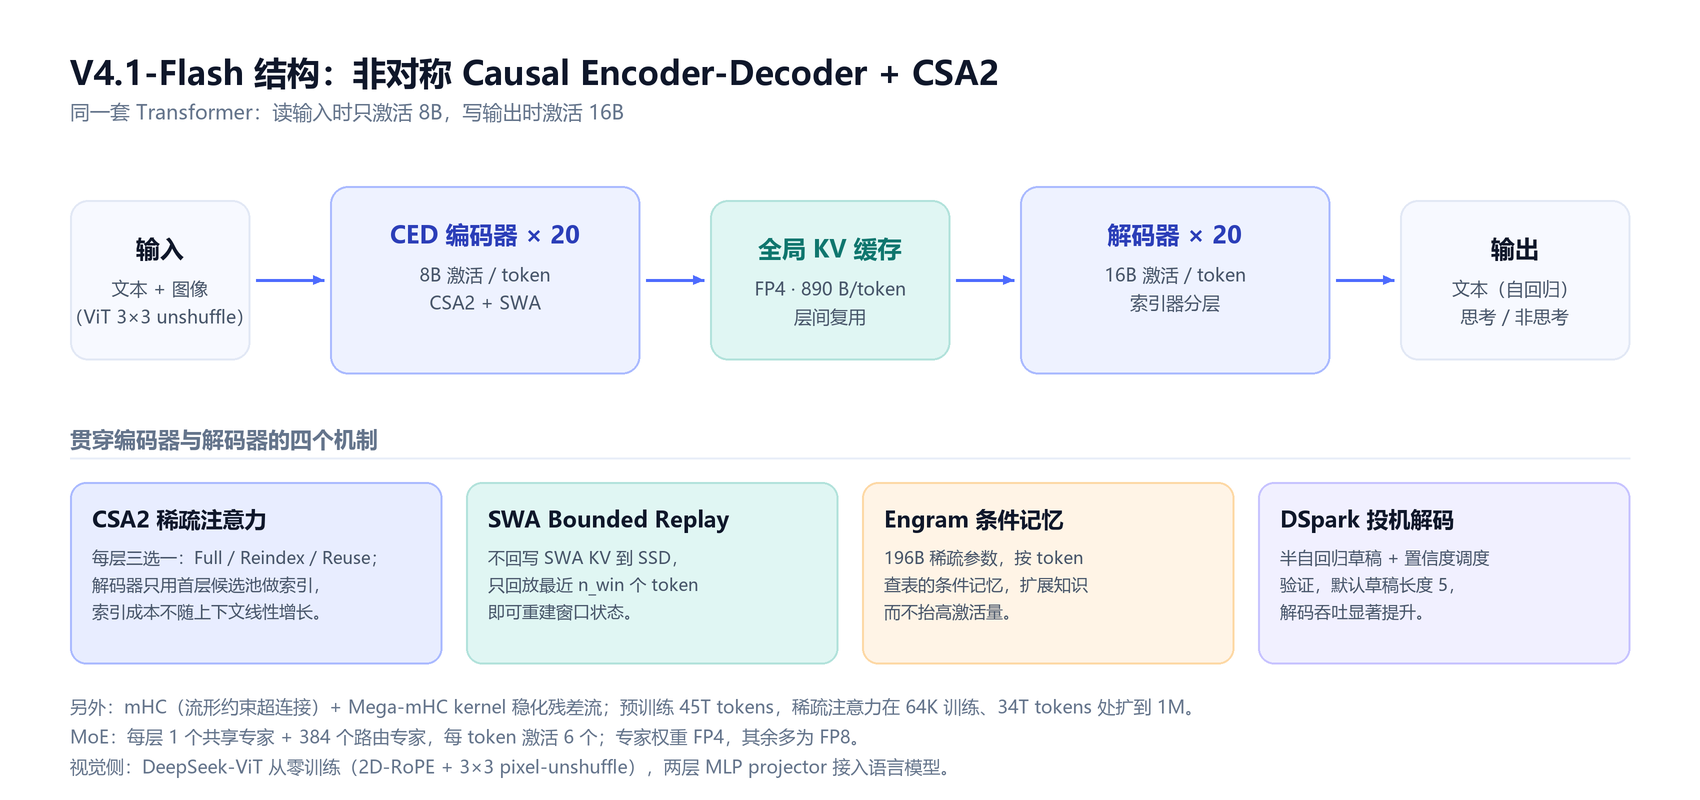
图 3 · CED 非对称编解码 + 四个关键机制(据 V4.1 模型卡整理)
4.1 Causal Encoder-Decoder(CED):输入和输出分开算
40 层 Transformer 拆成 20 层编码器 + 20 层解码器。解码器的全局 KV 由编码器最终隐状态投影得到,而不是每层自己算一份。
结果就是激活量不对称:
对 Agent 负载(输入远大于输出)来说,这个不对称非常划算。
4.2 CSA2:层间复用 + 分层索引
每个注意力层被静态指定为三种模式之一:Full / Reindex / Reuse,从而在主 KV 与 indexer K 上做层间共享、复用 Top-K 稀疏索引。解码器再叠一层分层稀疏索引器,让后续索引层只在第一层 Full 模式构造的候选池里检索 —— 索引成本不再随上下文线性增长。
4.3 KV Cache 压到 890 B/token
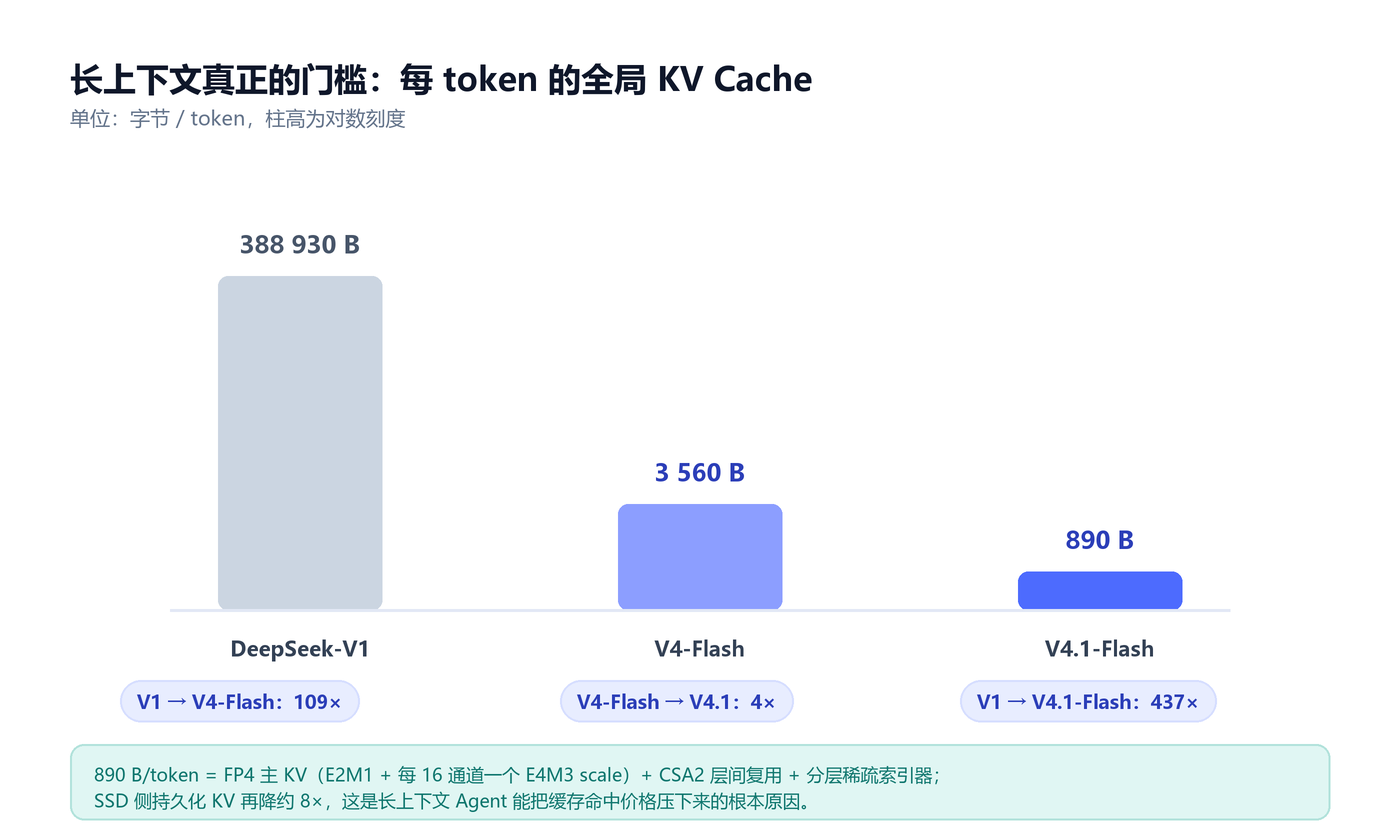
图 4 · 每 token 全局 KV 体积(对数刻度);V4.1-Flash 相对 V4-Flash 降 4 倍、相对 V1 降 437 倍
三个动作叠加:
FP4 主 KV 缓存:E2M1 格式,每 16 个通道一个 E4M3 scale
CSA2 层间复用:不是每层都存一份完整 KV
SWA Bounded Replay:滑动窗口 KV 不落 SSD,需要时只回放最近 n_win 个 token 重建
官方口径:相对 V4-Flash,HBM 只需 1/4,SSD 只需 1/8。按 890 B/token 算,一条 1M token 的会话 KV 约 890 MB —— 这是长上下文能算得过账的根本原因。
4.4 其他组件
Engram 条件记忆:196B 稀疏参数,按 token 查表,扩知识但不抬激活
DSpark 投机解码:半自回归草稿 + 置信度调度验证,默认草稿长度 5
Single-Pass mHC:流形约束超连接 + Mega-MHC kernel,稳化残差流
MoE 配置:每层 1 个共享专家 + 384 个路由专家,每 token 激活 6 个
视觉:DeepSeek-ViT 从零训练(2D-RoPE + 3×3 pixel-unshuffle),两层 MLP projector 接入
训练:45T 多模态 token 从头训;稀疏注意力 64K 训练,34T token 处扩到 1M
五、下载教程(三种方式 + 国内加速)
5.1 先看体积,再决定放哪
权重总量:484.6 GB,48 个
model-xxxxx-of-00048.safetensors张量类型:
F8_E8M0、F8_E4M3、I8(FP4 打包)、BF16、F32建议:NVMe 本地盘;留给转换副本的空间(见 5.4),实际准备 ≥ 1.2 TB 空闲
5.2 方式一:Hugging Face CLI(推荐)
bash
pip install -U "huggingface_hub[cli]"

# 国内网络强烈建议加这一行(走镜像)
export HF_ENDPOINT=https://hf-mirror.com

hf download deepseek-ai/DeepSeek-V4.1-Flash-1017 \
  --local-dir /data/models/DeepSeek-V4.1-Flash-1017
断点续传、分片并发都不用手动管,重跑同一条命令即可。
5.3 方式二:ModelScope(国内最稳)
bash
pip install -U modelscope

modelscope download \
  --model deepseek-ai/DeepSeek-V4.1-Flash-1017 \
  --local_dir /data/models/DeepSeek-V4.1-Flash-1017
ModelScope 页面同时提供每个分片的 sha256,可逐个校验。
5.4 方式三:git + LFS(不推荐,容易断)
bash
GIT_LFS_SKIP_SMUDGE=1 git clone https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
cd DeepSeek-V4.1-Flash-1017
git lfs pull
5.5 下载后必做的三件事
核对文件数:
ls *.safetensors | wc -l应为 48(V4.1-Flash-1017)确认 tokenizer 齐全:
tokenizer.json、tokenizer_config.json要在同一目录(转换脚本会复制它们)确认没有缺分片:
cat model.safetensors.index.json | python -m json.tool | head -20,把weight_map里的文件名与实际文件比对
⚠️ 这个版本不提供 Jinja 格式的 chat template。prompt 必须用仓库里的
encoding/参考实现,或生产环境用 deepseek-recipe(Rust + Python 绑定)。这一步做错,模型会答得很怪 —— 比显存不够更常见。
六、部署路线总览
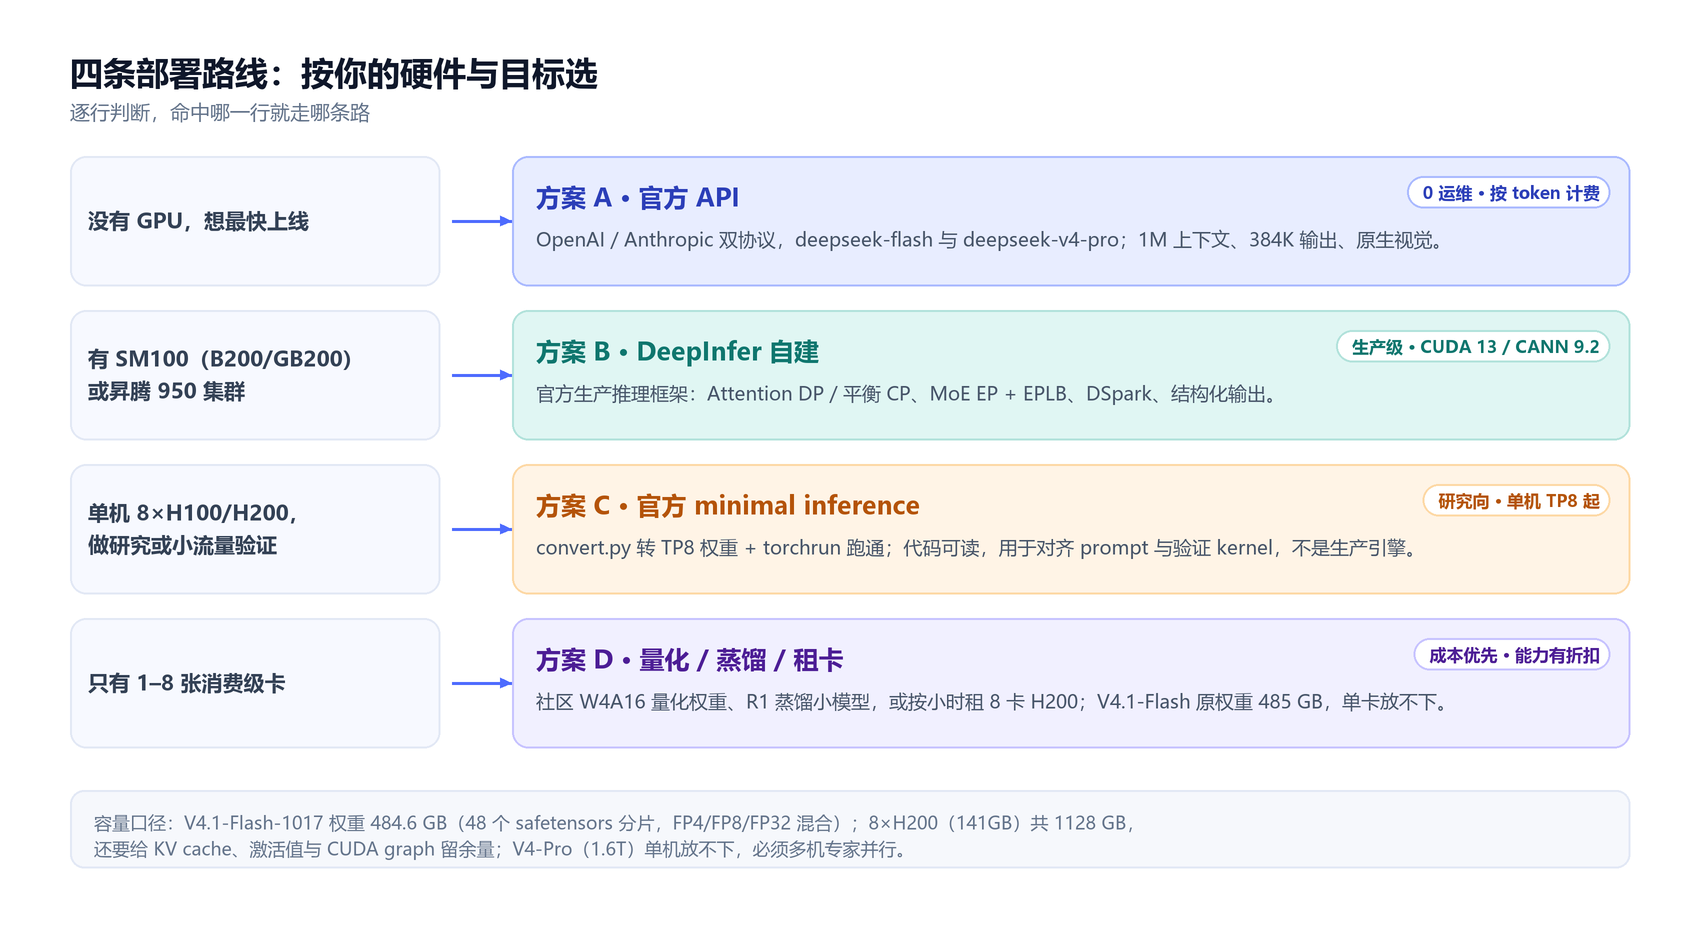
图 5 · 按硬件与目标选路线;左侧是条件,右侧是方案
七、方案 A:官方 API(最快上线)
7.1 基本信息
旧模型名 deepseek-v4-flash、deepseek-v4-flash-vision-exp、deepseek-chat、deepseek-reasoner 已陆续下线或路由到新模型,新项目请直接用 deepseek-flash。
7.2 最小可运行代码
bash
pip install -U openai
export DEEPSEEK_API_KEY="sk-..."
python
from openai import OpenAI

client = OpenAI(api_key="sk-...", base_url="https://api.deepseek.com")

resp = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "用一句话解释什么是 KV cache"}],
    reasoning_effort="high",                      # low / high / max
    extra_body={"thinking": {"type": "enabled"}},  # enabled / disabled
)
print(resp.choices[0].message.reasoning_content)  # 思考过程
print(resp.choices[0].message.content)            # 最终回答
curl 版:
bash
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-flash",
    "messages": [{"role": "user", "content": "你好"}],
    "reasoning_effort": "low"
  }'
7.3 思考模式的三个坑
思考模式下
temperature不生效(presence_penalty/frequency_penalty同样),设了不报错但被忽略,别指望用它调风格。带
tools时必须回传reasoning_content,否则会 400;不带tools时回传也会被忽略。top_p因模型而异:deepseek-flash只在思考模式生效(有效区间 0.95–1.0,低于 0.95 按 0.95 处理);deepseek-v4-pro在思考模式被忽略(有 tools 时固定 0.95,否则 1.0),只在非思考模式生效。
思考开关的其他协议写法:
7.4 价格(USD / 1M tokens)
高峰时段(UTC):周一至周五 01:00–04:00、06:00–10:00,即北京时间 09:00–12:00、14:00–18:00;其余时段(含周末与法定节假日)为低峰,价格减半。
并发上限:
deepseek-flash2500,deepseek-v4-pro500。缓存命中价只有未命中的 1/50,长会话、长系统提示词一定要让前缀稳定 —— 配合 890 B/token 的 KV 压缩,这是 Agent 场景省钱的核心。
7.5 客户端接入
Claude Code、Codex、OpenCode、OpenClaw、DeepSeek Harness 等都有官方接入文档:https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code。DeepSeek Harness 建议 v0.2.1-rc.1 及以上版本以适配 V4.1-Flash。
八、方案 B:DeepInfer 自建生产集群
仓库:https://github.com/deepseek-ai/DeepInfer(Apache-2.0,2026-10-21 开源)
8.1 前置条件(硬门槛)
H100/H200 是 Hopper(SM90),不在本版支持列表里 —— 这是选型时最容易踩的坑。
8.2 编译
bash
git clone https://github.com/deepseek-ai/DeepInfer.git
cd DeepInfer

python3.12 -m venv .venv && source .venv/bin/activate

# NVIDIA:
export DEEPINFER_ACCELERATOR=nvidia
# 昇腾改成:
# export DEEPINFER_ACCELERATOR=ascend

./build.sh
DEEPINFER_ACCELERATOR 要在运行 DeepInfer 的环境里也保持导出。
8.3 跑离线推理
bash
# 默认会从 Hugging Face 拉 deepseek-ai/DeepSeek-V4.1-Flash-1017 进缓存
# 有本地副本时指定:
export DEEPINFER_HF_MODEL_DIR=/data/models/DeepSeek-V4.1-Flash-1017

python examples/offline_inference.py
8.4 值得打开的开关
确定性采样需要 DEEPINFER_BATCH_INVARIANT=1 DEEPINFER_ENABLE_MTP_VARLEN=0 且给 SamplingParams 传固定 seq_seed。
8.5 上线前必须自己补的三块
官方文档写得很明白,这一版不包含完整服务所需的三件事:
KV cache 系统(跨请求复用、分级存储)
VE / Prefill / Decode 分离部署(引擎内大部分能力已实现,缺编排)
数据并行副本间的负载均衡(prefill 与 decode 都要)
所以 DeepInfer 是"高性能推理引擎",不是"开箱即用的推理服务"。要么自己写网关,要么放在已有的推理平台里当执行层。
8.6 性能基准怎么复现
仓库给了 examples/sweep/run_sweep.sh,官方数据是在 4 张 SM100 做 prefill、64 张做 decode(各在同一 scale-up 域内)测的。评估脚本在 eval/README.md。
九、方案 C:官方 minimal inference(研究与验证)
这是随权重一起发的参考实现,不是生产引擎。价值在于:代码可读、能对齐 prompt 编码、能验证 kernel 是否跑通。
9.1 装依赖
bash
cd /path/to/DeepSeek-V4.1-Flash-1017/inference
python -m pip install -r requirements.txt
9.2 转换权重(按 TP rank 切分)
bash
export HF_CKPT_PATH=/data/models/DeepSeek-V4.1-Flash-1017
export SAVE_PATH=/data/models/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
--tokenizer-path "${HF_CKPT_PATH}"转换后是每个 TP rank 一个 checkpoint 文件,所以
SAVE_PATH还会再占一份接近 485 GB 的空间专家数量从权重名自动推断,不用传
--tokenizer-path指向含tokenizer.json的目录,脚本会把它拷进转换结果
9.3 跑示例与交互
bash
export CKPT_PATH=$SAVE_PATH
export MP=8

# 官方给的等价 prompt 示例(TXT 与 JSON 编码结果应当一致)
INPUT_FILE=examples/example.txt ./run.sh
INPUT_FILE=examples/example_harmony.json ./run.sh

# 交互式聊天
torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
多机就在 torchrun 上加标准参数:
bash
torchrun --nnodes 2 --node-rank 0 --master-addr 10.0.0.1 --master-port 29500 \
  --nproc-per-node 8 generate.py --ckpt-path "$CKPT_PATH" --config config.json --interactive
9.4 自检(不用权重也能跑)
bash
python model.py会用 ModelArgs 默认参数搭个小模型,跑 prefill + 22 步 decode,覆盖真实 dense-FP8 / MoE-FP4 kernel 的形状与通路(权重未初始化,只验形状和 kernel 管道,不验数值)。
9.5 采样参数
用 Think Max 模式时,上下文窗口建议至少 384K。
十、方案 D:社区栈 / 量化 / 租卡
10.1 vLLM / SGLang 现状
V4.1 引入了 CED、CSA2、FP4 KV、DSpark 等新结构,上游推理框架的适配需要时间。截至本文整理时,官方推荐路径是 DeepInfer(生产)+ minimal inference(研究),vLLM/SGLang 对 V4 系列的支持请以上游 model support 列表为准,不要假设"装了就能跑"。
如果一定要接社区栈,三个必查项:
chat template:仓库没有 Jinja 模板,必须自己注入
encoding/的逻辑FP4 KV cache:主 KV 是 E2M1 + E4M3 scale,很多引擎只支持 FP8/FP16 KV
DSpark / MTP:不带投机解码也能跑,但吞吐会差一截
10.2 量化权重
Hugging Face 上已有社区做的 W4A16-FP8 等版本(例如 canada-quant/DeepSeek-V4-Flash-W4A16-FP8 一类仓库)。用之前请确认:谁做的、用什么校准集、有没有跑过基准对比。量化版的能力折扣要自己测,尤其是 Agent 和长上下文场景。
10.3 现实一点的方案
租卡:按小时租 8×H200/B200 跑一次性任务,比买卡划算得多
蒸馏小模型:R1 系列的蒸馏思路仍适用于垂直场景,7B–32B 级别在单卡上就能跑
混合架构:高频、简单请求走本地小模型,复杂请求走
deepseek-flashAPI
十一、硬件与容量规划
11.1 权重体积估算公式
以 V4.1-Flash-1017 的实测值为锚:
代码块
484.6 GB / 552B 参数 ≈ 0.88 GB 每十亿参数估算口径:仅权重,不含 KV cache、激活、CUDA graph 与框架开销。实际规划时显存再留 20%–30%。
11.2 KV cache 估算
单序列 1M token:
代码块
890 B/token × 1,000,000 ≈ 890 MB(约 0.87 GiB)这意味着在 8×B200(1.5 TB 显存)上,扣掉 485 GB 权重,剩下的空间能撑上百条 1M 上下文会话(还要扣激活与碎片)。对比 V4-Flash 的 1/4 体积,同样的卡能多跑约 4 倍并发。
11.3 一张表看懂该买什么
11.4 存储与网络
权重落盘:NVMe,读带宽直接影响冷启动(485 GB 全量加载)
转换副本:
convert.py会再写一份,准备 ≥ 1.2 TB多机:EP 通信吃 RDMA/IB,千兆网络会成为瓶颈
十二、周边开源生态
DeepSeek 的开源不只是权重,配套的 kernel 与工具链同样值得关注:
十三、常见坑与 FAQ
Q1:为什么我本地跑出来的回答很差? 九成是 prompt 编码错了。这一版没有 chat template,必须用 encoding/ 或 deepseek-recipe,否则特殊 token 与思考模式的分隔符全错。
Q2:H100/H200 能不能跑 DeepInfer? 不能。当前只支持 SM100(B200/GB200)与昇腾 950。Hopper 上要等社区适配,或用 minimal inference 走 FP8 路径。
Q3:8×4090/8×3090 能跑 V4.1-Flash 吗? 放不下。485 GB 权重、FP4 kernel 也不是消费卡的强项。想本地跑,选蒸馏小模型或社区量化版。
Q4:Ollama / llama.cpp 支持吗? 目前不支持 V4 系列原权重(新架构 + 体积过大)。小尺寸蒸馏模型可以。
Q5:能商用吗? 模型权重 MIT,DeepInfer Apache-2.0,商用许可上没有额外限制;生成内容的合规责任在调用方。
Q6:1M 上下文怎么真正用起来? 服务端把 max_model_len 开到 1M,客户端注意 max_tokens(官方建议 ≥ 256K,Think Max 建议上下文 ≥ 384K)。同时留意 KV 显存:一条满长会话约 890 MB。
Q7:deepseek-v4-pro 还能用吗? 能调,但会被路由到 V4.1-Flash 计费(在 V4.1-Pro 发布前)。要 V4-Pro 的真实能力,用本地权重或等新版本上线。
Q8:价格会不会变? 会。高峰期/低峰期规则、模型下线节奏都可能调整,上线前务必回看 https://api-docs.deepseek.com/quick_start/pricing。
十四、参考链接
官方发布
V4.1-Flash-1017 发布说明:https://api-docs.deepseek.com/news/news261017
V4.1-Flash 发布说明:https://api-docs.deepseek.com/news/news260910
权重与论文
V4.1-Flash-1017:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
V4 家族集合:https://huggingface.co/collections/deepseek-ai/deepseek-v4
ModelScope 镜像:https://modelscope.cn/models/deepseek-ai/DeepSeek-V4.1-Flash-1017
国内 HF 镜像:https://hf-mirror.com
代码
DeepInfer:https://github.com/deepseek-ai/DeepInfer
deepseek-recipe:https://github.com/deepseek-ai/deepseek-recipe
免责声明
本文为第三方整理,不是 DeepSeek 官方文档。价格为 2026-10-22 快照,模型名与路由策略可能随时调整;硬件需求中的"估算"项为按公开数据推算,实际部署请以官方仓库 README 与你自己压测的结果为准。