

Tabby:自托管、支持消费级 GPU 的开源 AI 代码补全助手(GitHub Copilot 本地替代)|部署与使用全指南
项目仓库: https://github.com/TabbyML/tabby
开源协议:仓库 ee/ 目录外代码 Apache
2.0,ee/ 目录遵循其独立 ee/LICENSE(企业功能)
· 主要语言:Rust · 交付形态:Docker 镜像、各平台独立可执行文件、源码编译
· 默认端口 8080 · 内置存储:SQLite(数据目录
~/.tabby,可用 TABBY_ROOT 覆盖) ·
官方文档:tabby.tabbyml.com/docs
非官方声明:Tabby 由 TabbyML, Inc. 维护,与 GitHub、Microsoft、OpenAI、Anthropic、Ollama、Mistral、NVIDIA、Apple 等公司不存在隶属、授权或合作关系;文中出现的模型、显卡与平台名称仅用于说明兼容目标。模型权重不随 Tabby 仓库分发,各模型遵循其自身许可证;企业功能与商用二次分发前请同时核对 Apache 2.0、
ee/目录许可与所选模型许可。
1 项目简介
Tabby 是一款开源自托管 AI 编码助手,定位为 GitHub Copilot 的本地 / 私有化替代方案:团队在自己的服务器上启动一个代码补全服务,编辑器插件通过 OpenAPI 连接,获得行内补全、侧边栏聊天、代码库上下文检索与团队管理能力。它不依赖外部数据库或云服务,默认使用内置 SQLite 存储配置、账号与事件日志,并面向消费级 GPU 做了推理适配。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | Tabby(命令行 tabby,Docker 镜像
tabbyml/tabby /
registry.tabbyml.com/tabbyml/tabby) |
| 仓库地址 | github.com/TabbyML/tabby |
| 项目定位 | 自托管、开源的 LLM 代码补全与编码助手服务,可私有化部署 |
| 开源协议 | ee/ 目录外 Apache 2.0;ee/ 目录遵循独立
ee/LICENSE;第三方组件沿用各自许可证 |
| 主要语言 | Rust |
| 交付形态 | Docker 镜像、Linux / Windows 独立压缩包、macOS Homebrew 安装、源码
cargo build |
| 默认端口 | 8080,可用 --port 修改 |
| 数据目录 | 默认 ~/.tabby(可用环境变量 TABBY_ROOT
覆盖),含数据库、日志、配置与事件 |
| 内置数据库 | SQLite,默认路径 ~/.tabby/ee/db.sqlite |
| 模型类型 | Completion(补全,FIM)、Chat(对话,兼容 OpenAI 规范)、Embedding(上下文检索,默认 Nomic-Embed-Text) |
| 推理设备 | cuda、metal(Apple
Silicon)、vulkan、cpu;CPU
可运行小参数模型 |
| 编辑器扩展 | VSCode、Vim、IntelliJ 平台等,见官方扩展文档 |
| 官方文档 | tabby.tabbyml.com/docs/welcome |
| 模型注册表 | tabby.tabbyml.com/docs/models |
1.2 适用场景
- 希望在公司内网或本机运行代码补全服务,代码与补全请求不离开自有网络。
- 团队共享一个 Tabby 实例:注册管理员账号、邀请成员、按团队查看使用活动与报告。
- 在消费级 NVIDIA / AMD / Apple Silicon 设备上部署小参数代码模型,替代需要上传代码到外部云服务的补全工具。
- 通过 HTTP 模型连接器接入 OpenAI、Ollama、vLLM、llama.cpp、Claude 等远程或私有端点,复用现有模型网关。
- 搭建面向内部工程团队的 Answer Engine:索引代码仓库与内部文档,在聊天与内联问答中提供上下文相关回答。
- 二次开发与研究:基于 OpenAPI 把 Tabby 补全能力接入自研 Cloud IDE 或代码评审流程。
1.3 能力边界(官方口径)
- 官方 README 自述三大特点:独立运行、无需 DBMS 或云服务;提供 OpenAPI 便于接入现有基础设施(如 Cloud IDE);支持消费级 GPU。
- Tabby 自身不打包模型权重:本地模型需从模型注册表选择并在启动时下载,远程模型通过 HTTP 连接器调用对应提供者接口;模型许可、计费与能力边界由模型提供者决定。
- 官方 FAQ 说明:Tabby 仅支持单张 NVIDIA GPU;多卡场景需要启动多个
Tabby 实例并通过
CUDA_VISIBLE_DEVICES/HIP_VISIBLE_DEVICES分别绑定。 - 官方明确提示不支持降级(does not support downgrade),升级前必须备份数据库;数据目录不建议放在 NFS 等存在文件锁缺陷的网络文件系统上。
- 企业级功能(部分账号、SSO、LDAP、团队与报表等)位于
ee/目录并受独立许可约束;社区版可用能力以安装版本与官方管理文档为准。
2 功能特性
2.1 自包含、低外部依赖
- 内置 SQLite 保存账号、配置、索引与事件日志,不需要单独部署
PostgreSQL 或 MySQL;数据集中在
~/.tabby目录,备份与迁移围绕该目录展开。 - 提供 OpenAPI 接口,补全、聊天、索引等能力可被第三方编辑器或自研平台直接调用。
2.2 三类模型独立配置
- Completion 模型:面向代码补全,主要采用 Fill-in-the-Middle(FIM)提示格式,根据光标前后内容生成候选代码。
- Chat 模型:面向对话与内联问答,广泛兼容 OpenAI
规范;HTTP 连接器支持配置
supported_models在聊天界面动态切换模型。 - Embedding 模型:把代码仓库与文档索引成语义向量,聊天时检索相关片段;默认使用 Nomic-Embed-Text。
2.3 本地模型与远程模型双模式
- 本地模式:Tabby 通过 llama.cpp 子进程加载注册表内模型,命令行
--model、--chat-model指定模型 ID;也支持按模型规范放入本地目录后传路径加载。 - 远程模式:通过 HTTP 连接器直连 OpenAI 风格聊天接口、Ollama
补全、vLLM、llama.cpp 等端点,在
~/.tabby/config.toml中配置kind、api_endpoint、api_key与prompt_template。
2.4 多编辑器扩展与端到端优化
- 提供 VSCode、Vim、IntelliJ 等扩展;官方理念强调补全体验是整条链路的结果:除模型能力外,扩展侧的流式返回、取消、自适应缓存与上下文组装同样影响响应速度与候选质量。
- 扩展支持行内补全多候选、侧边栏聊天、
@提及文件作为上下文、聊天命令内联编辑、自动生成提交信息等能力(具体以扩展版本为准)。
2.5 仓库上下文与 Answer Engine
- 对仓库级代码做索引,补全与问答时融合仓库上下文;支持导入内部文档作为上下文来源。
- Answer Engine 面向内部工程团队集中知识,可切换后端聊天模型,把问答结果沉淀为可分享的页面;后台任务(索引、导入)在管理界面给出通知。
2.6 团队管理与集成
- 首个注册账号自动成为管理员(owner 角色);可邀请成员加入实例。
- 支持 GitHub / GitLab SSO、自托管 GitHub / GitLab 集成、LDAP 认证、活动页面与团队使用报表;管理员可在 Information > System 页面查看各模型连接状态卡片。
3 官方界面预览
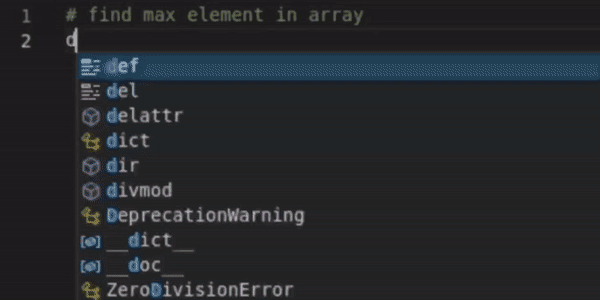
下图为官方 README 中的编辑器演示:在深色编辑器中输入 d
后,Tabby 弹出内联补全候选列表,展示
def、del、delattr、dict、dir、divmod
等 Python 关键字与内置对象;补全候选由 Completion
模型结合当前文件上下文生成,候选数量、排序与可取消行为由编辑器扩展与模型共同决定。
部署成功后,浏览器访问 http://localhost:8080 可进入
Tabby
管理首页:首个注册账号为管理员,首页展示账号信息与连接编辑器所需凭据;成员管理、模型卡片、索引任务与通知分别位于
Settings 与管理界面对应页面,具体菜单以安装版本为准。
4 官方跳转链接汇总
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库主页 | https://github.com/TabbyML/tabby | 服务端与扩展相关源码 |
| 官方文档 | https://tabby.tabbyml.com/docs/welcome/ | 安装、配置、管理与扩展说明 |
| 模型注册表 | https://tabby.tabbyml.com/docs/models/ | 推荐补全 / 聊天 / Embedding 模型与许可 |
| 模型排行 | https://leaderboard.tabbyml.com | 质量、许可与模型体积的选型参考基准 |
| VSCode 扩展 | https://marketplace.visualstudio.com/items/TabbyML.vscode-tabby | VSCode / VSCode 系编辑器安装入口 |
| JetBrains 扩展 | https://plugins.jetbrains.com/plugin/22379-tabby | IntelliJ 平台扩展 |
| 扩展文档 | https://tabby.tabbyml.com/docs/extensions/ | 各编辑器连接方式 |
| Releases | https://github.com/TabbyML/tabby/releases | 版本发布与独立压缩包下载 |
| Issues | https://github.com/TabbyML/tabby/issues | Bug 跟踪与功能反馈 |
| Slack 社区 | https://links.tabbyml.com/join-slack | 使用交流与排障求助 |
| 路线图 | https://tabby.tabbyml.com/docs/roadmap/ | 官方规划与进展 |
| 博客 | https://tabby.tabbyml.com/blog/ | 模型集成、上下文机制等技术文章 |
5 前置要求与服务器配置
5.1 软件前提
- Docker Engine:Docker 部署方式需要本机安装 Docker;使用 CUDA 后端还需先安装 NVIDIA Container Toolkit。
- 显卡驱动与 CUDA 工具链(GPU 版):NVIDIA
显卡安装对应驱动;独立包 GPU 版需要 CUDA 11 或更高版本,可用
nvcc --version核对;AMD 方案走 ROCm / Vulkan,非 NVIDIA 可选 Vulkan 压缩包。 - 网络:首次启动本地模型需要从模型来源下载权重;远程模型方案只需能访问对应 API 端点。
- 编辑器:按团队习惯在 VSCode、Vim、IntelliJ 等编辑器中安装 Tabby 扩展并填入服务地址与令牌。
5.2 硬件建议(官方 FAQ 口径)
| 模型规模 | 官方建议硬件 |
|---|---|
| 1B–3B 补全模型 | NVIDIA T4、10 系列、20 系列,或 Apple Silicon(M1 等) |
| 7B–13B 补全模型 | NVIDIA V100、A100、30 系列、40 系列 |
| 显存参考 | CUDA 默认 int8 模式下,CodeLlama-7B 约占用 8GB 显存;实际占用随量化与序列长度变化 |
| 精度与算力 | int8:Compute Capability ≥ 7.0 或 6.1;float16:≥ 7.0;bfloat16:≥ 8.0 |
| 多卡 | 官方仅支持单 GPU;多卡需启动多个实例,分别绑定
CUDA_VISIBLE_DEVICES(CUDA)或
HIP_VISIBLE_DEVICES(ROCm) |
| CPU | 可运行 1B 级别小模型,延迟较高;团队共享实例不建议只靠 CPU |
| Apple Silicon | 经 Accelerate 与 CoreML / Metal 在边缘设备运行,M1/M2 算力有限,适合个人使用,团队共享建议改用 CUDA / ROCm Docker 主机 |
5.3 端口、目录与环境变量
| 项 | 默认值 | 用途 |
|---|---|---|
| 服务端口 | 8080 |
浏览器管理界面与编辑器 API;可用 --port 修改 |
| 数据目录 | ~/.tabby |
数据库、日志、配置文件 config.toml、事件与模型缓存;用
TABBY_ROOT 覆盖 |
| 数据库 | ~/.tabby/ee/db.sqlite |
SQLite 主库 |
| 事件日志 | ~/.tabby/events/<YYYY-MM-DD>.json |
按日期落盘的 JSON 事件记录 |
| 调试日志 | RUST_LOG |
控制服务日志级别,排障时设置为 debug |
| 反向代理 | 支持 | 必须放行 WebSocket,Answer Engine 流式输出依赖长连接 |
不要把数据目录放在 NFS 上:SQLite 依赖可靠文件锁,多数网络文件系统锁实现不完整,可能导致数据库损坏。
6 方式一:Docker 与 Docker Compose 部署(推荐)
6.1 CUDA 环境下单容器启动
官方 Docker 文档(安装 NVIDIA Container Toolkit 后):
docker run -d \
  --name tabby \
  --gpus all \
  -p 8080:8080 \
  -v $HOME/.tabby:/data \
  registry.tabbyml.com/tabbyml/tabby \
  serve \
  --model StarCoder-1B \
  --chat-model Qwen2-1.5B-Instruct \
--device cuda- 端口
-p 8080:8080;数据卷映射到容器内/data。 - 容器镜像名在官方 README 中为
tabbyml/tabby,文档站点使用registry.tabbyml.com/tabbyml/tabby,二者对应同一镜像,按网络可达性选择。 - 启用 SELinux 的系统,数据卷追加
:Z选项:
docker run -d \
  --name tabby \
  --gpus all \
  -p 8080:8080 \
  -v $HOME/.tabby:/data:Z \
  registry.tabbyml.com/tabbyml/tabby \
  serve --model StarCoder-1B --chat-model Qwen2-1.5B-Instruct --device cuda
6.2 CPU / 无显卡环境启动
去掉 --gpus all,并把 --device 改为
cpu(小参数模型方可流畅运行):
docker run -d \
  --name tabby \
  -p 8080:8080 \
  -v $HOME/.tabby:/data \
  registry.tabbyml.com/tabbyml/tabby \
  serve --model StarCoder-1B --chat-model Qwen2-1.5B-Instruct --device cpu
6.3 Docker Compose 方式
# docker-compose.yml
version: '3.5'

services:
  tabby:
    restart: always
    image: registry.tabbyml.com/tabbyml/tabby
    command:
      - serve
      - --model StarCoder-1B
      - --chat-model Qwen2-1.5B-Instruct
      - --device cuda
    volumes:
      - "$HOME/.tabby:/data"
    ports:
      - 8080:8080
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]
启动与查看日志:
docker compose up -d
docker compose logs -f tabby
6.4 首次注册管理员
服务启动后访问
http://localhost:8080,第一个注册的账号即为管理员(owner);登录后进入首页,即可看到连接编辑器所需的服务地址与令牌,再在
VSCode / Vim / IntelliJ 扩展中填入对应信息。需要邀请成员时,在首页进入
Settings → Members 操作。
7 方式二:各平台独立安装与源码本地构建
7.1 macOS(Apple Silicon,Homebrew)
官方借助 Accelerate 与 CoreML / Metal 在边缘设备获得可用推理速度:
brew install tabbyml/tabby/tabby

# 启动服务(Metal 设备)
tabby serve --device metal --model StarCoder-1B --chat-model Qwen2-1.5B-Instruct
需要更换端口时追加 --port;查看全部启动选项:
tabby serve --help7.2 Linux 独立压缩包
在 Releases 页面 Assets 中下载对应压缩包:
- 纯 CPU 系统:
tabby_x86_64-manylinux2014.zip - NVIDIA GPU(CUDA 11.7
示例):
tabby_x86_64-manylinux2014-cuda117.zip - 非 NVIDIA
显卡:
tabby_x86_64-manylinux2014-vulkan.zip
# 解压后进入目录启动(CUDA 示例)
./tabby serve --model StarCoder-1B --chat-model Qwen2-1.5B-Instruct --device cuda
CUDA 11 或更高版本可用 nvcc --version 核对;Vulkan
版需安装 libvulkan1(Ubuntu)。文档索引开发者上下文可选安装
Katana 爬取后端(最低 1.1.2 版本),用于在 llms.txt
不可用时抓取开发者文档。
7.3 Windows 独立可执行文件
在 Releases 中选择
tabby_x86_64-windows-msvc.zip(CPU)或
tabby_x86_64-windows-msvc-cuda117.zip(CUDA);解压后进入
dist\tabby_x86_64-windows-msvc-cuda117 目录,在命令提示符或
PowerShell(管理员)中执行:
# CPU 环境
.\tabby.exe serve --model StarCoder-1B --chat-model Qwen2-1.5B-Instruct

# CUDA 环境
.\tabby.exe serve --model StarCoder-1B --chat-model Qwen2-1.5B-Instruct --device cuda
看到启动成功提示后访问 http://localhost:8080。
7.4 Windows WSL2
- 安装 WSL2 与 Ubuntu(22.04 或 24.04 均可):
wsl --install -d Ubuntu          # Ubuntu 22.04
wsl --install -d Ubuntu-24.04 # Ubuntu 24.04- 进入 Ubuntu 终端后按第 7.2 节 Linux 指南安装;WSL2 负责 GPU 直通,无需额外适配。
- 服务在 Ubuntu 内运行后,Windows 浏览器通常通过
http://localhost:8080(或自定义端口)访问。
7.5 源码本地构建(开发者)
git clone --recurse-submodules https://github.com/TabbyML/tabby
cd tabby

# 已克隆仓库时补取子模块
git submodule update --recursive --init
安装依赖:
# macOS
brew install protobuf

# Ubuntu / Debian
sudo apt install protobuf-compiler libopenblas-dev

# Ubuntu 可选工具
sudo apt install make sqlite3 graphviz
先按 Rust 官方教程配置 Rust 环境,然后构建:
cargo build启动参数与独立包一致;具体可执行文件名、子命令与参数以
cargo build 产物输出与 tabby serve --help
为准,贡献流程遵循仓库 CONTRIBUTING.md。
7.6 接入编辑器扩展
- 在编辑器扩展市场安装 Tabby(VSCode / IntelliJ / Vim,链接见第 4 节)。
- 扩展中填写 Tabby 服务地址(如
http://localhost:8080)与首页生成的令牌。 - 等待模型加载完成,在代码文件中触发行内补全;侧边栏聊天可
@提及文件补充上下文。
8 配置项说明
8.1 配置文件位置
Tabby
默认不会自动创建配置文件;需要手动在数据目录创建
~/.tabby/config.toml(Docker 部署对应容器
/data/config.toml,即宿主机
$HOME/.tabby/config.toml)。文件可覆盖模型、补全、Answer
Engine 等行为。
8.2 本地模型配置
[model.completion.local]
model_id = "StarCoder2-3B"

[model.chat.local]
model_id = "Mistral-7B"

[model.embedding.local]
model_id = "Nomic-Embed-Text"model_id使用模型注册表中的 ID;也支持按 MODEL_SPEC 规范放入本地目录后传入目录路径。- Embedding 模型默认 Nomic-Embed-Text,用于仓库与文档索引。
8.3 远程模型(HTTP 连接器)
# 远程聊天模型(OpenAI 风格),可配置多模型切换
[model.chat.http]
kind = "openai/chat"
model_name = "gpt-4o"
supported_models = ["gpt-3.5-turbo", "gpt-4o", "gpt-4o-mini"]
api_endpoint = "https://api.openai.com/v1"
api_key = "your-api-key"

# Ollama 补全模型示例
[model.completion.http]
kind = "ollama/completion"
model_name = "codellama:7b"
api_endpoint = "http://localhost:11434"
prompt_template = "<PRE> {prefix} <SUF>{suffix} <MID>"

# vLLM 补全模型示例
[model.completion.http]
kind = "vllm/completion"
model_name = "your_model"
api_endpoint = "http://localhost:8000/v1"
api_key = "your-api-key"
prompt_template = "<PRE> {prefix} <SUF>{suffix} <MID>"

# 远程 Embedding 模型示例
[model.embedding.http]
kind = "openai/embedding"
model_name = "text-embedding-3-small"
api_endpoint = "https://api.openai.com/v1"
api_key = "your-api-key"- 不同补全模型需要不同
prompt_template,具体模板参考官方 Models HTTP API 文档与models.json。 - 配置完成后到 Information > System 页面查看各模型卡片连接状态,确认本地子进程或 HTTP 端点均已连通。
8.4 补全语言与 Answer Engine 自定义
# 补充内置识别之外的语言
[[additional_languages]]
languages = ["swift"]
exts = ["swift"]
line_comment = "//"
top_level_keywords = ["import", "let", "var", "func", "return"]

# 自定义聊天系统提示词(多行字符串使用三个双引号)
[answer]
system_prompt = """
You are "Tabby",
a coding assistant designed to help software developers.
"""
8.5 启动命令与环境变量
已在官方文档中明确出现的 serve 选项:
| 选项 | 说明 |
|---|---|
--model <模型 ID 或目录> |
Completion 本地模型 |
--chat-model <模型 ID> |
Chat 本地模型 |
--device cuda|metal|vulkan|cpu |
推理设备 |
--port <端口> |
服务端口,默认 8080 |
其他推理类型、并行度、序列长度、采样参数等选项请以
tabby serve --help与对应安装版本为准,本文不臆造未在官方文档列出的参数。
| 环境变量 | 说明 |
|---|---|
TABBY_ROOT |
覆盖默认数据目录 ~/.tabby |
RUST_LOG |
服务日志级别,排障时可设为 debug |
CUDA_VISIBLE_DEVICES |
多实例单卡绑定时指定可见 NVIDIA 显卡 |
HIP_VISIBLE_DEVICES |
AMD ROCm 多实例绑定时指定可见显卡 |
HSA_OVERRIDE_GFX_VERSION |
ROCm 未直接识别 AMD 显卡时,按相近受支持型号覆盖(如 RDNA2 设
10.3.0、RDNA3 设 11.0.0) |
8.6 反向代理配置
Tabby 作为 HTTP 服务可放在 Nginx 等反向代理之后;Answer Engine 流式输出使用 WebSocket,必须放行升级头。Nginx 片段:
location / {
  proxy_pass http://localhost:8080;
  proxy_set_header Host $host;
  proxy_set_header X-Real-IP $remote_addr;
  proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
  proxy_http_version 1.1;
  proxy_set_header Upgrade $http_upgrade;
  proxy_set_header Connection "upgrade";
}
9 常用运维命令
# ---- Docker ----
docker run -d --name tabby -p 8080:8080 -v $HOME/.tabby:/data \
  registry.tabbyml.com/tabbyml/tabby serve \
  --model StarCoder-1B --chat-model Qwen2-1.5B-Instruct --device cuda

docker logs -f tabby                        # 跟踪日志
docker stop tabby                           # 停止
docker restart tabby                        # 重启
docker pull tabbyml/tabby                   # 拉取最新镜像(升级前先备份)

# ---- Compose ----
docker compose up -d
docker compose logs -f tabby
docker compose down

# ---- 独立包 / 源码产物 ----
tabby serve --help                          # 查看全部启动选项
tabby serve --model StarCoder-1B --device cuda
RUST_LOG=debug tabby serve ...              # 调试日志级别

# ---- 数据库备份 ----
sqlite3 $HOME/.tabby/ee/db.sqlite
# 在 SQLite CLI 中执行:
# .backup backup_database.db

# ---- 事件日志 ----
ls ~/.tabby/events                          # 按日期命名的 JSON 事件文件
升级标准流程(官方口径):先备份数据库 → Docker 拉取最新镜像或替换独立可执行文件 → 重启 Tabby。Tabby 不支持降级,回退版本前需恢复备份数据库,不要在未备份的情况下跨版本升降级。
10 常见故障排查
10.1 浏览器打不开 8080 页面
- 确认容器或进程已启动:
docker ps/docker compose ps,查看docker logs -f tabby是否有启动报错或模型下载失败。 - 核对端口映射与
--port;反向代理场景检查代理是否放行 WebSocket 与正确转发Host头。 - 首次启动模型需要下载权重,网络受限时先确认模型来源可达。
10.2 GPU 未被识别或启动报设备错误
- CUDA 方案确认已安装 NVIDIA Container Toolkit,宿主机驱动与
nvcc --version达到 CUDA 11 以上;容器命令保留--gpus all与--device cuda。 - 无显卡或驱动不可用时改用
--device cpu,并选择 1B 级别小模型;Apple Silicon 使用--device metal。 - AMD ROCm 不被识别时按 FAQ 设置
HSA_OVERRIDE_GFX_VERSION;非 NVIDIA 显卡也可选择 Vulkan 压缩包与vulkan设备。
10.3 显存不足(OOM)
- 换用更小参数模型(1B–3B 区间);核对当前模型推荐显卡档位,7B–13B 模型需要 V100 / A100 / 30 系 / 40 系级别显存。
- CUDA 默认 int8 模式已显著降低显存占用;不要在不满足算力要求的老显卡上强制开启 float16 / bfloat16。
10.4 模型卡片显示未连接
- 进入 Information > System 查看 Completion / Chat / Embedding 三张卡片状态。
- 本地模型核对
model_id是否在注册表内、模型文件是否下载完整;远程模型核对kind、api_endpoint、api_key、网络连通性与模型名拼写。 - 补全模型连接 Ollama / vLLM 时补全
prompt_template,格式不匹配会导致候选为空或报错。
10.5 补全候选为空或质量差
- 确认当前文件语言在内置或
additional_languages配置中被识别;核对仓库索引任务是否完成。 - 换用注册表中评级更合适的模型;参考官方排行榜在质量、许可与模型体积之间取舍。
- 检查上下文(当前文件、仓库索引、
@提及文件)是否真正参与了提示词组装。
10.6 数据目录放在 NFS 后数据库损坏
官方 FAQ 明确不建议把 Tabby 根目录放在 NFS:SQLite 依赖可靠文件锁,网络文件系统锁实现缺陷会导致数据库损坏与异常行为。迁移到本地磁盘或受支持的块存储后,用备份数据库恢复,并验证事件目录与配置文件路径正确。
10.7 升级后异常或需要回退
Tabby 不支持直接降级版本。升级前用 sqlite3 .backup
备份数据库并保存 ~/.tabby
目录;升级后报错时先回滚到上一镜像 /
可执行文件,再恢复备份数据库,最后核对 Release 说明中的迁移提示。
10.8 后台索引 / 文档导入失败
- 观察管理界面通知框中的后台作业状态;文档开发者上下文索引需要 Katana(最低 1.1.2)时确认已安装且版本满足要求。
- 私有仓库与内部文档导入凭据、网络连通性按管理界面对应页面检查;索引量大时预留磁盘与内存余量。
10.9 多人共用同一实例卡顿
- 单实例并发受模型推理与本机资源限制;团队共享优先选用 GPU 服务器而非个人笔记本。
- 多卡场景启动多个 Tabby 实例并分别绑定显卡,由编辑器或上游负载分发到不同实例;不要在单实例上依赖多卡并行。
11 风险与合规说明
以下条款整理自官方 README、LICENSE、官方文档与模型注册表口径;如与官方原文不一致,以仓库
LICENSE、ee/LICENSE、tabby.tabbyml.com/docs 为准。
11.1 开源协议与企业功能
仓库 ee/ 目录之外的代码采用 Apache 2.0
许可证;ee/ 目录内容遵循独立
ee/LICENSE,账号体系、SSO、LDAP、团队管理、报表等企业功能的使用范围以该许可为准。第三方组件保留各自原始许可证。把
Tabby 嵌入商业产品、对外提供托管服务或修改品牌标识前,须先确认
ee/ 许可与 Apache 2.0
的义务(保留版权与许可证声明、标注修改等)。
11.2 模型权重与许可证风险
- Tabby 服务端不随仓库分发模型权重;注册表内模型许可各不相同,例如 StarCoder 系列为 BigCode-OpenRAIL-M、CodeLlama 为 Llama 2、CodeGemma 为 Gemma License、CodeQwen 为 Tongyi Qianwen License、Codestral-22B 为 Mistral AI Non-Production License、DeepSeek 系列为 Deepseek License,部分模型仅限非生产用途。
- 商用部署前必须逐一核对所选模型的许可证条款、地域与用途限制;远程接入第三方模型 API 时,同时受对应服务提供者的服务条款与隐私政策约束。
11.3 代码与数据隐私
- 自托管的主要价值在于补全上下文留在自有环境内;使用远程模型连接器时,代码片段会按提示词发送到配置的
api_endpoint,处理涉密仓库时优先选择本地模型或私有端点。 config.toml中的api_key、远程端点地址与团队成员信息属于敏感配置,文件权限按服务器最小权限管理,不要提交到公开仓库;备份数据库时同样按敏感数据保管。- 事件日志记录使用行为,团队推广前应向成员说明数据收集范围与用途。
11.4 生成代码可靠性
- 模型补全与聊天结果可能存在错误、不安全的 API 用法、许可证冲突或性能问题;Tabby 只是候选生成器,不替代代码评审、单元测试与安全扫描。
- 不要直接采纳未审阅的补全建议;对外发布的代码需人工核对依赖、版权归属与实现正确性。
11.5 商业使用与免责
Tabby 按现状(AS-IS)提供,不保证模型输出正确、不保证与特定编辑器、显卡或驱动组合持续兼容;使用者自行承担代码质量、数据泄露、服务中断、模型许可违约与业务损失风险。如认为仓库内特定文件侵犯合法权益,请通过 GitHub Issues 提交说明,不要在公开 Issue、配置示例或截图中提交 API Key、内部地址或私有代码片段。