

InvokeAI:带统一画布、节点工作流与模型管理的本地自托管生成式图像平台|部署与使用全指南
项目仓库: https://github.com/invoke-ai/InvokeAI
开源协议:Apache License 2.0(Copyright © 2022–2026 InvokeAI
Contributors) · 运行语言:Python 后端 + React/Vite 前端 ·
交付形态:官方 Launcher 桌面应用、ghcr.io Docker 镜像、uv
虚拟环境手动安装 · 默认端口:9090(默认绑定
127.0.0.1) · 官方文档:invoke.ai
非官方声明:本文是基于官方 README、官方文档站(invoke.ai)与仓库
docker/目录文件整理的部署使用指南,不代表 InvokeAI 团队立场。“Invoke” 品牌与各模型、采样器、扩展名称归各自权利人所有;本地模型权重、第三方节点包与云端 API 模型各自遵循其许可协议、服务条款与计费规则,使用者须自行确认合规边界。项目按现状(AS-IS)提供,本文不保证生成结果合规、可商用或持续可用。
1 项目简介
InvokeAI(界面内品牌名为 Invoke,社区常称 Invoke Community Edition)是一个开源的生成式图像平台:后端由 Python 实现,前端为本地托管的 Web 服务与 React 界面,围绕“画布创作 + 节点工作流 + 模型管理 + 图库画板”组织出图流程。官方 README 将其定位为面向专业人士与爱好者的创意引擎,既能完成提示词出图、图生图与局部重绘,也能通过节点工作流搭建可复用、可分享的生成流水线,并作为多款商业产品的基础。
项目本身不附带模型权重:首次启动后需要在 Model Manager(模型管理器)中安装本地模型,或配置云端模型的 API Key;SD 1.5、SDXL、FLUX 系列、Z-Image、Krea 等本地模型与若干仅 API 可用的模型各自有独立的许可与硬件要求。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | InvokeAI(界面品牌 “Invoke”,Community Edition) |
| 仓库地址 | github.com/invoke-ai/InvokeAI |
| 项目定位 | 本地自托管生成式图像平台:Web 服务 + React 界面、Unified Canvas、节点工作流、画板图库与模型管理器 |
| 开源协议 | Apache License 2.0;NOTICE 标注 Copyright 2022–2026
InvokeAI Contributors |
| 运行语言 | Python 后端;前端 React + Vite(webv2,旧版
webv1 同步构建);包管理使用 uv |
| Python 口径 | 手动安装文档要求 Python 3.11–3.12,建议
3.12;pyproject.toml 约束
>=3.12,<3.13;官方 Launcher 会自行安装匹配的
Python |
| 交付形态 | 官方 Launcher(Windows / macOS arm64 / Linux AppImage)、Docker 镜像
ghcr.io/invoke-ai/invokeai、uv 手动虚拟环境 |
| 默认端口 | 9090;默认绑定 127.0.0.1,通过
host: 0.0.0.0 或 INVOKEAI_HOST
提供局域网访问 |
| 本地入口 | 浏览器打开 http://localhost:9090;Docker 容器内
INVOKEAI_HOST=0.0.0.0 由 Compose 映射端口 |
| 运行根目录 | 默认 ~/invokeai(搜索顺序:--root 参数 →
INVOKEAI_ROOT 环境变量 → venv 所在目录 → 用户主目录
invokeai) |
| 配置文件 | 根目录下 invokeai.yaml,旁置
invokeai.example.yaml 默认值参考 |
| 官方文档 | invoke.ai · 安装指南 · YAML 配置 |
1.2 适用场景
- 在个人工作站上搭建一套长期使用的本地出图环境,用画布完成生成、局部重绘、外扩、参考图叠加、图层与蒙版编辑,并把整个画布状态保存为
.invk工程文件继续迭代。 - 把重复出图流程固化为节点工作流:串联模型加载、提示词、采样、放大、人脸修复、LoRA 应用等节点,形成可复用、可分享的流水线,并通过社区节点扩展能力。
- 在 Model Manager 中集中安装、扫描与管理 ckpt、diffusers 与部分 gguf 模型,管理 embedding、LoRA 与 VAE,图库按 Board(画板)分组保存、检索与二次调用历史图像。
- 服务器 / 多用户场景:开启多用户模式进行账号与权限管理,配合队列调度在多张 GPU 之间分配生成任务;或通过 Docker 在 Linux 服务器上以容器方式部署。
- 接入云端 API 模型作为本地模型能力的补充(README 标注 “API Only” 的模型类别),或在 ARM64 设备上以 CPU 模式运行 API 类模型。
1.3 能力边界(官方口径)
- 官方 README 自述为 “a leading creative engine”,提供“industry leading web-based UI”;出图质量、速度与显存占用由所选模型、图像尺寸、采样参数、显卡与内存共同决定,平台本身不承诺特定画质或生成速度。
- README 列出的模型支持清单分本地模型与 API Only 两类:SD 1.5、SD 2.0、SDXL、SD 3.5 Medium / Large、CogView 4、Flux.1 Dev / Schnell / Kontext / Krea、Flux Redux、Flux Fill、Flux.2 Dev、Flux.2 Klein 4B / 9B、Z-Image Turbo / Base、Krea 2 Turbo / Raw、Anima、Qwen Image、Qwen Image Edit、Ideogram 4、ERNIE-Image、ERNIE-Image-Turbo 等按架构支持;Nano Banana、GPT Image、Wan 标注为 API Only,需要对应服务的 API Key 与网络访问。
- 硬件支持以系统要求页为准:NVIDIA 为主要适配路径;AMD 仅 Linux(ROCm);Intel Arc 支持 Windows 与 Linux x86_64;Linux ARM64(aarch64,如树莓派 5)仅支持 CPU 模式;macOS 上 Docker 无法访问 GPU,官方建议直接使用 Launcher 本地安装。
- 模型文件本身遵循各自发布方许可;社区节点(community nodes)与第三方模型不在官方安全审计范围内。多用户模式为显式可选功能,默认关闭时运行在单用户系统管理员账号下。
- 文档明确:旧版
install/invoke脚本将逐步停止维护,新部署优先使用 Launcher、Docker 或手动 uv 虚拟环境;无头服务器上由使用者按手动指南自行组织启动脚本。
2 功能特性
以下条目整理自官方 README 特性清单、官方文档站 Concepts / Features
章节与仓库 docker/
目录说明;具体菜单名称与可用模型以安装版本为准。
2.1 本地 Web 服务与 React 界面
- Invoke 在本机启动一个自托管 Web 服务,前端为 React
单页应用;浏览器访问
http://localhost:9090即可使用,无需依赖第三方在线绘图网站。 - 界面包含顶部模型 / 工作区切换、左侧参数面板、中央画布与右侧节点 / 图库面板;支持快捷键、悬停说明与深色视觉风格。
2.2 Unified Canvas(统一画布)
- 画布是集成化创作工具,覆盖核心生成能力、内绘 / 外绘(in/out-painting)、画笔工具、参考图与图层;可用于改造 AI 生成图、草图、照片与渲染图。
- 画布工具栏提供边界框、套索、渐变、形状、文本工具等编辑手段;生成结果可在画布内反复细化。
- Canvas
Projects:把整个画布状态——全部栅格层、重绘层、控制层及其图像数据、变换、不透明度与锁定状态、蒙版、参考图、生成参数与
LoRA——保存为单个
.invk文件;.invk本质是 ZIP 压缩包,在服务器可取到图片时会内嵌各层与参考图的实际字节,工程可自包含地在另一台机器打开或分享。
2.3 Nodes 与 Workflows(节点与工作流)
- 节点(Node):一次接收输入、返回输出的独立操作;节点左侧为输入连接点,右侧为输出连接点,选项既可手动配置,也可由其他节点的输出覆盖。官方口径:InvokeAI 的全部功能都通过节点挂载。
- 工作流(Workflow):把多个节点按连线关系组合成自定义、可重复的生成流程;Node Editor 提供节点编辑界面,可扩展适配具体生产场景。
- 社区节点由社区维护并在官方文档的 Community Nodes 目录中索引;新节点下载后即可在工作流中使用。
2.4 Board 与 Gallery(画板图库)
- 图库面板用于快速浏览、查找与复用已生成和已加载的图片、视频;图库按
Board(画板) 组织,
Uncategorized为默认画板,可自建画板分类。 - 画板是多态的:图片与视频共存于同一画板,按创建时间排序;图片可拖放到任意基于图像的界面元素上,图像内嵌的元数据便于回想起当初使用的提示词与参数。
2.5 模型管理与格式支持
- Model Manager:在界面内安装模型、扫描已有目录、登记模型元数据;首次启动会引导进入模型管理器。
- 模型格式支持 ckpt、diffusers 与部分 gguf;另有 Embedding Manager 管理文本嵌入;Model Manager 负责模型注册表、哈希与目录扫描。
- 内置放大工具链;支持 SAM / SAM2 一类对象分割与选择模型辅助抠图与选区。
2.6 多模型架构与云端接入
- 本地架构覆盖 README 清单中的 SD 家族、SDXL、FLUX 家族、Z-Image、Krea、Qwen Image、ERNIE-Image、Ideogram 等;FP8、SDNQ 量化、低显存模式、FP8 存储等量化与压缩手段用于压低显存门槛(详见官方 Low-VRAM、FP8 Storage、SDNQ 文档页)。
- API 类模型通过配置对应提供者的 API Key 接入;配置项中提供 OpenAI、Gemini、阿里云 DashScope、Seedream 等外部模型提供者的 Key 与 Base URL 覆盖项。
2.7 多 GPU、队列与多用户
- 多 GPU 场景下可为每张 GPU 各运行一个生成会话;队列默认
round_robin轮询调度,单个用户的大批量任务不会独占全部 GPU;也可切回FIFO严格先进先出。 - 开启
multiuser后进入多用户模式,要求账号认证与授权,由管理员创建用户并管理会话;关闭时默认单用户、内置系统管理员账号。 - 模型缓存、部分加载、权重 RAM 副本、注意力类型、 tiled decode
等内存策略均可在
invokeai.yaml中按硬件调优。
3 官方界面预览
3.1 Canvas 与 Workflows 双视图
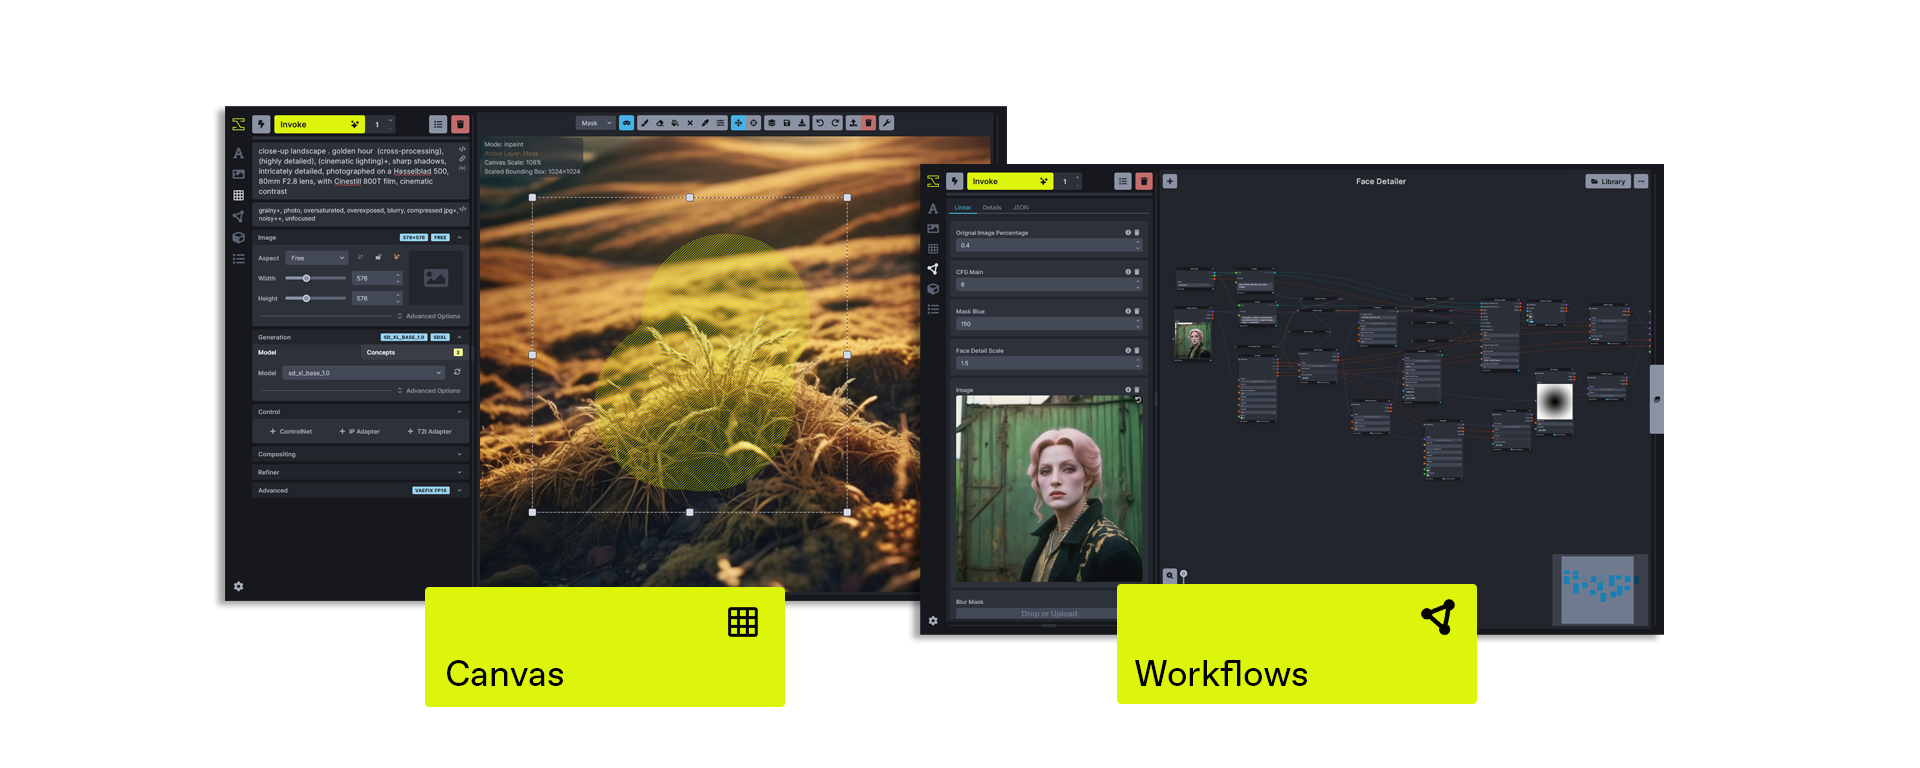
下图为官方 README 中的功能总览图:左侧为 Unified Canvas,提示词、参考图、模型、ControlNet / IP Adapter / T2I Adapter 等参数在左栏配置,中央画布展示边界框、蒙版与局部重绘结果;右侧为节点式 Workflows 编辑器,节点连线构成 Face Detailer 一类后处理流水线。
3.2 官方 Launcher 启动窗口
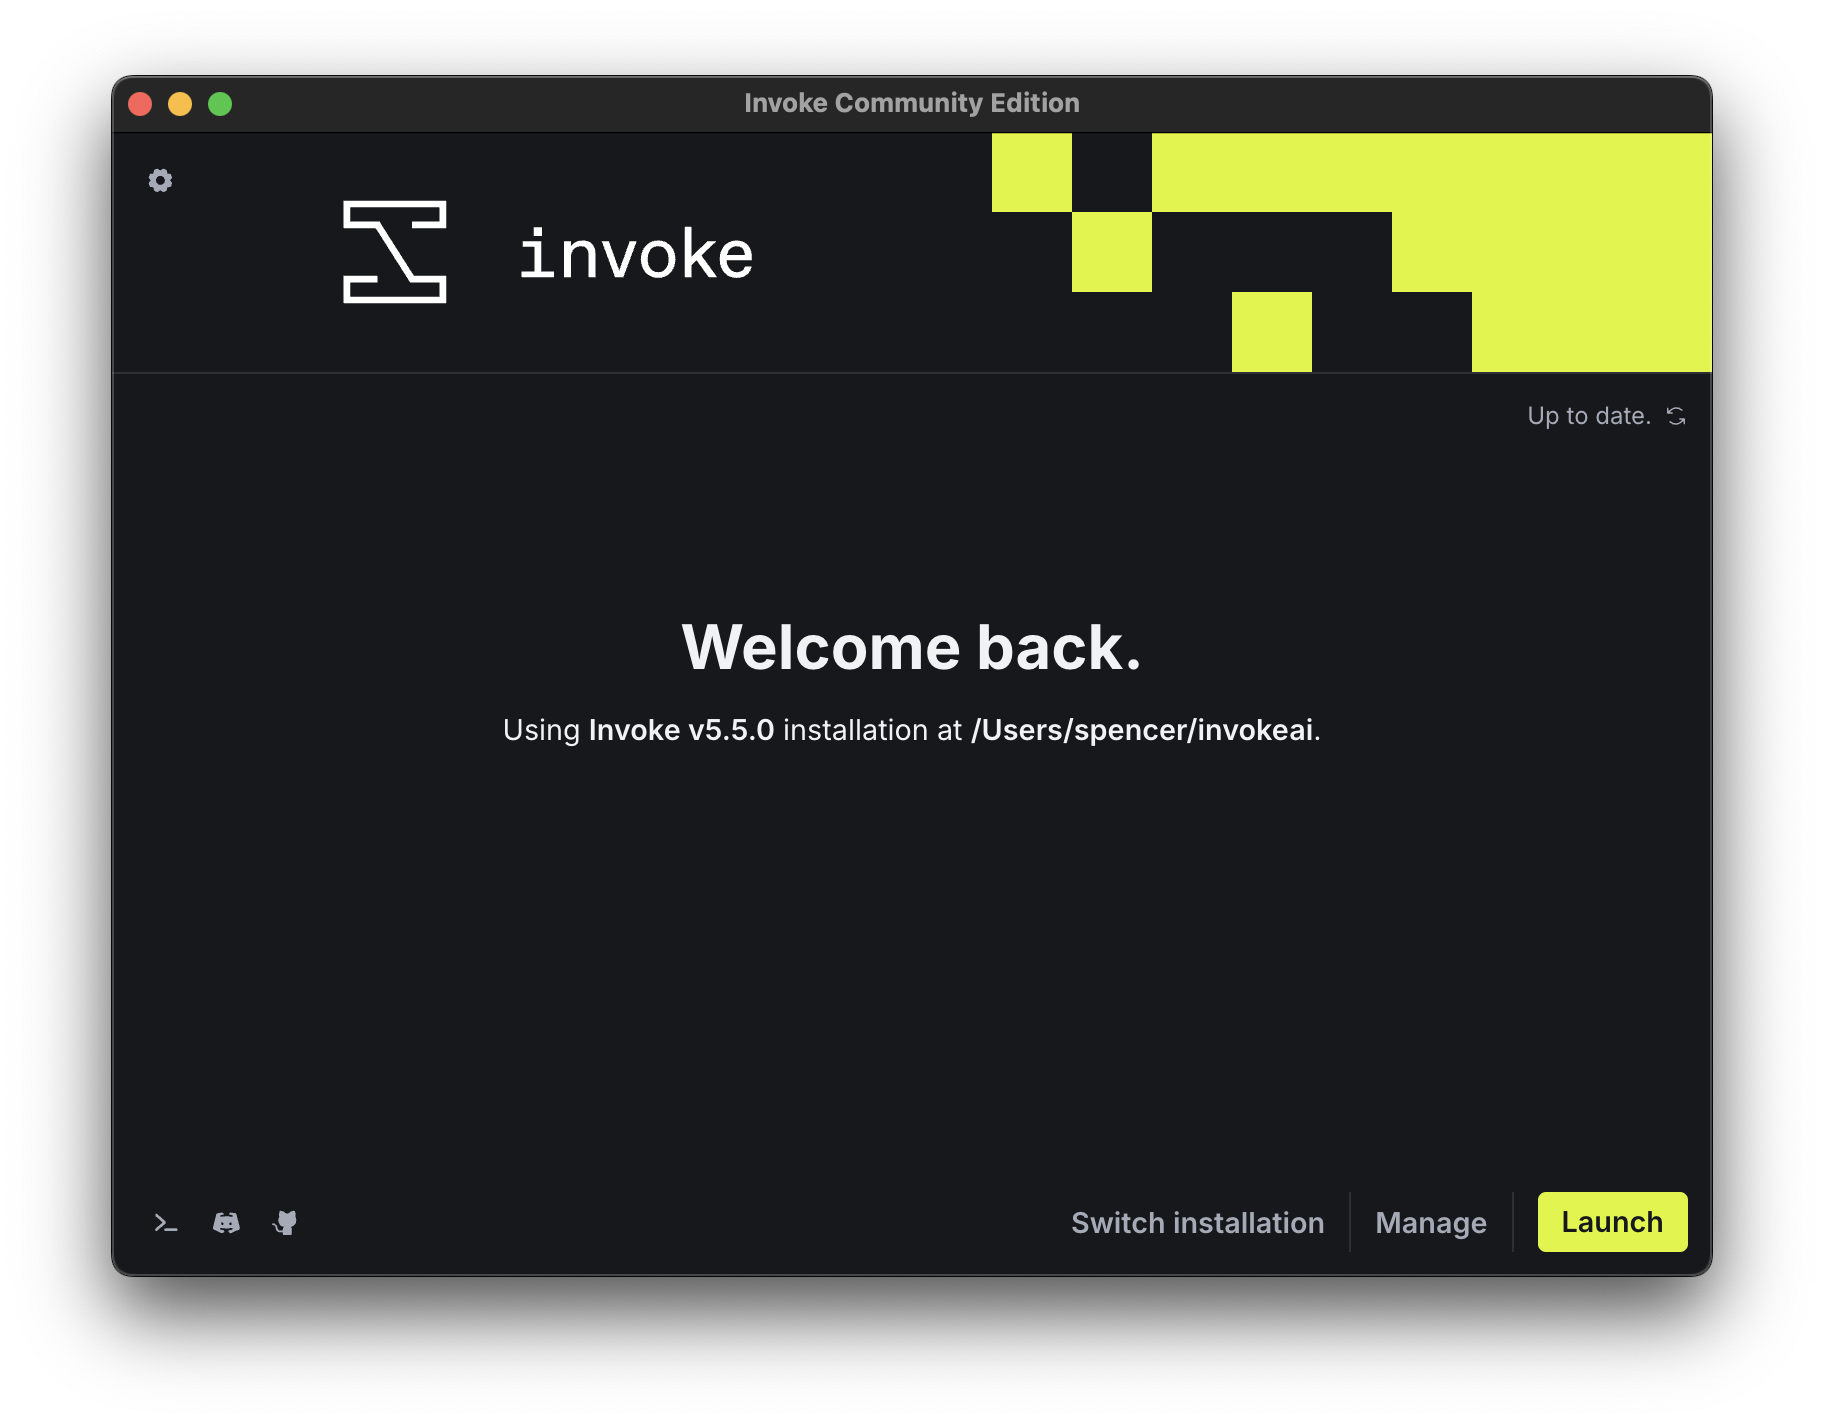
下图为官方 Launcher 仓库 README 中的欢迎窗口:Launcher 负责安装、更新、修复与启动 Invoke 安装实例,底部提供 Switch installation(切换安装实例)、Manage(管理)与 Launch(启动)操作;窗口右上角显示版本是否为最新。
4 官方跳转链接汇总
5 前置要求与环境配置
5.1 操作系统与运行时
- 操作系统:Windows 10 及以上、macOS 14 及以上、Linux(Ubuntu 20.04 及以上经过较好测试)。AMD 显卡仅支持 Linux;Intel Arc 支持 Windows 与 Linux x86_64;Linux ARM64(aarch64,如树莓派 5、其他单板机与 ARM 服务器)仅 CPU 模式。
- Python:使用官方 Launcher 时无需手动安装
Python,Launcher 自带并管理 Python;手动安装要求 Python 3.11–3.12,建议
3.12,
python3 --version核验版本。Windows 安装官方安装器时勾选加入 PATH,必要时补装 Microsoft Visual C++ Redistributable;macOS 若模型安装报证书错误,运行对应版本的Install Certificates.command,并通过xcode-select --install安装 XCode 命令行工具。 - Linux 系统库:OpenCV 所需基础库,Debian 系:
sudo apt update && sudo apt install -y libglib2.0-0 libgl1-mesa-glx- Docker:仅容器化部署需要;Linux 需安装 Docker
Engine 与 Compose 插件(旧版连字符
docker-compose可能不兼容),并按 NVIDIA / AMD 文档配置容器运行时;Windows GPU 场景需要 WSL2。 - 显卡驱动:NVIDIA 用
nvidia-smi核验驱动与 CUDA;AMD Linux 用rocm-smi核验 ROCm;Intel Arc 需较新驱动,并用python -c "import torch; print(torch.xpu.is_available(), torch.xpu.device_count())"核验设备可见性。
5.2 硬件与显存建议
官方系统要求页按模型家族给出粗略指引(低显存通常仍可运行,只是更慢,具体以 Low-VRAM 指南为准):
| 模型家族 | 最佳分辨率 | 参考显卡系列 | 最低显存 | 最低内存 | 备注 |
|---|---|---|---|---|---|
| SD 1.5 | 512×512 | NVIDIA 10xx 及以上 | 4GB | 8GB | — |
| SDXL | 1024×1024 | NVIDIA 20xx 及以上 | 8GB | 16GB | — |
| FLUX.1 | 1024×1024 | NVIDIA 20xx 及以上 | 10GB | 32GB | — |
| FLUX.2 Klein 4B | 1024×1024 | NVIDIA 30xx 及以上 | 12GB | 16GB | FP8 可 8GB+;Diffusers + encoder |
| FLUX.2 Klein 9B | 1024×1024 | NVIDIA 40xx | 24GB | 32GB | FP8 可 12GB+;Diffusers + encoder |
| Z-Image Turbo | 1024×1024 | NVIDIA 20xx 及以上 | 8GB | 16GB | Q4_K 8GB;Q8 / BF16 16GB+ |
| Krea-2(Turbo / Raw) | 1024×1024 | NVIDIA 40xx | 24GB | 32GB | FP8 16GB+;GGUF Q4_K 约 12GB;Diffusers 约 26GB |
| Wan 2.2 A14B(T2V / I2V) | 1280×720 | NVIDIA 30xx 及以上 | 12GB | 32GB | 双专家 MoE;Q4_K_M 12GB;Q8 18GB+;Diffusers 32GB+ |
| Wan 2.2 TI2V-5B | 1280×720 | NVIDIA 20xx 及以上 | 8GB | 16GB | 单 transformer;Q4_K_M 6GB+;Q8 8GB+;Diffusers 12GB+ |
- Apple Silicon:M1、M2 等全部 Mac 均可运行,建议内存 16GB 及以上;统一内存承担显存与系统内存双重角色。
- ARM64 Linux:无 GPU 时本地生成较慢,API 类模型(如 GPT Image、Gemini)不依赖本机 GPU,可以正常工作。
- 磁盘:为模型目录、输出图库、下载缓存与工作流缩略图预留充足空间;单个大模型权重数
GB 起,建议把
models_dir与outputs_dir放到空间充裕的磁盘。 - 临时目录:Linux 上若
/tmp挂载为 tmpfs,需保证其空间充足。
5.3 端口、目录与网络
| 项 | 默认值 | 用途与说明 |
|---|---|---|
| Web 端口 | 9090 |
INVOKEAI_PORT / port 配置;容器 Compose
默认映射 ${INVOKEAI_PORT:-9090}:${INVOKEAI_PORT:-9090} |
| 绑定地址 | 本机模式 127.0.0.1 |
host / INVOKEAI_HOST 设为
0.0.0.0 后供局域网访问;容器内默认
0.0.0.0 |
| 运行根目录 | ~/invokeai |
含
models/、outputs/、databases/、workflow_thumbnails/、style_presets/、nodes/、configs/、fonts/、profiles/
与 invokeai.yaml |
| 模型目录 | models/ |
models_dir 可改到外置磁盘;下载缓存
models/.download_cache,转换缓存
models/.convert_cache |
| 输出目录 | outputs/ |
生成图片 / 视频;image_subfolder_strategy 可选
flat / date / type /
hash |
| 数据库目录 | databases/ |
图库、模型注册表与队列状态 |
| 自定义节点目录 | nodes/ |
custom_nodes_dir 指向社区节点安装位置 |
| 环境变量前缀 | INVOKEAI_ |
invokeai.yaml
中设置项均可加该前缀转为环境变量;非原始类型传 JSON 编码字符串 |
把界面暴露到局域网或公网前,应在
invokeai.yaml开启多用户模式并配置账号,或在反向代理层叠加鉴权;未鉴权的共享实例等价于把本机模型与出图能力开放给所有访问者。
6 方式一:Docker / Compose 部署(服务器与自托管推荐)
官方在仓库 docker/ 目录提供
Dockerfile、docker-compose.yml、.env.sample 与
run.sh 便捷脚本;Linux(含 WSL2)是 GPU
容器化的推荐环境,macOS 上 Docker 无法访问 GPU,官方建议改用 Launcher
本地安装。
6.1 快速启动(单条命令,无持久化)
NVIDIA(CUDA)GPU:
docker run --runtime=nvidia --gpus=all --publish 9090:9090 ghcr.io/invoke-ai/invokeaiAMD(ROCm,Linux):
docker run --device /dev/kfd --device /dev/dri --publish 9090:9090 ghcr.io/invoke-ai/invokeai:main-rocm容器启动完成后浏览器打开
http://localhost:9090,在模型管理器中安装模型即可开始生成。
需要持久化生成图与模型时,追加数据卷挂载:
docker run --runtime=nvidia --gpus=all \
  --publish 9090:9090 \
  --volume /some/local/path:/invokeai \
  ghcr.io/invoke-ai/invokeai
挂载宿主机目录即作为容器内 /invokeai
运行根目录;该目录通常可在不同 Invoke
安装之间复用,但跨大版本升级前请先阅读发行说明。
6.2 Compose 方式部署
- 克隆仓库并进入
docker/目录:
git clone https://github.com/invoke-ai/InvokeAI.git
cd InvokeAI/docker- 复制环境变量样例并按需修改:
cp .env.sample .env- 启动对应服务:
# 方式 A:使用官方便捷脚本(读取 .env 中的 GPU_DRIVER 选择 profile 并跟踪日志)
./run.sh

# 方式 B:标准 Compose 命令(默认 CUDA 服务)
docker compose up
docker-compose.yml 内置三个服务:
| 服务 | Profile | 说明 |
|---|---|---|
invokeai-cuda |
默认 | NVIDIA CUDA,通过 nvidia 驱动预留 1 个 GPU |
invokeai-cpu |
cpu |
纯 CPU
服务,docker compose --profile cpu up invokeai-cpu |
invokeai-rocm |
rocm |
AMD ROCm,runtime: amd,注入
AMD_VISIBLE_DEVICES=all 与
RENDER_GROUP_ID,docker compose --profile rocm up invokeai-rocm |
run.sh 的行为:先 touch .env
保证文件存在;解析 .env 中的构建参数;以
GPU_DRIVER(缺省 cuda)作为 profile
与服务名,执行 docker compose build <service>,再
docker compose --profile <profile> up -d <service>
并 logs -f 跟踪日志。使用 run.sh 时
Ctrl+C 只会退出日志跟踪,容器继续运行,停止需执行
docker compose down。
6.3 容器环境变量(.env)
| 变量 | 默认值 | 用途 | 是否必填 |
|---|---|---|---|
INVOKEAI_ROOT |
~/invokeai |
宿主机上 Invoke 数据根目录,存放模型、配置与输出;建议显式设置为绝对路径 | 强烈建议 |
HOST_INVOKEAI_ROOT |
${INVOKEAI_ROOT:-~/invokeai} |
宿主机文件系统中的数据目录;相对路径相对
docker-compose.yml 所在目录 |
否 |
CONTAINER_INVOKEAI_ROOT |
/invokeai |
容器内运行根目录,必须为绝对路径,一般无需修改 | 否 |
INVOKEAI_PORT |
9090 |
界面端口,宿主机与容器同端口映射 | 否 |
GPU_DRIVER |
cuda |
镜像构建后端:cuda / rocm /
cpu;ARM64(aarch64,如树莓派 5)必须使用
cpu |
按硬件 |
RENDER_GROUP_ID |
未设置 | ROCm 场景宿主机 render 组 ID,宿主机执行
getent group render 获取 |
AMD 必填 |
CONTAINER_UID |
1000 |
容器内运行用户 UID,保证挂载目录文件属主正确;宿主机执行
id -u 获取 |
否 |
HUGGING_FACE_HUB_TOKEN |
未设置 | 访问 Hugging Face 私有仓库模型所需 Token;不设置时多数公开模型仍可下载 | 按需 |
HF_HOME |
~/invokeai/.cache/huggingface |
Hugging Face 缓存目录,Compose 同时把宿主机缓存挂载进容器 | 否 |
6.4 不同平台注意事项
- Linux(推荐):确保守护进程启用 buildkit;安装
Compose 插件;按 NVIDIA Container Toolkit 或 AMD ROCm 文档配置容器 GPU
访问;GPU 加速仅支持
x86_64,arm64/aarch64镜像为纯 CPU。 - Windows:Docker Desktop 自带 GPU 支持;NVIDIA
方案需 WSL2;克隆仓库后若
docker-entrypoint.sh报no such file or directory,通常是 Windows CRLF 行尾导致,把文件转为 LF(VSCode 右下角行尾切换,或 WSL2 中dos2unix),必要时git checkout docker/docker-entrypoint.sh重置。 - macOS:Docker 无法访问 GPU,出图速度慢,官方建议直接安装 Launcher;若仍要在 Docker 中试用,需在 Docker Desktop 中分配至少 16GB 内存、开启 VirtioFS 共享并启用 Compose V2。
- ARM64 CPU 镜像构建:
# 本地构建 ARM64 CPU 镜像
docker build -f docker/Dockerfile --build-arg GPU_DRIVER=cpu -t invokeai:cpu .

# 从 x86_64 主机交叉编译 arm64 镜像
docker buildx build --platform linux/arm64 -f docker/Dockerfile --build-arg GPU_DRIVER=cpu -t invokeai:arm64-cpu .
6.5 反向代理与网络
- 界面经反向代理挂在子路径时,在
invokeai.yaml设置base_url(如/invoke);代理保留子路径时必填,代理剥离子路径时也建议设置以保证 OpenAPI / 文档地址正确;forwarded_allow_ips填反向代理 IP。 - CORS 通过
allow_origins、allow_credentials、allow_methods、allow_headers配置;HTTPS 可由ssl_certfile与ssl_keyfile提供,生产环境更常见的做法是由代理层终结 TLS。
7 方式二:本地安装与源码 / 开发运行
7.1 官方 Launcher 桌面安装(推荐个人用户)
Launcher 是官方 Electron 桌面应用,覆盖 Windows、macOS(Apple
Silicon)与 Linux,自带 uv 与匹配的
Python,负责安装、更新、修复与启动 Invoke 实例,无需手动准备 Python
版本。
下载入口(来自 launcher 仓库 README):
- Windows:
Invoke.Community.Edition.Setup.latest.exe,运行 EXE 安装并启动,桌面会生成快捷方式,安装完成后可删除下载的 EXE。 - macOS:
Invoke.Community.Edition-latest-arm64.dmg,打开 DMG 把应用拖入 `Applications`,从启动台运行,安装后可删除 DMG。 - Linux:
Invoke.Community.Edition-latest.AppImage,按需在文件属性中赋予可执行权限,可选移动到非管理员目录并添加桌面快捷方式,双击 AppImage 或快捷方式启动。
安装与更新流程:
- 启动 Launcher,点击 Install 按引导安装或更新 Invoke;已有安装实例可在 Launcher 中选择并交由其管理、更新与启动。
- Launcher 启动时会自检自身与 Invoke 版本:自身更新以弹窗提示,Invoke 更新显示绿色提示条,按引导完成即可。
- 安装失败时可在安装流程 Review 步骤勾选 Repair Mode
重试;仍失败时打开 Launcher 左下角开发控制台执行
uv cache clean清理缓存后重试,或更换安装位置;问题可提交到官方 Discord。 - 启动 Invoke 后浏览器进入
http://localhost:9090,在 Model Manager 安装本地模型或配置 API 模型 Key。
Launcher 之外的第三方启动器(如 Stability Matrix、LynxHub)不受官方维护,无法保证兼容性;追求稳定体验时优先使用官方 Launcher(口径来自安装文档 Alternative Launchers 小节)。
7.2 手动 uv 虚拟环境安装(无头服务器 / 开发者)
适用于不使用 Launcher、需要在命令行组织环境,或在主分支上参与开发的场景。命令来自官方 Manual Installation 文档。
1)安装 uv 并确认:按 uv 官方文档
的独立安装方式安装,执行 uv --version
确认;安装后可能需要重启终端才能识别命令。
2)创建安装目录与虚拟环境:
# Linux / macOS
mkdir ~/invokeai
cd ~/invokeai

# Windows(PowerShell / CMD)
# mkdir $Home\invokeai
# cd $Home\invokeai

# 创建便携虚拟环境,内置 Python 3.12,不依赖系统 Python 版本
uv venv --relocatable --prompt invoke --python 3.12 --python-preference only-managed .venv3)激活虚拟环境:
# Linux / macOS
source .venv/bin/activate

# Windows
# .venv\Scripts\activate
4)选择包规格与 torch 后端:
- 包规格:NVIDIA 20xx 系列及更老显卡使用
invokeai[xformers];NVIDIA 30xx 及更新显卡、或非 NVIDIA 显卡使用invokeai。 - torch 后端按下表选择,不适用的场景不要添加
--torch-backend:
| 平台 / 硬件 | torch 后端参数 |
|---|---|
| Windows + NVIDIA | --torch-backend=cu128 |
| Windows + Intel Arc | --torch-backend=xpu |
| Windows + 其他 / 无 GPU | 不使用后端参数 |
| Linux + NVIDIA | --torch-backend=cu128 |
| Linux + 无 GPU(x86_64) | --torch-backend=cpu |
| Linux + ARM64(aarch64) | 不使用后端参数(PyPI 自带 CPU wheel) |
| Linux + AMD | --torch-backend=rocm7.1(当前需同时约束
torch<2.12,详见手动文档说明) |
| Linux + Intel Arc | --torch-backend=xpu |
5)安装包:版本号从 Releases 选择,命令形式:
# 无 torch 后端
uv pip install <PACKAGE_SPECIFIER>==<VERSION> \
  --python 3.12 --python-preference only-managed --force-reinstall

# 带 torch 后端
uv pip install <PACKAGE_SPECIFIER>==<VERSION> \
  --python 3.12 --python-preference only-managed \
--torch-backend=<后端标识> --force-reinstall6)重新激活环境并启动:
# 退出后重新激活,使 invokeai 专属命令进入环境
deactivate && source .venv/bin/activate
# Windows: deactivate 后重新执行 .venv\Scripts\activate

# 指定根目录启动 Web 服务
invokeai-web --root ~/invokeai
启动后浏览器访问
http://localhost:9090。无头服务器如需后台常驻,由使用者按上述命令组织自己的启动脚本;旧版
install / invoke
脚本官方不再计划长期维护。
7.3 开发者从源码运行
- 参与开发或运行 main 分支时,参考官方 Contributing 文档 与仓库
invokeai/frontend/webv2、invokeai/frontend/webv1目录;Dockerfile 中前端构建使用 Node 22 与 pnpm 10,pnpm install --frozen-lockfile后pnpm exec vite build。 - 后端为可安装 Python 包,
pyproject.toml中控制台脚本invokeai-web指向invokeai.app.run_app:run_app;开发模式可使用INVOKEAI_DEV_RELOAD在 Python 源码变更时自动重载(不重载节点定义)。 - 新模型架构接入、节点包开发与 API 开发分别见开发文档的 New Model Type Integration、Creating Node Packs 与 Workflow API 章节。
7.4 安装模型与首次配置
- 进入界面 Model Manager 标签页,通过内置目录、Hugging Face 仓库 ID 或本地目录扫描安装模型;首次启动会弹出模型管理器引导。
- 旧版本(v3 及以前)升级后缺失的模型:在 Model Manager 的
Scan Folder 中粘贴旧
autoimport目录或models目录路径扫描,取消勾选 Inplace install 后批量安装(口径见 FAQ Missing models after updating from v3)。 - 私有 Hugging Face 仓库或需要鉴权的模型市场,在
invokeai.yaml的remote_api_tokens中按 URL 正则配置 Bearer Token;Hugging Face 对应url_regex: huggingface.co。 - API 类模型在对应外部提供者配置中填入 API Key;Base URL 可按需覆盖以接入兼容端点。
8 配置项说明
8.1 启动参数与配置文件优先级
- 命令行参数:
--root <path>指定运行根目录;--config <path>指定自定义invokeai.yaml路径。 - 配置搜索优先级:环境变量 →
invokeai.yaml设置 → 默认值;环境变量统一加INVOKEAI_前缀,例如INVOKEAI_HOST对应host;列表、对象等非原始类型传 JSON 编码字符串。 - 根目录搜索顺序:
--root参数 →INVOKEAI_ROOT环境变量 → 当前激活 venv 所在目录 → 用户主目录下invokeai。 - 根目录标准布局:
models/、outputs/、databases/、workflow_thumbnails/、style_presets/、nodes/、configs/、fonts/、profiles/、invokeai.yaml、invokeai.example.yaml。
8.2 Web 服务项(Web)
| 配置项 | 环境变量 | 默认值 | 说明 |
|---|---|---|---|
host |
INVOKEAI_HOST |
127.0.0.1 |
绑定地址;0.0.0.0 提供局域网访问 |
port |
INVOKEAI_PORT |
9090 |
服务端口 |
allow_origins |
INVOKEAI_ALLOW_ORIGINS |
[] |
允许的 CORS 来源列表 |
allow_credentials |
INVOKEAI_ALLOW_CREDENTIALS |
true |
是否允许 CORS 凭据 |
allow_methods |
INVOKEAI_ALLOW_METHODS |
["*"] |
允许的 CORS 方法 |
allow_headers |
INVOKEAI_ALLOW_HEADERS |
["*"] |
允许的 CORS 请求头 |
ssl_certfile |
INVOKEAI_SSL_CERTFILE |
空 | HTTPS 证书文件路径 |
ssl_keyfile |
INVOKEAI_SSL_KEYFILE |
空 | HTTPS 密钥文件路径 |
base_url |
INVOKEAI_BASE_URL |
空 | 反向代理子路径公共前缀,如
/invoke;规范化为单前导斜杠、无尾斜杠 |
forwarded_allow_ips |
INVOKEAI_FORWARDED_ALLOW_IPS |
127.0.0.1 |
允许设置 X-Forwarded-* 头的 IP 列表或
*,仅在设置 base_url 时生效 |
http_compression_level |
INVOKEAI_HTTP_COMPRESSION_LEVEL |
9 |
gzip 响应压缩级别,0 关闭;代理已压缩时建议设
0,大图库场景设 1 更流畅 |
8.3 路径项(Paths)
| 配置项 | 环境变量 | 默认值 | 说明 |
|---|---|---|---|
models_dir |
INVOKEAI_MODELS_DIR |
models |
模型目录,自定义路径须为绝对路径 |
convert_cache_dir |
INVOKEAI_CONVERT_CACHE_DIR |
models/.convert_cache |
模型转换缓存目录(旧版本迁移保留,已标记弃用) |
download_cache_dir |
INVOKEAI_DOWNLOAD_CACHE_DIR |
models/.download_cache |
动态下载模型缓存目录 |
legacy_conf_dir |
INVOKEAI_LEGACY_CONF_DIR |
configs |
旧版 checkpoint 配置文件目录 |
db_dir |
INVOKEAI_DB_DIR |
databases |
数据库目录 |
outputs_dir |
INVOKEAI_OUTPUTS_DIR |
outputs |
输出目录 |
fonts_dir |
INVOKEAI_FONTS_DIR |
fonts |
自定义字体目录 |
image_subfolder_strategy |
INVOKEAI_IMAGE_SUBFOLDER_STRATEGY |
flat |
图片子目录策略:flat / date /
type / hash |
custom_nodes_dir |
INVOKEAI_CUSTOM_NODES_DIR |
nodes |
自定义节点目录 |
style_presets_dir |
INVOKEAI_STYLE_PRESETS_DIR |
style_presets |
风格预设目录 |
workflow_thumbnails_dir |
INVOKEAI_WORKFLOW_THUMBNAILS_DIR |
workflow_thumbnails |
工作流缩略图目录 |
8.4 设备、缓存与精度(Device / Cache / Generation)
| 配置项 | 环境变量 | 默认值 | 说明 |
|---|---|---|---|
device |
INVOKEAI_DEVICE |
auto |
首选执行设备:auto / cpu /
cuda / mps / xpu /
cuda:N / xpu:N |
generation_devices |
INVOKEAI_GENERATION_DEVICES |
auto |
并行生成设备;auto 使用全部可用
GPU,单设备列表串行;可写 [cuda:0, cuda:1] 显式指定 |
precision |
INVOKEAI_PRECISION |
auto |
浮点精度:auto / float16 /
bfloat16 / float32;auto
按显卡与系统判断 |
max_cache_ram_gb |
INVOKEAI_MAX_CACHE_RAM_GB |
空 | 模型缓存占用的最大系统内存 GB;不设置时按可用内存自动配置 |
max_cache_vram_gb |
INVOKEAI_MAX_CACHE_VRAM_GB |
空 | 模型缓存占用的最大显存 GB;共享 GPU 且驱动无法上报空闲显存时建议显式设置 |
device_working_mem_gb |
INVOKEAI_DEVICE_WORKING_MEM_GB |
3 |
计算设备预留工作内存 GB;OOM 时可适当调大;CPU 运行无效 |
enable_partial_loading |
INVOKEAI_ENABLE_PARTIAL_LOADING |
true |
模型部分加载,以速度换显存;流式把权重从 RAM 送入 VRAM |
keep_ram_copy_of_weights |
INVOKEAI_KEEP_RAM_COPY_OF_WEIGHTS |
true |
VRAM 中模型是否保留 RAM 权重副本;内存紧张时可关闭 |
attention_type |
INVOKEAI_ATTENTION_TYPE |
auto |
注意力实现:auto / normal /
xformers / sliced /
torch-sdp |
attention_slice_size |
INVOKEAI_ATTENTION_SLICE_SIZE |
auto |
切片大小,仅 attention_type=="sliced"
时生效:auto / balanced / max /
1–8 |
sequential_guidance |
INVOKEAI_SEQUENTIAL_GUIDANCE |
false |
串行计算 guidance 以降低内存占用 |
force_tiled_decode |
INVOKEAI_FORCE_TILED_DECODE |
false |
启用分块 VAE 解码,降低显存占用、牺牲部分性能 |
wan_memory_optimization |
INVOKEAI_WAN_MEMORY_OPTIMIZATION |
false |
实验性 Wan 内存优化,速度变慢 |
pid_memory_optimization |
INVOKEAI_PID_MEMORY_OPTIMIZATION |
false |
实验性 PiD 解码内存优化,峰值激活内存约减半,解码结果非位级一致 |
pytorch_cuda_alloc_conf |
INVOKEAI_PYTORCH_CUDA_ALLOC_CONF |
空 | Torch CUDA 内存分配器配置,如
backend:cudaMallocAsync,需按系统实测调优 |
offload_text_encoders_to_idle_gpus |
INVOKEAI_OFFLOAD_TEXT_ENCODERS_TO_IDLE_GPUS |
true |
多 GPU 时把文本编码器放到空闲 GPU,避免频繁驱逐去噪模型 |
8.5 队列与节点(Queue / Nodes)
| 配置项 | 环境变量 | 默认值 | 说明 |
|---|---|---|---|
max_queue_size |
INVOKEAI_MAX_QUEUE_SIZE |
10000 |
会话队列最大条目数 |
session_queue_mode |
INVOKEAI_SESSION_QUEUE_MODE |
round_robin |
round_robin 按用户轮询;FIFO
严格先进先出;单用户模式下均按提交顺序服务 |
clear_queue_on_startup |
INVOKEAI_CLEAR_QUEUE_ON_STARTUP |
false |
启动时清空会话队列;为 true 时禁用
max_queue_history |
max_queue_history |
INVOKEAI_MAX_QUEUE_HISTORY |
空 | 保留最近 N 条完成 / 失败 / 取消的队列项,启动时清理更旧记录 |
allow_nodes |
INVOKEAI_ALLOW_NODES |
空 | 允许使用的节点白名单;留空允许全部 |
deny_nodes |
INVOKEAI_DENY_NODES |
空 | 禁用节点黑名单;留空不禁用 |
node_cache_size |
INVOKEAI_NODE_CACHE_SIZE |
512 |
内存中缓存的节点数量 |
8.6 模型安装与安全(Model Install)
| 配置项 | 环境变量 | 默认值 | 说明 |
|---|---|---|---|
hashing_algorithm |
INVOKEAI_HASHING_ALGORITHM |
blake3_single |
模型哈希算法:blake3_multi(SSD 优选)/
blake3_single(HDD 优选)/ random(跳过哈希)/
md5、sha256 等 |
remote_api_tokens |
INVOKEAI_REMOTE_API_TOKENS |
空 | URL 正则 + Bearer Token 列表,用于模型市场与私有仓库下载鉴权;环境变量传 JSON 编码字符串 |
scan_models_on_startup |
INVOKEAI_SCAN_MODELS_ON_STARTUP |
false |
启动时扫描模型目录登记孤立模型,通常配合内存数据库测试使用 |
allow_private_download_urls |
INVOKEAI_ALLOW_PRIVATE_DOWNLOAD_URLS |
false |
允许下载队列访问回环、链路本地与内网地址;仅在自建内网镜像安装模型时开启 |
download_proxy |
INVOKEAI_DOWNLOAD_PROXY |
空 | 模型下载专用 HTTP 代理;代理自身须执行公网地址策略校验 |
unsafe_disable_picklescan |
INVOKEAI_UNSAFE_DISABLE_PICKLESCAN |
false |
危险项:关闭模型安装时的 picklescan 安全检查,允许任意代码执行,禁止用于生产 |
allow_unknown_models |
INVOKEAI_ALLOW_UNKNOWN_MODELS |
true |
允许安装无法识别的模型(标记为
unknown,无元数据);关闭后拒绝安装 |
8.7 多用户与外部模型提供者
| 配置项 | 环境变量 | 默认值 | 说明 |
|---|---|---|---|
multiuser |
INVOKEAI_MULTIUSER |
false |
开启多用户模式后要求认证与授权;关闭时为单用户内置管理员账号 |
strict_password_checking |
INVOKEAI_STRICT_PASSWORD_CHECKING |
false |
开启后密码须同时含大写、小写与数字;关闭时仅向用户报告强度 |
external_openai_api_key /
external_openai_base_url |
INVOKEAI_EXTERNAL_OPENAI_API_KEY 等 |
空 | OpenAI 图像模型 API Key 与 Base URL 覆盖 |
external_gemini_api_key /
external_gemini_base_url |
INVOKEAI_EXTERNAL_GEMINI_API_KEY 等 |
空 | Gemini 图像模型 API Key 与 Base URL 覆盖 |
external_alibabacloud_api_key /
external_alibabacloud_base_url |
INVOKEAI_EXTERNAL_ALIBABACLOUD_API_KEY 等 |
空 | 阿里云 DashScope 图像模型 Key 与 Base URL 覆盖 |
external_seedream_api_key /
external_seedream_base_url |
INVOKEAI_EXTERNAL_SEEDREAM_API_KEY 等 |
空 | Seedream 图像模型 Key 与 Base URL 覆盖 |
所有 API Key 只保存在本机
invokeai.yaml或受保护环境变量中,不要提交到公开仓库、截图或团队文档;invokeai.yaml属于个人配置,不要随工作流工程文件外发而泄露其中的凭据。
8.8 日志与调试项
| 配置项 | 环境变量 | 默认值 | 说明 |
|---|---|---|---|
log_handlers |
INVOKEAI_LOG_HANDLERS |
["console"] |
日志目标:console、file=<path>、syslog=path|address:host:port、http=<url>,可列表多选 |
log_format |
INVOKEAI_LOG_FORMAT |
color |
plain / color / syslog /
legacy |
log_level |
INVOKEAI_LOG_LEVEL |
info |
debug / info / warning /
error / critical |
log_level_network |
INVOKEAI_LOG_LEVEL_NETWORK |
warning |
网络相关日志级别;info / debug
非常啰嗦 |
log_sql |
INVOKEAI_LOG_SQL |
false |
记录 SQL 查询;需 log_level=debug,日志量极大 |
use_memory_db |
INVOKEAI_USE_MEMORY_DB |
false |
使用内存数据库,仅开发场景 |
dev_reload |
INVOKEAI_DEV_RELOAD |
false |
Python 源码变更自动重载;不重载节点定义 |
log_memory_usage |
INVOKEAI_LOG_MEMORY_USAGE |
false |
每次模型缓存操作前后采集内存快照并在 debug 级别记录,有时间开销 |
9 常用运维命令
9.1 Docker / Compose 运维
cd InvokeAI/docker

# 前台启动并跟踪日志(默认 cuda 服务)
docker compose up

# 后台启动指定 profile 服务
docker compose --profile cpu up -d invokeai-cpu
docker compose --profile rocm up -d invokeai-rocm

# 查看实时日志
docker compose logs -f

# 停止并移除容器(不删除挂载数据目录)
docker compose down

# 重新构建镜像(修改 .env 中 GPU_DRIVER 后)
docker compose build invokeai-cuda

# 查看运行中容器与资源占用
docker ps
docker stats
# 单条 docker run 场景:查看容器 ID 后停止
docker ps
docker stop <container-id>- 数据持久化依赖挂载卷;升级镜像前先备份宿主机
INVOKEAI_ROOT目录;容器内/invokeai与宿主机目录一一对应。 run.sh退出后容器仍在后台运行,停止请用docker compose down,不要只关闭日志终端。
9.2 Launcher 与手动环境运维
# 手动虚拟环境:进入根目录并激活(Linux / macOS)
cd ~/invokeai
source .venv/bin/activate

# 重新启动服务
invokeai-web --root ~/invokeai

# 查看安装版本(在虚拟环境内)
uv pip show invokeai- Launcher 方式:在窗口中点击 Manage 进入管理项,Switch installation 切换已登记实例,绿色提示条出现时按引导更新;Launcher 自身更新按弹窗提示完成。
- 手动方式更新:在激活的虚拟环境中按 7.2 节选择包规格与 torch
后端后重新执行
uv pip install对应新版本;旧版本数据库与模型注册表迁移以发行说明为准。
9.3 备份与恢复
定期备份运行根目录中的下列内容(大模型可单独归档或迁移到外置磁盘):
| 备份对象 | 默认路径 | 说明 |
|---|---|---|
| 模型与嵌入 | models/、embedding 相关目录 |
含下载缓存 models/.download_cache、转换缓存
models/.convert_cache |
| 生成成果 | outputs/ |
图片、视频与子目录结构 |
| 数据库 | databases/ |
图库、模型注册表、队列与用户数据 |
| 配置文件 | invokeai.yaml、configs/ |
服务、路径、设备与多用户设置 |
| 工作流与预设 | nodes/、style_presets/、workflow_thumbnails/ |
自定义节点、风格预设与缩略图 |
| 字体与工程 | fonts/、.invk 工程文件 |
自定义字体与画布工程 |
# Linux 下备份配置、数据库、预设与工作流(不含大模型与输出图)
tar -czf invokeai-config-backup.tar.gz \
  invokeai.yaml databases/ nodes/ style_presets/ workflow_thumbnails/ fonts/
恢复时把备份目录放回新根目录对应位置;模型目录可通过
models_dir、outputs_dir
等配置项指向备份位置,不必复制回默认目录。
9.4 日常管理操作
- 清理模型缓存:界面内 Clear Model Cache
按钮;
model_cache_keep_alive_min可设置闲置分钟数后自动清缓存,0为永久保留。 - 队列管理:队列可在界面查看与取消;
max_queue_size限制条目数,clear_queue_on_startup控制是否启动时清空。 - 多用户运维:多用户模式下由管理员在 Web 前端或命令行脚本创建用户、查看活动;会话管理、密码策略与密钥轮换见多用户管理指南。
- 日志:默认输出到控制台;持久化日志在
invokeai.yaml配置log_handlers: ["console", "file=<path>"];排障时临时把log_level调到debug,复现后改回info。
10 常见故障排查
以下条目整理自官方 FAQ、系统要求页、Docker 文档与 YAML 配置说明;复现问题时先关闭自定义节点与非必要外部模型,用最小参数集定位。
10.1 启动后提示未安装模型
- 首次启动会引导进入 Model Manager;选择本地模型目录或通过仓库 ID 安装模型后再生成。
- 模型未被识别时核对模型格式是否在支持范围内(ckpt、diffusers、部分
gguf),并检查
models_dir指向的绝对路径。 - v3 及以前版本升级后模型缺失:按 7.4 节在 Scan Folder 中扫描旧
autoimport与models目录,取消 Inplace install 后安装。
10.2 生成速度慢、未使用 GPU
- 先核对系统要求页中目标模型家族的显存与内存门槛;低显存场景按官方 Low-VRAM 指南配置部分加载、 tiled decode 与注意力切片。
- 启动日志会打印本次生成使用的设备;确认任务实际跑在 GPU 上。若装了
NVIDIA 显卡却走了 CPU,重装时选择对应 GPU 选项,或在
device/generation_devices中显式指定cuda:0。 - Windows + NVIDIA 显存超限时会触发系统内存回退(sysmem fallback),速度明显下降;减少分辨率、批量大小与模型同时驻留,或按低显存指南关闭回退。
- 确认
nvidia-smi(NVIDIA)、rocm-smi(AMD)或torch.xpu.is_available()(Intel Arc)能看到显卡;驱动版本过旧是常见原因。
10.3 显存不足(Out of Memory)
- 按模型家族参考 5.2 节显存表;开启
enable_partial_loading(默认开启)、force_tiled_decode、sequential_guidance与attention_type: sliced等内存策略。 - 调大
device_working_mem_gb(默认 3GB)预留工作内存;降低max_cache_vram_gb限制并发驻留模型数量;关闭keep_ram_copy_of_weights缓解系统内存压力。 - 切换 FP8、GGUF / SDNQ 量化版本模型;Klein 4B / 9B、Krea-2、Wan 等模型的量化门槛见系统要求表与官方 FP8 Storage、SDNQ 文档页。
10.4 启动报 ValidationError 或配置无效
- 现象:安装过程正常,启动时报配置校验错误。
- 原因:
invokeai.yaml中某项设置类型或取值不合法,报错信息会指出具体配置项;对照 YAML 配置文档 修正取值(如精度枚举、设备标识、子目录策略、队列模式)。 - 临时排障:把
invokeai.yaml重命名备份后启动,由程序生成默认配置,再逐项加回自定义设置。
10.5 启动时 Triton 相关报错
- FAQ 说明:该报错可以安全忽略,Invoke 并不使用 Triton;Linux 上若希望消除提示,可按社区方式安装 Triton,但不属于功能必需。
10.6 Linux 内存泄漏与频繁模型切换 OOM
- 现象:Linux glibc 下模型在 CPU / GPU 间移动造成内存碎片,已释放内存无法归还系统,频繁切换模型时即使内存总量充足也会 OOM 崩溃。
- 缓解:设置分配器环境变量,强制大于 1MB 的块使用
mmap,释放后立即归还系统:
export MALLOC_MMAP_THRESHOLD_=1048576- 该方案以整体速度变慢为代价;效果与 libc 实现相关,其他实现(如 musl)上的表现需要自行验证。
10.7 Docker 容器相关问题
- WSL2 下
no such file or directory:多为docker-entrypoint.sh的 Windows CRLF 行尾导致;转为 LF 或git checkout docker/docker-entrypoint.sh重置。 - 容器无法访问 GPU:Linux 确认 NVIDIA Container Toolkit / AMD ROCm 容器运行时已配置;Windows 确认 Docker Desktop 启用 WSL2 GPU 支持;macOS Docker 无法使用 GPU,改用 Launcher。
- 文件属主不对:在
.env中用CONTAINER_UID=$(id -u)匹配宿主机用户;ROCm 场景核对RENDER_GROUP_ID与宿主机getent group render一致。 - 端口冲突:9090 被占用时在
.env修改INVOKEAI_PORT,或停止占用进程后重启 Compose。 - ARM64 主机:
GPU_DRIVER必须设为cpu;x86_64 的 CUDA / ROCm 镜像不能在 ARM64 上使用 GPU 加速。
10.8 模型下载失败或需要鉴权
- 公开模型下载失败时检查网络与代理;
download_proxy可单独为模型下载配置 HTTP 代理。 - 私有 Hugging Face 仓库与需要 Token 的模型市场:在
remote_api_tokens中按 URL 正则配置 Token;Hugging Face 私有仓库使用url_regex: huggingface.co。 - 内网镜像模型默认受公网地址策略限制;确需从局域网镜像安装时才开启
allow_private_download_urls。 - 不要关闭
unsafe_disable_picklescan来绕过模型安全检查;该选项会在模型安装阶段引入任意代码执行风险。
10.9 浏览器与界面小问题
- Firefox 无法复制:Firefox
默认不允许页面直接访问剪贴板;在
about:config中把dom.events.asyncClipboard.clipboardItem设为true,重启浏览器后恢复复制功能。 - 复现网上图片:网络示例图多由其他软件生成,无法保证在 Invoke 中得到相同结果;复现需要对齐模型、正负向提示词、种子、采样器、采样步数、尺寸、放大步骤等全部参数。
- 反向代理子路径:设置
base_url并配置forwarded_allow_ips;代理已做压缩时把http_compression_level设为0,避免双重压缩阻塞事件循环。
10.10 多用户与公网暴露排障
- 用户无法登录:核对账号状态、密码策略与会话配置;管理员忘记密码时参考多用户指南的重置流程。
- 数据库锁错误:检查是否有多个进程同时使用同一
databases/目录;单实例部署避免重复启动服务。 - 公网部署前完成:开启
multiuser、设置强密码、配置会话有效期、核对allow_private_download_urls默认关闭,并在反向代理层叠加 HTTPS 与访问控制。
11 风险与合规说明
以下条款整理自官方 LICENSE、README、官方文档站与通用合规口径;如与官方原文不一致,以仓库
LICENSE、invoke.ai 文档 与各模型许可协议最新版本为准。
11.1 开源协议(Apache 2.0)
InvokeAI 开源代码采用 Apache License
2.0,NOTICE 标注 Copyright 2022–2026 InvokeAI
Contributors。Apache 2.0
允许自由使用、修改、分发与商用,修改与再分发时需保留版权声明、许可证副本与
NOTICE 文件;项目附带的专利授权条款在 Apache 2.0
框架内约定。前端、后端、节点包与社区扩展各自可能附带不同许可,集成前应核对对应
LICENSE / README。
11.2 模型权重与第三方组件许可
- 平台不附带模型权重;SD 家族、SDXL、FLUX、Z-Image、Krea、Qwen Image、ERNIE-Image、Ideogram、CogView 等模型由各自发布方提供,许可条款(商用限制、署名、年龄限制、分发限制)各不相同,必须在模型卡与模型站逐条核对。
- ckpt / diffusers / gguf 模型文件、LoRA、embedding、超分与人脸修复模型来自第三方,可能包含未经授权训练的素材;用于商用产品前应完成模型许可与训练来源合规评估。
- 外部提供者 API 模型(README 标注 API Only 类别)的调用受对应服务条款、隐私政策、内容政策与计费规则约束;API Key 属于个人或组织凭据,泄露后应立即在对应平台轮换。
11.3 生成内容版权与平台风控
- 各司法辖区对 AI 生成图像的可版权性认定不同;平台不保证生成内容可注册版权、保证原创或不侵权,也不替代人工审核。
- 用他人照片、肖像、插画、角色、商标作为参考图或训练素材,涉及肖像权、著作权与商标权;公开发布、商用、参赛或接入电商 / 广告场景前应取得授权或确认素材处于可训练许可范围。
- 在社交平台、电商平台发布生成图时,遵守各平台关于 AI 生成内容标注、审核、限流与违禁类目的规则;平台封号、限流与内容删除风险由使用者自行承担。
11.4 节点、扩展与代码执行安全
- 社区节点与第三方模型包可以读取本机文件、访问网络并执行代码,能力等价于安装第三方软件;只从官方社区节点索引与可信来源安装,安装前阅读源码与维护状态,定期更新或卸载不用的节点。
unsafe_disable_picklescan会关闭模型安装时的恶意 pickle 检查,官方明确标注为危险项,禁止在生产环境使用;allow_private_download_urls、allow_nodes/deny_nodes等访问控制项应按最小权限配置。- 画布工程
.invk内嵌图层与参考图字节,分享工程文件前检查其中是否包含未公开照片、商业素材与敏感参数。
11.5 多用户与数据隐私
- 默认单用户模式以系统管理员身份运行;开启多用户模式后才具备账号认证、授权与会话管理能力。对外提供共享实例前,应完成用户创建、密码策略、会话管理与模型访问权限规划,不要在未鉴权状态下把界面挂到公网。
- 本机模式下提示词、参考图与生成图保存在本机
outputs/与databases/;使用 API 模型、共享图库或反向代理时,数据流向由对应服务与代理配置决定;敏感人物照片、未公开产品图不要通过不受信任的渠道生成。 - 备份目录、
invokeai.yaml与模型缓存中可能包含 API Token、历史参考图与个人配置,外发备份前应先脱敏。
11.6 免责声明
项目按现状(AS-IS)提供,官方不保证在特定硬件、系统版本、模型组合与网络环境下持续可用,不保证生成结果正确、合规或无侵权风险;使用者自行承担出图质量、模型许可、内容版权、数据泄露、服务中断与业务损失风险。如认为仓库内特定文件侵犯合法权益,请通过 GitHub Issues 提交说明;不要在公开 Issue 中上传 API Key、模型 Token、未公开参考图或个人配置。