Surya 保姆级部署教程:689M 参数开源 OCR,从文档识别到表格 HTML 全流程
Surya 是一个 689M 参数的开源 OCR 模型,由 Datalab 开发。它在 OmniParseBench 上拿到 85.9 分(1B 以下开源模型最高),在 olmOCR-bench 上 83.7%,支持 91 种语言,中文准确率 75.7%。和站点此前写过的 PaddleOCR 相比,Surya 是一个视觉语言模型(VLM)——它不只是识别文字,还能做版面分析(标题、表格、图片、页眉分类)、表格识别成 HTML(支持合并单元格)、数学公式识别成 LaTeX。本文按官方 README,从 pip 安装、vllm/llama.cpp 推理后端、到跑通文档 OCR 全流程。
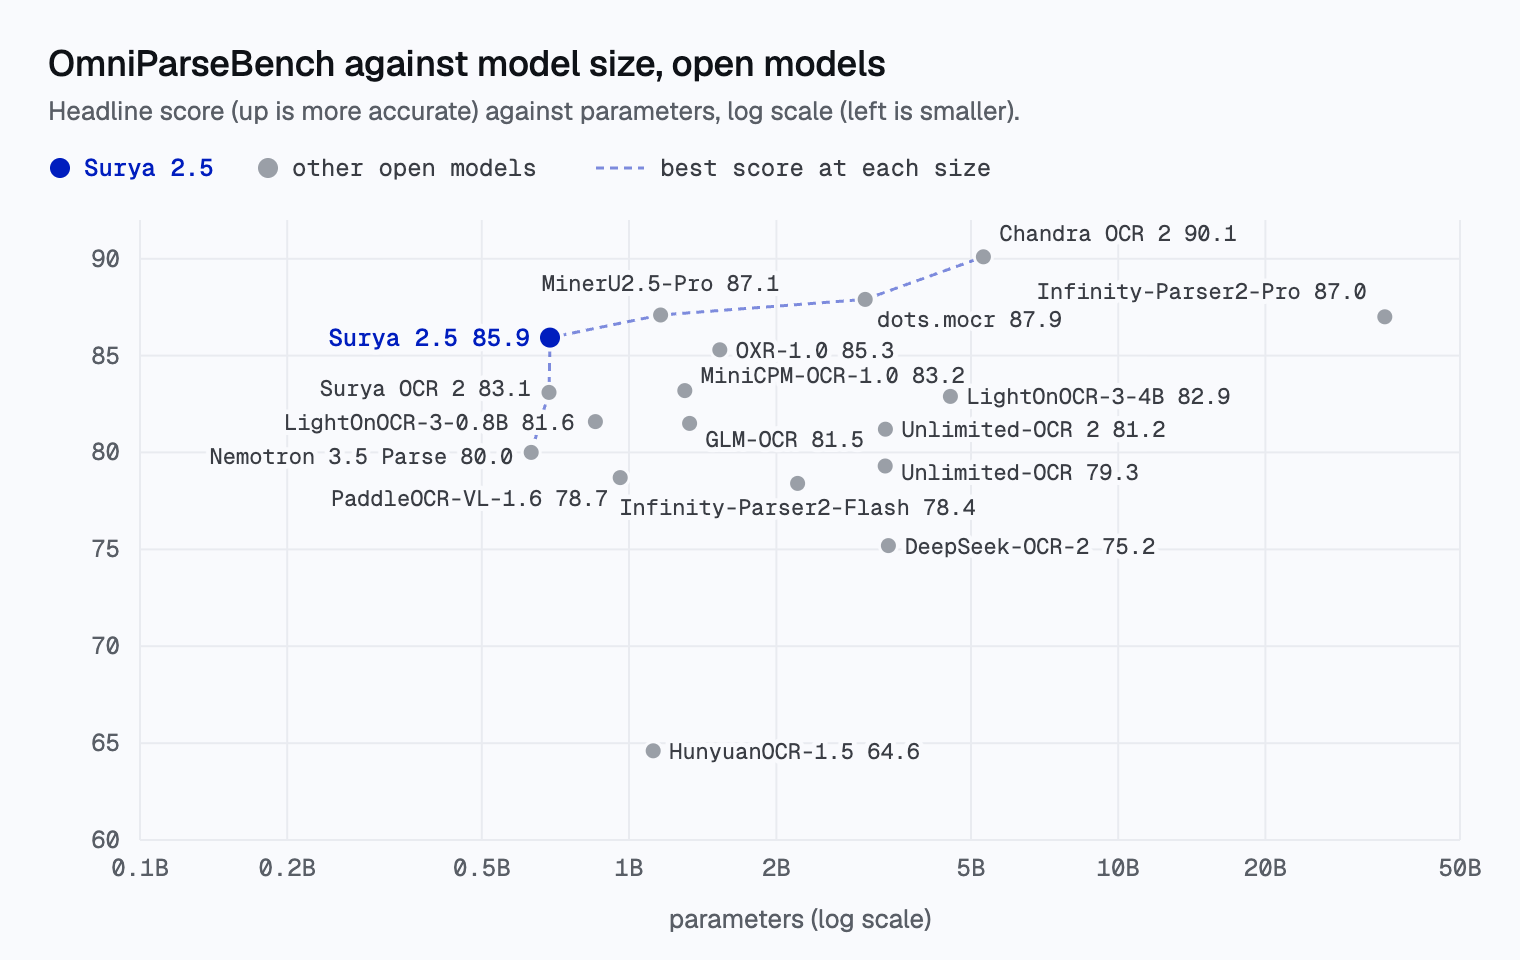
一、项目介绍与适用场景
Surya 由 Datalab(datalab.to)开发维护,代码 Apache 2.0,模型权重 OpenRAIL-M。它的核心是一个 689M 参数的视觉语言模型(Qwen3.5 架构),一次前向推理同时完成版面分析、OCR、表格识别——不是多个小模型串联,而是一个大模型端到端输出 HTML。
适用场景:
- 文档数字化:把 PDF/扫描件转成可检索的文本(带版面结构);
- 表格提取:把 PDF 里的表格转成 HTML,支持合并单元格;
- 多语言 OCR:91 种语言,包括中文、日文、韩文、阿拉伯文等;
- 数学公式识别:把论文里的公式转成 LaTeX;
- 研究/数据处理:批量处理文档数据集。
与 PaddleOCR 的区别:PaddleOCR 是传统 OCR(检测+识别两阶段),速度快但版面理解弱;Surya 是 VLM,端到端输出结构化 HTML,版面理解强但需要 GPU/大模型推理后端。Surya 更适合"理解文档结构",PaddleOCR 更适合"快速批量识别文字"。
Surya 的工作原理和传统 OCR 有什么不同?传统 OCR(Tesseract、PaddleOCR)走的是"检测文字行→逐行识别"的两阶段流水线:先在图片上找出所有文字行的位置,再逐行识别成文字。这种方法快,但它不知道"这行字是标题还是正文""这个区域是表格还是图片"。Surya 是一个视觉语言模型(VLM),它把整张文档图片作为输入,一次前向推理直接输出结构化的 HTML——里面已经区分了 <h1> 标题、<p> 正文、<table> 表格、<math> 公式、<img> 图片等。相当于你给它一张扫描页,它直接"看懂"这页文档的结构,输出一个网页。
性能数据:官方在 H100 80GB 上测,Surya 2.5 在 192 DPI 下 4.5 页/秒,比 Surya 2 快 1.7 倍(MTP 加持)。Apple Silicon M4 Max 36GB 上跑 Q8_0 量化版约 0.2 页/秒——慢但能用,适合低频文档处理。中文准确率 75.7%(比 Surya 2 的 66.7% 提升明显),英文 90.3%。
二、核心功能逐条拆解
- OCR 文字识别:全页 OCR,输出 HTML。
- 版面分析:自动区分标题、正文、表格、图片、页眉页脚等,带阅读顺序。
- 表格识别:输出
<table>...</table>HTML,支持 colspan/rowspan 合并单元格。 - 数学公式:自动识别成 KaTeX 兼容的 LaTeX,包在
<math>...</math>里。 - 多语言:91 种语言,中文 75.7%、英文 90.3%、日文 80.5%。
- 文字行检测:独立的小模型,输出每行文字的 bbox。
- Streamlit GUI:
surya_gui命令启动交互式界面。 - 两种推理后端:vllm(NVIDIA GPU,快)或 llama.cpp(CPU/Apple Silicon)。
- 批量处理:支持文件夹、PDF、图片,
--page_range指定页码范围。 - 性能可调:DPI、并发数、MTP 等参数可调。
- MLX 后端:Apple Silicon 上用 MLX 加速,比 llama.cpp 更快。
- GGUF 构建:官方提供脚本把模型转成 GGUF 格式,自定义量化。
三、全套官方链接
| 类型 | 链接 |
|---|---|
| GitHub 仓库 | https://github.com/VikParuchuri/surya |
| 官方文档 | https://documentation.datalab.to |
| 官网 | https://www.datalab.to |
| Playground | https://www.datalab.to/playground |
| License | 代码 Apache 2.0,模型 OpenRAIL-M |
四、硬件与环境前置要求
官方 README 的 Installation 和 Inference backend prerequisites 小节明确:
- Python:pip 安装即可;
- 推理后端(二选一):
- NVIDIA GPU:需要 Docker + NVIDIA Container Toolkit(vllm 后端);
- CPU / Apple Silicon:需要 llama.cpp 的
llama-server二进制(brew install llama.cpp); - 内存:GPU 模式建议 16GB+ 内存;Apple Silicon M4 Max 36GB 跑 bf16 峰值约 4.7GB RSS;
- GPU 显存:vllm 模式下 H100 80GB 最佳,消费级 GPU 也能跑(模型只有 689M)。
官方出处:README "Inference backend prerequisites" 小节。
补充说明:无 NVIDIA GPU 能不能跑?能,用 llama.cpp 或 MLX 后端。Apple Silicon M4 Max 36GB 上跑 Q8_0 量化版约 0.2 页/秒,处理一份 10 页文档大约 50 秒。CPU 模式(Intel/AMD)会更慢,建议只用于低频处理。如果你的文档量很大(每天几百页),强烈建议用 NVIDIA GPU + vllm 后端。
五、多平台部署步骤
5.1 pip 安装(官方)
第 1 步:安装:
pip install surya-ocr
第 2 步:装推理后端:
NVIDIA GPU(vllm 后端): - 装 Docker 和 NVIDIA Container Toolkit; - surya 首次使用会自动 spawn vllm Docker 容器。
CPU / Apple Silicon(llama.cpp 后端):
# macOS
brew install llama.cpp

# Linux 从 https://github.com/ggml-org/llama.cpp/releases 下载
5.2 跑通 OCR(官方命令)
第 1 步:对一张图片跑 OCR:
surya_ocr DATA_PATH
DATA_PATH 可以是图片、PDF、或文件夹。结果输出到 results.json。
第 2 步:对 PDF 跑 OCR,只处理第 0、5-10、20 页:
surya_ocr document.pdf --page_range 0,5-10,20
第 3 步:同时保存可视化标注图:
surya_ocr document.pdf --images
第 4 步:指定输出目录:
surya_ocr document.pdf --output_dir ./output
5.3 保持服务常驻(官方 --keep_server)
默认每次命令都启动/关闭推理服务器,多次运行会重复加载模型。用 --keep_server 保持服务:
# 第一次:启动服务并保持
surya_ocr document1.pdf --keep_server

# 后续命令:自动连接到已运行的服务
surya_layout document2.pdf
surya_table document3.pdf
5.4 Streamlit GUI(官方)
pip install streamlit pdftext
surya_gui
浏览器打开后可以上传图片/PDF 交互式 OCR。
5.5 Python API(官方)
from PIL import Image
from surya.inference import SuryaInferenceManager
from surya.recognition import RecognitionPredictor

manager = SuryaInferenceManager()  # 自动 spawn vllm 或 llama-server
rec = RecognitionPredictor(manager)
predictions = rec([Image.open("page.png")])
# predictions[0].blocks: 每个 block 的 label/html/polygon/bbox/confidence
六、配置文件全部参数解释
Surya 无独立配置文件,通过环境变量配置。按官方 README 整理:
| 环境变量 | 作用 | 默认值 | 配置示例 | 改错后果 |
|---|---|---|---|---|
SURYA_INFERENCE_BACKEND |
推理后端 | auto(vllm 或 llamacpp) | vllm 或 llamacpp 或 mlx |
后端不对跑不起来 |
SURYA_INFERENCE_URL |
连接已有服务 | 自动 spawn | http://localhost:8000/v1 |
地址不对连不上 |
SURYA_INFERENCE_PARALLEL |
并发数 | 8 | 16 |
太高 OOM |
SURYA_INFERENCE_KEEP_ALIVE |
保持服务 | false | 1 |
每次都要重新加载模型 |
VLLM_MAX_MODEL_LEN |
vllm 最大上下文 | 24576 | 视显存调整 | 太小截断输出 |
DETECTOR_BATCH_SIZE |
检测批大小 | 自动 | 4 |
太高 OOM |
七、启动、后台常驻与开机自启
Surya 是命令行工具,不是常驻服务。用 --keep_server 或 SURYA_INFERENCE_KEEP_ALIVE=1 保持推理服务器运行。
如果你想做成 HTTP 服务,官方未提供——可以自己用 FastAPI 包一层,或者用 Datalab 托管平台(付费)。
八、功能实操教程
第 1 步:pip install surya-ocr,确保 Docker(NVIDIA)或 llama.cpp(CPU/Mac)已装好。
第 2 步:准备一份扫描版 PDF 或图片。
第 3 步:跑全页 OCR:
surya_ocr scan.pdf --images --output_dir ./ocr_output
第 4 步:查看 results.json——每个 block 都有 label(Text/Table/Picture/...)、html(内容 HTML)、bbox、confidence。
第 5 步:单独跑版面分析:
surya_layout scan.pdf --images
第 6 步:单独跑表格识别:
surya_table scan.pdf --images
输出是 <table>...</table> HTML,合并单元格自动用 colspan/rowspan。
第 7 步:从 Python 调用:
from PIL import Image
from surya.inference import SuryaInferenceManager
from surya.recognition import RecognitionPredictor
from surya.layout import LayoutPredictor

manager = SuryaInferenceManager()
layout = LayoutPredictor(manager)
rec = RecognitionPredictor(manager)

img = Image.open("page.png")
layouts = layout([img])
predictions = rec([img], layouts)  # block 模式:先版面再逐块 OCR
第 8 步:调整 DPI 提速。官方说 DPI 从 192 降到 96 能显著提升吞吐量(精度略降):
# 在 surya/settings.py 里改 DPI,或通过环境变量
export SURYA_IMAGE_DPI=96
第 9 步:连接已有的 vllm 服务。如果你已经在跑一个 vllm 服务,可以直接连:
export SURYA_INFERENCE_BACKEND=vllm
export SURYA_INFERENCE_URL=http://localhost:8000/v1
surya_ocr page.png
第 10 步:MLX 后端(Apple Silicon 加速)。除了 llama.cpp,Apple Silicon 用户还可以用 MLX 后端:
pip install mlx-vlm==0.7.10
export SURYA_INFERENCE_BACKEND=mlx
export SURYA_MLX_MODEL=/path/to/surya-mlx-int8
surya_ocr page.png
MLX 后端比 llama.cpp 在 Apple Silicon 上更快,适合 M 系列芯片用户。
第 11 步:批量处理整个文件夹:
surya_ocr ./documents_folder/ --output_dir ./results/
surya 会自动处理文件夹里所有图片和 PDF,每个文件输出一个对应的 results.json。
九、全套报错故障排查
-
报错:vllm Docker 容器启动失败。 原因分析:Docker 或 NVIDIA Container Toolkit 没装好。 分步解决方案:确认
docker run --gpus all nvidia/cuda:12.0.0-base-ubuntu22.04 nvidia-smi能跑通。 -
报错:llama-server 没找到。 原因分析:llama.cpp 没装或不在 PATH。 分步解决方案:
brew install llama.cpp(macOS);Linux 从 llama.cpp releases 下载并放到 PATH。 -
报错:OCR 结果乱码或漏字。 原因分析:图片分辨率不对。 分步解决方案:官方建议——分辨率太低就提高,太高就降到 2048px 宽度以内。对老/模糊图片先做二值化、去斜预处理。
-
报错:检测框不准。 原因分析:
DETECTOR_BLANK_THRESHOLD或DETECTOR_TEXT_THRESHOLD不合适。 分步解决方案:官方建议——如果看到模糊的框,降低阈值;如果框连在一起,提高阈值。两者都在 0-1 范围,且 TEXT_THRESHOLD 要大于 BLANK_THRESHOLD。 -
报错:
surya_table --mode simple报错。 原因分析:Surya 2.5 不支持 simple 模式(需要 Surya 2 checkpoint)。 分步解决方案:用默认--mode full(输出表格 HTML);或设SURYA_MODEL_CHECKPOINT=datalab-to/surya-ocr-2切回 Surya 2。 -
报错:处理速度很慢。 原因分析:DPI 太高,或并发数太低。 分步解决方案:DPI 从 192 降到 96;
SURYA_INFERENCE_PARALLEL提到 16;用--keep_server避免重复加载模型。 -
报错:
surya_ocr命令找不到。 原因分析:pip 安装后 PATH 里没有 surya-ocr 的命令。 分步解决方案:确认 pip 的 bin 目录在 PATH 里(which python3);或用python3 -m surya.scripts.ocr代替。 -
报错:模型下载失败。 原因分析:首次运行要从 HuggingFace 下载模型权重。 分步解决方案:设置
HF_ENDPOINT=https://hf-mirror.com走国内镜像;或预下载模型文件。 -
报错:输出的 HTML 里公式不渲染。 原因分析:
<math>...</math>标签需要 KaTeX 渲染。 分步解决方案:在网页里引入 KaTeX CSS/JS 即可;Surya 输出的是 KaTeX 兼容的 LaTeX。
十、升级、回滚与卸载
升级:pip install -U surya-ocr。Surya 更新很快(当前 2.5),升级前建议看 GitHub Releases 的 changelog。从 v1 升级到 v2 有 API 变化(SuryaInferenceManager 替换 FoundationPredictor),需要改代码。
备份建议:Surya 无用户数据,OCR 输出文件自己备份;模型文件在 HuggingFace 缓存目录(~/.cache/huggingface/),可以单独备份避免重新下载。
回滚:pip install surya-ocr==<旧版本号>。
卸载:pip uninstall surya-ocr。
十一、商用许可与合规风险提示
代码协议 Apache 2.0,但模型权重是 OpenRAIL-M——免费用于研究、个人使用,以及融资/收入低于 500 万美元的初创公司。超过这个范围的商业使用需要联系 Datalab 购买商业许可(https://www.datalab.to/pricing)。如果你是大公司或 SaaS 产品要用 Surya 模型,务必先确认许可。本教程不构成法律意见。
附录:Surya vs PaddleOCR vs Tesseract 怎么选
| 维度 | Surya | PaddleOCR | Tesseract |
|---|---|---|---|
| 模型类型 | VLM 大模型 | 传统两阶段 | 传统引擎 |
| 版面理解 | 强(输出 HTML) | 弱 | 无 |
| 表格识别 | 强(HTML+合并单元格) | 中 | 无 |
| 数学公式 | 支持(LaTeX) | 不支持 | 不支持 |
| 多语言 | 91 种 | 80+ 种 | 100+ 种 |
| 中文准确率 | 75.7% | 高 | 中 |
| 速度 | 慢(需 GPU) | 快(CPU 可跑) | 最快 |
| 部署复杂度 | 高(需 vllm/llama.cpp) | 中 | 低 |
一句话:需要理解文档结构(标题/表格/公式)、批量生成结构化 HTML,用 Surya;只需要快速识别文字、中文为主,用 PaddleOCR;极简场景、英文为主,用 Tesseract。
附录:新手常见问题 FAQ
Q1:Surya 和 PaddleOCR 有什么区别? A:PaddleOCR 是传统 OCR,只输出文字;Surya 是 VLM,输出带版面结构的 HTML。如果你只需要"把图片里的文字变成文本",PaddleOCR 更快更省资源;如果你需要"理解这页文档的结构"(哪些是标题、哪些是表格),Surya 更强。
Q2:我没有 NVIDIA GPU,能用 Surya 吗? A:能。Apple Silicon 用 MLX 或 llama.cpp;Intel/AMD CPU 用 llama.cpp。速度会慢,但低频处理(一天几十页)完全够用。
Q3:Surya 支持中文吗? A:支持。官方基准中文准确率 75.7%,比 Surya 2 提升了 9 个百分点。中文扫描件、印刷体效果不错,手写中文准确率会下降。
Q4:输出的 HTML 怎么用?
A:直接在网页里渲染。Surya 输出的是标准 HTML(<p>、<h1>、<table>、<math>),用浏览器或任何 HTML 解析器都能处理。数学公式用 KaTeX 渲染。
Q5:Surya 能处理 PDF 吗?
A:能。直接传 PDF 文件路径,surya_ocr document.pdf。可以用 --page_range 0,5-10,20 指定页码范围。
Q6:和 Datalab 托管平台是什么关系? A:Datalab 是 Surya 作者的商业公司,提供托管 API(每月 5000 页免费额度)。你可以本地跑 Surya,也可以直接用 Datalab API 不用管基础设施。
参考链接
- GitHub 仓库:https://github.com/VikParuchuri/surya
- 官方文档:https://documentation.datalab.to
- Datalab 官网:https://www.datalab.to
- HuggingFace:https://huggingface.co/datalab-to