
Seed-OSS:超详细部署与使用教程
Seed-OSS 是字节跳动 Seed 团队开源的大语言模型系列:首个版本 Seed-OSS-36B(36B 参数、原生 512K 上下文、Apache-2.0 协议),主打长上下文、推理、Agent 与通用能力,并提供「灵活控制思考预算」的独创机制——推理链长度可按需求动态调节。尽管预训练仅用 12T tokens,Seed-OSS 在多项主流开源 benchmark 上达到优秀水平,面向国际化(i18n)场景优化。
| 所属公司 | GitHub 仓库 | 官方文档/官网 | 开源协议 | Star 数 | 最新版本(截至 2026-10-27) | 主要语言 |
|---|---|---|---|---|---|---|
| 字节跳动(Seed 团队) | github.com/ByteDance-Seed/seed-oss | 模型集合:HuggingFace ByteDance-Seed ;团队站点:seed.bytedance.com | Apache-2.0 | 约 891 | Seed-OSS-36B-Base / -Instruct(2025-08-20 发布) | Python |
目录
一、项目概述
1.1 项目定位
Seed-OSS 是字节 Seed 团队对外开源的 LLM 系列,仓库本身(ByteDance-Seed/seed-oss,默认分支 master)承载模型发布说明、推理脚本与技术报告入口。模型权重托管在 HuggingFace(ByteDance-Seed/Seed-OSS-36B-Base、Seed-OSS-36B-Base-woSyn、Seed-OSS-36B-Instruct)。它面向两类人:
- 应用开发者:拿 Instruct 版直接做长上下文、Agent、工具调用应用;
- 研究者:官方同时发布「带/不带合成指令数据」两个 Base 版本,方便不被预训练合成数据影响的后训练研究。
1.2 核心功能
模型规格(Seed-OSS-36B):
| 项 | 规格 |
|---|---|
| 参数量 | 36B |
| 注意力 | GQA |
| 激活函数 | SwiGLU |
| 层数 | 64 |
| QKV heads | 80 / 8 / 8 |
| Head Size | 128 |
| Hidden Size | 5120 |
| 词表 | 155K |
| 上下文长度 | 512K(原生) |
| RoPE 基频 | 1e7 |
关键特性:
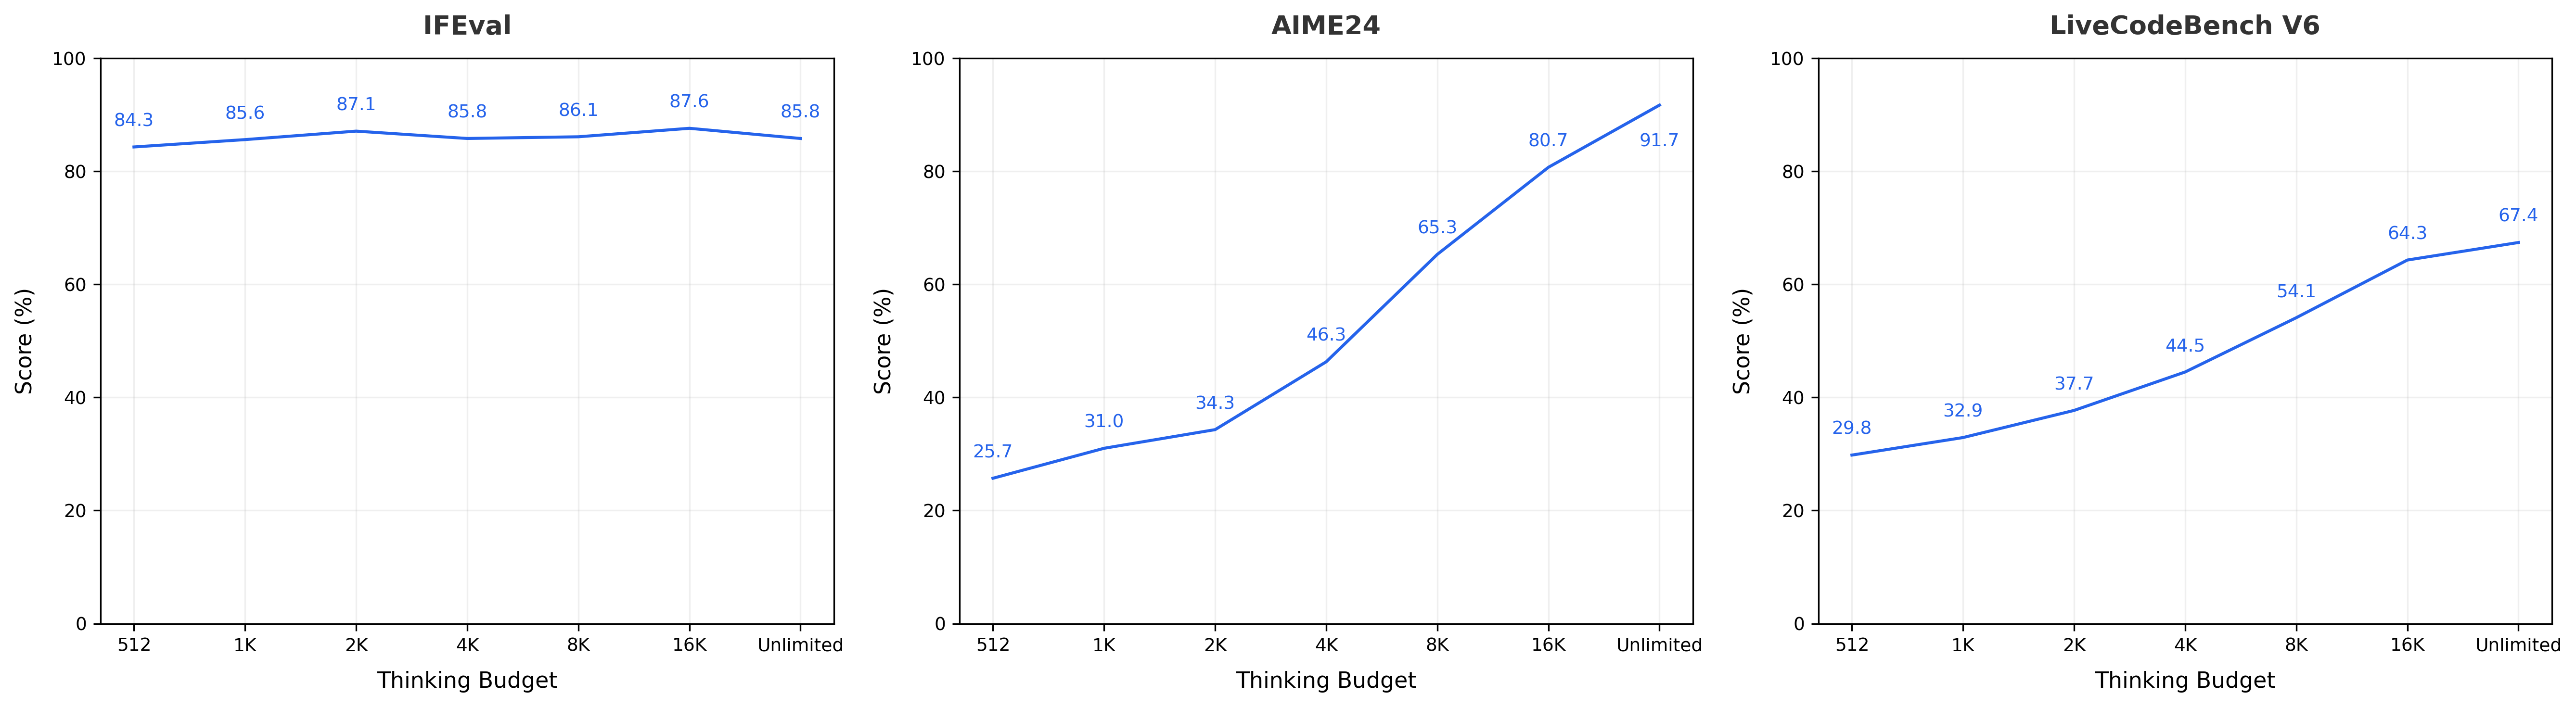
- 灵活控制思考预算(Thinking Budget):用户可动态调节推理链长度,简单任务少想、难题多想;默认不限长度,建议取 512 的整数倍(512/1K/2K/4K/8K/16K),预算为 0 时直接作答;
- 增强推理能力:针对推理任务专门优化,同时保持通用能力均衡;
- Agentic Intelligence:工具调用、问题解决等 Agent 任务表现突出(TAU1-Retail、SWE-Bench 等);
- 研究友好:发布带/不带合成指令数据两个 Base 版;
- 原生长上下文:512K 原生上下文训练。
发布版本(2025-08-20 News):
Seed-OSS-36B-Base(带合成指令数据,默认推荐);Seed-OSS-36B-Base-woSyn(不带合成数据,研究用);Seed-OSS-36B-Instruct(对话/指令版)。
官方建议采样参数:temperature=1.1, top_p=0.95(TAU 类任务 temperature=1, top_p=0.7)。
1.3 技术架构
- 架构:标准因果语言模型,RoPE 位置编码 + GQA 注意力 + RMSNorm + SwiGLU 激活;
- 推理栈:HuggingFace
transformers(>=4.56.1)开箱即用;生产级服务用 vLLM(>=0.10.2,带 Seed-OSS 支持); - 工具调用:vLLM 启动时通过
--tool-call-parser seed_oss开启; - 思考预算:在 chat template 里传
thinking_budget参数控制,模型推理中会自我反思、估算剩余预算。
二、环境要求
| 项目 | 要求 |
|---|---|
| 操作系统 | Linux(官方推理主力);Windows 建议 WSL2 |
| Python | 3.10+(transformers/vllm 环境) |
| 推理框架 | transformers>=4.56.1;或 vllm>=0.10.2(OpenAI 兼容服务) |
| GPU | 36B BF16 全量约需多卡(vLLM 示例 --tensor-parallel-size 8);单卡可上 4/8bit 量化 |
| 磁盘 | 36B 权重 BF16 约 70GB+,预留 150GB+ 含缓存 |
| 网络 | 需访问 HuggingFace;国内可镜像 HF_ENDPOINT=https://hf-mirror.com |
| 显存(量化) | 4bit/8bit 量化可显著降显存,见 generate.py 的 --load_in_4bit/8bit |
三、部署方式
3.1 下载模型
# 用 huggingface-cli 下到本地目录
pip install -U huggingface_hub
huggingface-cli download ByteDance-Seed/Seed-OSS-36B-Instruct --local-dir ./Seed-OSS-36B-Instruct

# 国内镜像
export HF_ENDPOINT=https://hf-mirror.com
huggingface-cli download ByteDance-Seed/Seed-OSS-36B-Instruct --local-dir ./Seed-OSS-36B-Instruct
3.2 方式一:transformers 快速推理(零服务)
# 安装 transformers
pip install "transformers>=4.56.1"
from transformers import AutoModelForCausalLM, AutoTokenizer
import os, re

model_name_or_path = "ByteDance-Seed/Seed-OSS-36B-Instruct"

tokenizer = AutoTokenizer.from_pretrained(model_name_or_path)
# 生产建议 bfloat16 + GPU
model = AutoModelForCausalLM.from_pretrained(model_name_or_path, device_map="auto")

messages = [
    {"role": "user", "content": "How to make pasta?"},
]
tokenized_chat = tokenizer.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=True,
    return_tensors="pt",
    thinking_budget=512   # 控制思考预算
)

outputs = model.generate(tokenized_chat.to(model.device), max_new_tokens=2048)
output_text = tokenizer.decode(outputs[0])
print(output_text)
3.3 方式二:仓库推理脚本 generate.py
# 拉仓库(默认分支 master)
git clone https://github.com/ByteDance-Seed/seed-oss.git
cd seed-oss/inference

# 基础推理
python3 generate.py --model_path /path/to/model

# 8bit 量化
python3 generate.py --model_path /path/to/model --load_in_8bit True

# 4bit 量化
python3 generate.py --model_path /path/to/model --load_in_4bit True

# 自定义 prompt
python3 generate.py --model_path /path/to/model --prompts "['What is machine learning?', 'Explain quantum computing']"
generate.py 关键参数:
| 参数 | 说明 |
|---|---|
--model_path |
模型目录(必填) |
--prompts |
输入提示(默认示例) |
--max_new_tokens |
最大生成(默认 4096) |
--attn_implementation |
flash_attention_2(默认)或 eager |
--load_in_4bit/8bit |
4/8bit 量化,降显存 |
--thinking_budget |
思考预算 token(默认 -1 不限) |
3.4 方式三:vLLM OpenAI 兼容服务(生产推荐)
# 安装 vLLM(>=0.10.2 带 Seed-OSS 支持)
pip install "vllm>=0.10.2"

# 启动 OpenAI 兼容 API 服务
python3 -m vllm.entrypoints.openai.api_server \
    --host localhost \
    --port 4321 \
    --enable-auto-tool-choice \
    --tool-call-parser seed_oss \
    --trust-remote-code \
    --model ./Seed-OSS-36B-Instruct \
    --chat-template ./Seed-OSS-36B-Instruct/chat_template.jinja \
    --tensor-parallel-size 8 \
    --dtype bfloat16 \
    --served-model-name seed_oss
测试调用:
# 普通对话(非流式)
python3 inference/vllm_chat.py --max_new_tokens 4096 --thinking_budget -1
# 流式对话
python3 inference/vllm_chat.py --max_new_tokens 4096 --thinking_budget -1 --stream

# 工具调用
python3 inference/vllm_tool_call.py --max_new_tokens 4096 --thinking_budget -1
python3 inference/vllm_tool_call.py --max_new_tokens 4096 --thinking_budget -1 --stream
3.5 验证部署成功
# 1) transformers 能加载并出文本(见 3.2 示例)
# 2) vLLM 服务起来后,用 OpenAI SDK 指向 http://localhost:4321/v1
curl http://localhost:4321/v1/models
# 3) 发一条 chat 请求,确认返回文本且 thinking_budget 生效
四、使用方法
4.1 基础对话
from transformers import AutoModelForCausalLM, AutoTokenizer

model_path = "ByteDance-Seed/Seed-OSS-36B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_path)
model = AutoModelForCausalLM.from_pretrained(model_path, device_map="auto")

messages = [{"role": "user", "content": "你好,介绍一下你自己"}]
inputs = tokenizer.apply_chat_template(messages, tokenize=True, add_generation_prompt=True,
                                       return_tensors="pt", thinking_budget=512)
out = model.generate(inputs.to(model.device), max_new_tokens=2048)
print(tokenizer.decode(out[0]))
4.2 思考预算(Thinking Budget)调参
# 简单任务:预算小,直接答
thinking_budget = 512
# 难题:预算大,多推理
thinking_budget = 4096
# 不限长度:默认模式
thinking_budget = -1
# 直接作答(不思考):设 0
官方建议:预算取 512 整数倍(512/1K/2K/4K/8K/16K),模型在这些区间上训练最充分;低于 512 的值建议直接设 0。
4.3 工具调用(Agent)
# vLLM 服务已用 --tool-call-parser seed_oss 开启
python3 inference/vllm_tool_call.py --max_new_tokens 4096 --thinking_budget -1 --stream
Agent 场景下模型会按工具 schema 输出结构化调用,配合 function-calling 应用。
4.4 常用配置
| 配置 | 推荐值 | 说明 |
|---|---|---|
temperature |
1.1 | 官方默认 |
top_p |
0.95 | 官方默认(TAU 类任务 0.7) |
max_new_tokens |
4096 | 按任务调 |
thinking_budget |
512 的倍数 | 控制推理链长度 |
attn_implementation |
flash_attention_2 | 需装 flash-attn |
| 量化 | 4bit/8bit | 显存紧张时 |
4.5 适用场景
- 长上下文应用:512K 原生上下文,长文档/长代码库分析;
- Agent 与工具调用:TAU1-Retail、SWE-Bench 表现强;
- 推理增强:AIME、LiveCodeBench 类数学/竞赛编程;
- 私有化大模型底座:Apache-2.0 可商用;
- 后训练研究:带/不带合成数据两个 Base 版可选。
五、常见问题排查(FAQ)
Q1:transformers 版本不够报错
- 要求 >=4.56.1,pip install -U "transformers>=4.56.1" 后重试。
Q2:单卡显存放不下 36B BF16
- 用 4bit/8bit 量化(generate.py --load_in_4bit/8bit);或多卡张量并行(vLLM --tensor-parallel-size)。
Q3:vLLM 启动报错
- 确认 vllm>=0.10.2;确认 --chat-template 指向模型目录里的 chat_template.jinja;多卡时 --tensor-parallel-size 等于卡数。
Q4:HuggingFace 下载慢
- export HF_ENDPOINT=https://hf-mirror.com 走镜像;或用 hf_transfer 加速。
Q5:输出不思考/直接给答案
- 默认 thinking_budget=-1 不限长度;想压成本就传 512 的倍数;想不思考就传 0。
Q6:采样参数怎么设?
- 官方建议 temperature=1.1, top_p=0.95;TAU 类 Agent 任务 temperature=1, top_p=0.7。
Q7:想做微调,用哪个 Base?
- 通用场景用 Seed-OSS-36B-Base;研究合成数据影响时用 Seed-OSS-36B-Base-woSyn。
Q8:Windows 能跑吗? - 官方推理以 Linux 为主;Windows 建议 WSL2。
Q9:工具调用不触发
- vLLM 启动必须带 --enable-auto-tool-choice --tool-call-parser seed_oss;客户端用 OpenAI function-calling 格式。
Q10:商用合规吗? - Apache-2.0,可商用,保留版权声明即可。
六、部署注意事项与最佳实践
- 协议友好:Apache-2.0 是少有的可商用 36B 级开源 LLM,商用注意保留 LICENSE。
- 量化起步:单卡先用 4/8bit 量化跑通,再上多卡 BF16。
- vLLM 生产:对外服务用 vLLM OpenAI 兼容端点,别裸 transformers。
- 思考预算是杠杆:简单任务压预算降本,难题放大预算提质,按场景调。
- 采样对齐:严格按官方
temperature=1.1, top_p=0.95,复现 benchmark 才稳。 - chat template:vLLM 必须挂模型自带
chat_template.jinja,否则对话格式错乱。 - 镜像加速:国内务必
HF_ENDPOINT镜像,36B 权重下载量大。 - flash-attn:装 flash-attn 开
flash_attention_2,推理吞吐明显更好。 - 模型选型:应用选 Instruct;研究后训练选 Base(带/不带合成数据按需求)。
- 关注更新:仓库默认分支 master,技术报告 Coming Soon,升级前看 News。
七、参考资料
- GitHub 仓库:https://github.com/ByteDance-Seed/seed-oss
- HuggingFace 模型集合:https://huggingface.co/collections/ByteDance-Seed/seed-oss-68a609f4201e788db05dcd
- Seed 团队站点:https://seed.bytedance.com
- Seed-1.6 技术页(对照):https://seed.bytedance.com/en/seed1_6
- 模型卡:https://github.com/ByteDance-Seed/seed-oss/blob/master/MODEL_CARD.md
- vLLM 推理脚本:https://github.com/ByteDance-Seed/seed-oss/tree/master/inference
- HuggingFace 模型:https://huggingface.co/ByteDance-Seed