
Depth-Anything-3:超详细部署与使用教程
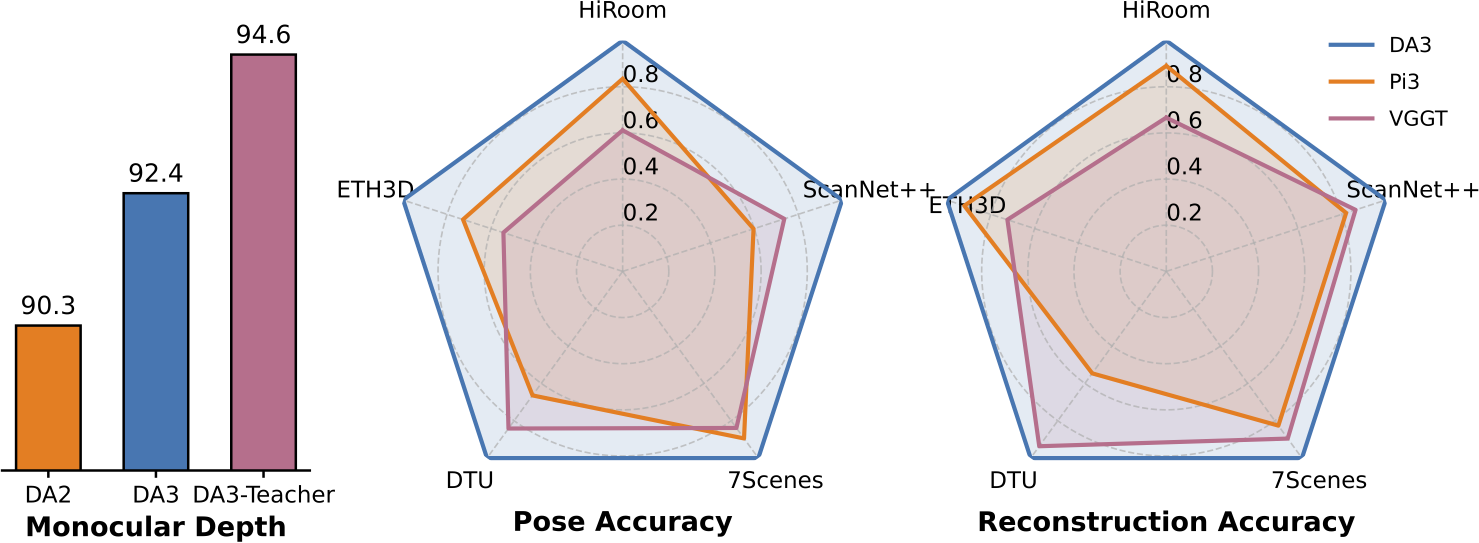
Depth Anything 3(DA3)是字节跳动 Seed 团队开源的单目/多目深度估计基础模型:从任意视觉输入(单张或多张图像,无论是否已知相机位姿)预测空间一致的几何结构。它用一个朴素的 plain Transformer(如 DINO 编码器)做主干、单一「depth-ray 表示」替代复杂多任务学习,一套模型同时覆盖单目深度、多目深度、带位姿条件深度、相机位姿估计、3D 高斯估计五类任务,深度估计显著超越 Depth Anything V2,多目深度与位姿估计超越 VGGT。

| 所属公司 | GitHub 仓库 | 官方文档/官网 | 开源协议 | Star 数 | 最新版本(截至 2026-10-27) | 主要语言 |
|---|---|---|---|---|---|---|
| 字节跳动(Seed 团队) | github.com/ByteDance-Seed/Depth-Anything-3 | 项目页:depth-anything-3.github.io ;HF Demo:huggingface.co/spaces/depth-anything/Depth-Anything-3 ;模型:HuggingFace depth-anything ;论文:arXiv:2511.10647 | 代码 Apache-2.0;Giant/Large 权重 CC BY-NC 4.0(非商用),Base/Small/Metric/Mono 权重 Apache-2.0 | 约 6.6k | 无 GitHub Release Tag,以仓库 master 最新提交为准 | Python |
目录
一、项目概述
1.1 项目定位
DA3 解决的问题是「从二维图像恢复三维视觉空间」。它的两个核心设计哲学:
- 极简建模:一个普通的 plain Transformer(例如 DINO 编码器)就够当主干,不需要架构特化;
- 单一 depth-ray 表示:用一种表示统一建模,免去复杂的多任务学习。
输入一组任意视角的图像,DA3 输出逐图深度图、置信度、相机外参(w2c/opencv 或 colmap 格式)与内参;Nested 系列还能把任意视角模型与度量深度模型串起来,输出真实米制尺度的三维重建。官方强调:所有模型仅在公开学术数据集上训练。
1.2 核心功能(模型矩阵,以官方 README Model Cards 为准)
| 系列 | 模型 | 参数量 | 用途 | 权重协议 |
|---|---|---|---|---|
| Nested | DA3NESTED-GIANT-LARGE-1.1 / 原版 | 1.40B | 任意位姿深度 + 位姿估计 + 位姿条件 + 3DGS + 米制深度 + 天空分割 | CC BY-NC 4.0 |
| Any-view | DA3-GIANT-1.1 / 原版 | 1.15B | 相对深度 + 位姿估计 + 位姿条件 + 3DGS | CC BY-NC 4.0 |
| Any-view | DA3-LARGE-1.1 / 原版 | 0.35B | 相对深度 + 位姿估计 + 位姿条件 | CC BY-NC 4.0 |
| Any-view | DA3-BASE | 0.12B | 相对深度 + 位姿估计 | Apache-2.0 |
| Any-view | DA3-SMALL | 0.08B | 相对深度 + 位姿估计 | Apache-2.0 |
| 单目度量 | DA3METRIC-LARGE | 0.35B | 米制深度 + 天空分割 | Apache-2.0 |
| 单目深度 | DA3MONO-LARGE | 0.35B | 高质量相对单目深度(直接预测深度,非视差) | Apache-2.0 |
注意:带
-1.1后缀的模型是修复训练 bug 后重训版本,性能更好(尤其街景),官方推荐优先用-1.1;原版DA3NESTED-GIANT-LARGE、DA3-GIANT、DA3-LARGE已弃用但仍可下载。
代码库能力:
- 🎨 交互式 Web UI(Gradio)与 Gallery,可视化并对比结果;
- ⚡ 灵活 CLI:批量处理、接入自定义流程;
- 💾 多导出格式:
glb、npz、深度图、ply、3DGS 视频等; - 🔧 模块化设计,便于扩展新模型;
- 🚀 DA3-Streaming:滑动窗口流式推理,超长视频序列推理可在 <12GB 显存 跑。
1.3 技术架构
架构要点:
- 主干:DINOv2 类 ViT(配置文件在
src/depth_anything_3/configs,默认 ViT-B/L 等规格); - 头部:DualDPT 类融合头,输出 depth-ray 表示;
- 模型本体:
DepthAnything3Net定义在src/depth_anything_3/model/da3.py;输入输出处理封装在DepthAnything3(src/depth_anything_3/api.py); - 自定义模型:新建 Yaml 配置(指定 backbone/head),用
create_object(load_config(...))实例化。
二、环境要求
| 项目 | 要求 |
|---|---|
| 操作系统 | Linux(官方主力);Windows 建议 WSL2 |
| Python | >= 3.10(Gradio Web UI 要求) |
| 深度学习框架 | PyTorch(torch>=2)+ torchvision;xformers |
| GPU | 需 NVIDIA GPU 支持 xFormers;DA3-Streaming 超长视频可 <12GB 显存;大模型(Giant 1.15B)建议更大显存 |
| 其他依赖 | gsplat(高斯头部,需按指定 commit 安装);Gradio(Web UI,.[app]) |
| 磁盘 | 模型权重从 HuggingFace 下载(Base 0.12B ~ Nested 1.4B),预留数 GB ~ 数十 GB |
| 网络 | 需访问 HuggingFace;国内可 export HF_ENDPOINT=https://hf-mirror.com |
三、部署方式
3.1 安装步骤
# 1) 拉取仓库
git clone https://github.com/ByteDance-Seed/Depth-Anything-3.git
cd Depth-Anything-3

# 2) 先装 PyTorch 2.x 与 xformers
pip install xformers "torch>=2" torchvision

# 3) 基础安装(Python API + CLI)
pip install -e .

# 4) 高斯头部依赖(gsplat,必须按官方指定 commit)
pip install --no-build-isolation git+https://github.com/nerfstudio-project/gsplat.git@0b4dddf04cb687367602c01196913cde6a743d70

# 5) (可选)Gradio Web UI,要求 Python>=3.10
pip install -e ".[app]"

# 6) (可选)装全部依赖
pip install -e ".[all]"
3.2 配置说明
- 模型从 HuggingFace 自动下载(如
depth-anything/DA3NESTED-GIANT-LARGE-1.1),也可先手动下到本地目录,再把路径传给from_pretrained; - 国内网络:
export HF_ENDPOINT=https://hf-mirror.com; - 模型架构配置在
src/depth_anything_3/configs/*.yaml,不改则用默认。
3.3 启动命令
# 选定模型(HF 仓库名或本地目录)
export MODEL_DIR=depth-anything/DA3NESTED-GIANT-LARGE-1.1
export GALLERY_DIR=workspace/gallery
mkdir -p $GALLERY_DIR

# A) 启动 backend 常驻进程(把模型缓存到 GPU,供后续 CLI 复用)
da3 backend --model-dir ${MODEL_DIR} --gallery-dir ${GALLERY_DIR}

# B) auto 模式:一组图像一键推理 + 导出 glb
da3 auto assets/examples/SOH \
    --export-format glb \
    --export-dir ${GALLERY_DIR}/TEST_BACKEND/SOH \
    --use-backend

# C) 视频处理:抽帧 + 特征可视化 + 导出 glb-feat_vis
da3 video assets/examples/robot_unitree.mp4 \
    --fps 15 \
    --use-backend \
    --export-dir ${GALLERY_DIR}/TEST_BACKEND/robo \
    --export-format glb-feat_vis \
    --feat-vis-fps 15 \
    --process-res-method lower_bound_resize \
    --export-feat "11,21,31"

# D) 不开 backend 的一次性 CLI
da3 auto assets/examples/SOH \
    --export-format glb \
    --export-dir ${GALLERY_DIR}/TEST_CLI/SOH \
    --model-dir ${MODEL_DIR}
3.4 验证部署成功
# 最小 Python 推理验证
import glob, os, torch
from depth_anything_3.api import DepthAnything3

device = torch.device("cuda")
model = DepthAnything3.from_pretrained("depth-anything/DA3NESTED-GIANT-LARGE-1.1")
model = model.to(device=device)

images = sorted(glob.glob("assets/examples/SOH/*.png"))
prediction = model.inference(images)

# 预期各输出张量形状正常
print(prediction.processed_images.shape)  # [N,H,W,3] uint8
print(prediction.depth.shape)              # [N,H,W] float32
print(prediction.conf.shape)               # [N,H,W] float32
print(prediction.extrinsics.shape)          # [N,3,4]
print(prediction.intrinsics.shape)         # [N,3,3]
能打印出形状且 workspace/gallery/ 下生成 glb 文件即部署成功。
四、使用方法
4.1 基础用法:Python API 推理
import glob, os, torch
from depth_anything_3.api import DepthAnything3

device = torch.device("cuda")
model = DepthAnything3.from_pretrained("depth-anything/DA3NESTED-GIANT-LARGE-1.1")
model = model.to(device=device)

example_path = "assets/examples/SOH"
images = sorted(glob.glob(os.path.join(example_path, "*.png")))
prediction = model.inference(images)
# prediction.processed_images : [N, H, W, 3] uint8
# prediction.depth            : [N, H, W] float32
# prediction.conf             : [N, H, W] float32
# prediction.extrinsics       : [N, 3, 4] float32 (opencv w2c / colmap)
# prediction.intrinsics       : [N, 3, 3] float32
4.2 常用命令 / 配置
| 命令 | 作用 |
|---|---|
da3 backend |
常驻进程,缓存模型到 GPU |
da3 auto <图像目录> |
一组图像一键推理 + 导出(glb/npz/ply/深度图) |
da3 video <视频> |
视频抽帧推理 + 特征可视化 |
关键参数:
--use-backend:复用常驻 backend,避免重复加载模型;--export-format:glb/npz/ply/glb-feat_vis等;--fps/--feat-vis-fps:视频抽帧与特征可视化帧率;use_ray_pose:用 ray head 推导相机位姿,稍慢但更准(默认 False 走 cam head 更快);ref_view_strategy:多目输入时的参考视图选择策略(见docs/funcs/ref_view_strategy.md)。
4.3 进阶功能
- 米制深度换算:
DA3METRIC-LARGE输出需用metric_depth = focal * net_output / 300.(focal 为像素焦距,取内参 K 的 fx/fy 均值);DA3NESTED-GIANT-LARGE输出本身已是米制; - 自定义模型结构:新建 Yaml 配置(指定
DinoV2backbone 与DualDPThead),create_object(load_config("path/to/new/config"))实例化; - DA3-Streaming:超长视频序列滑动窗口推理,<12GB 显存,见
da3_streaming/README.md; - Benchmark 评测:官方提供 5 数据集上的位姿估计与三维重建评测管线,见
docs/BENCHMARK.md; - Web UI:
pip install -e ".[app]"后启动 Gradio 界面,可视化 Gallery 对比结果。
4.4 适用场景
- 三维重建 / NeRF / 3D Gaussian Splatting:从一组照片恢复场景几何与新视角;
- 机器人视觉:实时深度感知(ROS2 封装见社区 DA3-ROS2-Wrapper、TensorRT 节点);
- AR/VR:WebXR 立体播放(VideoDepthViewer3D);
- 内容创作:Blender 插件(DA3-blender)、ComfyUI 节点(ComfyUI-DepthAnythingV3);
- 测绘/数字孪生:米制尺度的单目深度测量。
五、常见问题排查(FAQ)
Q1:显存不够 / OOM
- 用更小模型(Base 0.12B / Small 0.08B);长视频用 DA3-Streaming(<12GB 显存);降分辨率(lower_bound_resize)。
Q2:老 GPU 不支持 xFormers - 官方 Issue #11 有解决方案(社区 @S-Mahoney 提供),先看 issue 再装。
Q3:HuggingFace 下载慢/失败
- export HF_ENDPOINT=https://hf-mirror.com 走镜像;或手动下模型到本地目录再传路径。
Q4:pip install -e . 报错
- 确认 Python>=3.10;先装 torch>=2、torchvision、xformers;gsplat 必须按官方指定 commit 装。
Q5:da3 命令找不到
- pip install -e . 后检查 which da3;或在仓库根目录执行,确认安装在当前 Python 环境。
Q6:位姿精度想再高一点
- 推理时开 use_ray_pose(稍慢更准);多目输入配 ref_view_strategy 选好参考视图。
Q7:下载的模型是旧版,效果一般
- 官方 -1.1 是修 bug 重训版,街景更好;把模型名换成 DA3NESTED-GIANT-LARGE-1.1 等带 -1.1 的。
Q8:导出格式怎么选?
- 给 Blender/三维软件用 glb;给研究用 npz;给点云查看器用 ply;要可视化特征用 glb-feat_vis。
Q9:Windows 能跑吗? - 官方以 Linux 为主;Windows 建议 WSL2,避免原生环境装 xformers/gsplat 踩坑。
Q10:权重协议能不能商用? - Giant/Large 系列是 CC BY-NC 4.0(非商用);Base、Small、DA3METRIC-LARGE、DA3MONO-LARGE 是 Apache-2.0(可商用)。商用前先核对所用模型的协议。
六、部署注意事项与最佳实践
- 协议红线:Giant/Large 权重非商用,商用场景务必选 Base/Small/Metric/Mono(Apache-2.0)。
- 优先
-1.1:新版修了训练 bug,街景等场景明显更好。 - 显存分级:先 Small/Base 跑通流程,再上 Large/Giant;长视频用 Streaming。
- 镜像加速:国内务必配
HF_ENDPOINT镜像,否则权重下载卡。 - gsplat 锁版本:高斯头部必须装官方指定 commit,自己升版本会不兼容。
- Python 版本:Web UI 要求 >=3.10,基础 CLI 也建议 3.10+。
- 米制换算:
DA3METRIC-LARGE要手动乘focal/300得米制;Nested 版直接是米制。 - 参考视图策略:多目输入的
ref_view_strategy会影响一致性,按场景调。 - 评测管线:发论文/比模型时用官方
docs/BENCHMARK.md统一口径。 - 社区生态:Blender、ComfyUI、ROS2、TensorRT 都有现成封装,能复用就别自己写。
七、参考资料
- GitHub 仓库:https://github.com/ByteDance-Seed/Depth-Anything-3
- 项目主页:https://depth-anything-3.github.io
- HuggingFace 在线 Demo:https://huggingface.co/spaces/depth-anything/Depth-Anything-3
- 模型列表(HuggingFace depth-anything):https://huggingface.co/depth-anything
- 论文:https://arxiv.org/abs/2511.10647
- CLI 文档:https://github.com/ByteDance-Seed/Depth-Anything-3/blob/main/docs/CLI.md
- Python API 文档:https://github.com/ByteDance-Seed/Depth-Anything-3/blob/main/docs/API.md
- Benchmark 评测:https://github.com/ByteDance-Seed/Depth-Anything-3/blob/main/docs/BENCHMARK.md
- DA3-Streaming:https://github.com/ByteDance-Seed/Depth-Anything-3/tree/main/da3_streaming
- Issues:https://github.com/ByteDance-Seed/Depth-Anything-3/issues