
PyTorch:GPU 加速张量计算与动态自动微分深度学习框架部署指南
PyTorch 是一个 Python 软件包,官方 README 明确它提供两大高层能力:一是类似 NumPy、但带有强 GPU 加速的张量计算;二是建立在磁带式(tape-based)自动微分系统之上的深度神经网络。它不是把一个庞大的 C++ 框架包一层 Python 绑定,而是深度集成进 Python 生态,你可以像使用 NumPy、SciPy、scikit-learn 一样自然地使用它,也可以在需要时复用 Cython、Numba 等熟悉的工具扩展它。在实际使用中,PyTorch 通常被当作两种角色:要么是"能用 GPU 算力的 NumPy 替代品",要么是"追求最大灵活性与速度的深度学习研究平台"。今天绝大多数大模型训练与微调框架,底层都构建在 PyTorch 之上。本文按官方 README 梳理从二进制安装、源码编译到 Docker 部署的完整路径,所有命令与版本要求均以仓库说明为准,方便新手照着一步步把环境跑通。
一、项目官方信息
| 项目 | 信息 |
|---|---|
| 项目定位 | GPU 加速张量计算 + 磁带式自动微分的深度学习框架 |
| GitHub 仓库 | pytorch/pytorch |
| 主要语言 | Python |
| 官方网站 | pytorch.org |
| 安装选择器 | pytorch.org/get-started/locally |
| 官方文档 | pytorch.org/docs |
| 开源协议 | BSD 风格协议(见仓库 LICENSE) |
| Star 数量 | 约 105k(截至 2026 年 10 月) |
二、项目配图
PyTorch 官方 Logo(来自官方仓库 docs 目录,已上传至本站附件目录,访问稳定):
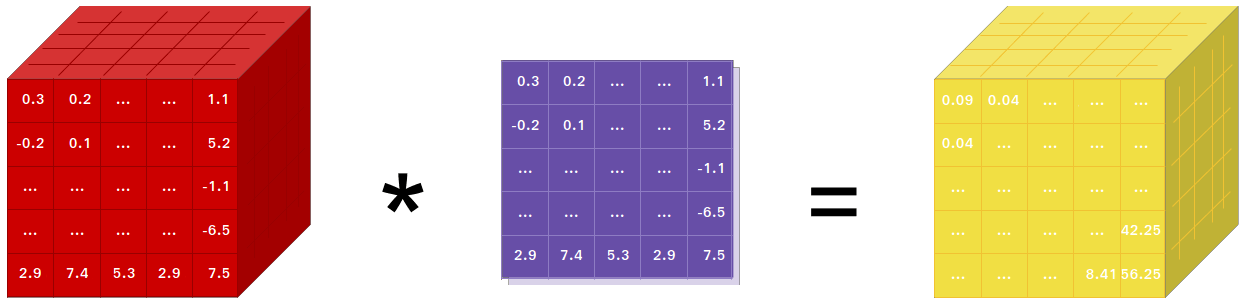
官方 README 中还展示了张量(Tensor)与 NumPy ndarray 的对应关系示意:
三、项目背景
在 PyTorch 之前,主流深度学习框架大多采用"静态图"思路:你必须先把整个神经网络结构定义好、编译一次,之后反复复用同一份结构,想改变网络行为就要推倒重来。PyTorch 选择了"动态图 + 反向模式自动微分"的路线,官方 README 形容它像一台磁带录音机:前向计算时记录下每一步操作,反向传播时再"回放"这盘磁带求梯度,因此网络行为可以任意改变,且几乎零额外开销。这种思路受启发于 torch-autograd、autograd、Chainer 等早期工作,而 PyTorch 把它做到了当时最快的实现之一。
另一个关键设计是"Python First"与"命令式体验":代码执行一行就是一行,没有异步黑盒,出错时堆栈追踪直接指向你自己定义的那一行,开发者不需要花几个小时去调试晦涩的执行引擎。配合自研的 GPU 内存分配器,PyTorch 的显存占用非常高效,让更大模型的训练成为可能。
正是这种"研究友好、调试直观"的特性,让 PyTorch 从学术圈迅速扩散到工业界:今天大模型预训练、微调、推理优化、多模态模型等几乎所有方向,主流实现都以 PyTorch 为底座;大量上层框架(如 Hugging Face 的模型库、各类训练加速库)本质上也是在 PyTorch 张量与自动微分之上做封装。对初学者而言,学会 PyTorch 就等于拿到了进入深度学习工程世界的钥匙。官方 README 还专门提示,本项目与同名的 hughperkins/pytorch 无关,避免混淆。
四、核心特性逐条说明
- GPU 就绪的张量库:张量可以放在 CPU 或 GPU 上,计算被大幅加速;提供切片、索引、数学运算、线性代数、归约等全套张量例程,对标 NumPy 体验。官方 README 特别说明,如果你用过 NumPy,就已经用过张量(即 ndarray),迁移成本几乎为零,只是底层计算搬到了 GPU 上。
- 磁带式动态自动微分:基于反向模式自动微分,支持对 torch 中所有可微张量操作求导,网络行为可随前向过程任意变化,兼顾速度与研究灵活性。与静态图框架"先定义、再复用"不同,你可以在循环、条件分支里动态改变网络结构,这对研发新模型尤其重要。
- Python 优先、深度集成:不是 C++ 巨框架的薄绑定,新网络层可以直接用 Python 写,并复用你惯用的 NumPy/SciPy/Cython/Numba 生态。官方的目标是"合适的地方不重复造轮子",让科学计算栈自然衔接。
- 命令式执行体验:代码即执行,无异步视图;进入调试器或看到报错堆栈时,追踪信息直接指向源码定义位置。这意味着你可以像调试普通 Python 脚本一样打断点、打印中间张量,而不是面对一个编译好的计算图。
- 快速精简、框架开销小:集成 Intel MKL、NVIDIA cuDNN、NCCL 等加速库,CPU/GPU 张量与神经网络后端经过多年打磨;自研 GPU 内存分配器让显存利用更高效,官方明确表示因此可以训练比以往更大的模型。
- 无痛扩展:新层可用 Python 基于 torch API 编写;想用 C/C++ 写层,官方提供高效、样板代码极少的扩展 API,无需手写 wrapper,并配有专门的扩展教程与示例。
官方 README 还把库拆成五个核心组件,各司其职又彼此衔接:torch(类 NumPy 张量库)、torch.autograd(磁带式自动微分)、torch.nn(与 autograd 深度集成的神经网络库)、torch.multiprocessing(跨进程共享张量内存的多进程,用于数据加载与 Hogwild 训练)、torch.utils(DataLoader 等工具)。
五、典型适用场景
- 科学计算与 NumPy 升级:已经习惯 NumPy 写数值计算,想把矩阵运算搬到 GPU 上提速,直接把 ndarray 换成 torch 张量即可,API 几乎一一对应。
- 深度学习研究与模型实验:需要反复改网络结构、插入打印、断点调试,动态图让"改一行、跑一步"的迭代节奏非常顺畅。
- 大模型训练与微调底座:绝大多数开源大模型的训练脚本都基于 PyTorch,本地复现、二次微调都离不开它。
- 边缘与嵌入式部署:NVIDIA Jetson 系列平台官方提供专用 wheel 与 L4T 容器,适合在边缘设备上跑推理。
无论你属于哪一类用户,官方都建议从二进制安装起步,先跑通官方教程里的"张量 + 自动微分 + 神经网络"三段式示例,再根据具体项目需求引入数据加载、分布式训练或自定义 C++ 扩展,避免一开始就陷入编译细节。对只是想跑通一个开源模型的同学,安装好 PyTorch 后,把权重文件准备好,几行加载代码就能进入推理环节。
六、环境要求
- 二进制安装:通过 Conda 或 pip wheel 安装,具体命令在官方安装选择器上按你的系统/ CUDA 版本选择,无需本地编译。
- 源码编译:需要 Python 3.11 或更高版本;一个完全支持 C++20 的编译器(Linux 上要求 gcc 11.3.0 或更新);Windows 需 Visual Studio 或其生成工具;至少 10 GB 空闲磁盘;首次编译约 30–60 分钟,后续增量编译快得多。
- GPU 支持:CUDA 路线需安装 NVIDIA CUDA 与 cuDNN v9.0 及以上;AMD ROCm 4.0 及以上(仅 Linux);Intel GPU 按官方先决条件文档配置。不用 GPU 时可设
USE_CUDA=0、USE_ROCM=0、USE_XPU=0关闭对应后端。 - Docker:使用预构建镜像需要 Docker v23.0 以上;官方 README 同时提醒,使用 torch.multiprocessing 时容器默认共享内存偏小,需要额外调整。
整体而言,普通用户只要准备好 Python 环境和一张可用的 NVIDIA 显卡(或纯 CPU 也能跑),走二进制安装即可;只有在需要修改底层 C++/CUDA 代码、调试 PyTorch 本体、或为特定平台裁剪时,才需要按源码编译那一套准备编译器与磁盘空间。
七、部署步骤
1. 二进制安装(本地,推荐新手)
官方 README 指出,通过 Conda 或 pip wheel 安装二进制包的命令统一放在官网选择器:打开 pytorch.org/get-started/locally,选择你的操作系统、包管理工具、计算平台(CPU/CUDA/ROCm),页面会给出对应命令,复制执行即可。这是最省事的方式,绝大多数用户都应该走这条路线,不需要碰编译器。NVIDIA Jetson 平台的专用 wheel 与 L4T 容器官方也有单独页面提供,要求 JetPack 4.2 及以上。
2. 源码安装(本地,适合贡献者)
git clone https://github.com/pytorch/pytorch
cd pytorch
git submodule sync
git submodule update --init --recursive
安装依赖:
pip install --group dev
Linux 上如需 CUDA,再按需安装 MKL 与 MAGMA 等。然后编译安装:
python -m pip install --no-build-isolation -v -e .
3. Docker 预构建镜像(网页端/服务器一键运行)
官方 README 给出可直接拉取的镜像,适合在服务器上快速拉起一个带 GPU 的 PyTorch 环境:
docker run --gpus all --rm -ti --ipc=host pytorch/pytorch:latest
注意 PyTorch 使用共享内存在进程间传数据,因此多进程 DataLoader 场景下要加 --ipc=host 或 --shm-size 调大共享内存段,否则容器里多进程数据加载容易报错或卡住。想自己构建镜像,可使用仓库自带 docker.Makefile(要求 Docker ≥ 23.0,Dockerfile 提供 CUDA 12.6 与 cuDNN v9 支持),还可以通过 PYTHON_VERSION=x.y 等 make 变量指定 Python 版本。
4. 浏览器网页端在线学习
PyTorch 本身是库而非网页应用,但官方把完整教程、API 参考与模型生态都放在浏览器可访问的站点:在 pytorch.org/tutorials 可以直接在浏览器里阅读从入门到进阶的教程,配合 PyTorch Hub 在线浏览预训练模型,无需先装环境就能开始学习。这种"先看教程、再动手装"的方式,对第一次接触深度学习的人尤其友好。
八、使用方法
安装完成后,验证:
import torch
print(torch.__version__)
print(torch.cuda.is_available())
张量创建与自动微分的最小示例:
import torch

x = torch.tensor([1.0, 2.0, 3.0], requires_grad=True)
y = x * x
y.sum().backward()
print(x.grad)
这段代码演示了 PyTorch 最核心的工作方式:创建张量时设置 requires_grad=True,表示要为它记录梯度;之后每一步数学运算都会被"磁带"记下来;调用 y.sum().backward() 时,磁带被反向回放,自动算出损失对 x 的梯度并填入 x.grad。整个过程你不需要手写求导公式,框架自动完成。实际训练中,模型定义在 torch.nn.Module 子类里,优化器用 torch.optim,数据用 torch.utils.data.DataLoader 加载,三者配合即可完成标准训练循环。
九、常见问题 FAQ
Q1:pip 安装后 torch.cuda.is_available() 返回 False?
说明装的是 CPU 版 wheel。请回到官方安装选择器,按本机 CUDA 版本重新选择对应安装命令,而不是直接 pip install torch;装完后再次运行该打印命令确认输出为 True 再开始训练。
Q2:源码编译为什么要 10 GB 磁盘、30–60 分钟? 这是 README 明确给出的硬性要求:C++20 编译器 + 全量子模块 + 首次全量编译。后续改动后的增量编译会快很多,普通使用者直接用二进制 wheel 即可,完全不需要走这条路。
Q3:Docker 里多进程数据加载报共享内存不足?
按 README 提示,运行容器时加 --ipc=host 或用 --shm-size 调大共享内存段。这是因为 PyTorch 多进程 DataLoader 依赖共享内存把张量在进程间传递,容器默认的共享内存段通常只有几十到一百多兆,根本不够用。
Q4:只想用 CPU,不想编译 CUDA?
设置环境变量 USE_CUDA=0(ROCm 用 USE_ROCM=0,Intel GPU 用 USE_XPU=0)再编译;或直接在安装选择器里选 CPU 平台。这样编译出来的 PyTorch 只能在 CPU 上跑,但安装快、依赖少,适合学习和轻量实验。
Q5:BSD 风格协议可以商用吗? 可以。README 指明 PyTorch 采用 BSD 风格协议,详见仓库 LICENSE 文件,对研究和商用都非常友好。
Q6:遇到问题去哪里问? 官方论坛 discuss.pytorch.org 讨论实现与研究,GitHub Issues 报 bug 与安装问题,另有 PyTorch Slack 供中高级用户交流。想了解版本发布节奏可看仓库 RELEASE.md,想参与贡献请先阅读 CONTRIBUTING.md。
十、跳转链接
- 项目仓库:pytorch/pytorch
- 官网与安装选择器:pytorch.org/get-started/locally
- 官方教程:pytorch.org/tutorials
- API 文档:pytorch.org/docs
- 模型生态:PyTorch Hub
- 示例代码:github.com/pytorch/examples
以上即 PyTorch 的完整部署路径:新手从官网安装选择器一键装二进制包,需要改源码再走 git clone 加源码编译,服务器环境用 Docker 预构建镜像拉起。装好后先用 torch.cuda.is_available() 确认 GPU 可用,再按官方教程从张量与自动微分一步步练起,就能顺利进入深度学习工程实践。对后续要跑大模型微调的同学,PyTorch 环境就绪只是第一步,上层还会用到配套的数据加载、分布式训练与混合精度工具,这些都在官方教程和示例仓库里有对应章节,值得按顺序通读一遍。