
PageIndex:无向量库、靠推理检索的 RAG 引擎部署指南
PageIndex 是 VectifyAI 开源的无向量、基于推理的 RAG 引擎。它受 AlphaGo 启发,用层级树索引取代向量索引,让大模型像人类专家翻长报告一样"推理着"找到正确章节。它不需要向量数据库、不需要分块,检索结果可追溯、可解释,号称"读起来像人读的"。

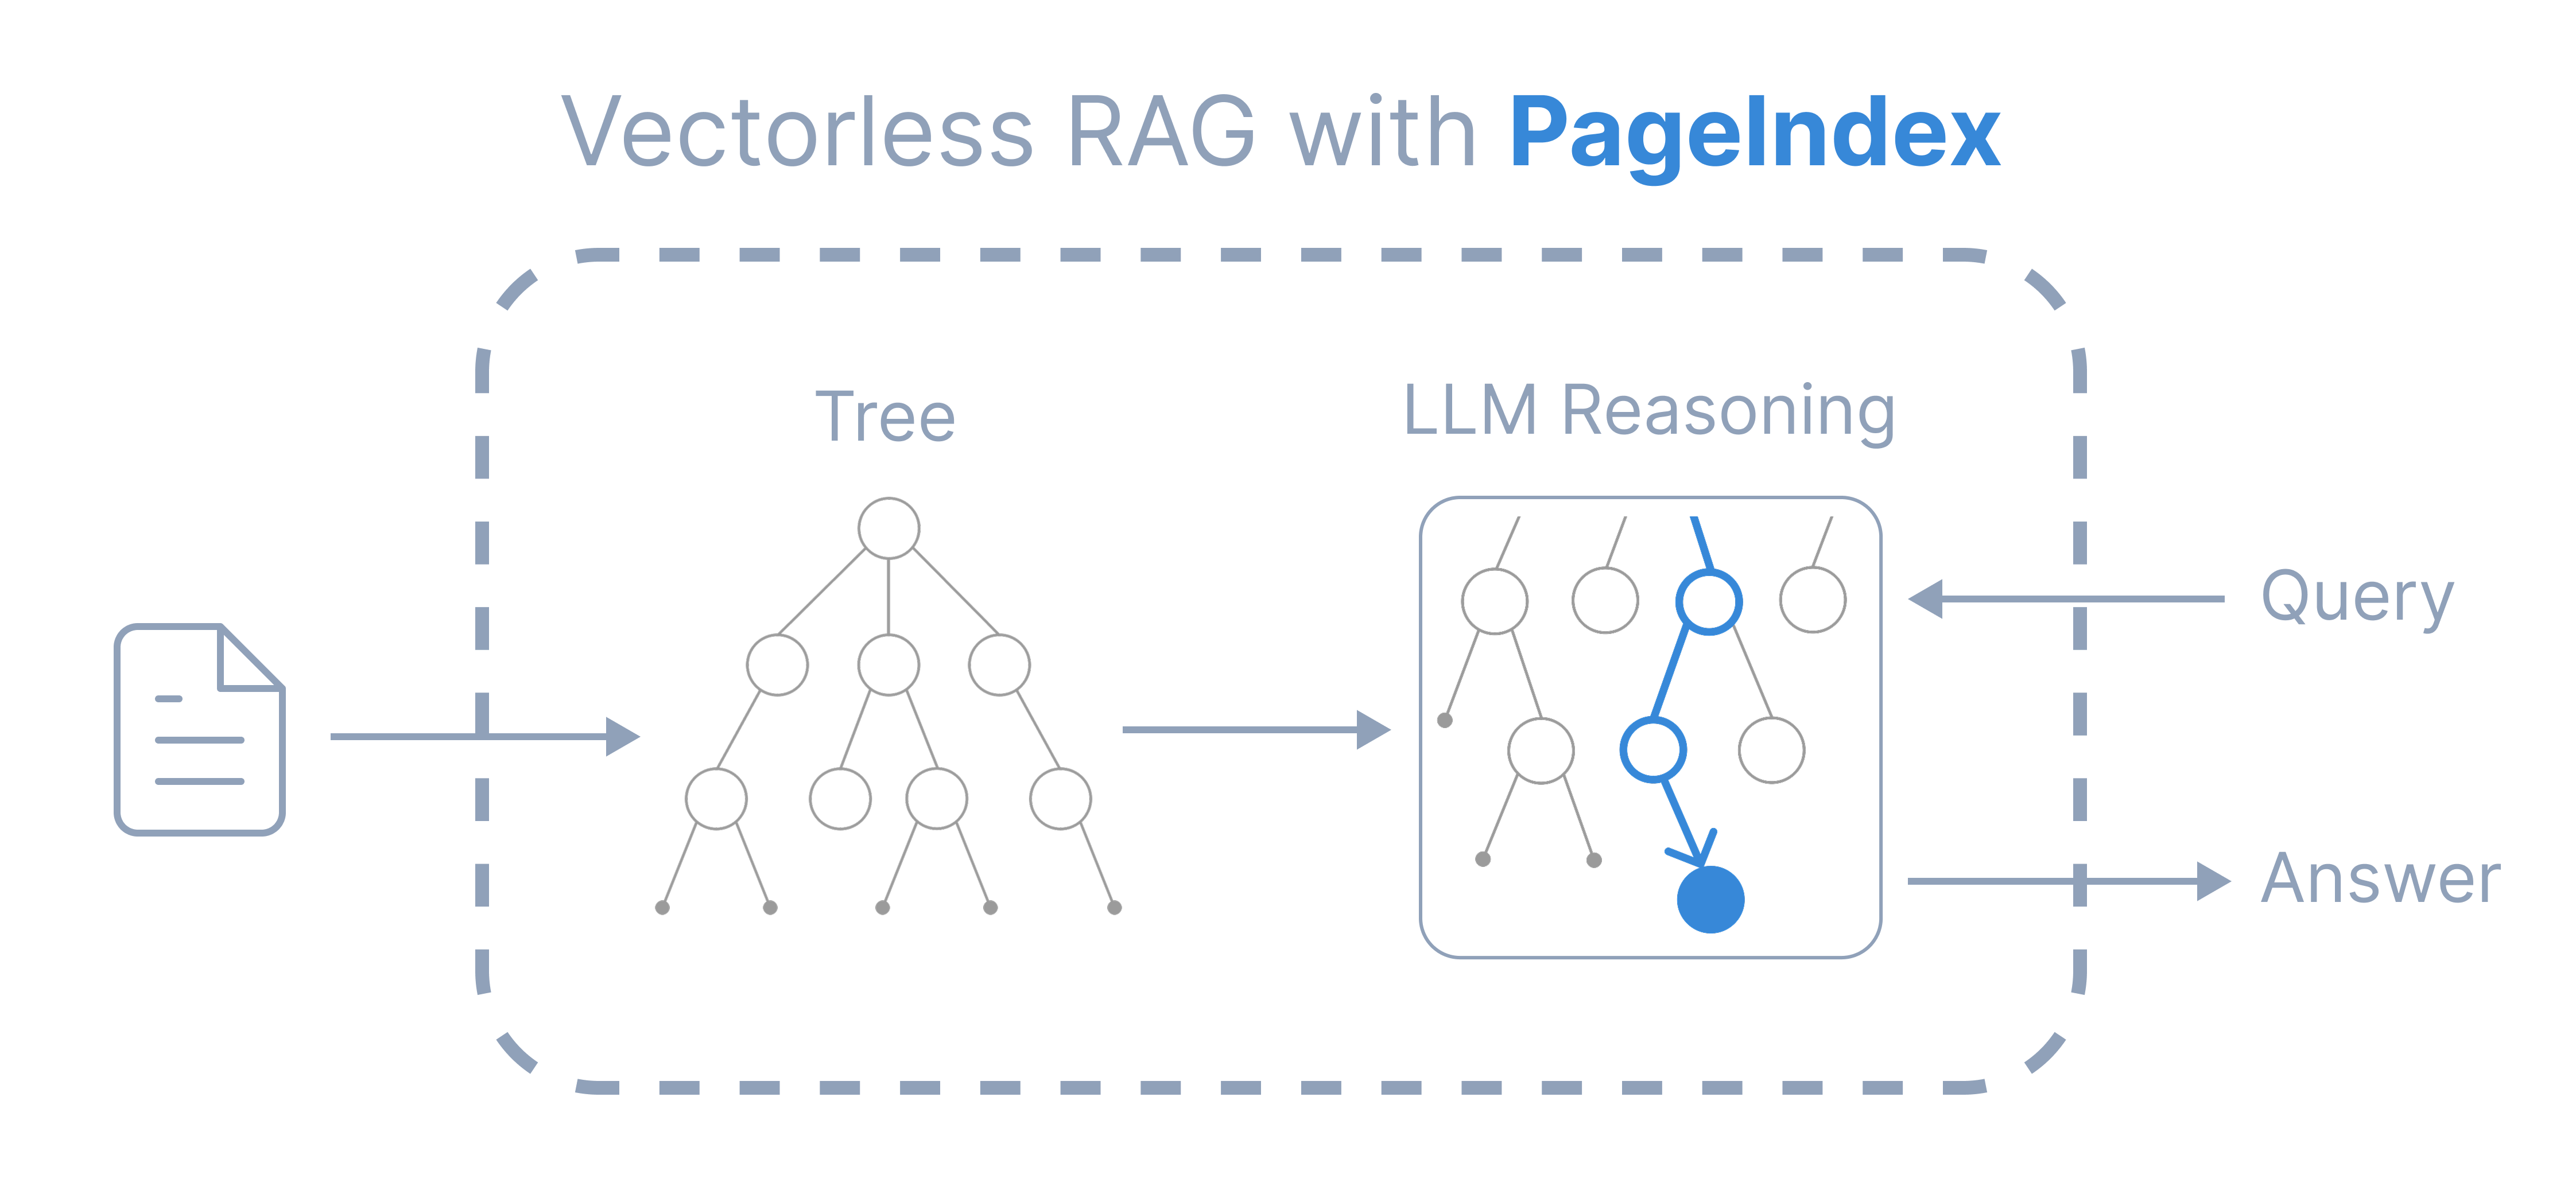
传统向量 RAG 按语义"相似度"检索,但相似度不等于相关性——专业文档里真正相关的内容往往并不相似,而相似的内容又未必相关。PageIndex 把检索分成两步:先为每个文档生成树状结构索引,再让智能体带着 LLM 推理去搜索这棵树。它特别适合财报、法律文件、监管文档、技术手册、医学文献、教材这类又长又复杂的专业文档。
一、项目官方信息
| 项目 | 信息 |
|---|---|
| 项目名称 | PageIndex |
| 项目定位 | 无向量库、基于推理的 RAG 引擎,靠树索引与 LLM 推理检索 |
| 维护组织 | VectifyAI |
| 代码仓库 | VectifyAI/PageIndex |
| 主要语言 | Python |
| 官方文档 | docs.pageindex.ai |
| 开源协议 | MIT |
| Star 数 | 约 39.8k |
| 提供方式 | 本地 SDK 与 PageIndex Cloud |
二、项目背景
做长文档问答时,向量 RAG 经常"答非所问":问一个具体数字,它返回语义相近但不相关的段落;分块还会把一个表格或一段话拦腰截断。根因是相似度不等于相关性——真正相关需要上下文理解和多步推理,而向量检索只会算 embedding 距离。PageIndex 的思路是模仿人类专家:你读一份年报,不会把全文塞进脑子,而是先看目录,判断该翻到哪一节,再细读那一节。
它为每个文档建一棵层级树,树本身从文档版面结构抽取、不强依赖强模型;查询时由 chat 模型带着对话历史和领域知识在树上"推理着走",只读取它推理经过的节点。这样检索成本不随文档长度增长,而且每一步都能追溯到原文位置。
这种做法和人类阅读专业文档的习惯高度一致:你不会把一份 400 页的年报逐字读一遍,而是先看目录定位到"经营讨论与分析"那一节,再看其中"利润率"那段。PageIndex 的树索引就是把这种目录结构显式建出来,chat 模型扮演"翻页的专家",根据问题判断下一个该看哪个分支。相比向量检索把文档切碎后靠 embedding 碰运气,它对需要跨段落综合、引用原文的财务与法律问题明显更稳。
三、核心特性
- 无向量库、无分块:用树索引取代向量索引,省去 embedding 与切分。
- 推理式检索:LLM 在树上走,按上下文判断下一步看哪个节点。
- 可追溯、可解释:结果能指向明确引用,不是黑盒"感觉检索"。
- 上下文感知:检索时带上对话历史和领域知识,而不只是 query 向量。
- 本地与云端双模:一个客户端既可本地跑(自带 LLM key),也可指向 Cloud。
- Flash 快索引:文本 PDF 的快速树索引生成,本地模式默认。
- Page Search API:约一秒找到回答每个问题的页面,再只把这些页给 LLM,宣称在文档问答上砍 97% token 成本。
- 可扩展到百万文档:File System 做文件级树索引层,让它能推理整个语料库。
- 支持 Claude 订阅:用
pip install -U "pageindex[claude]"可直接用你的 Claude 订阅额度,无需 API key。
四、环境要求
- Python:用 pip 安装 SDK。
- LLM key:本地模式需要 OpenAI 兼容 API key;或用 Claude 订阅。
- 索引模型要求低:树结构从版面抽取,索引模型只做摘要精炼,基础模型即可;chat 模型建议用你能负担的最好模型。
- 成本参考:本地建索引约每页 0.001 美元,一本 1000 页教材约一美元多、几分钟,之后每次提问复用索引。
五、部署步骤
方式一:pip 本地安装(推荐)
pip install -U pageindex
import os
from pageindex import PageIndexClient

os.environ["OPENAI_API_KEY"] = "your-openai-key"

client = PageIndexClient(
    index="gpt-6-luna",    # 建树索引用的模型
    chat="gpt-6-sol",      # 搜树用的模型
)
doc_id = client.submit_document("report.pdf")["doc_id"]

answer = client.chat("What was the 2023 operating margin?", doc_id=doc_id)
print(answer)
想用 Claude 订阅额度:
pip install -U "pageindex[claude]"
模型名前加 claude-code/ 前缀,例如 index="claude-code/haiku"、chat="claude-code/opus",用量走你的订阅套餐,无需单独 API key。
方式二:云端托管
不想本地跑模型的话,直接用 PageIndex Cloud,指向云端端点即可,省去索引和运维。
方式三:接入自己的智能体
把 PageIndex 工具放进 OpenAI Agents SDK、Claude Agent SDK 或任意框架,让智能体在需要长文档信息时调用它检索。网页端还有 PageIndex App,是一个像人一样分析长专业文档的智能体。
六、使用方法
典型流程是:提交一次文档建索引(一次性成本),之后反复提问复用索引。index= 用便宜模型即可,因为树结构从版面来、索引模型只做精炼;chat= 用强模型,因为它要在树上推理找答案。
和"每次把整份 PDF 塞给模型"相比,PageIndex 的查询成本不随文档长度涨。官方基准里,52 页时原生 PDF 输入贵 2.1 倍,420 页时贵 16.6 倍,到 805 页文档干脆塞不进上下文窗口。多文档检索、流式、引用、自定义模型都在 SDK 文档里配置。
落地时建议:先用一份真实长文档(如一份财报)建索引,问几个需要跨段落的问题,对比向量 RAG 的答案;满意后再把它接进自己的问答或智能体。索引是一次性投入,建好后同一文档反复问都走同一棵树,越用越划算。
七、常见问题 FAQ
Q:一定要向量数据库吗? A:不要。它用层级树索引,不建 embedding、不做分块,省去向量库运维。
Q:为什么比向量 RAG 准? A:相关性靠推理而非相似度。它带着上下文在树上判断该看哪一节,适合需要领域理解和多步推理的长文档。
Q:建索引贵吗? A:约每页 0.001 美元,一次建好反复用;索引模型用基础模型即可省钱。
Q:查询成本会随文档变大而涨吗? A:不会。它只读推理经过的节点,成本由树遍历决定,而不是文档长度。
Q:没有 OpenAI key 能用吗? A:能。装 pageindex[claude] 用 Claude 订阅额度,或指向 PageIndex Cloud。
Q:适合什么文档? A:财报、法律、监管、技术手册、医学文献、教材等长而复杂的专业文档;短简单问答用普通向量 RAG 也够。
局限与注意
树索引依赖文档版面结构,扫描件或版式混乱的 PDF 要先转成文本;建索引是一次性成本,极短文档用它反而比直接整文输入更重。它解决的是长文档精准检索,短问答不必上这套。Chat 模型强决定准确率,预算有限时把钱花在 chat 模型上而不是 index 模型。
索引与查询模型怎么选
建索引时 index= 用便宜模型即可,因为树结构主要来自文档版面,索引模型只做摘要精炼;chat= 选你能负担的最强模型,它负责在树上推理找答案,直接影响准确率。本地模式默认 Flash 快速树索引,适合文本类 PDF;扫描件或复杂版式先转成文本再索引。一本 1000 页教材建索引约一美元、几分钟,之后每次提问都复用,越用越摊薄。
什么时候该用它
文档越长、越专业、越需要跨段落综合和引用原文,它相对向量 RAG 的优势越大;短问答或事实性小问题,普通向量 RAG 或直接整文输入更省事。把它接进自己的智能体时,按"先建一次索引、再反复提问"的模式组织,而不是每次重新索引。
总体而言,PageIndex 用"树索引加推理"替代了向量相似度检索,让长专业文档的问答更准、更省、可追溯。它不建向量库、不分块,索引一次建好反复用,查询成本不随文档长度涨,是财报、法律、医学文献这类复杂文档问答的新范式。
- GitHub 仓库:VectifyAI/PageIndex
- 官方文档:docs.pageindex.ai
- 云端:developer.pageindex.ai
- 介绍博客:pageindex-intro
- 财务 QA 基准:pageindex-benchmarks
- Page Search API:search.pageindex.ai
- 问题反馈:GitHub Issues
小结:PageIndex 用树索引加推理替代向量相似度检索,让长专业文档问答更准、更省、可追溯。索引一次建好反复用,查询成本不随文档长度涨,是复杂文档问答的新范式。
进阶:用 Page Search API 把"找到回答问题的页面"单独抽成一步,再只把相关页喂给 LLM,宣称在文档问答上大幅砍 token。多文档场景用 File System 层做文件级树索引,让它推理整个语料库。接进自己的智能体时,按"先建一次索引、再反复提问"组织,避免重复建索引。
社区与生态:VectifyAI 出品,提供 SDK、Cloud 和 Page Search API,强调"无向量"这一反主流路线。它发布了财务 QA 基准对比向量 RAG,用数据说明准确率和成本差异。社区围绕长文档、专业文档问答讨论,适合对 RAG 精度不满、想试新范式的团队。
落地建议:先拿一份真实长文档建索引,问几个需要跨段落的问题,和向量 RAG 对比答案,确认收益后再接进自己的问答或智能体。索引用便宜模型、查询用强模型,控制成本。文档越长越专业,它的优势越大;短问答不必上这套。
为什么值得用:向量 RAG 靠相似度找内容,专业文档里相关≠相似;PageIndex 用树索引加推理让模型像人翻报告一样找答案,可追溯、不建向量库、查询成本不随文档涨。
对比:和向量 RAG 比,它不靠 embedding 相似度,而是 LLM 在树上推理找答案,结果可追溯;和每次整文输入比,它成本不随文档长度涨,超长文档也塞得进。
上手顺序:pip 装 SDK→配 key→提交一份文档建索引→提问验证→和向量 RAG 对比→接进自己的智能体。索引一次建好反复用,成本摊薄。
结语:当向量 RAG 在专业长文档上"答非所问",PageIndex 用树索引加推理给出了另一条路:像人翻报告一样找答案,可追溯、不建向量库、成本可控。
记住三件事:索引用便宜模型、查询用强模型、一次建索引反复用。
再提醒:扫描件先转文本再索引;短文档不必上这套;预算有限时把钱花在 chat 模型上。
本文基于官方 README 整理,SDK 命令与模型名以仓库最新版为准;本地模式先配好 LLM key,建索引后反复提问验证效果。
希望这份部署指南帮你在长文档问答上拿到更准的答案。
部署前再确认一次 LLM key 额度和模型名,建索引前先用小文档验证效果。
祝你在长文档上拿到又准又省的答案。
建索引时先用便宜模型,查询时再上强模型。
这份指南到此结束,祝你检索效果如预期。
如遇问题,先看仓库 issue 与官方文档。
先拿一份真实长文档对比向量 RAG,确认收益再接进生产。
索引是一次性投入,建好后反复提问更划算。
希望这份指南帮你跑通第一个索引。
总之,PageIndex 用树索引加推理重新定义了长文档 RAG:不建向量库、不分块、成本可控、结果可追溯。它把"像人翻报告"这件事做成了工程,值得对向量 RAG 精度不满的团队一试。
祝你部署顺利。
更多细节见官方仓库与文档。
本文完。
感谢阅读。
如有用请转发给同事。
下期再见。
欢迎关注。
祝好。
完。
它的真正价值在于把"像人一样翻报告"这件隐性认知变成可工程化的树索引加推理流程,让长文档问答不再靠碰运气。 谢谢阅读。