

仓库:https://github.com/bentoml/OpenLLM 模型仓库:https://github.com/bentoml/openllm-models 许可证:Apache-2.0 默认端口:3000(OpenAI 兼容 API +
/chatUI)
1. 项目简介
OpenLLM 是 BentoML 团队出品的自托管大模型工具:一条命令把任意开源 LLM(Llama 3.3、Qwen2.5、Phi3 等)或自定义模型跑成 OpenAI 兼容 API。内置 chat UI、vLLM 等推理后端,并提供 Docker / Kubernetes 企业级部署工作流。
1.1 核心信息一览
| 项目 | 内容 |
|---|---|
| 仓库 | bentoml/OpenLLM |
| 定位 | 自托管 LLM 为 OpenAI 兼容 API |
| 许可证 | Apache-2.0 |
| 安装 | pip install openllm |
| 服务端口 | 3000(/v1 OpenAI 兼容、/chat UI) |
| 推理后端 | vLLM 等 |
| 鉴权 | 可选 API Key;gated 模型需 HF_TOKEN |
1.2 适用场景
- 想把开源 LLM 快速暴露成 OpenAI 兼容端点;
- 已有 OpenAI SDK 客户端,想换成本地自托管模型;
- 需要 Docker / K8s 企业级部署工作流。
1.3 能力边界(官方口径)
- OpenLLM 不存储模型权重,gated 模型需自备
HF_TOKEN并申请授权; - 自定义模型需按 BentoML 流程构建 Bento;
- 模型列表以官方 openllm-models 仓库为准。
2. 功能特性
- 一条命令起服务:
openllm serve <model>; - OpenAI 兼容
API:
http://localhost:3000/v1,可直接用 openai-python / LlamaIndex 接入; - 内置 Chat
UI:
http://localhost:3000/chat; - CLI
对话:
openllm run <model>; - 模型仓库:
openllm model list/openllm repo update/openllm model get; - 自定义仓库:
openllm repo add <name> <url>(仅公开仓库); - 生产部署:Docker / Kubernetes。
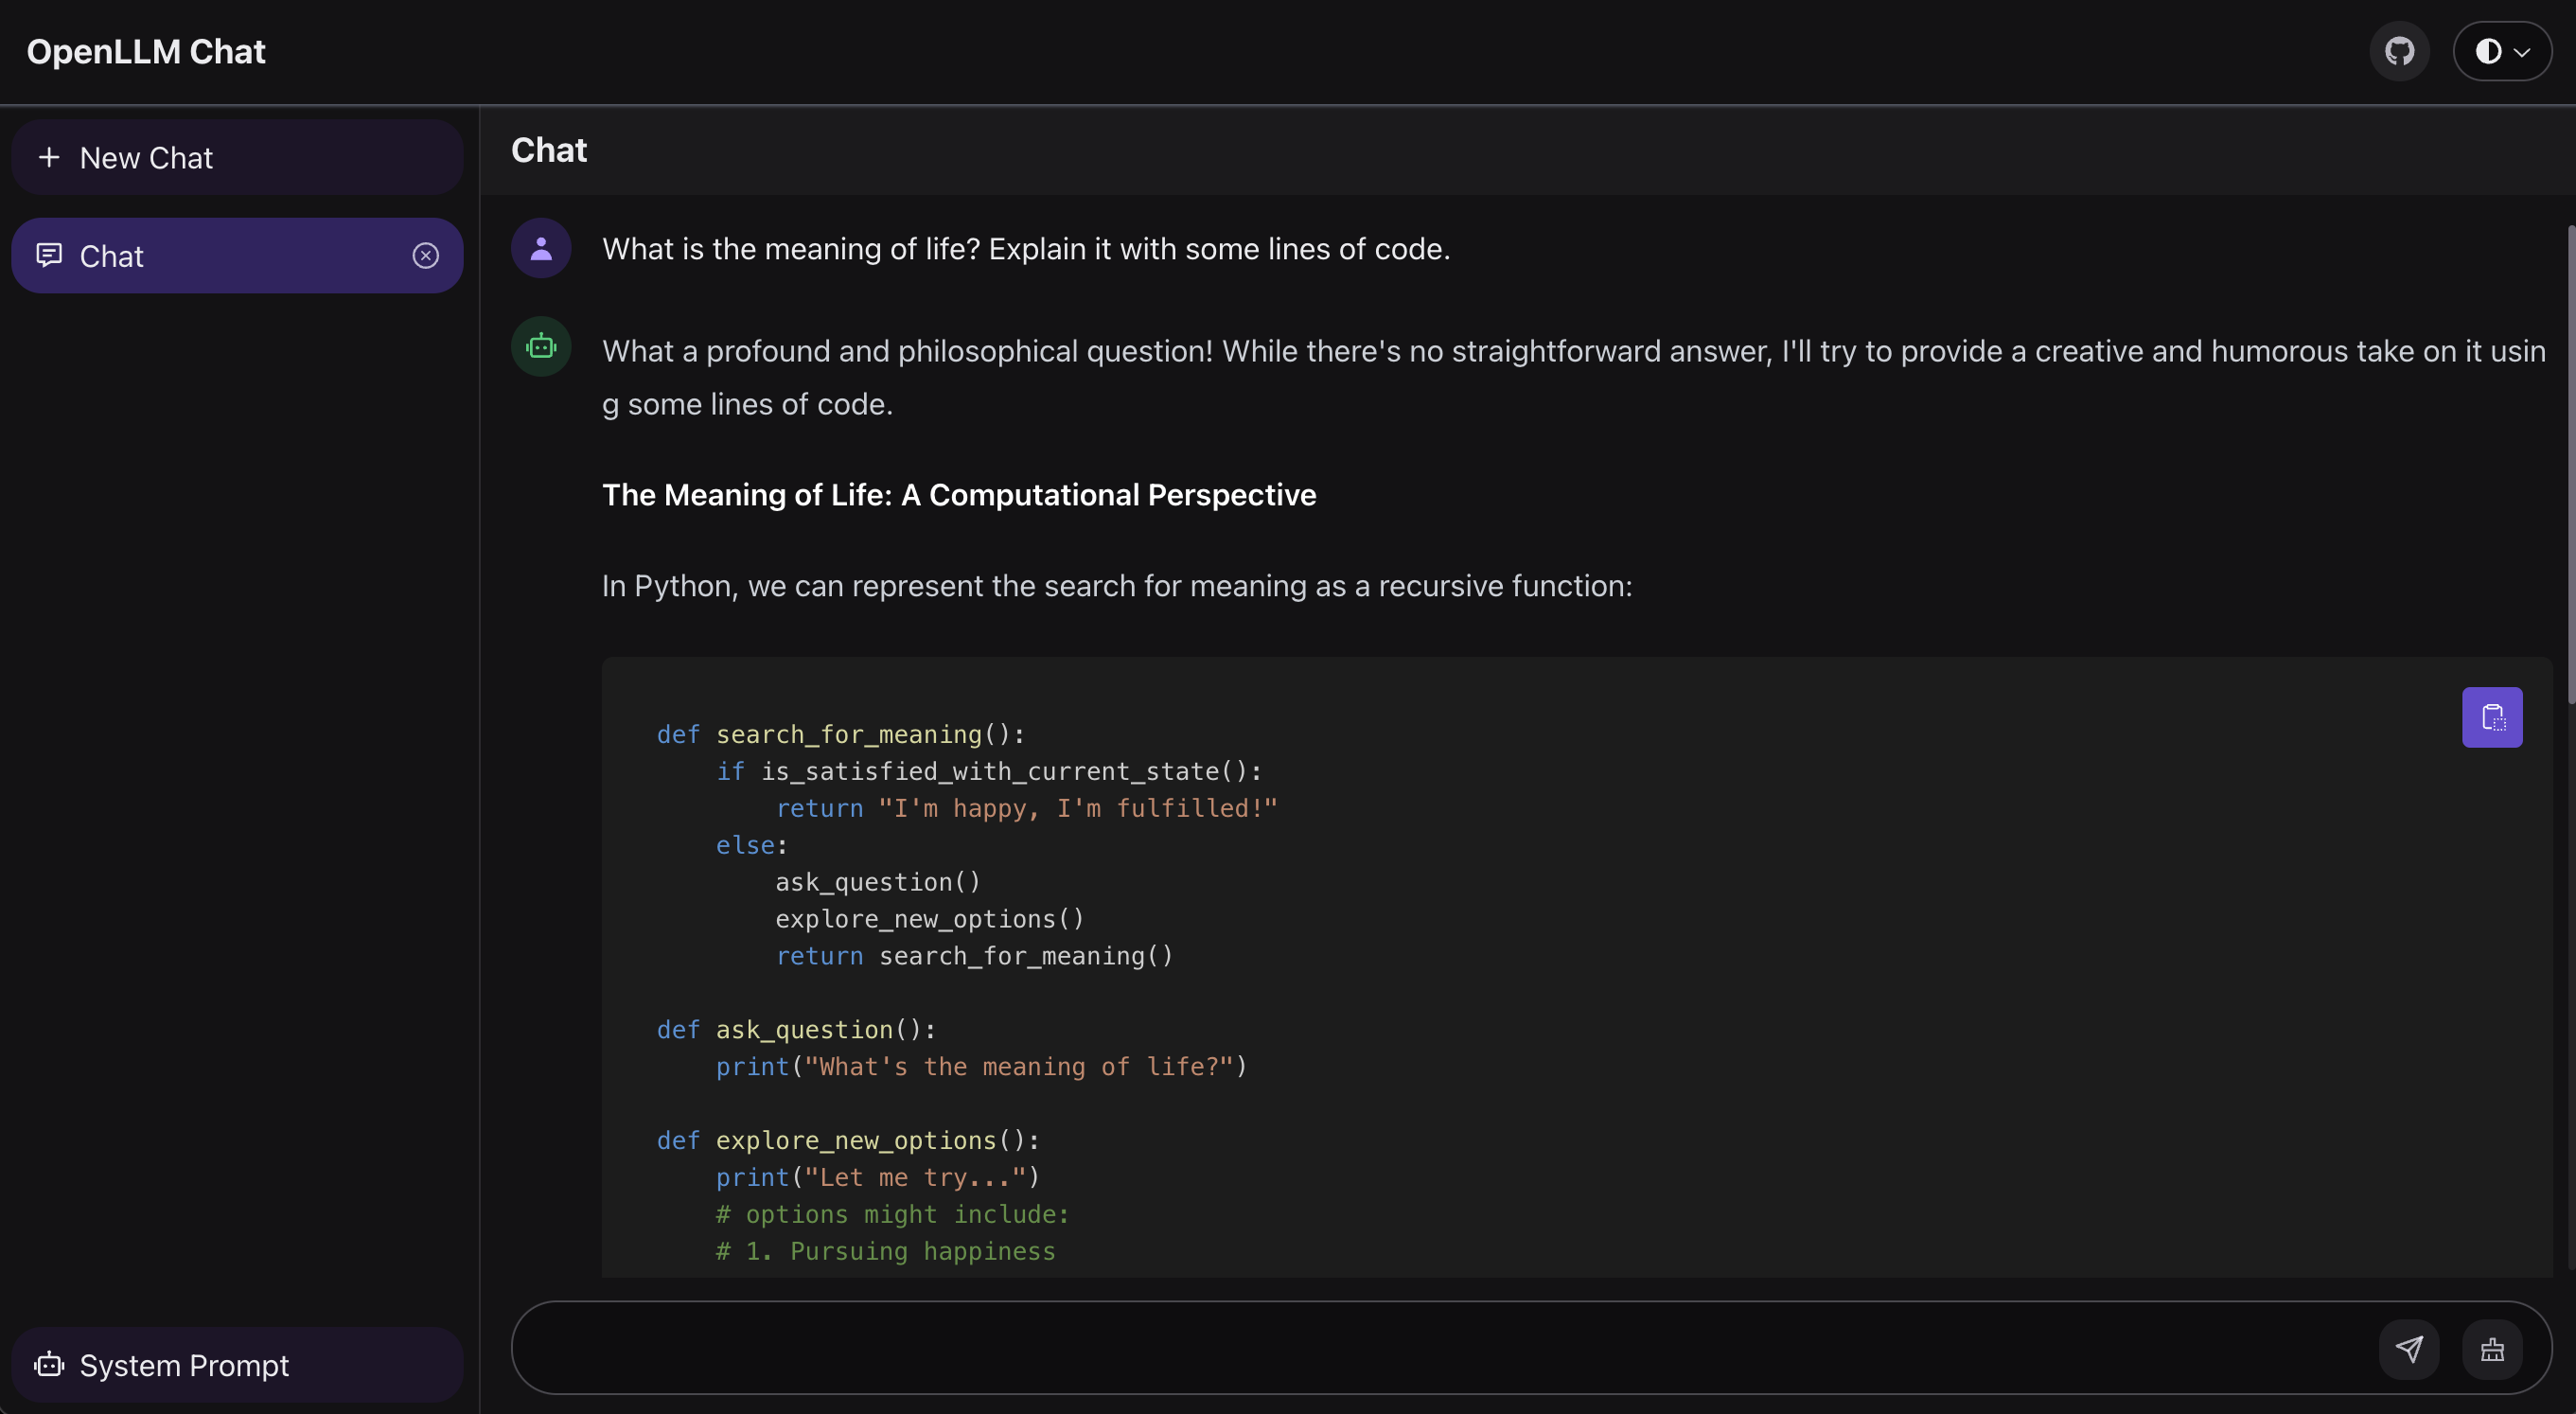
3. 官方界面预览
上图为官方 README 的 Chat UI 截图(README 官方素材)。
4. 官方跳转链接汇总
- 仓库主页:https://github.com/bentoml/OpenLLM
- 模型仓库:https://github.com/bentoml/openllm-models
- 设计博客:https://www.bentoml.com/blog/from-ollama-to-openllm-running-llms-in-the-cloud
- BentoML 文档:https://docs.bentoml.com/
- 开发者指南:https://github.com/bentoml/OpenLLM/blob/main/DEVELOPMENT.md
- Slack 社区:https://l.bentoml.com/join-slack
5. 前置要求与服务器配置
- Python 环境;
- 推荐 GPU(模型列表给出所需 GPU,如 llama3.1:8b 约 24G);
- gated 模型:https://huggingface.co/settings/tokens
建 token 并
export HF_TOKEN=<token>; - 端口 3000 不被占用。
6. 方式一:pip 安装并起服务(推荐)
pip install openllm
openllm hello
起一个模型服务:
openllm serve llama3.2:1b服务在 http://localhost:3000,OpenAI
兼容端点为 /v1,UI 在 /chat。
OpenAI Python 客户端接入:
from openai import OpenAI

client = OpenAI(base_url='http://localhost:3000/v1', api_key='na')

chat = client.chat.completions.create(
    model="meta-llama/Llama-3.2-1B-Instruct",
    messages=[{"role": "user", "content": "Explain superconductors like I'm five years old"}],
    stream=True,
)
for chunk in chat:
    print(chunk.choices[0].delta.content or "", end="")
7. 方式二:CLI 对话与自定义仓库
# CLI 直接对话
openllm run llama3:8b

# 列模型
openllm model list

# 同步最新仓库
openllm repo update

# 查看模型信息
openllm model get llama3.2:1b

# 加自定义公开仓库
openllm repo add <repo-name> <repo-url>
8. 配置项说明
| 配置 | 说明 |
|---|---|
HF_TOKEN |
gated 模型所需 Hugging Face token |
openllm serve <model>:<tag> |
起服务,默认 3000 |
| API host | 默认 http://localhost:3000 |
| API key | 客户端鉴权用,可选 |
| 自定义仓库 | 需按 BentoML 构建 Bento,公开仓库 |
9. 常用运维命令
# 安装
pip install openllm

# 体验
openllm hello

# 起服务
openllm serve llama3.2:1b

# 列/查模型
openllm model list
openllm model get llama3.2:1b

# 同步仓库
openllm repo update
10. 常见故障排查
- gated 模型 401:确认已
export HF_TOKEN并在 HF 申请该模型访问权; - 显存不足:按模型列表选小参数版本或多卡;
- 客户端连不上:确认 3000 端口与
base_url=.../v1; - 模型找不到:先
openllm repo update同步。
11. 风险与合规说明
- Apache-2.0 许可;
- 模型权重版权归各自发布方,使用遵守其许可;
- GPU 成本由使用者承担;
- 本文为社区部署笔记,命令以官方 README 最新版本为准。