
MuseTalk —— 腾讯音乐 Lyra Lab 出品的实时高保真音频驱动视频口型同步模型
适用场景:给已有视频/照片中的人物换配音口型、配合 MuseV 生成的虚拟人视频完成口型对齐、离线批量配音成片;仓库同时提供普通推理、实时推理与 Gradio 网页 Demo 三套入口。本节命令与参数均以官方 README、官方仓库脚本(
scripts/inference.py、scripts/realtime_inference.py、app.py、inference.sh、download_weights.sh、download_weights.bat、requirements.txt、configs/inference/*.yaml)为准。
项目定位与基本信息
| 项目 | 内容 |
|---|---|
| 一句话定位 | 实时高质量音频驱动口型同步模型(MuseTalk: Real-Time High-Fidelity Video Dubbing via Spatio-Temporal Sampling),在 ft-mse-vae 潜空间中按输入音频修改人脸区域(256×256),支持中/英/日等多语言音频,NVIDIA Tesla V100 上 30fps+(来源:官方 README Overview 与开头摘要) |
| 开源许可 | 代码:MIT License(Copyright © 2024 Tencent Music Entertainment Group),学术与商业使用均无限制;训练好的模型权重:README 声明可用于任何用途,包括商业用途;whisper、ft-mse-vae、dwpose、S3FD 等第三方开源组件须遵守各自许可证;测试数据集仅可用于非商业研究目的(来源:官方仓库 LICENSE 文件 + README "Disclaimer/License" 章节,web_fetch 核验) |
| 官方 GitHub 仓库 | https://github.com/TMElyralab/MuseTalk(curl HEAD 200,2026-10-25 核验) |
| 官方 HuggingFace 权重仓库 | https://huggingface.co/TMElyralab/MuseTalk(curl HEAD 200);官方在线 Gradio Demo:https://huggingface.co/spaces/TMElyralab/MuseTalk(curl HEAD 200) |
| 官方文档/官网 | 本项目没有独立官方文档站点;使用说明全部位于 GitHub README;技术报告:https://arxiv.org/abs/2410.10122(curl 200),v2 版本 https://arxiv.org/abs/2410.10122v2(curl 200)。README 称"对新用户提供了详细安装与使用教程",即仓库 README 本身 |
| 版本信息 | 官方未在 GitHub Releases 发布版本包(release 徽章显示 "no releases or repo not found",2026-10-25 curl 核验);模型版本以 README News 为准:MuseTalk 1.5 于 2025-03-28 发布(清晰度、身份一致性、唇音同步均优于 1.0);训练代码于 2025-04-05 开源;1.0 版本于 2024-04-02 发布。当前 main 分支推理命令同时支持 v1(1.0)与 v15(1.5) |
| 作者 / 机构 | Yue Zhang、Zhizhou Zhong、Minhao Liu、Zhaokang Chen、Bin Wu†、Yubin Zeng、Chao Zhan、Junxin Huang、Yingjie He、Wenjiang Zhou;同等贡献,†通讯作者 benbinwu@tencent.com;腾讯音乐娱乐 Lyra Lab(README 首页署名) |
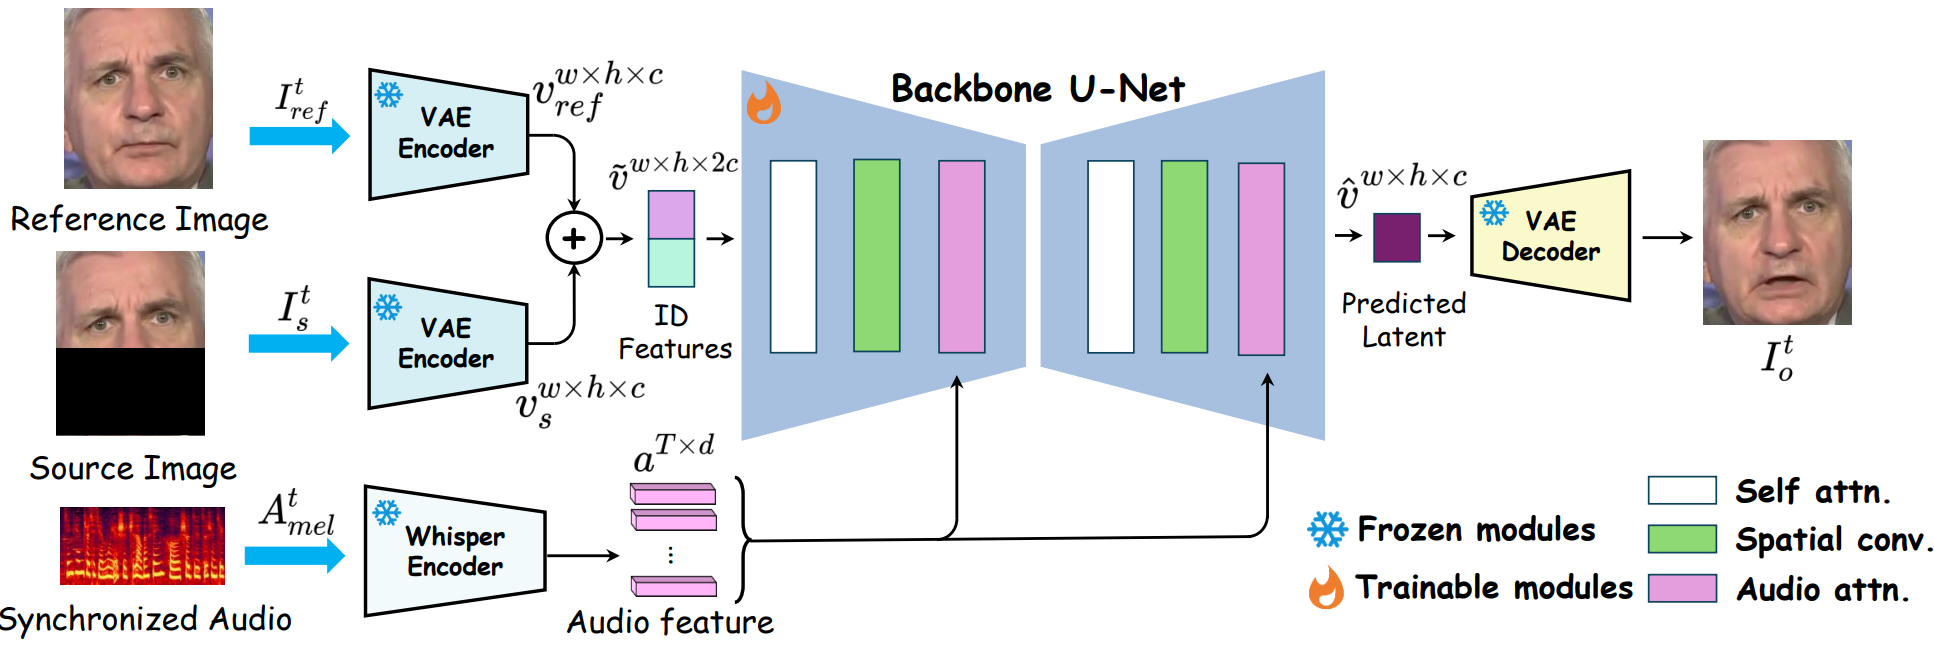
| 技术要点 | 非扩散模型:单次前向在潜空间完成 inpainting;音频由冻结的 whisper-tiny 编码;生成网络借用 Stable Diffusion UNet 结构,音频 embedding 经交叉注意力融合到图像 embedding(README "Model" 章节) |
| 已知局限(README "Limitations") | 人脸区域 256×256,分辨率未达理论上限,可结合 GFPGAN 等超分模型提升;胡须、唇形唇色等面部细节保留不充分;当前流水线逐帧生成,存在抖动 |
官方图片
图 07-1 MuseTalk 模型结构(README "Model" 章节原图)

- 来源 URL:https://github.com/user-attachments/assets/02f4a214-1bdd-4326-983c-e70b478accba(README
原始链接,跟随 302 重定向下载) - 下载方式:
curl -L -o 07_musetalk_model_structure.png "<上述 URL>";2026-10-25 下载后file校验:PNG image data, 1934 x 646, 8-bit/color RGBA,大小 410,486 字节(>20KB)。
图 07-2 Gradio Demo 参数面板(README "Gradio Demo" 章节引用图 assets/figs/gradio_2.png)
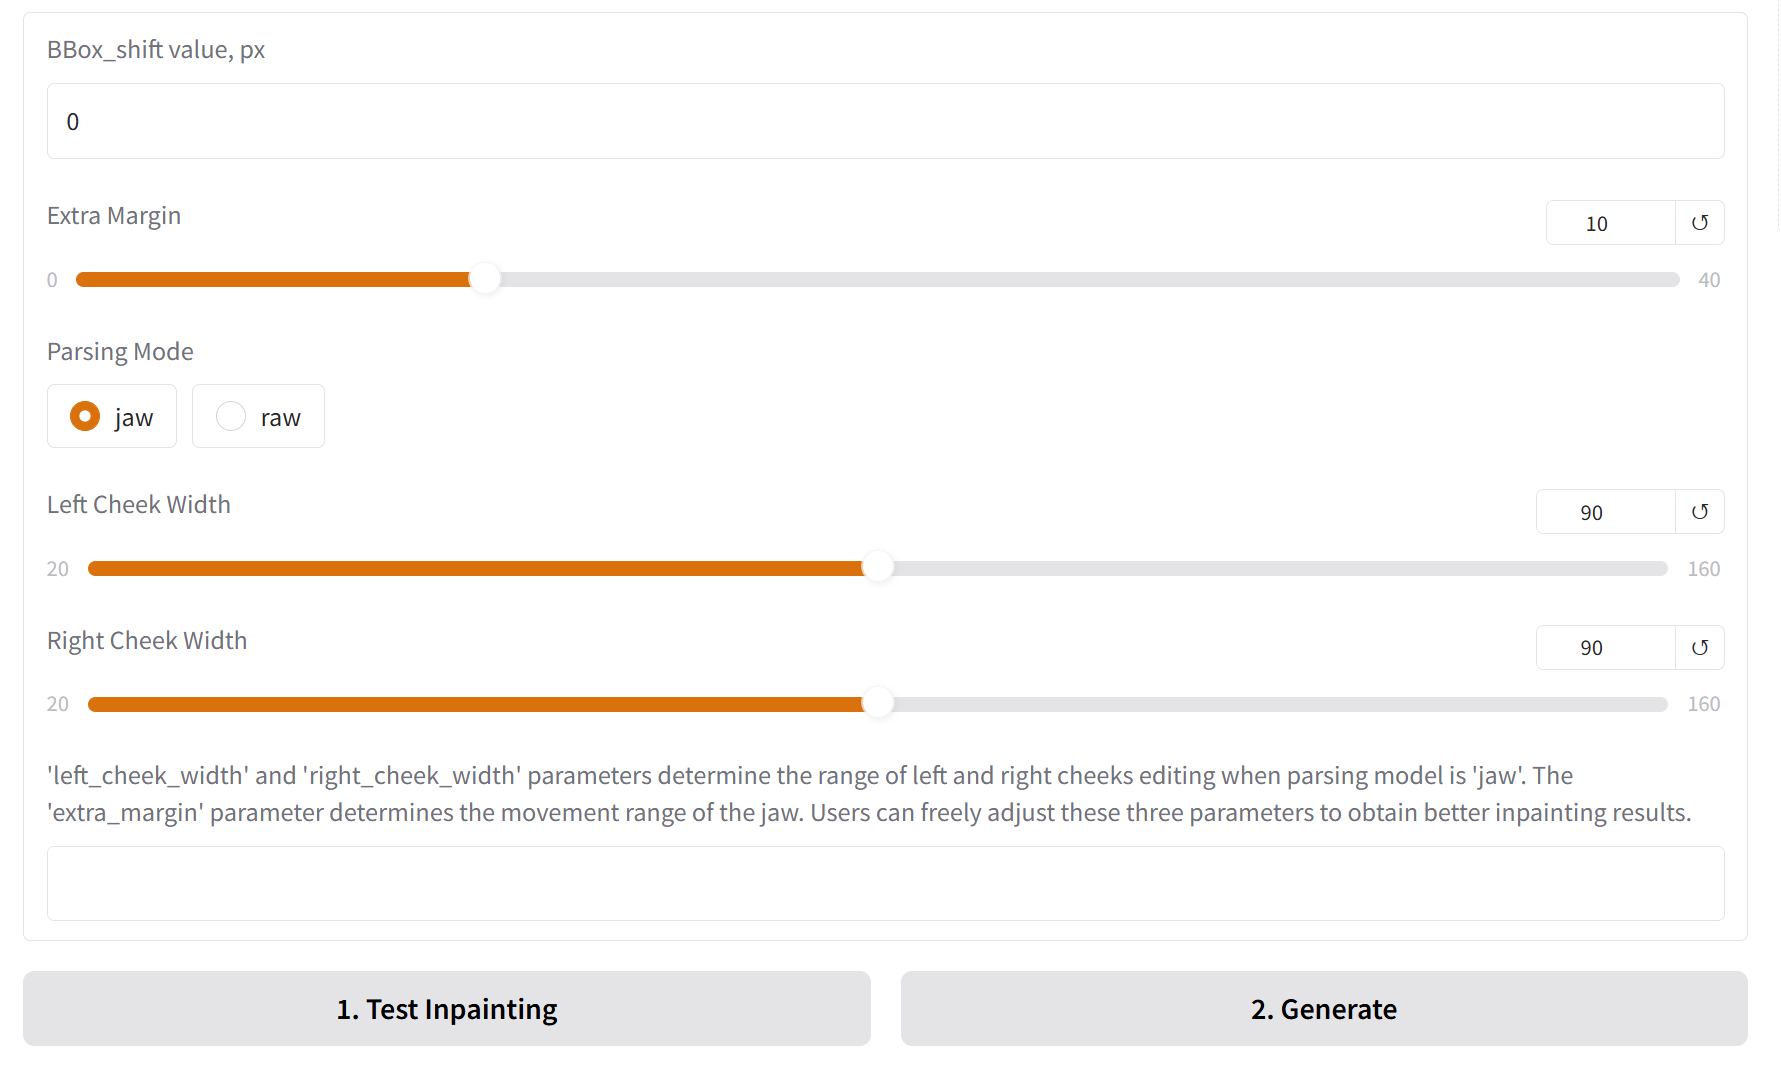
- 来源 URL:https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/assets/figs/gradio_2.png
- 下载方式:
curl -L -o 07_musetalk_gradio_params.png "<上述 URL>";2026-10-25 下载后file校验:PNG image data, 1781 x 1066, 8-bit/color RGBA,大小 75,170 字节(>20KB)。
说明:仓库另一张
assets/figs/gradio.png(硬件耗时对比图)下载后仅 13,911 字节,未达到本节 ">20KB" 的交付要求,故未引用;本地亦未保留。
环境要求
| 维度 | 要求 / 说明 | 官方依据 |
|---|---|---|
| 操作系统 | README 同时提供 Linux 与 Windows 的安装、普通推理、实时推理命令;Gradio Demo 官方实测环境为 Windows + NVIDIA RTX 3050 Ti Laptop GPU(README "Gradio Demo" 章节)。本机 WSL2 Ubuntu 24.04 与 Windows 10/11 原生均可执行 README 命令 | README Installation / Quickstart / Gradio Demo |
| Python | 官方推荐 Python 3.10(conda create -n MuseTalk python==3.10) |
README "Build environment" |
| CUDA / PyTorch | 官方推荐 CUDA 11.7;安装 PyTorch 2.0.1、torchvision 0.15.2、torchaudio 2.0.2,提供 pip(cu118 wheel)与 conda 两种方式 | README "Install PyTorch 2.0.1" |
| GPU 与显存 | 实时推理基准:NVIDIA Tesla V100 上 30fps+(README Overview)。官方最低实测:Windows + RTX 3050 Ti Laptop 4GB 显存,fp16 模式生成 8 秒视频约 5 分钟(README Gradio 章节)。官方未列出其他消费级显卡的显存占用 GB 数值(待实测) | README Overview / Gradio Demo |
| 本机显卡适配说明 | RTX 3070 8GB:高于官方最低实测的 4GB 机型,离线普通推理在 fp16 下可运行;官方未承诺 3070 达到实时帧率,实时推理速度以本机实测为准。RTX 4090 24GB:显存余量充足,可关闭 fp16 换取更好画质。以上为对照官方最低配置的说明,非官方实测结论 | README Gradio 章节(对照得出,已注明) |
| 内存 | 官方 README / 脚本未列明内存容量要求(待验证) | — |
Python 依赖(requirements.txt 钉版,web_fetch 核验原文) |
diffusers==0.30.2、accelerate==0.28.0、numpy==1.23.5、tensorflow==2.12.0、tensorboard==2.12.0、opencv-python==4.9.0.80、soundfile==0.12.1、transformers==4.39.2、huggingface_hub==0.30.2、librosa==0.11.0、einops==0.8.1、gradio==5.24.0、gdown、requests、imageio[ffmpeg]、omegaconf、ffmpeg-python、moviepy |
https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/requirements.txt |
| MMLab 生态依赖 | openmim → mmengine → mmcv==2.0.1 → mmdet==3.1.0 → mmpose==1.1.0(README "Install MMLab Packages" 原文版本号) |
README Installation |
| ffmpeg | 普通推理与视频合成依赖 ffmpeg;README 要求先 ffmpeg -version 确认可用;Linux sudo apt-get install ffmpeg;Windows 从 FFmpeg static 构建下载并加入 PATH,或通过 --ffmpeg_path 参数指定 |
README "Setup FFmpeg" + Quickstart "Prerequisites" + scripts/inference.py |
| 磁盘空间 / 模型权重体积 | 下列体积为 2026-10-25 对各 HF / 官方 URL 执行 HTTP HEAD(Content-Length)实测;官方 README 未给出官方体积说明。7 个已测文件合计约 8.59 GiB;人脸解析 79999_iter.pth 托管于 Google Drive,本次未取得体积(待验证);另需为输出帧图片与成片预留磁盘 |
07.4.3 权重清单表(实测值 + 出处 URL) |
最详细部署步骤(WSL2 Ubuntu 24.04 / Windows 10-11 双视角)
环境搭建(README Installation 原文命令)
视角 A:WSL2 Ubuntu 24.04 / Linux
# 1. 创建官方推荐环境
conda create -n MuseTalk python==3.10
conda activate MuseTalk

# 2. 安装 PyTorch 2.0.1(README Option 1:pip cu118 wheel)
pip install torch==2.0.1 torchvision==0.15.2 torchaudio==2.0.2 --index-url https://download.pytorch.org/whl/cu118
# README Option 2(conda 方式,二选一即可):
# conda install pytorch==2.0.1 torchvision==0.15.2 torchaudio==2.0.2 pytorch-cuda=11.8 -c pytorch -c nvidia

# 3. 拉取源码
git clone https://github.com/TMElyralab/MuseTalk.git
cd MuseTalk

# 4. 安装其余 Python 依赖(README 原文命令)
pip install -r requirements.txt

# 5. 安装 MMLab 生态(README 原文命令)
pip install --no-cache-dir -U openmim
mim install mmengine
mim install "mmcv==2.0.1"
mim install "mmdet==3.1.0"
mim install "mmpose==1.1.0"

# 6. 安装 ffmpeg(README Quickstart Prerequisites:Linux 用系统包管理器)
sudo apt-get update && sudo apt-get install -y ffmpeg
ffmpeg -version    # 确认命令在 PATH 中
视角 B:Windows 10/11 原生
# 1. conda 环境(与 Linux 一致)
conda create -n MuseTalk python==3.10
conda activate MuseTalk

# 2. PyTorch(README 同一组 pip 命令,Windows 下直接可用)
pip install torch==2.0.1 torchvision==0.15.2 torchaudio==2.0.2 --index-url https://download.pytorch.org/whl/cu118

# 3. 源码与依赖
git clone https://github.com/TMElyralab/MuseTalk.git
cd MuseTalk
pip install -r requirements.txt
pip install --no-cache-dir -U openmim
mim install mmengine
mim install "mmcv==2.0.1"
mim install "mmdet==3.1.0"
mim install "mmpose==1.1.0"
ffmpeg 安装(README "Setup FFmpeg" 原文):
- 下载 ffmpeg-static 构建包:https://github.com/BtbN/FFmpeg-Builds/releases(curl 200 核验)。
- Linux:解压后设置环境变量
export FFMPEG_PATH=/path/to/ffmpeg,README 示例export FFMPEG_PATH=/musetalk/ffmpeg-4.4-amd64-static。 - Windows:将
ffmpeg-xxx\bin目录加入系统 PATH;命令行运行ffmpeg -version能输出版本信息即配置成功;也可以在推理命令中用--ffmpeg_path参数指定实际 bin 目录(README Windows 推理命令即采用该方式)。
下载权重(两种官方方式)
方式一:官方下载脚本(推荐,脚本内置国内 HF 镜像)
| 系统 | 命令 | 脚本事实(web_fetch 核验源码) |
|---|---|---|
| Linux | sh ./download_weights.sh |
脚本内 export HF_ENDPOINT=https://hf-mirror.com;依次下载 v1.0、v1.5、sd-vae、whisper、dwpose、syncnet;gdown 下载人脸解析权重;curl 下载 resnet18 |
| Windows | download_weights.bat |
脚本内 set HF_ENDPOINT=https://hf-mirror.com;使用 hf download 命令拉取 TMElyralab/MuseTalk 整仓及上述子模型;人脸解析从 HF ManyOtherFunctions/face-parse-bisent 下载两个文件 |
方式二:手动下载(README "Option 2: Manual Download" 原文清单)
- MuseTalk 训练权重:https://huggingface.co/TMElyralab/MuseTalk/tree/main
- 其他组件权重: - sd-vae-ft-mse:https://huggingface.co/stabilityai/sd-vae-ft-mse/tree/main(curl 200) - whisper-tiny:https://huggingface.co/openai/whisper-tiny/tree/main(curl 200) - dwpose:https://huggingface.co/yzd-v/DWPose/tree/main(curl 200) - syncnet:https://huggingface.co/ByteDance/LatentSync/tree/main(curl 200) - face-parse-bisent 79999_iter.pth:https://drive.google.com/file/d/154JgKpzCPW82qINcVieuPH3fZ2e0P812/view?pli=1 - resnet18:https://download.pytorch.org/models/resnet18-5c106cde.pth(curl 实测 46,827,520 字节)
权重目录结构(README 原文树形清单,必须按此组织到 models/ 下):
./models/
├── musetalk
│   ├── musetalk.json
│   └── pytorch_model.bin
├── musetalkV15
│   ├── musetalk.json
│   └── unet.pth
├── syncnet
│   └── latentsync_syncnet.pt
├── dwpose
│   └── dw-ll_ucoco_384.pth
├── face-parse-bisent
│   ├── 79999_iter.pth
│   └── resnet18-5c106cde.pth
├── sd-vae
│   ├── config.json
│   └── diffusion_pytorch_model.bin
└── whisper
    ├── config.json
    ├── pytorch_model.bin
    └── preprocessor_config.json
权重文件清单与实测体积(2026-10-25 HTTP HEAD Content-Length 实测)
| 目录 / 文件 | 来源仓库 | 实测体积 | 备注 |
|---|---|---|---|
models/musetalk/pytorch_model.bin |
https://huggingface.co/TMElyralab/MuseTalk | 3,400,076,549 B ≈ 3.17 GiB | MuseTalk 1.0 权重;只用 1.5 时可不下载 |
models/musetalkV15/unet.pth |
https://huggingface.co/TMElyralab/MuseTalk | 3,400,074,924 B ≈ 3.17 GiB | MuseTalk 1.5 权重(README 推荐版本) |
models/sd-vae/diffusion_pytorch_model.bin |
https://huggingface.co/stabilityai/sd-vae-ft-mse | 334,707,217 B ≈ 319.2 MiB | 冻结 VAE |
models/whisper/pytorch_model.bin |
https://huggingface.co/openai/whisper-tiny | 151,095,027 B ≈ 144.1 MiB | 冻结音频编码器 |
models/dwpose/dw-ll_ucoco_384.pth |
https://huggingface.co/yzd-v/DWPose | 406,878,486 B ≈ 388.0 MiB | 人脸关键点检测 |
models/syncnet/latentsync_syncnet.pt |
https://huggingface.co/ByteDance/LatentSync | 1,488,019,828 B ≈ 1.39 GiB | 唇音同步判别网络 |
models/face-parse-bisent/resnet18-5c106cde.pth |
https://download.pytorch.org/models/resnet18-5c106cde.pth | 46,827,520 B ≈ 44.7 MiB | 人脸解析 backbone |
models/face-parse-bisent/79999_iter.pth |
Google Drive(README 手动清单) | 待验证(本次未能取得 Content-Length) | 人脸解析权重 |
| 合计(不含 79999_iter.pth) | — | 约 8.59 GiB | 另需预留输出帧与成片空间 |
国内加速:
download_weights.sh/download_weights.bat已把HF_ENDPOINT指向 https://hf-mirror.com(curl 200 核验);手动下载时也可在各 HF URL 前替换域名huggingface.co → hf-mirror.com。
关键配置文件修改(以官方 YAML 原文为准,web_fetch 核验)
普通推理配置 configs/inference/test.yaml(当前 main 分支原文):
task_0:
 video_path: "data/video/yongen.mp4"
 audio_path: "data/audio/yongen.wav"

task_1:
 video_path: "data/video/yongen.mp4"
 audio_path: "data/audio/eng.wav"
 bbox_shift: -7
| 字段 | 含义 | 官方说明 |
|---|---|---|
video_path |
输入视频、图片文件或图片目录(scripts/inference.py 支持三种类型) |
README:video_path 为输入视频/图片/图片目录路径 |
audio_path |
输入音频文件路径 | README:audio_path 为输入音频文件路径 |
bbox_shift |
人脸掩码上边界偏移量,仅 v1.0 生效;正值(向下)增大张嘴幅度,负值(向上)减小张嘴幅度 | README "Use of bbox_shift to have adjustable results (For 1.0)";scripts/inference.py 中 v15 分支强制 bbox_shift = 0 |
result_name |
可选,自定义输出视频文件名(scripts/inference.py 读取该字段;YAML 默认配置未使用) |
源码字段 |
实时推理配置 configs/inference/realtime.yaml(当前 main 分支原文):
avator_1:
 preparation: True # your can set it to False if you want to use the existing avator, it will save time
 bbox_shift: 5
 video_path: "data/video/yongen.mp4"
 audio_clips:
     audio_0: "data/audio/yongen.wav"
     audio_1: "data/audio/eng.wav"
| 字段 | 含义 | 官方说明(README "Important notes for real-time inference") |
|---|---|---|
preparation |
处理新数字人时设为 True;复用已准备好的形象设为 False 以节省时间 |
README 实时推理注意事项第 1、4 条 |
bbox_shift |
人脸偏移量(仅 v1.0 生效;scripts/realtime_inference.py 中 v15 分支同样固定为 0) |
源码 + README |
video_path |
数字人参考视频路径 | README 配置说明 |
audio_clips |
实时模式下逐段生成所用的音频片段字典 | README 注意事项第 2 条:准备完成后,形象将用 audio_clips 中的音频片段生成视频 |
README 补充:为获得最佳效果,输入视频建议 25fps(与训练时一致);帧率偏低的视频可先插帧,或用 ffmpeg 转成 25fps。
启动与推理命令
普通推理(Normal Inference,README Quickstart 原文)
Linux:
# MuseTalk 1.5(README 推荐)
sh inference.sh v1.5 normal
# MuseTalk 1.0
sh inference.sh v1.0 normal
Windows(README 原文命令,路径分隔符为反斜杠;--ffmpeg_path 指向实际 ffmpeg bin 目录):
REM MuseTalk 1.5(推荐)
python -m scripts.inference --inference_config configs\inference\test.yaml --result_dir results\test --unet_model_path models\musetalkV15\unet.pth --unet_config models\musetalkV15\musetalk.json --version v15 --ffmpeg_path ffmpeg-master-latest-win64-gpl-shared\bin

REM MuseTalk 1.0:相应改为 models\musetalk、pytorch_model.bin、--version v1
实时推理(Real-time Inference,README Quickstart 原文)
Linux:
# MuseTalk 1.5(推荐)
sh inference.sh v1.5 realtime
# MuseTalk 1.0
sh inference.sh v1.0 realtime
Windows(README 原文命令):
REM MuseTalk 1.5(推荐)
python -m scripts.realtime_inference --inference_config configs\inference\realtime.yaml --result_dir results\realtime --unet_model_path models\musetalkV15\unet.pth --unet_config models\musetalkV15\musetalk.json --version v15 --fps 25 --ffmpeg_path ffmpeg-master-latest-win64-gpl-shared\bin

REM MuseTalk 1.0:相应改为 models\musetalk、pytorch_model.bin、--version v1
inference.sh脚本事实(web_fetch 核验):normal→scripts.inference+configs/inference/test.yaml+results/test;realtime→scripts.realtime_inference+configs/inference/realtime.yaml+results/realtime,并附加--fps 25;v1.0对应--version v1与models/musetalk/pytorch_model.bin,v1.5对应--version v15与models/musetalkV15/unet.pth。
Gradio 网页 Demo(README "Gradio Demo" 原文命令;Windows / Linux 通用):
# 可去掉 --use_float16 换取更好画质,但会增加显存占用与推理时间(README 原文说明)
python app.py --use_float16 --ffmpeg_path ffmpeg-master-latest-win64-gpl-shared\bin
app.py 参数(源码 argparse 核验):--ip 默认 127.0.0.1,--port 默认 7860,--share(创建公开链接),--use_float16,--ffmpeg_path 默认 Windows 路径 ffmpeg-master-latest-win64-gpl-shared\bin。启动后浏览器访问 http://127.0.0.1:7860。
使用方法
方式一:Gradio 网页 Demo(README "Gradio Demo" 章节 + app.py 界面定义)
- 启动
python app.py --use_float16 --ffmpeg_path <ffmpeg bin 目录>。 - 左侧面板:Drving Audio(
app.py源码原始标签,即 Driving Audio)上传驱动音频;Reference Video 上传参考视频(app.py的check_video会自动把视频转成 25fps)。 - 参数区:
-
BBox_shift value, px(bbox_shift,默认 0,仅 v1.0 可调;Demo 固定使用 v15) -Extra Margin(滑块 0–40,默认 10,决定下颌区域可动范围) -Parsing Mode(jaw/raw,默认jaw) -Left Cheek Width/Right Cheek Width(滑块 20–160,默认 90;jaw模式下决定左右脸颊编辑范围) - 先点 "1. Test Inpainting" 仅生成第一帧用于微调口型参数,减少成片面部瑕疵(README 建议:为节省推理时间,可先生成第一帧调试最佳参数)。
- 参数满意后点 "2. Generate",右侧输出口型同步视频。
方式二:命令行普通推理(离线批量配音)
- 编辑
configs/inference/test.yaml,把video_path/audio_path换成自己的素材;可写多个task_*任务。 - 执行 07.4.5 节普通推理命令。
- 输出目录:
results/test/v15/<视频名>_<音频名>.mp4(scripts/inference.py命名规则:output_basename = f"{input_basename}_{audio_basename}",先帧序列 + 临时视频,再用 ffmpeg 合并输入音频)。
方式三:命令行实时推理
- 首次为新数字人准备素材:
configs/inference/realtime.yaml中preparation: True,填写video_path与audio_clips。 - 执行 07.4.5 节实时推理命令;首次会做人脸检测、坐标提取、VAE latent 等准备工作并缓存:v15 为
results/v15/avatars/<avatar_id>/,v1 为results/avatars/<avatar_id>/(scripts/realtime_inference.py源码路径规则)。 - 后续复用同一形象:将
preparation改为False,跳过准备阶段。 - 可选跳过图片保存以测速:
python -m scripts.realtime_inference --inference_config configs/inference/realtime.yaml --skip_save_images
(README "For faster generation without saving images" 原文命令)
普通推理参数说明表(来源:scripts/inference.py 源码 argparse,逐项核验默认值)
| 参数 | 默认值 | 说明 |
|---|---|---|
--ffmpeg_path |
./ffmpeg-4.4-amd64-static/ |
ffmpeg 可执行文件所在目录;找不到时脚本将其加入 PATH(Windows 分隔符 ;,其他系统 :) |
--gpu_id |
0 |
使用的 GPU 编号 |
--vae_type |
sd-vae |
VAE 类型 |
--unet_config |
./models/musetalk/config.json(源码默认值) |
UNet 配置 JSON 路径;1.5 启动命令中传 models/musetalkV15/musetalk.json |
--unet_model_path |
./models/musetalkV15/unet.pth(源码默认值) |
UNet 权重路径;1.0 传 models/musetalk/pytorch_model.bin |
--whisper_dir |
./models/whisper |
Whisper 模型目录 |
--inference_config |
configs/inference/test_img.yaml(源码默认值) |
推理 YAML 配置路径 |
--bbox_shift |
0 |
人脸框偏移像素;仅 v1 生效,v15 固定为 0 |
--result_dir |
./results |
结果输出根目录 |
--extra_margin |
10 |
人脸裁剪额外边距(v15 生效) |
--fps |
25 |
视频帧率(图片/图片目录输入时使用) |
--audio_padding_length_left |
2 |
音频左侧 padding 长度 |
--audio_padding_length_right |
2 |
音频右侧 padding 长度 |
--batch_size |
8 |
推理 batch 大小 |
--output_vid_name |
None |
自定义输出视频文件名;YAML 中 result_name 会覆盖 |
--use_saved_coord |
关 | 复用已保存的人脸坐标 .pkl 以节省时间 |
--saved_coord |
关 | 保存坐标供后续复用;未开启则处理结束后删除坐标缓存 |
--use_float16 |
关 | 启用 fp16(pe / vae.vae / unet.model 转半精度),降低显存与耗时 |
--parsing_mode |
jaw |
人脸融合解析模式(jaw / raw) |
--left_cheek_width |
90 |
左脸颊区域宽度(v15 解析参数) |
--right_cheek_width |
90 |
右脸颊区域宽度(v15 解析参数) |
--version |
v15 |
模型版本,可选 v1 / v15 |
实时推理参数补充(来源:scripts/realtime_inference.py 源码 argparse)
| 参数 | 默认值 | 说明 |
|---|---|---|
--batch_size |
20 |
实时推理 batch 大小(与普通推理的 8 不同) |
--skip_save_images |
关 | 跳过分帧图片保存,仅统计速度(README 07.5.3 命令) |
--extra_margin |
10 |
人脸裁剪额外边距 |
--parsing_mode |
jaw |
融合解析模式 |
--left_cheek_width / --right_cheek_width |
90 |
左右脸颊宽度 |
| 其他参数 | 同 07.5.4 | 实时脚本内模型固定转半精度(pe.half() 等),无 --use_float16 开关 |
端到端示例(输入 → 命令 → 输出,使用仓库自带示例素材)
- 输入素材(仓库内置,已核验可达):
- 视频:
data/video/yongen.mp4(https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/data/video/yongen.mp4,HTTP HEAD 实测 1,870,923 字节) - 音频:data/audio/yongen.wav(https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/data/audio/yongen.wav,实测 1,536,078 字节) - 配置:保持
configs/inference/test.yaml中task_0默认值不变(即上述两个文件)。 - 命令(Linux / WSL2):
conda activate MuseTalk
cd MuseTalk
sh inference.sh v1.5 normal
- 处理过程:ffmpeg 抽帧 → Whisper 提取音频特征 → 人脸关键点与 bbox 检测(坐标缓存为
.pkl)→ VAE 编码 latent → UNet 逐 batch 推理 → 解码贴回原画面 → ffmpeg 合成yongen_yongen.mp4并合并音频。 - 输出:
results/test/v15/yongen_yongen.mp4(scripts/inference.py输出命名规则)。 - Windows 等价命令:
python -m scripts.inference --inference_config configs\inference\test.yaml --result_dir results\test --unet_model_path models\musetalkV15\unet.pth --unet_config models\musetalkV15\musetalk.json --version v15 --ffmpeg_path <实际 ffmpeg bin 目录>
常见坑(现象 + 原因 + 解决,依据官方 README 与源码)
| # | 现象 | 原因 | 官方依据 / 解决方式 |
|---|---|---|---|
| 1 | 权重下载慢、连接 HF 超时 | 官方默认权重托管在 HuggingFace,境内直连不稳定 | 使用 sh ./download_weights.sh(Linux)或 download_weights.bat(Windows);两个脚本均内置 HF_ENDPOINT=https://hf-mirror.com 镜像;手动下载时把 HF 域名替换为 hf-mirror.com |
| 2 | 报错 "Unable to find ffmpeg" 或视频合成失败 | ffmpeg 不在 PATH,或 --ffmpeg_path 指向目录不正确 |
先执行 ffmpeg -version 确认;Linux sudo apt-get install ffmpeg;Windows 从 https://github.com/BtbN/FFmpeg-Builds/releases 下载 static 包,把 bin 加入 PATH,或在命令中传正确的 --ffmpeg_path(README Setup FFmpeg + Quickstart Prerequisites) |
| 3 | 显存不足(OOM) | 未开 fp16,或 batch 过大;官方最低实测为 4GB 显存机型(fp16) | 普通推理加 --use_float16;Gradio 启动加 --use_float16(README:去掉该选项画质更好,但显存占用与推理时间增加);必要时降低 --batch_size |
| 4 | 依赖版本冲突、导入报错 | requirements.txt 为钉版环境(numpy 1.23.5、transformers 4.39.2、diffusers 0.30.2 等),MMLab 也有固定版本 |
严格按 README 顺序安装:先 pip install -r requirements.txt,再用 mim 安装 mmcv==2.0.1 / mmdet==3.1.0 / mmpose==1.1.0;不要随意 pip install -U 升级这些包 |
| 5 | 成片口型节奏与原视频帧率不匹配 | 输入视频帧率不是 25fps(训练帧率) | README:输入视频建议 25fps;帧率偏低时先插帧,或用 ffmpeg 转成 25fps;Gradio 的 check_video 会自动把上传视频转 25fps(app.py 源码) |
| 6 | v1.5 下调整 bbox_shift 没有效果 |
scripts/inference.py / scripts/realtime_inference.py 中 version == "v15" 时强制 bbox_shift = 0;bbox_shift 是 v1.0 专属参数 |
仅在 --version v1 时使用 bbox_shift(README "For 1.0" 小节与 assets/BBOX_SHIFT.md);v15 通过 extra_margin、parsing_mode、左右脸颊宽度调整 |
| 7 | 实时推理第二次运行仍重复做人脸检测与坐标提取 | realtime.yaml 中 preparation 仍为 True |
新形象首次 True 完成准备;复用同一形象改为 False(README 实时推理注意事项第 1、4 条);若修改了 bbox_shift,脚本会提示需要重建 avatar |
| 8 | Windows 下实时推理达不到 30fps+ | 官方 30fps+ 实时基准为 NVIDIA Tesla V100;README 未承诺消费级 Windows 显卡实时帧率 | 以本机实测为准;降低 --batch_size、使用 fp16;Windows 下 app.py 已按源码设置 WindowsSelectorEventLoopPolicy 解决异步 IO 问题(app.py 源码) |
| 9 | 找不到 79999_iter.pth 或 resnet18 |
手动下载清单中人脸解析权重来自 Google Drive,容易漏下 | Linux 脚本用 gdown --id 154JgKpzCPW82qINcVieuPH3fZ2e0P812 下载;Windows bat 从 HF ManyOtherFunctions/face-parse-bisent 拉取两个文件;按 07.4.2 目录结构核对 |
| 10 | 输出视频面部抖动 / 身份细节丢失 | README "Limitations" 已声明:当前流水线逐帧生成存在抖动;胡须、唇形唇色等细节保留不充分 | 属模型已知局限;可结合 GFPGAN 等超分模型后处理(README Limitations 建议) |
本节来源清单
| # | URL | 用途 | 验证方式(2026-10-25) |
|---|---|---|---|
| 1 | https://github.com/TMElyralab/MuseTalk | 官方仓库主页 | curl HEAD 200 |
| 2 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/README.md | README 全文(定位、News、环境、权重、配置、命令、Gradio、Limitations、License) | web_fetch 完整读取(5638 字符,全文) |
| 3 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/LICENSE | MIT 代码许可 + 第三方组件许可清单核验 | web_fetch 完整读取(3335 字符) |
| 4 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/requirements.txt | 钉版 Python 依赖清单(18 个依赖条目) | web_fetch 完整读取(72 字符) |
| 5 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/configs/inference/test.yaml | 普通推理配置字段与示例路径 | web_fetch 完整读取(47 字符) |
| 6 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/configs/inference/realtime.yaml | 实时推理配置字段与示例路径 | web_fetch 完整读取(65 字符) |
| 7 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/scripts/inference.py | 普通推理参数表、v15 固定 bbox_shift、输出命名规则、ffmpeg PATH 处理 | web_fetch 完整读取(2739 字符) |
| 8 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/scripts/realtime_inference.py | 实时推理参数表、准备阶段逻辑、fp16 固定处理 | web_fetch(snippet 定向读取 argparse 与类实现段落) |
| 9 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/app.py | Gradio 参数(ip/port/share/fp16/ffmpeg_path)、界面控件、25fps 转码、Windows 事件循环策略 | web_fetch 完整读取(5366 字符) |
| 10 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/inference.sh | Linux 普通/实时推理参数拼装规则 | web_fetch 完整读取(485 字符) |
| 11 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/download_weights.sh | Linux 下载脚本、HF 镜像地址、下载文件清单 | web_fetch 完整读取(430 字符) |
| 12 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/download_weights.bat | Windows 下载脚本、HF 镜像地址、人脸解析替代来源 | web_fetch 完整读取(349 字符) |
| 13 | https://huggingface.co/TMElyralab/MuseTalk | 官方模型权重仓库(v1.0 / v1.5) | curl HEAD 200;HF API 列文件 musetalk/pytorch_model.bin、musetalkV15/unet.pth 等 |
| 14 | https://huggingface.co/spaces/TMElyralab/MuseTalk | 官方在线 Gradio Demo | curl HEAD 200 |
| 15 | https://arxiv.org/abs/2410.10122 | 官方技术报告 | curl HEAD 200 |
| 16 | https://arxiv.org/abs/2410.10122v2 | 技术报告 v2(README News 10/18/2024 引用) | curl HEAD 200 |
| 17 | https://huggingface.co/stabilityai/sd-vae-ft-mse/tree/main | sd-vae-ft-mse 权重来源 | curl HEAD 200;权重体积 HTTP HEAD 334,707,217 B |
| 18 | https://huggingface.co/openai/whisper-tiny/tree/main | whisper-tiny 权重来源 | curl HEAD 200;体积 HTTP HEAD 151,095,027 B |
| 19 | https://huggingface.co/yzd-v/DWPose/tree/main | DWPose 权重来源 | curl HEAD 200;体积 HTTP HEAD 406,878,486 B |
| 20 | https://huggingface.co/ByteDance/LatentSync/tree/main | SyncNet 权重来源 | curl HEAD 200;体积 HTTP HEAD 1,488,019,828 B |
| 21 | https://drive.google.com/file/d/154JgKpzCPW82qINcVieuPH3fZ2e0P812/view?pli=1 | face-parse-bisent 79999_iter.pth 官方手动下载链接 | 来自 README 手动清单;Google Drive 体积本次未能取得(待验证) |
| 22 | https://download.pytorch.org/models/resnet18-5c106cde.pth | resnet18 权重官方直链 | curl HEAD 200;体积 46,827,520 B |
| 23 | https://hf-mirror.com | 官方脚本内置 HF 国内镜像 | curl HEAD 200;镜像地址由 #11、#12 脚本源码核验 |
| 24 | https://github.com/BtbN/FFmpeg-Builds/releases | README 指定的 Windows/Linux ffmpeg static 构建下载页 | curl HEAD 200 |
| 25 | https://github.com/chaojie/ComfyUI-MuseTalk | README "Third party integration" 第三方 ComfyUI 集成(README 注明未由官方验证维护) | curl HEAD 200 |
| 26 | https://github.com/user-attachments/assets/02f4a214-1bdd-4326-983c-e70b478accba | 图 07-1 模型结构图原图(README ![Model Structure]) |
curl -L 跟随重定向下载 + file 校验 PNG 1934×646,410,486 字节 |
| 27 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/assets/figs/gradio_2.png | 图 07-2 Gradio 参数面板原图 | curl 下载 + file 校验 PNG 1781×1066,75,170 字节 |
| 28 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/data/video/yongen.mp4 | 端到端示例输入视频 | HTTP HEAD 206,1,870,923 字节 |
| 29 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/data/audio/yongen.wav | 端到端示例输入音频 | HTTP HEAD 206,1,536,078 字节 |
| 30 | https://raw.githubusercontent.com/TMElyralab/MuseTalk/main/data/audio/eng.wav | 配置 task_1 / realtime audio_1 示例音频 | HTTP HEAD 206,1,920,078 字节 |
| 31 | https://github.com/TMElyralab/MuseTalk/releases | GitHub Releases 页面 | curl 徽章查询确认:官方未发布 Release 包 |
| 32 | https://github.com/TMElyralab/MuseV | README 推荐的配套文本/图片/姿态生成视频方案(组合使用) | README "Combining MuseV and MuseTalk" 引用;未单独抓取页面 |
| 33 | https://download.pytorch.org/whl/cu118 | README 安装命令中 torch 2.0.1 cu118 wheel 索引 | curl HEAD 200 |