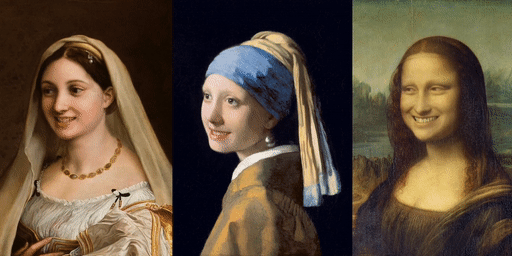


LivePortrait:照片与视频人像高效表情姿态驱动,缝合重定向控制与人像/猫狗动画本地部署指南|部署与使用全指南
项目仓库: https://github.com/KwaiVGI/LivePortrait(README 克隆地址 `https://github.com/KlingTeam/LivePortrait`,二者指向同一仓库)
开源协议:代码 MIT(Copyright © 2024 Kuaishou Visual Generation and
Interaction Center);InsightFace
模型仅限非商业研究用途,商用须移除并替换其检测模型 ·
开发语言:Python 3.10(PyTorch) · 论文:arXiv:2407.03168 ·
交付形态:人类模式 CLI、动物模式 CLI、Gradio WebUI(人类 /
动物两套界面)、Windows 一键安装包 · WebUI 默认端口
8890(绑定 127.0.0.1) · 官方主页:liveportrait.github.io
非官方声明:本文依据官方 README、
readme_zh_cn.md、requirements.txt、requirements_base.txt、inference.py、app.py、app_animals.py、src/config三个配置数据类与assets/docs调研文档整理部署步骤,属于第三方学习部署指南,不是快手 / KlingTeam 官方发布的运维文档。LivePortrait 是快手科技视觉生成与交互中心的开源研究项目;项目名称、论文与第三方模型名称归各自权利人所有。社区开发的 ComfyUI 节点、WebUI 扩展、TensorRT 加速版等属于独立第三方项目,不在本仓库官方发布范围内。
1 项目简介
LivePortrait 是快手科技(联合中国科学技术大学、复旦大学作者)开源的**高效人像动画(Portrait Animation)**项目,对应论文 LivePortrait: Efficient Portrait Animation with Stitching and Retargeting Control(arXiv:2407.03168)。核心能力是:给定一张源人像照片(或一段源人像视频)与一段驱动视频 / 动作模板,把驱动中的头部姿态、表情、眨眼、嘴部等运动迁移到源人像上,生成自然的动画视频;同时提供缝合(stitching)与重定向(retargeting)控制,在源图像空间与裁剪空间之间做稳定贴回,并支持对姿态、嘴部、眼睛等局部进行手动调节。
论文方法由外观特征提取器(F)、运动提取器(M)、扭曲模块(W)、SPADE
生成器(G)以及缝合 / 重定向 MLP 模块(S,含嘴部 R_lip、眼睛
R_eyes)组成;仓库 src/config/models.yaml
给出了各模块的结构参数。除人类模型外,仓库另维护一套动物模型(2025/01/01
更新到 v1.1),支持猫、狗等宠物的表情迁移。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | LivePortrait |
| 仓库地址 | github.com/KwaiVGI/LivePortrait(克隆 `https://github.com/KlingTeam/LivePortrait`) |
| 项目定位 | 高效人像 / 宠物照片与视频的表情、姿态驱动动画,含缝合与重定向控制 |
| 开源协议 | 代码 MIT;InsightFace 模型非商业研究专用(商用须替换,见第 11 章) |
| 论文 / 出处 | arXiv:2407.03168,liveportrait.github.io |
| 开发语言 / 框架 | Python 3.10、PyTorch(CUDA 11.1 / 11.8 / 12.1 可选)、Gradio 5.1.0、tyro 0.8.5 |
| 模型覆盖 | 人类模型(pretrained_weights/liveportrait);动物模型
v1.1(pretrained_weights/liveportrait_animals) |
| 部署方式 | Windows 一键安装包;Conda 源码环境 + inference.py /
inference_animals.py CLI;app.py /
app_animals.py Gradio 界面 |
| Gradio 端口 | server_port 默认
8890,server_name 默认
127.0.0.1,share 默认 False |
| 输出目录 | animations/(output_dir
默认值),拼接视频命名形如 s6--d0_concat.mp4 |
| 模型权重渠道 | HuggingFace KlingTeam/LivePortrait、hf-mirror
镜像、Google Drive、百度网盘(提取码 z5cn) |
| 系统入口 | 人类:python inference.py /
python app.py;动物:python inference_animals.py
/ python app_animals.py |
1.2 适用场景
- 单张照片驱动(i2v):用一段表情 / 动作视频驱动静态人像照片,生成带头部姿态与表情变化的动画短视频,用于数字人素材、虚拟形象、创意演示等研究与制作场景。
- 人像视频编辑(v2v):源输入本身是一段人像视频时,用另一驱动视频替换其运动,并可对动作做平滑处理。
- 图像驱动模式:以一张驱动图像提供表情 / 姿态参考,替代驱动视频(2024/08/19 更新)。
- 区域控制:仅对表情(
exp)、头部姿态(pose)、嘴部(lip)、眼睛(eyes)或全部区域(all)施加动画,其余部分保持不动。 - 姿态与表情重定向:在 Gradio 中用滑杆直接调节头部 pitch / yaw / roll、空间位移、微笑、眨眼、眉毛、视线方向与嘴型变化,得到静态或动态的重定向结果。
- 宠物表情迁移:动物模式把猫、狗等宠物的表情动作迁移到另一张宠物照片上。
- 动作模板复用与隐私保护:把驱动动作导出为
.pkl模板,后续推理直接复用模板、加快速度,同时避免重复传播含真人面部的驱动视频。
1.3 能力边界(官方口径)
- 动物模式测试范围:README 明确动物模式仅在 Linux 与 Windows 的 NVIDIA GPU 上经过测试;macOS(含 Apple Silicon)因 X-Pose 依赖不支持而无法使用动物模式,仅可运行人类模式。
- CPU 推理为 WIP:
flag_force_cpu标记为 "WIP"(开发中);官方推荐 NVIDIA GPU 运行,macOS Apple Silicon 可用 MPS 回退,但 README 注明速度可能比 RTX 4090 慢约 20 倍,Intel macOS 未测试。 - 眼睛 / 嘴部重定向标记
WIP:
flag_eye_retargeting、flag_lip_retargeting注释为 "not recommend to be True, WIP";属于实验性开关,稳定性以实际版本为准。 - 驱动视频要求:官方建议驱动视频裁剪为 1:1(如
512×512、256×256),聚焦头部、尽量减少肩部运动,首帧为中性表情的正面人脸;可用
--flag_crop_driving_video自动裁剪,效果不佳时手动调整比例与偏移或自行预处理。 - 缝合开关建议:头部运动较小时建议
flag_stitching=True;头部运动较大或源图为动物时建议关闭(动物 CLI 示例即带--no_flag_stitching)。 - 商用合规边界:InsightFace 检测模型仅限非商业研究;仓库 README 的 Ethics Considerations 提醒肖像动画存在深度伪造被滥用的社会风险,当前合成结果包含可见视觉伪影,可能有助于识别深度伪造;官方声明不对项目生成结果的使用承担法律责任。
- 官方 README 未逐模型公布硬性显存下限;硬件余量以实际加载日志为准,以官方仓库最新说明为准。
2 功能特性
2.1 人类模式:照片驱动与视频驱动
- 人像照片 →
动画视频(i2v):
inference.py接收源图片-s与驱动视频-d,输出动画视频;默认输出animations/s6--d0_concat.mp4,文件内拼接展示驱动视频、输入素材与生成结果。 - 人像视频编辑(v2v):源输入替换为视频(如
assets/examples/source/s13.mp4),在源视频基础上迁移驱动动作;driving_smooth_observation_variance控制动作平滑强度,数值越大越平滑,过度平滑会损失动作准确度。 - 图像驱动(i2i):Gradio 提供 "Driving Image" 标签页,以静态图像作为驱动参考;CLI 对应的图像驱动能力以当前仓库脚本实现为准。
2.2 缝合与贴回(Stitching & Paste-back)
- 缝合模块 S:由三个顺序执行的 MLP
网络组成,负责把动画后的面部运动稳定地缝合回源肖像;
flag_stitching控制是否启用。 - 贴回(paste-back):
flag_pasteback控制是否把裁剪空间内生成的面部结果贴回原图空间;Gradio 同时输出"原图空间结果"与"拼接结果"两路视频 / 图像。 - 源图裁剪:
flag_do_crop控制是否先把源人像裁剪到面部裁剪空间;flag_do_rot在裁剪时配合做旋转对齐。
2.3 姿态、表情与局部重定向
- 头部姿态:pitch(俯仰,
-15°–15°)、yaw(偏航,-25°–25°)、roll(翻滚,-15°–15°)三个滑杆做相对姿态调节。 - 空间位移与缩放:
mov_x(-0.19–0.19)、mov_y(-0.19–0.19)、mov_z(0.9–1.2)控制位移与远近缩放。 - 表情与面部细节:微笑(
smile,-0.3–1.3)、眨眼(wink,0–39)、眉毛(eyebrow,-30–30)、视线水平 / 垂直方向,以及三组嘴部变化滑杆(撅嘴、抿嘴、咧嘴、嘴闭合 / 张开)。 - 眼睛 /
嘴部比例重定向:
eye_retargeting_slider、lip_retargeting_slider把目标睁眼比 / 张嘴比施加到结果(CLI 对应flag_eye_retargeting、flag_lip_retargeting,实验性)。 - 嘴部归一化:
flag_normalize_lip在动画前先把嘴部归一化到闭合状态;仅在眼睛、嘴部重定向均关闭时生效。 - 源视频眼睛重定向:
flag_source_video_eye_retargeting在源为视频时让各帧睁眼比例对齐首帧,可能造成帧间抖动,同样有阈值参数控制。
2.4 驱动方式与动作强度
- 驱动选项:
driving_option取expression-friendly(表情友好,按全局倍数适配驱动动作,适合人类图片源)或pose-friendly(姿态友好)。 - 动作倍数:
driving_multiplier(0.0–2.0,默认1.0)仅在expression-friendly模式下生效,放大或缩小驱动动作幅度。 - 相对运动:
flag_relative_motion使用相对运动,避免绝对姿态偏移;默认开启。 - 音频优先级:
audio_priority取source或driving,决定拼接视频使用源视频还是驱动视频的音轨,默认driving。
2.5 动物模型(猫 / 狗)
- 2024/08/02 发布动物模型版本,2025/01/01
更新使用更多动物数据的新版模型(
base_models_v1.1)。 - 动物模式基于 X-Pose 关键点检测框架,需要先编译
MultiScaleDeformableAttention自定义算子;CLI 入口inference_animals.py,Gradio 入口app_animals.py。 - 动物源图默认关闭缝合(示例
--no_flag_stitching),并通过--driving_multiplier 1.75放大动作倍数。
2.6 动作模板与隐私保护
- 驱动视频可先转换为
.pkl动作模板;后续推理直接加载模板,无需再次读取含真人面部的驱动视频,兼顾推理速度与隐私保护。 - 示例:照片驱动
inference.py -s s9.jpg -d d5.pkl;视频编辑inference.py -s s13.mp4 -d d5.pkl。
2.7 推理加速与速度评估
--flag_do_torch_compile启用torch.compile加速:首次推理触发约一分钟优化过程,后续推理提升 20%–30%,具体收益随 CUDA 版本变化;该选项在 Windows 与 macOS 上不受支持。speed.py用于评估各模块在 NVIDIA GPU 上的单帧推理速度,结果记录在assets/docs/speed.md(RTX 4090、原生 PyTorch、torch.compile口径)。
2.8 界面与集成
- 官方 Gradio
界面分人类模式(
app.py)与动物模式(app_animals.py)两套,内置示例素材、裁剪选项、动画选项、重定向滑杆与一键清空按钮。 - 官方同时提供 HuggingFace Space 在线体验与 Windows 一键安装包;README "Community Resources" 收录了大量社区开发的 ComfyUI 节点、WebUI 扩展、实时应用与教程(均为第三方项目)。
3 官方界面预览
3.1 人类模式:真人表情驱动画像迁移
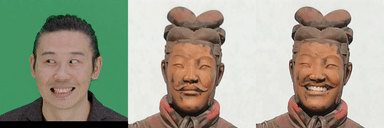
下图为 README 人类模式示例的静态帧:左侧为真人驱动参考,右侧为兵马俑形象在驱动表情下的前后对比(未驱动 / 驱动后),用于展示姿态与表情迁移效果。
本地 python app.py 启动后的 Gradio 界面(默认
http://127.0.0.1:8890)主要包含:源素材区("🖼️ Source
Image" / "🎞️ Source Video" 标签页)、驱动素材区("🎞️ Driving Video" /
"🖼️ Driving Image" / "📁 Driving Pickle"
标签页)、源裁剪选项、驱动视频裁剪选项、动画选项(归一化嘴部、相对运动、贴回、缝合、动画区域、驱动方式、动作倍数、动作平滑强度),以及"🚀
Animate"按钮;输出区同时给出原图空间动画视频与拼接动画视频。
3.2 动物模式:宠物表情迁移
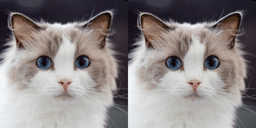
下图为 README 动物模式示例的静态帧:猫咪照片在表情迁移前后的左右对比。
动物模式 Gradio
界面(python app_animals.py)同样提供源图上传、驱动视频 /
模板上传与动画参数调节;该界面与模型仅在 Linux / Windows NVIDIA GPU
上经过测试。人类与动物模式的具体控件布局以本地启动版本为准,更多效果见官方主页
liveportrait.github.io。
4 官方跳转链接汇总
下表列出项目相关的官方入口,均可直接点击访问。
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库主页 | github.com/KwaiVGI/LivePortrait | 官方源码、CLI、Gradio 与配置文件 |
| 备用仓库别名 | github.com/KlingTeam/LivePortrait | README 克隆命令使用的别名地址,与上者同一仓库 |
| 项目主页 | liveportrait.github.io | 论文介绍与更多生成效果 |
| 论文 PDF | arxiv.org/abs/2407.03168 | LivePortrait 技术报告 |
| HuggingFace Space | huggingface.co/spaces/KlingTeam/LivePortrait | 官方在线体验 |
| 模型权重 | huggingface.co/KlingTeam/LivePortrait | pretrained_weights 全套权重 |
| hf-mirror 镜像 | hf-mirror.com/KlingTeam/LivePortrait | 国内镜像下载渠道 |
| Windows 安装包 | LivePortrait-Windows-v20240829.zip | 官方一键安装包(支持自动更新) |
| 模型 Google Drive | drive.google.com 权重目录 | 备用权重渠道 |
| 模型百度网盘 | pan.baidu.com/s/1MGctWmNla_vZxDbEp2Dtzw | 提取码 z5cn |
| Issues 反馈 | github.com/KwaiVGI/LivePortrait/issues | Bug 反馈与功能讨论 |
| 目录结构说明 | assets/docs/directory-structure.md | pretrained_weights 应有的层级与文件名 |
| 速度评测 | assets/docs/speed.md | RTX 4090 各模块单帧耗时 |
| FFmpeg 安装说明 | assets/docs/how-to-install-ffmpeg.md | Conda / Ubuntu / Windows / macOS 安装方式 |
| 更新日志目录 | assets/docs/changelog | 各版本功能与安全更新说明 |
| X-Pose 依赖 | github.com/IDEA-Research/X-Pose | 动物模式使用的通用关键点检测框架 |
| 联系方式 | guojianzhu.com | 项目负责人郭建珠个人主页 |
README "Community Resources" 表中的 AVTR-1、ditto-talkinghead、FasterLivePortrait、AdvancedLivePortrait-WebUI、FacePoke、FaceFusion、sd-webui-live-portrait、ComfyUI-LivePortraitKJ、ComfyUI-AdvancedLivePortrait、comfyui-liveportrait 等均为社区独立项目,由各自作者维护,与官方仓库不属于同一发布主体。
5 前置要求与服务器配置
5.1 软件前提
- Git:用于克隆仓库与子目录内依赖源码。
- Conda:官方推荐用 Conda
创建独立环境,
python=3.10(参见 Anaconda / Miniconda)。 - FFmpeg:必须同时具备
ffmpeg与ffprobe;inference.py与app.py启动前会执行ffmpeg -version检查,缺失直接抛ImportError。安装方式(来自assets/docs/how-to-install-ffmpeg.md):- Conda 用户:
conda install ffmpeg; - Ubuntu /
Debian:
sudo apt install ffmpeg、sudo apt install libsox-dev,必要时conda install -c conda-forge 'ffmpeg<7'; - Windows:按文档说明放置
ffmpeg.exe与ffprobe.exe并加入PATH; - macOS:
brew install ffmpeg。
- Conda 用户:
- NVIDIA 驱动与 CUDA(Linux / Windows
人类与动物模式):先
nvcc -V查看 CUDA 版本,再选择匹配的 PyTorch 轮子。 - Python
依赖:
pip install -r requirements.txt;requirements.txt引用requirements_base.txt,并追加onnxruntime-gpu==1.18.0、transformers==4.38.0。
5.2 PyTorch 与 CUDA 版本对照(README 示例)
| CUDA 版本 | 安装命令 |
|---|---|
| CUDA 11.1 | pip install torch==1.10.1+cu111 torchvision==0.11.2 torchaudio==0.10.1 -f https://download.pytorch.org/whl/cu111/torch_stable.html |
| CUDA 11.8 | pip install torch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0 --index-url https://download.pytorch.org/whl/cu118 |
| CUDA 12.1 | pip install torch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0 --index-url https://download.pytorch.org/whl/cu121 |
其他 CUDA 版本请查阅 PyTorch 官方历史版本页面。README 提醒:Windows 上部分较高 CUDA 版本(如 12.4、12.6)可能出现未知问题,可考虑降到较稳定的 11.8,降级方法参考社区维护的 X-Pose 安装文档。
5.3 macOS Apple Silicon 特殊说明
- X-Pose 依赖不支持 macOS,动物模式不可用;人类模式照常运行。
- 使用
requirements_macOS.txt安装:该文件引用requirements_base.txt,CPU 索引安装torch==2.3.0、torchvision==0.18.0、torchaudio==2.3.0,并使用onnxruntime-silicon==1.16.3。 - 启动命令前加
PYTORCH_ENABLE_MPS_FALLBACK=1;README 注明 Intel macOS 未测试,Apple Silicon 速度可能比 RTX 4090 慢约 20 倍。
5.4 硬件与系统建议
| 项目 | 说明 |
|---|---|
| 操作系统 | Linux、Windows(人类 / 动物模式 NVIDIA GPU 测试环境);macOS Apple Silicon(仅人类模式);Intel macOS 未测试 |
| GPU | 动物模式仅支持 Linux / Windows NVIDIA GPU;人类模式推荐 NVIDIA
GPU;flag_force_cpu 为 WIP,不建议作为生产路径 |
| 显存 / 内存 | README 未公布硬性显存下限;assets/docs/speed.md
给出的单帧耗时基于 RTX
4090;实际占用以加载日志为准,以官方仓库最新说明为准 |
| 磁盘 | 需容纳人类模型、动物模型、InsightFace 模型、X-Pose 权重与示例素材;模型大小以 HF 仓库实际下载为准 |
| 网络 | 下载权重可走 HuggingFace 或 hf-mirror 镜像;Windows 安装包与备用渠道见第 4 章 |
5.5 端口分配
| 端口 | 服务 | 默认绑定 | 用途 |
|---|---|---|---|
8890 |
Gradio 人类界面 app.py |
server_name=127.0.0.1、server_port=8890 |
浏览器访问本地 Demo;--server_port /
--server_name / --share 可改 |
8890 |
Gradio 动物界面 app_animals.py |
同上默认值 | 动物模式 Demo;与人类界面不同时启动即可复用端口 |
远程服务器运行 Gradio 时,建议通过 SSH 隧道或带认证的反向代理访问;
--share会生成 Gradio 公网临时链接,不要在未加鉴权的情况下把界面长期暴露到不可信公网。
6 方式一:官方 Windows 一键安装包(桌面端推荐路径)
容器化现状(如实说明):仓库未随附官方 Dockerfile 与
docker-compose.yml,本章不编造 Compose 文件。官方面向桌面用户提供的一键路径是 Windows 安装包;Linux / macOS 服务化与源码路径见第 7 章。README 收录的社区 Docker / TensorRT 方案属于第三方项目,不作为官方部署方式。
6.1 下载安装包
- 打开官方 Windows 安装包地址:LivePortrait-Windows-v20240829.zip(历史版本与更新说明见 HuggingFace 仓库目录)。
- 下载并解压
LivePortrait-Windows-v20240829.zip;早期 2024/07/25 版本同样从 HuggingFace 或百度云下载,解压后双击run_windows.bat启动;2024/08/05 起的安装包同时支持人类模式与动物模式,2024/08/29 版本支持自动更新。 - 首次启动按界面引导确认运行环境与模型就绪;安装包内置的 FFmpeg、Python 运行时与模型权重以打包版本为准。
6.2 使用本地界面
- 人类模式:在启动的本地界面中上传源照片 / 视频与驱动视频 / 图像 /
.pkl模板,调整裁剪与动画选项后生成动画视频。 - 动物模式:在安装包支持动物模型的版本中切换到动物界面,上传宠物照片与驱动素材生成表情迁移视频;动物模式依赖 NVIDIA GPU 与已编译的 X-Pose 算子,具体以安装包版本为准。
- 界面选项与第 8 章参数一一对应;安装包的默认端口、素材目录与版本号以其内置说明为准,与源码仓库可能存在版本差异。
6.3 在线体验(不部署本地环境)
不想搭建本地环境时,可直接使用官方 HuggingFace Space:huggingface.co/spaces/KlingTeam/LivePortrait;在线环境的队列时长、算力与素材限制由 HF 平台与 Space 维护者决定,不等同于本地部署能力。
7 方式二:源码 / Conda 环境手动安装与 CLI 推理
7.1 克隆仓库并创建环境
git clone https://github.com/KlingTeam/LivePortrait
cd LivePortrait

conda create -n LivePortrait python=3.10
conda activate LivePortrait
7.2 安装 PyTorch 与项目依赖(Linux / Windows)
先按第 5.2 节对照表安装与本机 CUDA 匹配的 PyTorch,再安装其余依赖:
# 以 CUDA 11.8 为例(11.1 / 12.1 命令见 5.2 节)
pip install torch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0 \
  --index-url https://download.pytorch.org/whl/cu118

pip install -r requirements.txt
requirements_base.txt
锁定的主要依赖:numpy==1.26.4、pyyaml==6.0.1、opencv-python==4.10.0.84、scipy==1.13.1、imageio==2.34.2、lmdb==1.4.1、tqdm==4.66.4、rich==13.7.1、ffmpeg-python==0.2.0、onnx==1.16.1、scikit-image==0.24.0、albumentations==1.4.10、matplotlib==3.9.0、imageio-ffmpeg==0.5.1、tyro==0.8.5、gradio==5.1.0、pykalman==0.9.7、pillow>=10.2.0;requirements.txt
追加
onnxruntime-gpu==1.18.0、transformers==4.38.0。
macOS Apple Silicon 改用:
pip install -r requirements_macOS.txt7.3 下载预训练权重
# 安装 HF CLI(如尚未安装)
# pip install -U "huggingface_hub[cli]"

# HuggingFace 直连
huggingface-cli download KlingTeam/LivePortrait \
  --local-dir pretrained_weights \
  --exclude "*.git*" "README.md" "docs"

# 国内网络使用 hf-mirror 镜像
export HF_ENDPOINT=https://hf-mirror.com
huggingface-cli download KlingTeam/LivePortrait \
  --local-dir pretrained_weights \
  --exclude "*.git*" "README.md" "docs"
无法访问 HuggingFace 时,可从第 4 章 Google Drive
目录或百度网盘(提取码 z5cn)下载全部权重,解压后放入
./pretrained_weights。目录层级须与
assets/docs/directory-structure.md 一致:
pretrained_weights
├── insightface
│   └── models
│       └── buffalo_l
│           ├── 2d106det.onnx
│           └── det_10g.onnx
├── liveportrait
│   ├── base_models
│   │   ├── appearance_feature_extractor.pth
│   │   ├── motion_extractor.pth
│   │   ├── spade_generator.pth
│   │   └── warping_module.pth
│   ├── landmark.onnx
│   └── retargeting_models
│       └── stitching_retargeting_module.pth
└── liveportrait_animals
    ├── base_models
    │   └── (v1.1 目录下 F / M / G / W 四个 .pth)
    ├── retargeting_models
    │   └── stitching_retargeting_module.pth
    └── xpose.pth
7.4 人类模式 CLI 推理
# Linux / Windows:使用内置示例跑通流程
python inference.py

# macOS Apple Silicon(Intel 未测试,速度较慢)
PYTORCH_ENABLE_MPS_FALLBACK=1 python inference.py
成功运行后输出
animations/s6--d0_concat.mp4,文件包含驱动视频、输入素材与生成结果三段拼接。
指定自定义源素材与驱动素材:
# 源输入为图片
python inference.py -s assets/examples/source/s9.jpg -d assets/examples/driving/d0.mp4

# 源输入为视频(人像视频编辑 v2v)
python inference.py -s assets/examples/source/s13.mp4 -d assets/examples/driving/d0.mp4

# 查看全部命令行选项
python inference.py -h
驱动视频自动裁剪
python inference.py -s assets/examples/source/s9.jpg \
  -d assets/examples/driving/d13.mp4 \
  --flag_crop_driving_video
自动裁剪效果不理想时,调整 --scale_crop_driving_video 与
--vy_ratio_crop_driving_video
控制裁剪比例与纵向偏移,或手动把驱动视频预处理为 1:1
正面中性表情素材。
使用动作模板(.pkl)加速并保护隐私
# 照片动画
python inference.py -s assets/examples/source/s9.jpg -d assets/examples/driving/d5.pkl

# 人像视频编辑
python inference.py -s assets/examples/source/s13.mp4 -d assets/examples/driving/d5.pkl
7.5 动物模式 CLI 推理(Linux / Windows NVIDIA GPU)
先编译 X-Pose 使用的 MultiScaleDeformableAttention
自定义算子:
cd src/utils/dependencies/XPose/models/UniPose/ops
python setup.py build install
cd -   # 等价于回到仓库根目录 ../../../../../../../
再执行动物模式推理:
python inference_animals.py \
  -s assets/examples/source/s39.jpg \
  -d assets/examples/driving/wink.pkl \
  --driving_multiplier 1.75 \
  --no_flag_stitching
成功后输出 animations/s39--wink_concat.mp4。
7.6 启动 Gradio 界面
# 人类模式(Linux / Windows / macOS Apple Silicon)
python app.py

# macOS Apple Silicon
PYTORCH_ENABLE_MPS_FALLBACK=1 python app.py

# 动物模式(仅 Linux NVIDIA GPU 测试环境)
python app_animals.py
常用界面参数:
# 指定端口、主机名与公网分享链接
python app.py --server_port 8890 --server_name 127.0.0.1 --share

# 启用 torch.compile 加速(Windows / macOS 不支持;首次推理约一分钟优化)
python app.py --flag_do_torch_compile
浏览器打开 http://127.0.0.1:8890,按第 3.1
节说明上传素材、调整选项后点击 "🚀 Animate" 生成。
7.7 模块速度评测
# 仅 NVIDIA GPU
python speed.py
各模块在 RTX 4090、原生 PyTorch + torch.compile
下的单帧耗时记录于 assets/docs/speed.md:外观特征提取器
0.82ms、运动提取器 0.84ms、SPADE 生成器 7.59ms、扭曲模块
5.21ms、缝合与重定向模块合计
0.31ms(数值为官方评测口径,随硬件与版本变化)。
8 配置项说明
8.1
ArgumentConfig
用户输入参数(src/config/argument_config.py)
输入参数
| 参数 | 别名 | 默认值 | 说明 |
|---|---|---|---|
source |
-s |
assets/examples/source/s0.jpg |
源人像 / 动物照片,或人类源视频路径 |
driving |
-d |
assets/examples/driving/d0.mp4 |
驱动视频或 .pkl 动作模板路径 |
output_dir |
-o |
animations/ |
输出视频保存目录 |
推理开关与模型选项
| 参数 | 默认值 | 说明 |
|---|---|---|
flag_use_half_precision |
True |
FP16 半精度;出现黑块可能是 GPU 兼容性问题,置 False
重试 |
flag_crop_driving_video |
False |
是否裁剪驱动视频(驱动为视频时生效) |
device_id |
0 |
GPU 设备编号 |
flag_force_cpu |
False |
强制 CPU 推理(WIP,不建议生产使用) |
flag_normalize_lip |
False |
动画前把嘴部归一化到闭合;仅眼睛、嘴部重定向关闭时生效 |
flag_source_video_eye_retargeting |
False |
源为视频时把各帧睁眼比例对齐首帧;可能帧间抖动 |
flag_eye_retargeting |
False |
把驱动帧睁眼比迁移到源上(WIP,不建议开启) |
flag_lip_retargeting |
False |
把驱动帧张嘴比迁移到源上(WIP,不建议开启) |
flag_stitching |
True |
缝合;头部运动小建议开启,运动大或动物源建议关闭 |
flag_relative_motion |
True |
使用相对运动 |
flag_pasteback |
True |
把裁剪空间结果贴回原图空间 |
flag_do_crop |
True |
是否把源人像 / 视频裁剪到面部裁剪空间 |
driving_option |
expression-friendly |
expression-friendly(表情友好,图片源适用)或
pose-friendly(姿态友好) |
driving_multiplier |
1.0 |
动作倍数,仅 expression-friendly 模式生效 |
driving_smooth_observation_variance |
3e-7 |
源为视频时的动作平滑强度;越大越平滑,过度平滑损失动作准确度 |
audio_priority |
driving |
拼接视频音轨取 source 或 driving |
animation_region |
all |
动画区域:exp、pose、lip、eyes、all |
源图 / 视频裁剪参数
| 参数 | 默认值 | 说明 |
|---|---|---|
det_thresh |
0.15 |
人脸检测阈值;降低可提高召回 |
scale |
2.3 |
裁剪比例,数值越大面部在裁剪区占比越小 |
vx_ratio |
0 |
裁剪空间内向左右移动面部的比例 |
vy_ratio |
-0.125 |
裁剪空间内向上下移动面部的比例(+ 上、-
下) |
flag_do_rot |
True |
裁剪时是否进行旋转对齐 |
source_max_dim |
1280 |
源图 / 视频高宽上限,可调大到 1920 |
source_division |
2 |
源图 / 视频高宽须能被该数整除 |
驱动视频裁剪参数
| 参数 | 默认值 | 说明 |
|---|---|---|
scale_crop_driving_video |
2.2 |
驱动视频裁剪比例 |
vx_ratio_crop_driving_video |
0.0 |
驱动裁剪横向偏移 |
vy_ratio_crop_driving_video |
-0.1 |
驱动裁剪纵向偏移 |
Gradio 参数
| 参数 | 别名 | 默认值 | 说明 |
|---|---|---|---|
server_port |
-p |
8890 |
Gradio 服务端口 |
share |
— | False |
是否生成公网临时分享链接 |
server_name |
— | 127.0.0.1 |
监听主机;改 0.0.0.0 广播局域网 |
flag_do_torch_compile |
— | False |
启用 torch.compile 加速;Windows / macOS 不支持 |
gradio_temp_dir |
— | None |
Gradio 临时文件目录;非空时写入 GRADIO_TEMP_DIR |
8.2
InferenceConfig
关键字段(src/config/inference_config.py)
| 字段 | 默认值 / 路径 | 说明 |
|---|---|---|
models_config |
src/config/models.yaml |
模型结构配置 |
checkpoint_F |
pretrained_weights/liveportrait/base_models/appearance_feature_extractor.pth |
外观特征提取器 F |
checkpoint_M |
pretrained_weights/liveportrait/base_models/motion_extractor.pth |
运动提取器 M |
checkpoint_G |
pretrained_weights/liveportrait/base_models/spade_generator.pth |
SPADE 生成器 G |
checkpoint_W |
pretrained_weights/liveportrait/base_models/warping_module.pth |
扭曲模块 W |
checkpoint_S |
pretrained_weights/liveportrait/retargeting_models/stitching_retargeting_module.pth |
缝合 / 重定向模块 S、R_eyes、R_lip |
version_animals |
_v1.1 |
动物模型目录版本后缀 |
checkpoint_*_animal |
liveportrait_animals/base_models_v1.1/... |
动物模式 F / M / G / W 权重 |
input_shape |
(256, 256) |
面部裁剪输入尺寸 |
output_format |
mp4 |
输出格式(mp4 / gif) |
crf |
15 |
输出视频 CRF 质量参数 |
output_fps |
25 |
默认输出帧率 |
lip_normalize_threshold |
0.03 |
嘴部归一化阈值 |
source_video_eye_retargeting_threshold |
0.18 |
源视频眼睛重定向阈值 |
size_gif |
256 |
GIF 尺寸(预留) |
8.3
CropConfig
关键字段(src/config/crop_config.py)
| 字段 | 默认值 | 说明 |
|---|---|---|
insightface_root |
pretrained_weights/insightface |
InsightFace 模型根目录 |
landmark_ckpt_path |
pretrained_weights/liveportrait/landmark.onnx |
人脸关键点 ONNX 模型 |
xpose_config_file_path |
src/utils/dependencies/XPose/config_model/UniPose_SwinT.py |
X-Pose 模型配置 |
xpose_embedding_cache_path |
src/utils/resources/clip_embedding |
CLIP 嵌入缓存目录 |
xpose_ckpt_path |
pretrained_weights/liveportrait_animals/xpose.pth |
动物模式 X-Pose 权重 |
dsize |
512 |
裁剪尺寸 |
scale / vx_ratio /
vy_ratio |
2.3 / 0 / -0.125 |
源裁剪比例与偏移 |
max_face_num |
0 |
最大人脸数;0 表示不限制 |
flag_do_rot |
True |
裁剪旋转对齐 |
animal_face_type |
animal_face_9 |
动物关键点类型:animal_face_9 或
animal_face_68 |
direction |
large-small |
裁剪方向 |
8.4 Gradio 重定向滑杆取值范围
| 分组 | 滑杆 | 范围 / 默认 |
|---|---|---|
| 头部姿态 | pitch / yaw / roll | -15°–15° /
-25°–25° /
-15°–15°,默认 0 |
| 空间位移 | mov_x / mov_y / mov_z | -0.19–0.19 /
-0.19–0.19 /
0.9–1.2,默认 0 / 0
/ 1.0 |
| 嘴部变化 | 撅嘴 / 抿嘴 / 咧嘴 / 嘴开合 | -0.09–0.09 /
-20.0–15.0 /
0.0–15.0 /
-90.0–120.0 |
| 表情 | smile / wink / eyebrow | -0.3–1.3 / 0–39
/ -30–30 |
| 视线 | 水平 / 垂直 | -30.0–30.0 /
-63.0–63.0 |
| 裁剪比例 | 图片 / 视频 retargeting scale | 1.8–3.2,默认 2.5 /
2.3 |
8.5
模型结构模块(models.yaml 注释口径)
| 模块 | 代号 | 主要参数 |
|---|---|---|
| Appearance Feature Extractor | F | block_expansion=64、num_down_blocks=2、max_features=512、num_resblocks=6 |
| Motion Extractor | M | num_kp=21、backbone=convnextv2_tiny |
| Warping Module | W | num_kp=21、estimate_occlusion_map=True,含
Dense Motion 子参数 |
| SPADE Generator | G | upscale=2(256×256 →
512×512)、max_features=512 |
| Stitching / Retargeting | S | 缝合、嘴部 R_lip、眼睛 R_eyes 三个顺序 MLP 网络 |
9 常用运维命令
# ---- Conda 环境 ----
conda activate LivePortrait
conda deactivate

# ---- 依赖重装(修改 requirements 后)----
pip install -r requirements.txt
pip install -r requirements_macOS.txt   # macOS Apple Silicon

# ---- 权重核对 ----
ls pretrained_weights/liveportrait/base_models/
ls pretrained_weights/liveportrait_animals/
ls pretrained_weights/insightface/models/buffalo_l/

# ---- 人类模式 CLI ----
python inference.py
python inference.py -s assets/examples/source/s9.jpg -d assets/examples/driving/d0.mp4
python inference.py -h

# ---- 动物模式 CLI(先编译算子)----
cd src/utils/dependencies/XPose/models/UniPose/ops && python setup.py build install && cd -
python inference_animals.py -s assets/examples/source/s39.jpg \
  -d assets/examples/driving/wink.pkl --driving_multiplier 1.75 --no_flag_stitching

# ---- Gradio 界面 ----
python app.py
python app.py --server_port 8890 --server_name 0.0.0.0 --share
python app.py --flag_do_torch_compile
python app_animals.py

# ---- 速度评测(NVIDIA GPU)----
python speed.py

# ---- 产物查看 ----
ls animations/更新代码:git pull 后按 Releases / changelog 说明核对
pretrained_weights 是否需要同步升级;备份时保留
pretrained_weights/、自己的源素材、驱动模板与
animations/
产物;下载的模型权重、示例素材与生成视频不要提交到公开仓库。animations/
目录内为用户产物,清理前先确认无保留价值。
10 常见故障排查
10.1
FFmpeg is not installed(启动即抛 ImportError)
现象:python inference.py 或
python app.py 启动时报 "FFmpeg is not installed. Please
install FFmpeg (including ffmpeg and ffprobe)..."。
处理:确认 ffmpeg 与
ffprobe 都在 PATH 中并可执行
ffmpeg -version;按系统对照 5.1 节安装。仓库根目录若存在
ffmpeg/ 文件夹,脚本会自动把它加入
PATH(inference.py / app.py
均有该逻辑)。
10.2 动物模式算子编译失败
现象:MultiScaleDeformableAttention
编译报错,或运行 inference_animals.py
时提示算子未安装。
处理:
cd src/utils/dependencies/XPose/models/UniPose/ops
python setup.py build install
cd -- 确认 PyTorch、CUDA、编译器(gcc / MSVC)与本机环境匹配;
- 动物模式仅在 Linux / Windows NVIDIA GPU 测试,macOS 不支持;
- 算子编译失败时不要用人类模型参数替代动物模式入口。
10.3 权重缺失或目录结构错误
现象:加载时报 FileNotFoundError 指向
.pth / .onnx
权重,或推理结果异常、人脸检测不到。
处理:对照
assets/docs/directory-structure.md 核对
pretrained_weights 层级与文件名;从 HF / hf-mirror / Google
Drive /
百度网盘重新下载对应缺失文件,不要用半截缓存继续加载。insightface/models/buffalo_l/
下 2d106det.onnx 与 det_10g.onnx
缺失会导致人脸检测失败。
10.4 出现黑块或半精度异常
现象:生成视频局部黑块、颜色异常。
处理:flag_use_half_precision 默认
True,注释说明黑块可能源于 GPU
兼容性问题;关闭半精度重试:
python inference.py --flag_use_half_precision False10.5 Windows 高版本 CUDA 不稳定
现象:Windows 上 CUDA 12.4、12.6 出现未知报错或崩溃。
处理:README 建议考虑降到测试较稳定的 CUDA
11.8,并按 PyTorch 对照表重装 torch==2.3.0
系列轮子;降级步骤参考社区 X-Pose 安装文档。
10.6 torch.compile
加速不可用
现象:在 Windows 或 macOS 上使用
--flag_do_torch_compile 报错或无效果。
处理:README 明确该加速选项在 Windows 与 macOS 上不受支持;仅在 Linux NVIDIA 环境开启。首次推理有约一分钟优化过程,属预期行为,后续推理才体现 20%–30% 提速。
10.7 驱动视频裁剪效果不佳
现象:自动裁剪后人脸偏移、肩部入镜或动作裁切过度。
处理:
- 先手动把驱动视频预处理为 1:1(512×512 或 256×256)、聚焦头部、首帧中性表情正面人脸;
- 或调整
--scale_crop_driving_video(默认2.2)与--vy_ratio_crop_driving_video(默认-0.1)改善裁剪范围与纵向偏移; - 减少肩部动作幅度,避免大动作导致面部出框。
10.8 头部动作变形 / 缝合撕裂
现象:头部运动较大时面部边缘撕裂、拼接不自然。
处理:头部运动较小保持
flag_stitching=True;动作幅度大或源图为动物时关闭缝合(动物示例即
--no_flag_stitching);必要时降低
driving_multiplier,并核对
scale、vx_ratio、vy_ratio
裁剪参数是否把面部完整纳入。
10.9 源视频帧间抖动
现象:v2v 模式下画面帧间闪烁、眼睛忽大忽小。
处理:调大
driving_smooth_observation_variance
提升平滑度;注意数值过大会损失动作准确度。flag_source_video_eye_retargeting
仅在需要对齐睁眼比时开启,该选项本身可能引入抖动。
10.10 端口被占用
现象:Gradio 启动报端口已被占用。
处理:
ss -lntp | grep 8890
python app.py --server_port 8891
动物界面与人类界面不同时启动即可复用同一端口;局域网访问时
--server_name 0.0.0.0 并配合反向代理或 SSH 隧道。
10.11 HuggingFace 下载失败或超时
现象:huggingface-cli download
连接失败、中断或权重半截。
处理:切换 hf-mirror 镜像:
export HF_ENDPOINT=https://hf-mirror.com
huggingface-cli download KlingTeam/LivePortrait --local-dir pretrained_weights --exclude "*.git*" "README.md" "docs"
镜像仍不可用时使用 Google Drive 或百度网盘(提取码
z5cn)备用渠道;删除损坏的局部目录后重新下载。
10.12 动物模式在 macOS 上无法运行
现象:python app_animals.py 或
inference_animals.py 在 macOS 上报依赖 / 算子错误。
处理:这是官方已知边界——X-Pose 不支持
macOS,动物模式不可用;macOS 用户只能运行人类模式
app.py,如需动物模式请使用 Linux / Windows NVIDIA
机器。
11 风险与合规说明
以下条款整理自官方 README、
research_LICENSE与官方 Ethics Considerations;如与官方原文不一致,以仓库LICENSE、README 与各模型模型卡为准。
11.1 代码与模型许可证范围
- 代码 MIT:LivePortrait 开源代码按 MIT License 发布(Copyright © 2024 Kuaishou Visual Generation and Interaction Center),允许自由使用、修改与再分发,分发时保留版权声明与许可证副本。
- InsightFace 模型非商业专用:
LICENSE末尾明确说明 InsightFace 代码按 MIT 发布,但其模型仅限非商业研究目的;若要将 LivePortrait 用于商业场景,应先移除并替换 InsightFace 的检测模型,以完全符合 MIT 许可要求。 - 动物模型与 X-Pose:动物模式依赖 X-Pose 与
xpose.pth权重,集成分发时需同时核对 X-Pose 及其模型条款;landmark.onnx、各.pth权重的适用范围以对应模型卡与仓库说明为准。 - 实现借鉴了 FOMM(First Order Model)、Open Facevid2vid、SPADE、InsightFace、X-Pose 等开源研究成果(README Acknowledgements),二次分发时需保留对应第三方组件的许可声明。
11.2 肖像权与深度伪造合规(官方 Ethics Considerations)
- README 伦理提示明确:肖像动画技术伴随社会风险,尤其可能被滥用于制作深度伪造(deepfakes);遵循伦理准则与负责任使用实践至关重要。
- 只能使用本人肖像,或已取得肖像权人明确书面授权的照片 / 视频;不得未经授权驱动公众人物、陌生人或他人的人脸制作可被误认的仿真内容。
- 禁止把生成结果用于冒充真人身份、电信诈骗、虚假新闻、恶意诋毁、色情 / 暴力内容传播或其他违反法律法规与公序良俗的用途。
- 对外发布 AI 生成的人物视频时,应按当地法规标注 AI 合成属性;官方说明当前合成结果中仍存在可见视觉伪影,这些伪影可能有助于识别深度伪造。
11.3 官方责任边界
- README 明确:官方不对本项目生成结果的使用承担任何法律责任;使用者自行承担内容合规、肖像授权、服务中断与业务损失风险。
- 项目按现状(AS-IS)提供,不保证在所有素材、硬件与系统组合下达到演示效果;眼睛 / 嘴部重定向、CPU 模式等标记 WIP 的能力不承诺生产稳定性。
11.4 数据隐私与素材管理
- 本地推理默认不上传用户素材;若把
app.py/app_animals.py部署为对外服务并保存日志、上传用户照片视频,部署方须自行依法发布隐私政策、取得用户同意并落实数据安全措施。 - 参考照片、驱动视频、
.pkl动作模板与生成视频属于敏感素材,应限制目录访问权限,不要提交到公开仓库或不可信服务器;使用.pkl模板替代真人驱动视频有助于降低素材外泄风险。 - Gradio
--share公网链接为临时地址,含人脸素材的任务不要在未鉴权的公网链接中长期运行。
11.5 社区组件与第三方服务
- README "Community Resources" 收录的 ComfyUI 节点、WebUI 扩展、TensorRT 实时版、FacePoke、FaceFusion 等均为独立第三方项目,由各自作者维护,其许可、兼容性与安全状态不由 LivePortrait 官方背书;引入生产环境前须单独审计。
- HuggingFace Space、Replicate、FAL、Poe 等在线平台提供的体验入口受对应平台条款、队列与内容审核规则约束,不等同于本地源码部署。
11.6 免责声明
本指南依据官方公开文档与源码整理,命令、参数、端口、依赖版本、权重渠道与界面控件均来自仓库
README、readme_zh_cn.md、requirements.txt、inference.py、app.py、app_animals.py
与 src/config
配置类;官方后续版本可能调整依赖版本、模型渠道、算子要求与界面参数,部署时以仓库最新说明为准。法律不得排除或限制的责任除外,作者与本文不对因使用、修改或运行本项目产生的直接或间接损失承担责任。