
Hindsight:让 AI 智能体随时间学习的记忆系统部署指南
Hindsight 是 Vectorize.io 开源的智能体记忆系统,目标是打造"会随时间学习"的智能体。大多数记忆系统只是在回忆对话历史,而 Hindsight 专注于让智能体真正"学习",而不只是"记住"。它在 LongMemEval 长期记忆基准上取得了业界领先的成绩,被财富 500 强企业和越来越多的 AI 创业公司用于生产环境。

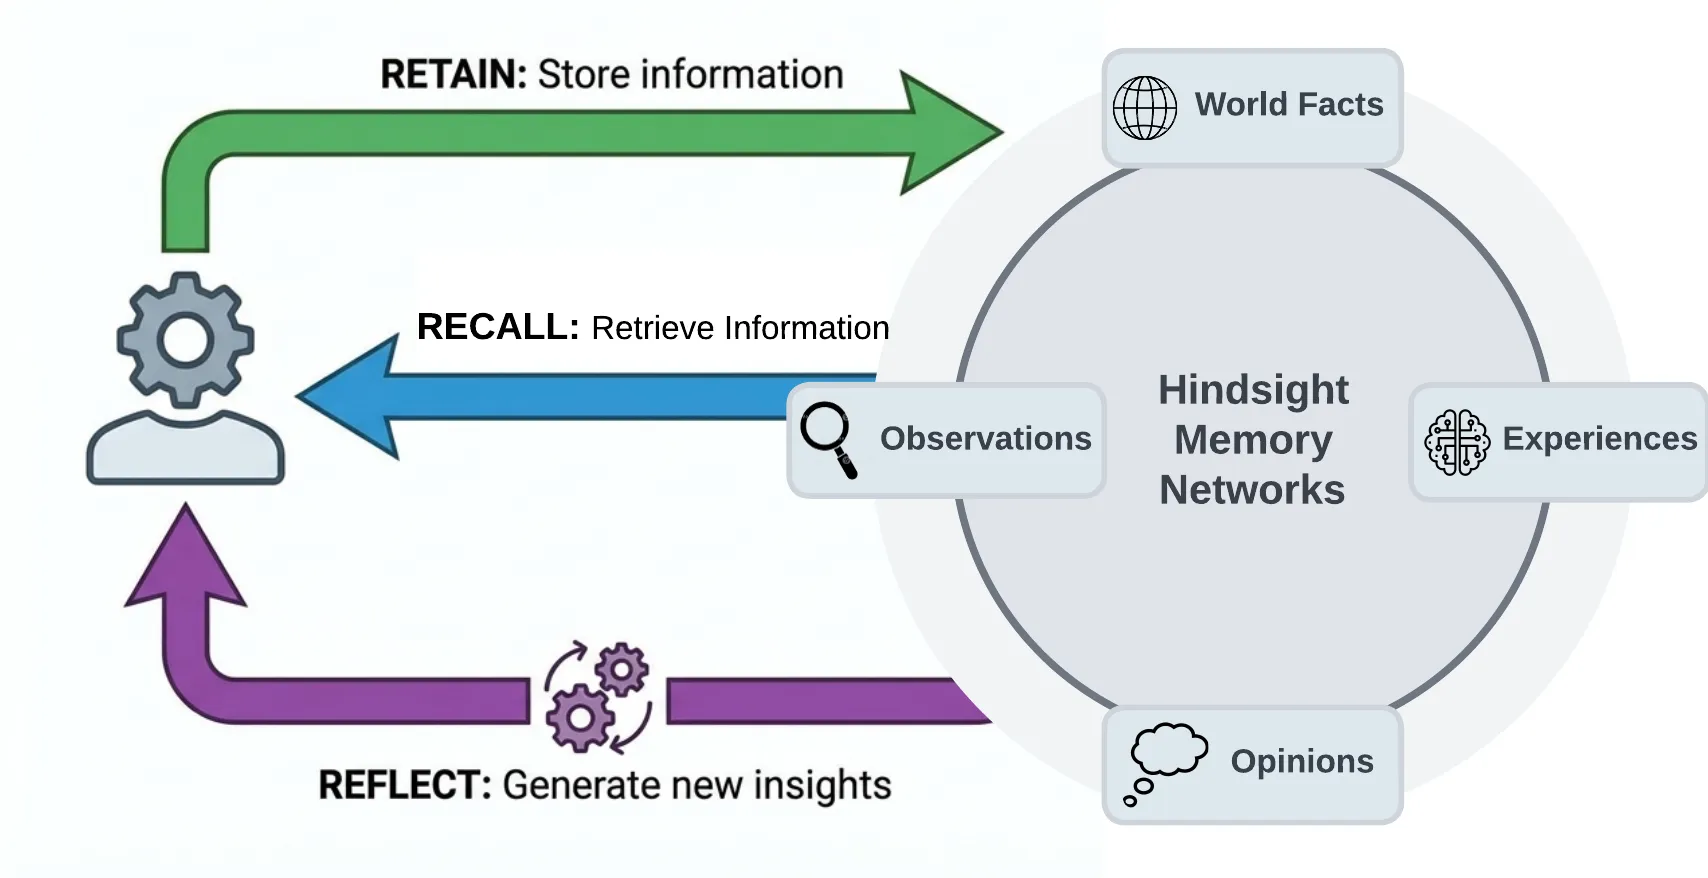
它用仿生的数据结构组织记忆,更接近人类记忆的运作方式:世界事实、经历、观察、心智模型四类记忆分通道存储,而不是简单的向量检索或知识图谱。核心操作有三个——retain(存入)、recall(召回)、reflect(反思),后台会把零散事实 Consolidate 成带证据的观察,并持续修正,让新信息强化、弱化或扩展已有信念,而不是默默覆盖。
一、项目官方信息
| 项目 | 信息 |
|---|---|
| 项目名称 | Hindsight |
| 项目定位 | 让 AI 智能体随时间学习的长期记忆系统 |
| 维护组织 | Vectorize.io |
| 代码仓库 | vectorize-io/hindsight |
| 主要语言 | Python |
| 官方文档 | hindsight.vectorize.io |
| 开源协议 | MIT |
| Star 数 | 约 54.4k |
| 论文 | arXiv:2512.12818 |
二、项目背景
现在的智能体有一个通病:每次对话结束就"失忆"。你告诉它你是谁、你的偏好、项目的约定,下次开新会话它又从头问起。RAG 能从文档里检索相关片段,但那是"查资料",不是"记住你";知识图谱能存关系,但维护成本高、更新僵化。Hindsight 想解决的是"智能体跨会话越用越懂你"这件事。
它的关键设计是把记忆分层:原始事实和经历进来后,后台自动归并成去重的观察,每条观察带着原文证据和证据计数;新证据到来时是"修正"而不是"覆盖",所以一个信念会随时间变得更准或被推翻。心智模型则是对某个固定问题(比如"这个用户的偏好是什么")的常驻答案,智能体启动时读一次数据库就拿到沉淀好的知识,而不是每次重新推理。这种"记忆会沉淀、会反思、会修正"的机制,正是它区别于普通向量库的地方。
更具体地说,当你调用 retain 存入一段话时,Hindsight 内部用 LLM 抽取关键事实、时间、实体和关系,再归一化成标准实体、时间序列和搜索索引。查询时 recall 并行跑四路检索(语义、关键词、图谱、时间),把结果融合、重排、按 token 预算裁剪后返回。reflect 则更进一步,对已有记忆做深度分析,建立跨记忆的新连接——比如销售智能体反思为什么某些话术得到了回复、某些没有,项目智能体反思还有哪些风险没被缓解。这种从"检索"到"反思"的跨度,让它能支撑需要长期记忆和自主决策的 AI 员工型智能体。
三、核心特性
- 三种操作:retain 存入、recall 召回、reflect 深度反思并建立新连接。
- 四种记忆类型:世界事实、经历、观察、心智模型,仿生分通道。
- 四路并行召回:语义向量、BM25 关键词、图谱(实体/时间/因果)、时间范围,结果用倒数排名融合加 cross-encoder 重排。
- 记忆银行(bank):一个用户、智能体或项目一个独立"大脑",严格隔离不串味。
- 观察沉淀:后台把事实归并成带证据引用的信念,新证据强化或弱化。
- 心智模型与知识页:常驻答案,启动即读,可导出成 Markdown 维基。
- 多语言默认:自动检测输入语言,实体保留原文字符(张伟还是张伟)。
- 记忆防御:可选按 45 种模式扫描密钥和 PII,脱敏或拦截。
- 25+ LLM 提供商:OpenAI、Anthropic、Gemini、本地 Ollama、OpenAI 兼容端点,现有订阅也能直接用。
- 60+ 集成:Claude Code、Cursor、LangGraph、n8n、Dify 等,多数无需改代码。
记忆银行还带有"倾向特质"(怀疑、字面、共情),会影响 reflect 如何基于记忆推理;每个 bank 可以从声明式模板创建。生产侧它提供 Prometheus 指标、管理 CLI(迁移、修复 bank、处理卡住的操作)、webhooks(retain/沉淀/刷新生命周期事件)和租户/认证/存储扩展点,企业还可以用 Oracle AI Database 23ai 获得完全对齐的功能。对不想运维的团队,Hindsight Cloud 按用量计费、带 99.9% SLA,直接指向托管端点即可。
四、环境要求
- 运行方式:Docker(推荐)、pip 裸机、Kubernetes Helm、或直接用托管的 Hindsight Cloud。
- 存储:PostgreSQL + pgvector,或 Oracle AI Database 23ai(功能对齐);嵌入式开发用内置 pg0。
- LLM 密钥:需要一个
HINDSIGHT_API_LLM_API_KEY或配置本地/兼容端点。 - 端口:API 8888,管理 UI 9999。
- 平台:Linux、macOS(含 Apple Silicon)、Windows 均支持;Intel Mac 用 slim 镜像。
五、部署步骤
方式一:Docker 一键启动(推荐)
export OPENAI_API_KEY=sk-xxx

docker run -it --pull always --name hindsight --restart unless-stopped \
  -p 8888:8888 -p 9999:9999 \
  -e HINDSIGHT_API_LLM_API_KEY=$OPENAI_API_KEY \
  -v hindsight-data:/home/hindsight/.pg0 \
  ghcr.io/vectorize-io/hindsight:latest
启动后 API 在 http://localhost:8888,管理 UI 在 http://localhost:9999。想外接 PostgreSQL 就进 docker/docker-compose 跑 docker compose up。换 LLM 提供商用 HINDSIGHT_API_LLM_PROVIDER 环境变量。
方式二:pip 裸机运行
pip install hindsight-api
export HINDSIGHT_API_LLM_API_KEY=sk-xxx
hindsight-api
方式三:浏览器网页端管理与嵌入式运行
启动后用浏览器打开 http://localhost:9999 就是管理界面,可以查看记忆银行、观察和知识页。不想起服务的话,Python 嵌入式模式:
pip install hindsight-all -U
import os
from hindsight import HindsightServer, HindsightClient

with HindsightServer(llm_provider="openai", llm_model="gpt-5-mini",
                     llm_api_key=os.environ["OPENAI_API_KEY"]) as server:
    client = HindsightClient(base_url=server.url)
    client.retain(bank_id="my-bank", content="Alice works at Google")
    results = client.recall(bank_id="my-bank", query="Where does Alice work?")
六、使用方法
客户端接入:
pip install hindsight-client -U
from hindsight_client import Hindsight
client = Hindsight(base_url="http://localhost:8888")

client.retain(bank_id="my-bank", content="Alice works at Google as a software engineer")
client.recall(bank_id="my-bank", query="What does Alice do?")
client.reflect(bank_id="my-bank", query="Tell me about Alice")
给现有智能体加记忆最简单的方式是 LLM Wrapper——两行代码把 OpenAI 客户端包一层,每次调用自动存/取记忆:
from openai import OpenAI
from hindsight_litellm import wrap_openai

client = wrap_openai(OpenAI(), bank_id="user-123", hindsight_api_url="http://localhost:8888")
response = client.chat.completions.create(model="gpt-5-mini",
    messages=[{"role":"user","content":"What do you know about me?"}])
每个服务还自带一个 MCP 端点 http://localhost:8888/mcp/{bank_id}/,把 retain/recall/reflect 暴露成工具给 MCP 客户端调用。做编码智能体时,用 npx @vectorize-io/hindsight-coding-agents install all 一条命令给各 CLI 装上长期项目记忆。
典型落地路径是:先用 LLM Wrapper 给现有智能体两行代码接上记忆,跑通"每次对话自动存/取";再按用户或项目分 bank,把隔离做好;最后打开记忆防御和观察沉淀,让智能体越用越准。对个人用户,它能让聊天机器人记住你的偏好和历史;对团队,它让 AI 员工型智能体在跨会话中积累项目上下文,不必每次重新解释背景。
七、常见问题 FAQ
Q:和直接用向量库 RAG 有什么区别? A:RAG 是查资料,Hindsight 是记你这个人——它会把事实沉淀成带证据的观察、随时间修正信念、支持反思,而不是每次返回相似片段。
Q:一定要用 OpenAI 吗? A:不必。支持 25+ 提供商,包括本地 Ollama、OpenAI 兼容端点,以及 ChatGPT Plus、Claude Pro 等现有订阅。
Q:数据隔离怎么做? A:一个用户/项目用一个 bank,bank 之间严格隔离;配合自定义 metadata 可做更细的过滤。
Q:怎么防止密钥被存进记忆? A:开启每 bank 的记忆防御策略,它按 45 种模式扫描 retain 内容,命中密钥或 PII 就脱敏或拦截。
Q:要自己运维数据库吗? A:自托管用 PostgreSQL+pgvector,或直接用 Hindsight Cloud 托管版,指向 https://api.hindsight.vectorize.io 即可免部署。
Q:支持中文吗? A:默认多语言,输入语言自动检测并保留原文,实体不会被翻译成拼音。
Q:reflect 和 recall 什么时候用哪个? A:recall 是查资料,返回相关记忆片段;reflect 是深度思考,让智能体在记忆之间建立新连接、形成判断,适合回答需要综合分析的问题,而不是简单事实查询。
Q:编码智能体怎么接? A:跑 npx @vectorize-io/hindsight-coding-agents install all,它会从 git 历史和过往会话自动建一个 per-repo 记忆银行,在智能体开工时注入,并生成覆盖架构、约定和进行中工作的知识页。
局限与注意
记忆系统会随时间累积噪声,建议定期审查高影响信念、清理过时事实;自托管要管好 PostgreSQL 的容量和备份。把敏感个人信息写入长期记忆前,考虑脱敏和保留策略。它适合需要跨会话记忆的智能体,单轮无状态问答用不上这套机制,反而增加复杂度。
记忆是怎么形成的
Hindsight 的核心循环是:智能体把每次交互里的事实交进去,系统抽取成带证据的观察,观察再聚合为信念;当新信息和旧信念冲突时,它会更新而不是覆盖,保留"为什么改"。这让智能体不只是记住"用户偏好 A",还能记住"曾经偏好 B,因为 X 改为 A"。反思模块进一步把相关观察连成更高层的结论,跨会话复用。
自托管 vs 云
自托管需要 PostgreSQL,适合记忆敏感、数据不出内网的团队;Cloud 省去数据库和运维,按量付费。接 OpenAI Agents SDK 或 LangChain 时,把记忆作为工具暴露给智能体,让它在需要时主动检索和写入。生产上建议先在小范围观察记忆抽取质量,再决定哪些交互值得长期沉淀。
总体而言,Hindsight 把记忆从"存对话历史"提升到"让智能体学习":事实会沉淀成带证据的观察、随时间修正信念、支持反思建立新连接。它适合需要长期记忆和自主决策的 AI 员工型智能体,自托管用 PostgreSQL,或直接用 Cloud 免运维。
- GitHub 仓库:vectorize-io/hindsight
- 官方文档:hindsight.vectorize.io
- 基准测试:benchmarks.hindsight.vectorize.io
- 论文:arXiv:2512.12818
- Hindsight Cloud:ui.hindsight.vectorize.io
- 集成列表:hindsight.vectorize.io/integrations
- 问题反馈:GitHub Issues
小结:Hindsight 把记忆从存历史提升到让智能体学习,事实沉淀为带证据的观察、随时间修正信念、跨会话复用。自托管用 PostgreSQL,或直接上 Cloud 免运维。
进阶:把记忆接入 OpenAI Agents SDK 或 LangChain,让智能体在需要时主动检索和写入;用命名空间隔离不同用户或项目。观察多了之后做记忆压缩和过期清理,避免上下文被噪声撑爆。监控抽取准确率,不满意就调整提示词或样例。
社区与生态:Hindsight 定位在记忆层,常和智能体框架搭配使用,提供 MCP 和 SDK 接入。它强调可观测——观察、信念、反思都有证据可查,方便调试智能体为什么这么答。社区围绕长期记忆和自主决策场景讨论,适合想做 AI 员工、个人助理的团队。
落地建议:先接一个简单智能体,让它在对话里写记忆、下一轮再读回,观察记忆是否被正确抽取和复用。自托管先把 PostgreSQL 跑通,配置好连接和命名空间。敏感数据先脱敏再入库,定期清理过时信念。记忆抽取质量不达标时,调整写入时的提示词和样例。
为什么值得用:普通智能体每次重启都失忆,Hindsight 把事实沉淀成带证据、可修正的长期记忆,跨会话复用,让 AI 员工越用越懂你。自托管或云都行。
对比:和把对话历史塞进上下文比,它抽取的是带证据的观察,省 token 且能跨会话修正;和自建向量记忆比,它多了信念和反思层。
上手顺序:跑通自托管 PostgreSQL→接一个智能体→让它读写记忆→跨会话验证→接入更多工具。先用小数据观察记忆质量,再放大。
结语:长期记忆是智能体从演示走向实用的关键一环,Hindsight 用可追溯的观察—信念—反思结构,把这件事做成了可自托管、可接框架的组件。
记住三件事:记忆带证据、信念会修正、敏感先脱敏。
再提醒:定期审查和清理过时记忆,避免噪声;命名空间隔离不同用户;自托管管好 PostgreSQL 备份和容量。
本文基于官方 README 整理,部署命令与模型参数以仓库最新版为准;自托管前先把 PostgreSQL 跑通,再接入智能体框架。
希望这份部署指南帮你给智能体装上长期记忆。
部署前再确认一次数据库连接和命名空间,别把不同项目的记忆混在一起。
祝你给智能体装上记忆后,越用越懂业务。
建记忆库时从小范围开始,观察抽取质量再放大。
这份指南到此结束,祝你部署顺利。
如遇问题,先看仓库 issue。