
Harness²:Google Research 递归智能体自我优化框架 · 部署与使用指南

一句话定位:模型权重全程冻结不变,只优化包裹模型的「外壳系统」(提示词、工具、记忆、技能等),让智能体在开放任务环境中递归式地自我变强。
论文:Harness²: Recursive Agent Harnessing for an Open World(arXiv:2610.14224) · 出品方:Google Research · 开源协议:Apache 2.0
官方资源跳转
| 资源 | 链接 |
|---|---|
| GitHub 仓库(源码) | https://github.com/google-research/harness2 |
| 项目官方主页 | https://harness2.github.io |
| 论文摘要页(arXiv) | https://arxiv.org/abs/2610.14224 |
| 论文 PDF 直链 | https://arxiv.org/pdf/2610.14224 |
| 源码打包下载(ZIP) | https://github.com/google-research/harness2/archive/refs/heads/main.zip |
| 官方安装指南 SETUP.md | https://github.com/google-research/harness2/blob/main/docs/SETUP.md |
| 官方基准指南 BENCHMARKS.md | https://github.com/google-research/harness2/blob/main/docs/BENCHMARKS.md |
| 官方实验指南 EXPERIMENTS.md | https://github.com/google-research/harness2/blob/main/docs/EXPERIMENTS.md |
| 开源协议 LICENSE | https://github.com/google-research/harness2/blob/main/LICENSE |
一、这是什么
1.1 两个核心概念
- Harness(外壳/机架):让一个大模型能够真正「干活」成为智能体的整套外围系统——提示词、工具、记忆、技能、编排流程、上下文管理等。模型本体只是底座,真正决定智能体表现的,是这层外壳。
- Harnessing(外壳优化):围绕任务反复调整、打磨这套外壳系统的过程。
Harness² 是一套即插即用(plug-and-play)的递归外壳优化框架。它在保持模型权重固定不变的前提下,把「任务级优化」和「长期经验沉淀」两层递归串联起来,让智能体面对设计阶段从未见过的新任务时,依然能自我改进。
1.2 为什么值得用
- 不动模型、零训练成本:不需要微调、不需要改动权重,只优化提示词与外围配置,普通开发者也能复现。
- 双层递归、能力可沉淀:单任务上对比式试出有效改法,再把经验写入长期经验库,后续任务自动复用,能力随任务积累。
- 效果可量化:在官方三个专业基准、四个模型—外壳组合上,仅单步优化即可带来明显提升(详见下文实测数据)。
- 执行器与基准开放:支持 OpenCode、Codex 两种执行器,内置 JobBench、LAB、WorkBuddy-Bench 三套评测。
二、工作原理
2.1 两层递归
任务级递归(Task-level recursion):针对当前任务,通过对比式的 Propose(提出改动)→ Probe(探测效果)→ Compose(组合改进) 流程打磨执行外壳:先提出若干候选改动,在同一任务上分别执行探测,再对比不同执行轨迹之间的行为差异,组合出改进后的外壳——整个过程不需要标准答案(ground-truth)反馈。
外壳级递归(Harnessing-level recursion):每完成一个任务,把被采纳的外壳方案、以及有执行证据支撑的经验教训,更新进一份持久化的「改进外壳(improvement harness)」,用来指导后续所有任务的优化方向,实现长期能力沉淀。
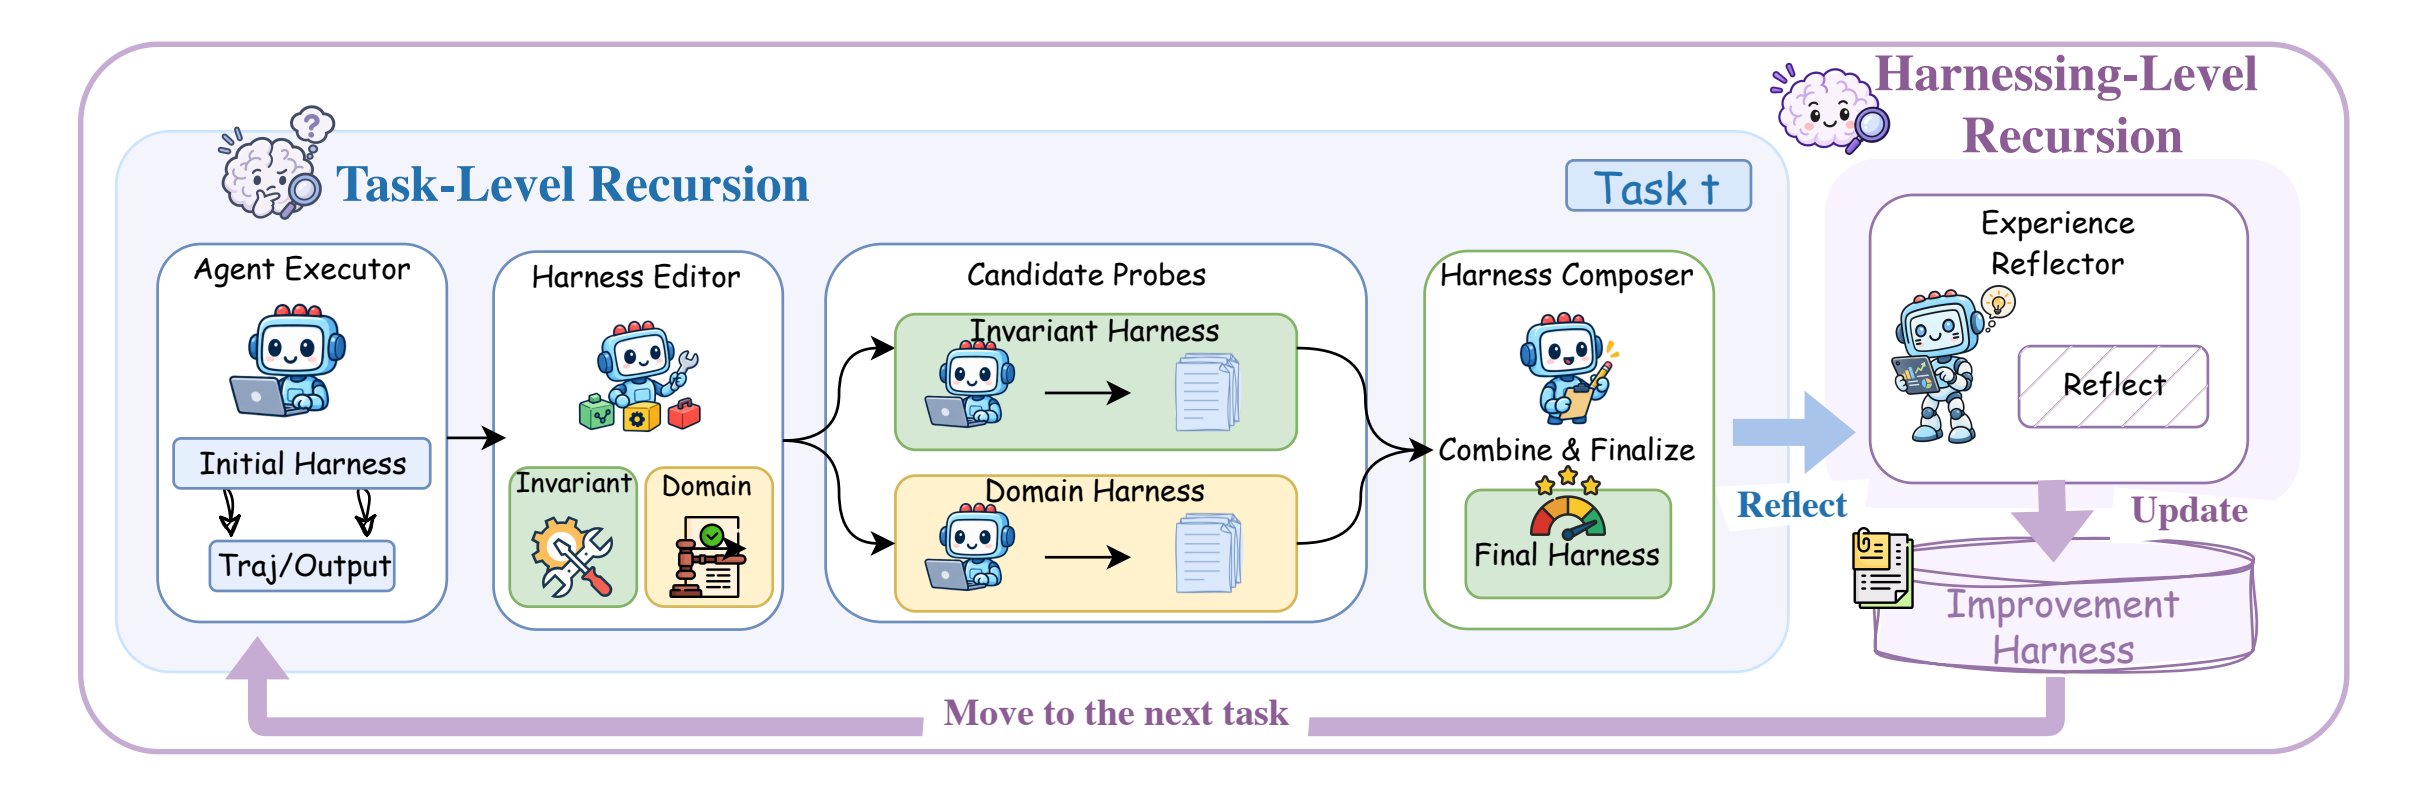
上图为官方流水线:左侧任务执行器运行初始外壳,外壳编辑器提出通用改动与领域专用改动,候选探测器分别执行,外壳编写器将其组合为最终外壳;右侧经验反思器回看本轮过程,更新供下一任务使用的改进外壳。
2.2 八个可编辑组件
模型周围暴露 8 类可被框架改写的外壳组件,分别控制上下文构建、工具接口、任务委派与工具循环内的行为:
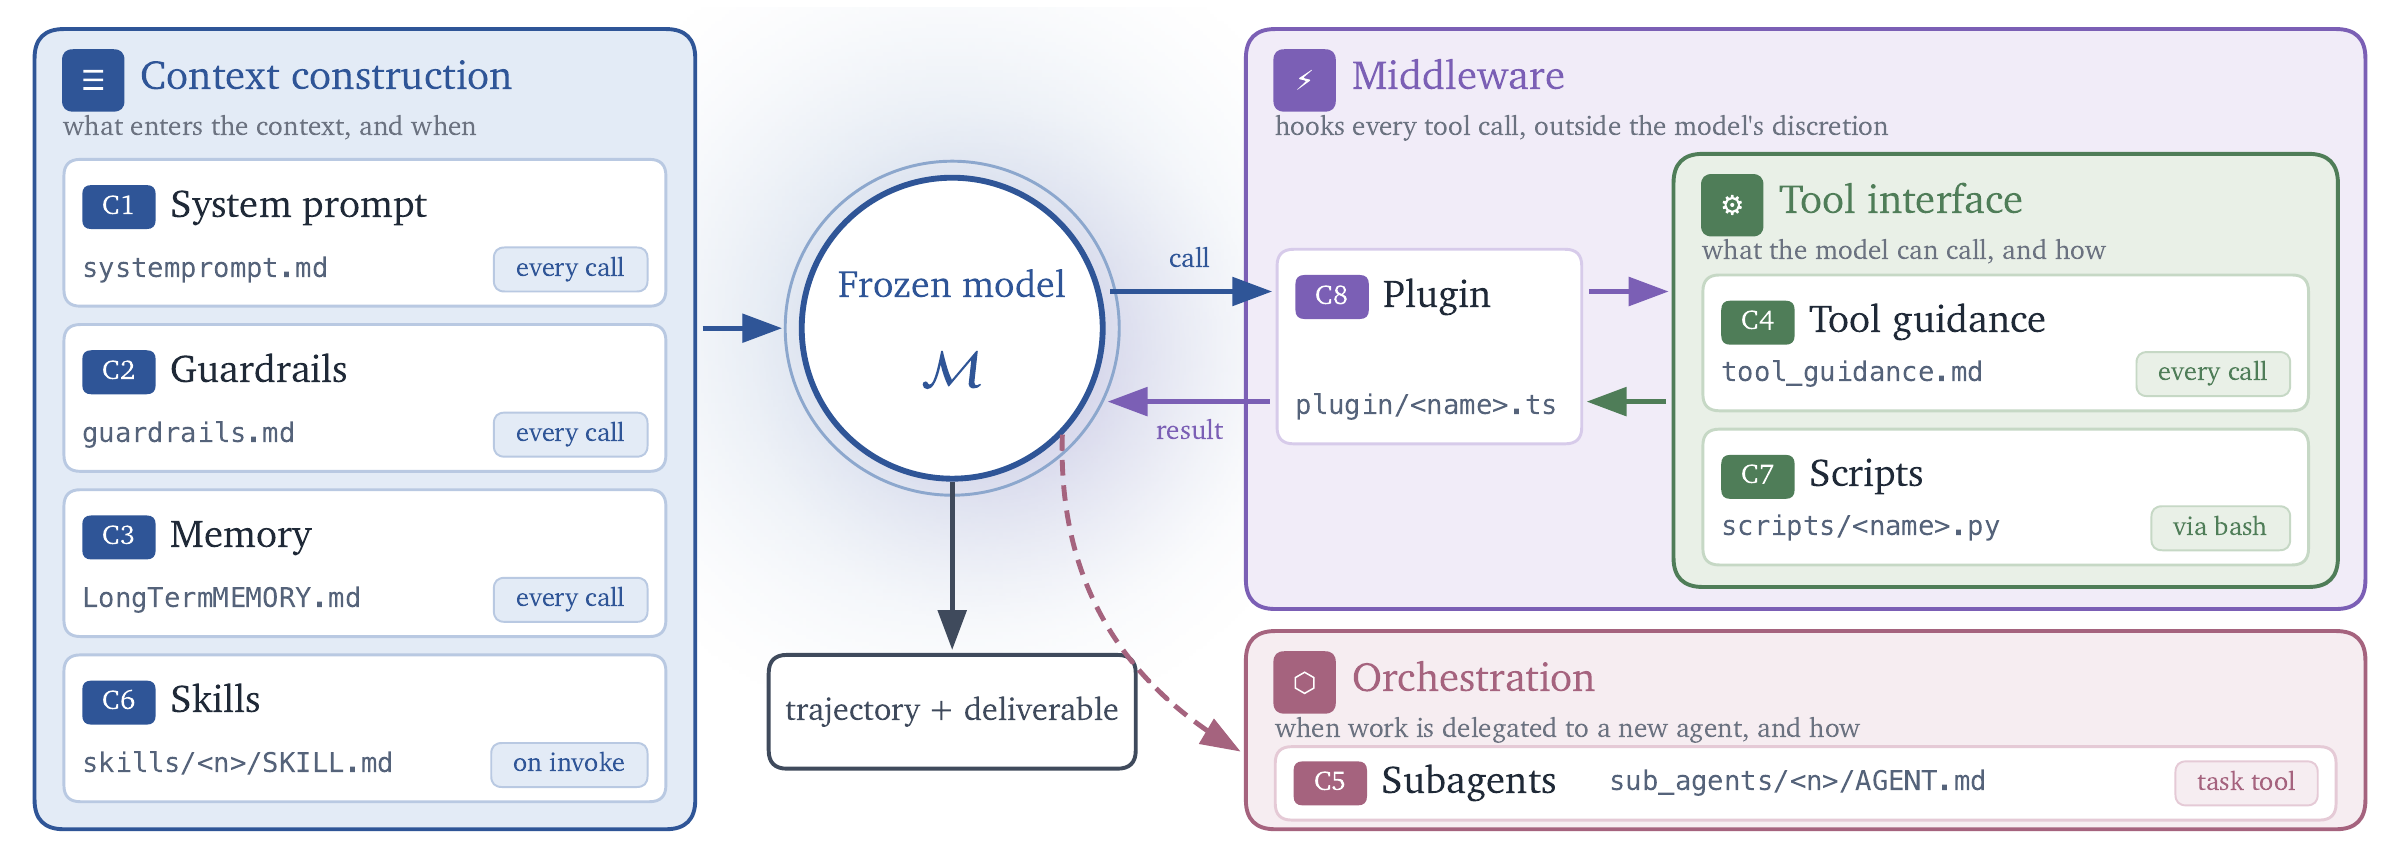
| 组件 | 作用归类 |
|---|---|
| System Prompt(系统提示词) | 构建上下文 |
| Guardrails(护栏规则) | 构建上下文 |
| Memory(记忆) | 构建上下文 |
| Skills(技能库) | 构建上下文 |
| Tool Guidance(工具使用指引) | 定义工具接口 |
| Scripts(脚本) | 定义工具接口 |
| Subagents(子智能体) | 编排委派工作 |
| Plugins(插件/中间件) | 控制中间件行为 |
2.3 两种任务级递归模式
两种模式都从同一基础外壳的 k 次参考执行 开始:
| 模式 | 行为 | 特点 |
|---|---|---|
--mode parallel(并行递归) |
提出并探测 k 个通用(invariant)候选 + k 个领域专用候选;每个独立组合都使用完整候选池与执行证据,产出 k 份改进外壳 | 探索面更广 |
--mode sequential(串行递归) |
携带已改进的外壳与累积执行证据,连续走完 k 轮 Propose–Probe–Compose | 优化挖得更深 |
--k 是任务级递归预算:--k 1 表示只走一轮 Propose–Probe–Compose。
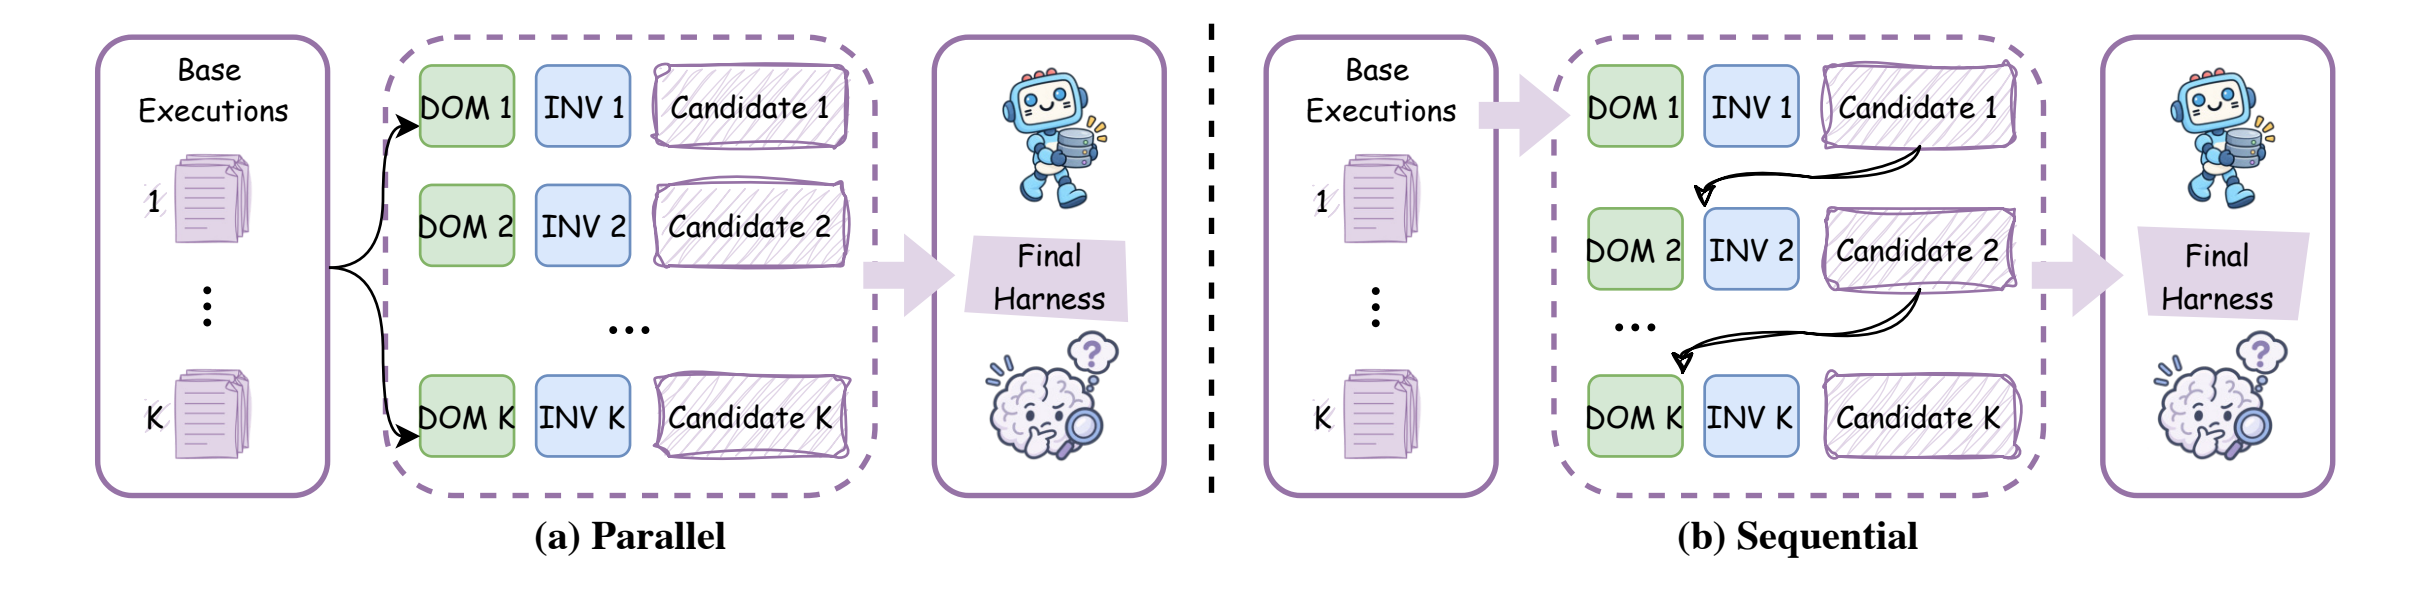
并行递归探索更广;串行递归优化更深。任务级预算调大后,官方报告可获得进一步提升。
经验沉淀机制:外壳方案被采纳后,反思(reflection)环节会把采纳的外壳与有证据支撑的经验教训存入按领域划分的经验库。同一领域内的任务按顺序执行、只读取更早的条目;不同领域可以并发执行。经验库按「基准 + 执行器 + 模式 + 预算 k + 随机种子」分离存放,保证实验互不污染。
2.4 官方实测效果
在三个专业基准、四个模型—外壳配置上,单步 Harness² 即可在原始外壳基础上提升 GLM-5 与 Gemini 3.5 Flash:
| 基准 | 提升幅度(官方报告) |
|---|---|
| WorkBuddy-Bench | 最高 +11.5 分 |
| JobBench | +4.5 分 |
| LAB(partial pass rate 部分通过率) | +11.8 个百分点 |
以上数据均来自官方论文与仓库 README;模型越弱,外壳优化带来的收益通常越明显。
三、环境要求与前置依赖
3.1 基础运行环境
| 项目 | 要求 |
|---|---|
| 操作系统 | Linux |
| Python | 3.12(Python 包同时支持 3.13) |
| 包管理器 | uv(https://docs.astral.sh/uv/getting-started/installation/) |
3.2 模型版基准评测额外依赖
| 依赖 | 用途 | 下载地址 |
|---|---|---|
| Node.js 20+ | 执行器运行环境 | https://nodejs.org/en/download |
| Google Cloud CLI(gcloud) | Vertex AI 模型凭证认证 | https://cloud.google.com/sdk/docs/install |
| Docker Engine | 仅 WorkBuddy-Bench 需要 | https://docs.docker.com/engine/install/ |
| Pandoc + Poppler | 仅 LAB 法律基准需要 | 见下方 apt 命令 |
3.3 安装系统级依赖(Debian / Ubuntu)
sudo apt-get update
sudo apt-get install -y git curl unzip ca-certificates pandoc poppler-utils
基准安装程序会在
dependencies/目录下自行安装锁定版本的 Bun 运行时;运行以下命令时请保持主 Harness² 虚拟环境处于激活状态。
四、第一步:本地 Demo 快速跑通(无需模型凭证、无 API 费用)
本地 Demo 会运行两种递归模式,使用确定性编辑器与真实 Python 执行,不需要任何模型密钥或云账号,适合先验证环境是否正常。
# 1. 克隆官方仓库
git clone https://github.com/google-research/harness2.git
cd harness2

# 2. 创建 Python 3.12 虚拟环境
uv venv --python 3.12 .venv
source .venv/bin/activate

# 3. 安装本项目(含渲染依赖)
uv pip install -e '.[render]'

# 4. 运行本地 Demo,输出到 runs/demo,递归预算 k=2
harness2-demo --output runs/demo --k 2
运行成功即说明本地环境就绪。结果写入 runs/demo/ 目录。
五、第二步:模型版完整部署(接入真实大模型基准)
5.1 拉取源码并安装
git clone https://github.com/google-research/harness2.git
cd harness2

uv venv --python 3.12 .venv
source .venv/bin/activate

uv pip install -e '.[render]'
5.2 配置模型凭证
复制环境变量模板并编辑:
cp .env.example .env
用编辑器打开 .env,填写 Vertex AI 项目与模型 ID。核心配置项如下:
| 变量 | 含义 |
|---|---|
HARNESS2_SOLVER_MODEL |
执行器模型,格式为 OpenCode 的 provider/model |
HARNESS2_IMPROVER_MODEL |
改进器模型,格式同上;默认与执行器相同 |
HARNESS2_JUDGE_MODEL |
评判模型的裸模型 ID(适配器会自动补全 Vertex 前缀) |
HARNESS2_RUNS_DIR |
结果输出根目录,默认 runs/ |
GOOGLE_CLOUD_PROJECT |
你的 Vertex AI 项目 ID |
GOOGLE_CLOUD_LOCATION |
区域,默认 global |
说明:Shell 环境变量优先级高于
.env;你的账号必须具备所配置每一个模型的访问权限。官方内置配置使用 Vertex Gemini 作为执行器与评判模型,改进器支持 Vertex Claude 或 Gemini。
5.3 完成 Google Cloud 认证
gcloud auth application-default login
其他认证方式(任选其一,详见官方 SETUP.md):
- 机器上已配置附加服务账号时,Application Default Credentials 可直接使用该账号;
gcloud auth application-default login --no-browser:在另一台有浏览器的机器上登录后回传;- 通过
GOOGLE_APPLICATION_CREDENTIALS指向服务账号密钥文件; gcloud auth application-default login --impersonate-service-account=<账号>模拟服务账号。
使用 Vertex 配置时,
gcloud必须在PATH中;安装检查会执行gcloud auth application-default print-access-token验证凭证。
5.4 安装并检查选定基准
每次只安装你打算运行的那一个基准:
# LAB(法律):harness2-setup lab
# JobBench(专业工作):harness2-setup jb
# WorkBuddy-Bench(办公/网页/代码):harness2-setup wb

harness2-setup lab
harness2-check --bench lab
harness2-setup <bench> --dry-run:预览安装命令,不实际改动;harness2-check:检查已装依赖、凭证与配置,不会调用模型;模型是否可用在首次真正调用时才检验;- 未完成配置时,优化与评判命令会以非零退出码返回。
六、运行基准(执行 → 评判 → 报告)
一条完整流程由三段命令组成:优化执行 harness2 → 评判 harness2-judge → 报告 harness2-report。
三段命令的基准、执行器、子集、--k、--mode、随机种子必须保持完全一致(不一致会导致报告与评判错位)。
成本提示:模型版运行会产生 API 调用费用(执行器 rollout + 改进阶段都会调用模型)。LAB 全量任务流包含 1143 个任务,正式跑之前务必先读模型定价、用小任务集试跑。
--max-tasks N限制的是每个领域的任务数,不是整次运行的总数;用--dry-run先预览任务选择与可用领域,不发起任何模型调用。
6.1 LAB · 法律工作基准
上游:
harveyai/harvey-labs;任务带原始材料与评分规则;需要 Pandoc 与 Poppler;评判只在输出选定后才读取材料。报告使用 Partial(通过条目占比)与 All-pass(全部通过)两种口径。
harness2-setup lab
harness2-check --bench lab

# 优化执行:只选 antitrust-competition 领域,最多 1 个任务,并行递归 k=1
harness2 --bench lab --k 1 --mode parallel \
  --only-domains antitrust-competition --max-tasks 1

harness2-judge --bench lab --k 1 --mode parallel
harness2-report --bench lab --k 1 --mode parallel
若评判阶段 Vertex 返回
429 RESOURCE_EXHAUSTED,属于配额不足,稍后重跑harness2-judge即可;未成功评判的任务不计分,输出写入运行目录的judge.log。结果目录:runs/lab/。任务自动发现:任务随锁定版本一起克隆到
dependencies/harvey-labs/tasks/<领域>/<任务>/task.json,适配器自动发现全部已安装任务,无需单独维护任务清单。安装程序会一并装好 LAB 依赖环境、运行器覆盖层与内置 Vertex 评判补丁。
6.2 JobBench · 专业工作基准
上游:
Job-Bench/job-bench-eval;数据集按职业目录分组;数据来自 Hugging Face,公开且无需账号、token 或条款确认。
harness2-setup jb
harness2-check --bench jb

harness2 --bench jb --k 1 --mode parallel
harness2-judge --bench jb --k 1 --mode parallel
harness2-report --bench jb --k 1 --mode parallel
JobBench 数据(含
RUBRICS.json)在 Hugging Face 公开,具备联网能力的执行器可能直接检索到答案;运行时请按官方实验指南屏蔽对应主机。结果目录:runs/jb/。数据集细节:setup 只下载 Hugging Face 主数据集(公开、非门控,无需账号/token/条款确认),记录其版本号并放置到
dependencies/job-bench-eval/dataset/main/,同时安装文档抽取依赖与一个处理推理努力与空补全的评判补丁。评分规则(rubrics)不进入改进器的证据。使用 Gemini 评判模型时走 Vertex OpenAI 兼容端点与 Application Default Credentials;如需独立评判提供方,设置HARNESS2_JUDGE_BASE_URL、HARNESS2_JUDGE_API_KEY与对应模型 ID 即可。报告分数沿用上游评分规则权重;未评分任务单独列出。
6.3 WorkBuddy-Bench · 办公 / 网页 / 代码基准
上游:
Tencent/workbuddy-bench;分为office、web、code三个子集;需要 Docker。上游腾讯自定义许可证含地域限制,下载使用前请先阅读官方许可证。
# 先确认 Docker 可用
docker info

# 只安装 office 子集(不写 --subset 会一次性安装全部三个子集)
harness2-setup wb --subset office
harness2-check --bench wb --subset office

harness2 --bench wb --subset office --k 1 --mode parallel
harness2-judge --bench wb --subset office --k 1 --mode parallel
harness2-report --bench wb --subset office --k 1 --mode parallel
后续每条命令一次只带一个子集;每次 rollout 使用全新的基准容器;运行目录:
runs/wb/<subset>/。安装与校验细节:
harness2-setup wb不带--subset时一次性安装全部三个子集。安装流程会锁定 Harbor 运行时、应用内置适配器/挂载/凭证传输补丁、复制 harness 运行器、从.env生成求解器与评判路由、用上游脚本下载所选子集、构建 OpenCode harness 镜像。公开 Vertex 配置要求HARNESS2_SOLVER_MODEL必须是google-vertex/gemini...格式、HARNESS2_JUDGE_MODEL为裸gemini...ID 且设置GOOGLE_CLOUD_PROJECT,否则 setup 拒绝执行(--dry-run会先提示该要求)。数据校验:安装补丁把上游下载脚本改为优先
curl、再wget、再hf,并要求数据集仓库的SHA256SUMS——无法通过校验的压缩包不会解包;成功下载会打印wb-bench-<subset>-v1.0.tar.gz: OK。任务结构:任务由
dependencies/workbuddy-bench/datasets/wb-bench-<subset>-v1.0/tasks/下的task.toml与instruction.md发现;code 子集用metadata.role、office 与 web 子集用metadata.category分组。适配器只读取验证器的score.json,改进器永远收不到验证器输出;缺失验证结果的任务保持未评分。
6.4 串行递归切换
把上述命令中的 --mode parallel 换成 --mode sequential 即可使用串行递归,其余参数保持不变:
harness2 --bench lab --k 2 --mode sequential
harness2-judge --bench lab --k 2 --mode sequential
harness2-report --bench lab --k 2 --mode sequential
6.5 一键脚本(检查+优化+评判+报告串行执行)
官方为每个基准提供了顺序执行全套流程的脚本:先运行检查,再执行优化、评判、报告。通过环境变量设置执行器、递归预算与模式:
# LAB:脚本内嵌检查与完整流程
bash scripts/run_lab.sh --only-domains antitrust-competition --max-tasks 1

# JobBench:用 Codex 执行器、k=3、串行递归
SUBSTRATE=cx K=3 MODE=sequential bash scripts/run_jobbench.sh --max-tasks 1

# WorkBuddy:指定 web 子集
SUBSET=web bash scripts/run_workbuddy.sh --max-tasks 1
支持的变量:SUBSTRATE(执行器)、K(递归预算)、MODE(递归模式),WorkBuddy 另有 SUBSET;额外参数会传给优化命令本身。
七、切换到 Codex 执行器(可选)
默认执行器为 OpenCode;需要使用 Codex 时,安装可选依赖并启动本地桥接服务。
7.1 安装桥接依赖并启动 bridge
uv pip install -e '.[render,bridge]'

# 普通基准:
harness2-bridge
# WorkBuddy(容器内需要访问桥接):
harness2-bridge --host 0.0.0.0
- Codex 执行器连接 Responses API 端点;针对 Vertex AI 上的 Gemini,内置
harness2-bridge通过本地 LiteLLM 服务提供该接口,复用同一套 Application Default Credentials 与GOOGLE_CLOUD_PROJECT。 - bridge 会把需要写入
.env的HARNESS2_CODEX_*配置打印出来;端口与访问密钥保存在dependencies/codex/,重启后复用。 - 如需接入其他 Responses API 端点,直接设置
HARNESS2_CODEX_BASE_URL、HARNESS2_CODEX_API_KEY、HARNESS2_CODEX_MODEL即可;修改后必须重新执行 setup(setup 会把端点与模型记录到dependencies/codex/home/config.toml,在此之前harness2-check会一直提示配置过期)。
7.2 全部命令追加 --substrate cx
harness2-setup lab --substrate cx
harness2-check --bench lab --substrate cx

harness2 --bench lab --substrate cx --k 1 --mode parallel \
  --only-domains antitrust-competition --max-tasks 1

harness2-judge --bench lab --substrate cx --k 1 --mode parallel
harness2-report --bench lab --substrate cx --k 1 --mode parallel
⚠️ Codex 以关闭沙箱方式运行;评测前请先按官方实验指南配置执行器网络限制。WorkBuddy 在 Docker 容器内执行 Codex,bridge 必须监听
--host 0.0.0.0,同时注意限制该端口的可访问范围。
八、常用命令参数速查
| 参数 | 作用 |
|---|---|
--k N |
任务级递归预算:--k 1 走一轮 Propose–Probe–Compose;并行下探测 N 通用 + N 领域候选,串行下连续走 N 轮 |
--mode parallel |
并行递归(探索更广,默认推荐先试) |
--mode sequential |
串行递归(挖得更深) |
--substrate cx |
使用 Codex 执行器(默认 OpenCode) |
--workers N |
并发运行 N 个领域;同一领域内任务保持有序(先跑完的经验才能被后跑的任务读取) |
--seed N |
可复现地打乱任务流顺序;注意它不控制模型采样的随机性 |
--subset office / web / code |
WorkBuddy 子集选择,每条命令只带一个 |
--only-domains <领域> |
LAB 限定任务领域,例如 antitrust-competition |
--max-tasks N |
限制每个领域本次运行的任务数量(先用小数量试跑,避免 API 费用) |
--split-file <文件> --split test |
使用预生成的任务分区运行指定分片(见 9.5 可复现性) |
--bases |
仅对基准评估:为参考执行(基础外壳)评分,产出 base_judged.json 供对照 |
--dry-run |
预览任务选择与可用领域,不发起模型调用 |
--help |
查看当前命令全部参数 |
九、结果目录、续跑与注意事项
9.1 结果保存位置
结果统一保存在 runs/ 下,按基准(含子集)分目录:runs/lab/、runs/jb/、runs/wb/<subset>/。内容包括:任务摘要、执行产物、被采纳的外壳方案、反思笔记、评分结果。
9.2 断点续跑
重复执行同一条命令即可续跑上次任务;失败未评分的任务保持未评分状态,不会被当作零分计入。更换模型或更换任务选择范围时,请使用一个新的 HARNESS2_RUNS_DIR,避免结果混在一起(保存的运行配置会阻止不兼容的续跑)。
9.3 成本控制建议
- 模型版运行会产生 API 调用费用;先用
--max-tasks 1、--k 1跑通最小任务再放量; harness2-setup <bench> --dry-run与harness2 --dry-run可在不调用模型的前提下预览安装与任务选择;- 每条命令都支持
--help查看完整参数。
9.4 基线对照(Baseline evaluation)
想量化「外壳优化」到底比原始外壳强多少,给参考执行(基础外壳)也评一次分:
# 先对基础外壳评分,产出 base_judged.json(与 judged.json 同目录)
harness2-judge --bases

# 然后正常评判改进外壳
harness2-judge --bench lab --k 1 --mode parallel

# 报告只覆盖改进外壳(refined harness)
harness2-report --bench lab --k 1 --mode parallel
对照时保持任务选择、执行器、改进器、评判器、网络访问完全固定。
9.5 可复现性与任务分区
为得到可复现的「按领域分层」任务切分(train/test 分片):
# 生成 42 种子、默认训练占比 0.5 的分区
python scripts/split_tasks.py --bench lab --seed 42 --output splits/lab.json

# 用指定分片运行
harness2 --bench lab --split-file splits/lab.json --split test --mode parallel
- 分区是本地文件,不是发布资产;脚本拒绝覆盖已存在文件;
- 任务分区脚本
scripts/split_tasks.py需要源码树(wheel 安装只含 harness2 包本身); - JobBench 数据集在下载时确定版本(非提交固定),setup 会把 Hugging Face 版本记录到
dependencies/job-bench-eval/dataset/main/.harness2-download.json,报告 JobBench 结果时请一并报告该版本。
9.6 网络与安全(详细)
执行器默认网络访问不受限,Codex 沙箱关闭。三个基准都是公开的,JobBench 每个任务的 RUBRICS.json 发布在 Hugging Face 上——联网执行器可以直接取回评分标准。官方在验证运行中曾发现:Codex 在 JobBench 上未经指示就自行下载了任务评分标准。因此评测前必须在网络层(执行器主机的出口防火墙或 DNS 策略)屏蔽以下主机:
| 主机 | 原因 |
|---|---|
huggingface.co、hf.co、*.hf.co |
基准数据与评分标准存放地 |
github.com、raw.githubusercontent.com |
基准仓库 |
注意区分两个阶段:setup 安装阶段需要访问这些主机下载依赖与数据;评测执行阶段才需要屏蔽它们。不要依赖工具本身的设置(Codex 无沙箱),必须做网络层限制,并在结果旁边注明采用的限制方式。
十、常见问题排查(FAQ)
| 现象 | 原因与处理 |
|---|---|
harness2-check 报配置不完整 |
检查 .env 中 HARNESS2_SOLVER_MODEL / HARNESS2_JUDGE_MODEL 格式是否符合官方要求(WorkBuddy 要求 google-vertex/gemini... 与裸 gemini...),并确认 GOOGLE_CLOUD_PROJECT 已设置 |
gcloud auth application-default print-access-token 失败 |
gcloud 未在 PATH 或未完成登录;按 5.3 节重新执行 gcloud auth application-default login(含 --no-browser / 服务账号等替代方式) |
评判阶段报 429 RESOURCE_EXHAUSTED |
Vertex 配额不足,非代码错误;稍后重跑 harness2-judge 即可,未评分任务保持未评分 |
| 安装 WorkBuddy 时 setup 拒绝执行 | 求解器/评判模型格式不符或 GOOGLE_CLOUD_PROJECT 缺失;用 harness2-setup wb --dry-run 查看具体要求 |
| WorkBuddy 数据解压失败 | 下载校验要求 SHA256SUMS;只接受能通过校验的压缩包,检查网络能否访问 Hugging Face 与 Docker 镜像仓库 |
| 换了模型/任务范围后续跑混乱 | 使用新的 HARNESS2_RUNS_DIR 输出根目录;保存的运行配置会阻止不兼容续跑 |
| 想对比「基础外壳 vs 优化后」 | 用 harness2-judge --bases 先给基础外壳评分,再看 base_judged.json 与 judged.json 对比 |
| 执行器访问了评分标准 | 评测前必须按 9.6 节在网络层屏蔽 huggingface.co、github.com、raw.githubusercontent.com,并在结果中注明限制方式 |
| 本地 Demo 报错 | 确认 Python 3.12 + uv + uv pip install -e '.[render]' 安装完整;Demo 不需要任何模型凭证 |
十一、官方下载与参考链接汇总
10.1 项目与文档
10.2 前置工具下载
| 工具 | 地址 |
|---|---|
| uv 包管理器 | https://docs.astral.sh/uv/getting-started/installation/ |
| Node.js 20+ | https://nodejs.org/en/download |
| Google Cloud CLI | https://cloud.google.com/sdk/docs/install |
| Docker Engine | https://docs.docker.com/engine/install/ |
10.3 官方在线原图(本文配图原始出处)


十二、引用与免责声明
论文引用(BibTeX)
@article{xu2026harness2,
  title = {Harness$^2$: Recursive Agent Harnessing for an Open World},
  author = {Xu, Ruiyao and Chen, Yanfei and CuiZhu, Zhongying and Dalvi Mishra, Bhavana and Ming, Yifei and Yu, Han and Han, Rujun and Lee, Chen-Yu and Pfister, Tomas},
  journal = {arXiv preprint arXiv:2610.14224},
  year = {2026},
  url = {https://arxiv.org/abs/2610.14224}
}
免责声明:本项目不是 Google 官方支持的产品,不适用 Google 开源软件漏洞奖励计划。
third_party/下的第三方代码、各基准与数据集保留其上游许可证;本文所有命令、参数与数据均整理自官方仓库 README、SETUP.md、BENCHMARKS.md 与论文,如官方文档更新,请以仓库最新版本为准。