
Breeze TTS 2:开放权重实时语音合成模型 · 最全部署与使用指南

一句话定位:BreezeBlue 出品的 30 亿参数开放权重 TTS 模型,为实时语音交互而生——支持免参考语音的「声音设计」、参考音频的「声音克隆与声音指导」、自然语言情绪指令、人声事件插入与超低延迟流式输出,中英双语一次搞定。
权重开源日期:2026.08.25(源码同日发布) · 推理代码协议:Apache 2.0 · 模型权重协议:BreezeBlue 研究/非商用许可
榜单成绩:在 Artificial Analysis 的 TTS Elo 榜单中排名 开放权重第 1,同时超过部分头部闭源商业模型。
目录
- 一、官方跳转与下载链接
- 二、模型简介与核心能力
- 三、硬件环境要求
- 四、完整部署步骤
- 五、模型权重获取方式
- 六、使用方法:四种核心玩法
- 七、流式 API 部署与调用
- 八、批量合成 API(Batch)
- 九、Fast 快速推理选项
- 十、Docker 容器化部署
- 十一、常见问题排查
- 十二、许可证与合规说明
- 十三、参考链接汇总
一、官方跳转与下载链接
| 资源 | 链接 |
|---|---|
| GitHub 推理源码仓库 | https://github.com/breezeblue-ai/breeze-tts |
| 源码 ZIP 打包下载 | https://github.com/breezeblue-ai/breeze-tts/archive/refs/heads/main.zip |
| HuggingFace 模型权重 | https://huggingface.co/BreezeBlue/breeze-tts-2 |
| 官网项目介绍页(Breeze TTS 2) | https://breezeblue.ai/breeze-tts-2 |
| 官网首页 / 在线体验 | https://breezeblue.ai/ |
| 官方文档中心 docs.breezeblue.ai | https://docs.breezeblue.ai/ |
| 官方 SDK 快速上手 | https://docs.breezeblue.ai/quickstart |
| TTS 使用指南 | https://docs.breezeblue.ai/guides/text-to-speech |
| 实时 TTS(WebSocket)指南 | https://docs.breezeblue.ai/guides/realtime-text-to-speech |
| Breeze CLI 安装文档 | https://docs.breezeblue.ai/cli |
| 模型权重许可证原文 | https://huggingface.co/BreezeBlue/Breeze-TTS-2/blob/main/LICENSE |
| 官方 Discord 社区 | https://discord.com/invite/6H7AgPe9pA |
| 官方 X(Twitter) | https://x.com/BreezeBlueX |
| 声音设计基准仓库 | https://github.com/breezeblue-ai/tts-voice-design-benchmark |
| 声音指导基准仓库 | https://github.com/breezeblue-ai/TTS-Voice-Direction-Benchmark |
| 延迟评测基准仓库 | https://github.com/breezeblue-ai/TTS-Latency-Benchmark |
二、模型简介与核心能力
2.1 这是什么
Breeze TTS 2 是 BreezeBlue 于 2026 年 8 月 25 日 开源的开放权重(Open Weights)文本转语音模型,规模 30 亿参数(3B),单模型同时支持中文和英文自然语音合成。
它的设计目标是实时语音交互:不仅合成质量高,而且响应快(首包音频延迟极低)、表现力强(可以自然描述让 AI "演"出某种声音),还能在文本里直接插入笑声、叹气等人类发声事件。
2.2 四大核心能力
| 能力 | 英文名 | 说明 |
|---|---|---|
| 🎙️ 声音克隆 | Voice Clone | 上传一段干净参考音频 + 其准确文字稿,即可复刻说话人的音色、节奏、情绪和表达风格 |
| 🎨 声音设计 | Voice Design | 无需任何参考音频,只用一句自然语言描述(如"一位温柔自信的年轻女性,声音清晰")就能凭空设计出符合特征的声音 |
| 🎛️ 声音指导 | Voice Direction | 基于参考音频克隆音色的同时,用文本指令控制语气、情绪、语速和表达方式(声音克隆 + 导演指导二合一) |
| 🎭 人声事件 | Vocal Events | 直接在文本里插入发声事件标记:英文用圆括号 (laugh),中文用方括号 [笑],让 AI 发出笑声、咳嗽、清嗓、叹气 |
2.3 性能亮点(官方数据)
- 榜单第一:Artificial Analysis TTS Elo 榜开放权重模型第 1 名,并超越部分头部闭源系统;
- 超低延迟:预热 Fast 路径 + NVIDIA H100 上,首音频时间(TTFA)< 40ms;
- 实时流式:实时因子(RTF)达 0.32,即生成速度约为实时速度的 3.1 倍;
- 显存友好:Eager 推理约占用 7.7 GiB 显存,推荐 12GB 显卡起步;Fast 全加速约 14.4 GiB,推荐 24GB 显卡;
- 中英双语:单模型覆盖中英文。
2.4 官方排行榜图
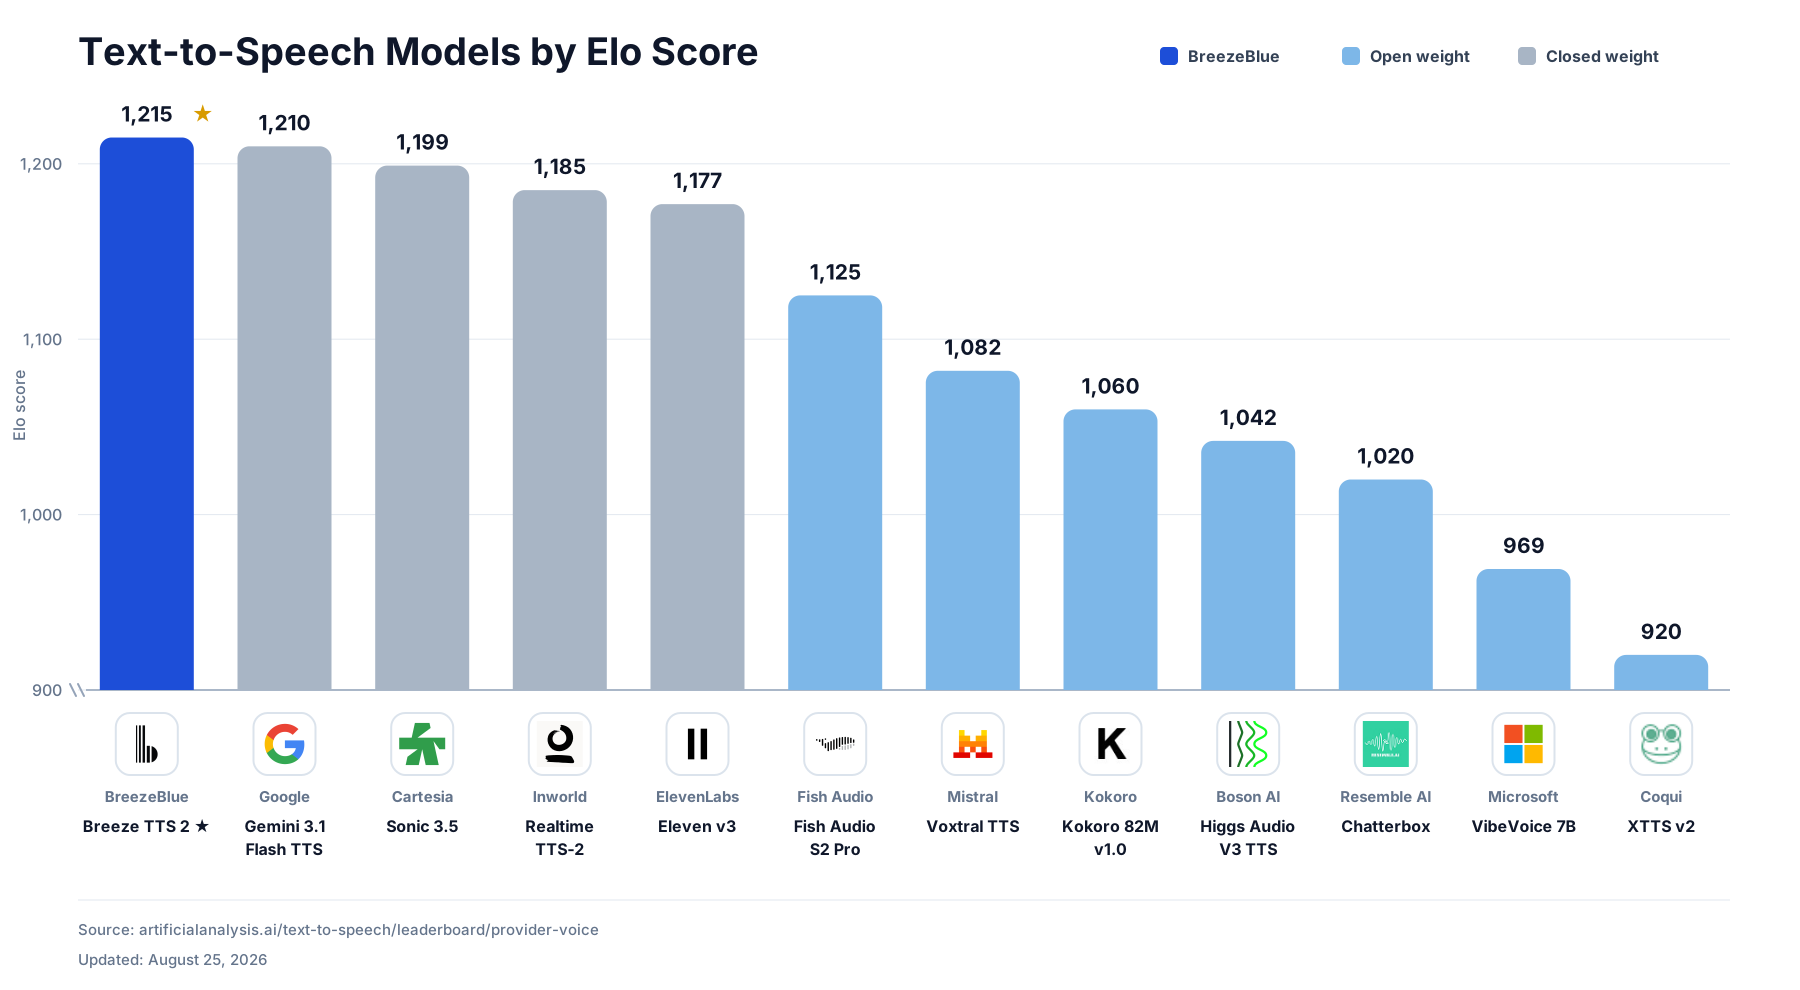
图注:Text-to-speech models ranked by Artificial Analysis Elo score —— Breeze TTS 2 在开放权重模型中位列第一(官方图)。
三、硬件环境要求
3.1 官方要求(必须满足)
| 项目 | 要求 |
|---|---|
| 操作系统 | Linux(Windows 建议使用 WSL2 Ubuntu) |
| Python | 3.10 或更高 |
| GPU | NVIDIA CUDA 显卡(不支持 AMD 原生加速) |
| 显存 | Eager 推理约 7.7 GiB(最低推荐 12GB 显卡);--fast-all 全加速约 14.4 GiB(推荐 24GB 显卡) |
| 驱动 | 支持 CUDA 12.8 的 NVIDIA 驱动环境 |
3.2 不同场景建议配置
| 场景 | 推荐显卡 |
|---|---|
| Eager 普通推理(本地体验) | RTX 3060 12G / 4060 16G / 3070 等 12GB+ 显卡 |
| Fast 快速推理(实时对话产品) | RTX 3090 / 4090 / 5070 等 24GB 显卡 |
| 批量离线合成 | 按批大小逐步加大显存,从 12GB 起步 |
⚠️ 纯 Windows 原生环境跑 CUDA 依赖较容易出问题,官方只保证 Linux;Windows 用户请用 WSL2 + Ubuntu。不支持 Mac / AMD / Intel 显卡的 CUDA 加速。
四、完整部署步骤
4.1 下载推理源码
git clone https://github.com/breezeblue-ai/breeze-tts.git
cd breeze-tts
不想用 git 也可以直接下载 ZIP: https://github.com/breezeblue-ai/breeze-tts/archive/refs/heads/main.zip,解压后
cd breeze-tts-main。
4.2 创建 Python 虚拟环境(推荐)
# 用 conda 创建 Python 3.10 环境(conda 没有则用 python -m venv)
conda create -n breeze python=3.10 -y
conda activate breeze
4.3 安装依赖
python -m pip install -r requirements.txt
依赖清单(官方 requirements.txt,版本已锁定):
| 依赖 | 版本 |
|---|---|
| torch | 2.9.1 |
| torchaudio | 2.9.1 |
| qwen-tts | 0.1.1(音频分词器,源自阿里 Qwen3-TTS,Apache 2.0) |
| transformers | 4.57.3 |
| huggingface-hub | >=0.34 |
| numpy | >=2.0 |
| soundfile | >=0.13 |
| fastapi / uvicorn | API 服务用 |
| python-multipart | 文件上传用 |
模型全部组件(分词器、骨干、解码器等)都包含在 Breeze TTS 2 权重包内,无需单独下载其他组件。
4.4 下载模型权重
方式 A:HuggingFace 网页下载
打开 https://huggingface.co/BreezeBlue/breeze-tts-2,点 "Files" 标签页,下载全部 safetensors 文件到一个本地目录(例如 ../breeze-tts-2)。
方式 B:命令行下载(推荐,自动进 HF 缓存)
推理命令直接传 HuggingFace 仓库 ID,运行时自动下载到标准缓存目录:
python infer.py BreezeBlue/breeze-tts-2 --text "你好,世界" ...
方式 C:huggingface-cli 下载到本地目录
pip install -U huggingface_hub
huggingface-cli download BreezeBlue/breeze-tts-2 --local-dir ./breeze-tts-2
五、模型权重获取方式(续)
infer.py / API 的 model 参数支持两种写法:
| 写法 | 说明 |
|---|---|
BreezeBlue/breeze-tts-2 |
Hugging Face 仓库 ID,自动下载进缓存;可加 --revision main 固定分支/标签/提交 |
/本地/路径/breeze-tts-2 |
本地权重目录(方式 A/C 下载后) |
六、使用方法:四种核心玩法
6.1 🎙️ 声音克隆(Voice Clone)
原理:传入参考音频 + 参考音频的准确文字稿,模型提取音色、节奏、情绪与风格,并让目标文本"说出"同一人的声音。
英文示例:
python infer.py ../breeze-tts-2 \
  --ref-audio reference_en.wav \
  --ref-text "This is the exact transcript of the English reference audio." \
  --text "(sigh) It is good to hear your voice again after all this time." \
  --output outputs/voice_clone_en.wav
中文示例:
python infer.py ../breeze-tts-2 \
  --ref-audio reference_zh.wav \
  --ref-text "这是中文参考音频的准确文字稿。" \
  --text "[叹气] 没想到过了这么久,你还记得我的声音。" \
  --output outputs/voice_clone_zh.wav
要点:
- 参考音频需干净、非循环、背景噪声尽量少;
- --ref-text 必须与参考音频的完整说话内容逐字一致;音频里如果重复说了某句话,文字稿里也要重复;
- 纯克隆不传 --instruction;一旦加了 --instruction 就自动变成「声音指导」(见 6.3)。
6.2 🎨 声音设计(Voice Design)
原理:不提供任何参考音频,仅用一段自然语言描述,从零"设计"出一个声音。描述语言建议与目标文本语言一致。可用 --cfg-scale 4 强化指令遵循度。
英文示例:
python infer.py ../breeze-tts-2 \
  --text "(sigh) Welcome aboard. Your journey begins now." \
  --instruction "A warm, thoughtful young woman with a clear voice and a calm, reflective delivery." \
  --cfg-scale 4 \
  --output outputs/voice_design_en.wav
中文示例:
python infer.py ../breeze-tts-2 \
  --text "[笑] 欢迎来到今晚的故事时间,让我们一起开始吧。" \
  --instruction "一位温柔自信的年轻女性,声音清晰,语气亲切,表达轻快而富有感染力。" \
  --cfg-scale 4 \
  --output outputs/voice_design_zh.wav
常用中文声音描述参考:
| 描述词 | 效果 |
|---|---|
| 温柔 / 沉稳 / 活泼 / 高冷 | 基础音色气质 |
| 声音清晰、字正腔圆 | 播音腔 |
| 语速轻快、抑扬顿挫 | 节奏控制 |
| 亲切、有感染力 | 情感浓度 |
| 深夜电台感、娓娓道来 | 氛围感 |
| 清脆的少年音 / 浑厚的男中音 | 具体音域 |
6.3 🎛️ 声音指导(Voice Direction)
原理:保留参考说话人身份,同时用指令导演其语气、情绪、节奏、表达。--cfg-scale 4 强化指令遵循。
python infer.py ../breeze-tts-2 \
  --ref-audio reference.wav \
  --ref-text "This is the exact transcript of the reference audio." \
  --text "(clears throat) We need to discuss what happened last night." \
  --instruction "Speak slowly with a restrained, serious tone." \
  --cfg-scale 4 \
  --output outputs/voice_direction.wav
声音克隆与声音指导的区别:克隆 = 只复刻参考音色,不加额外指令;指导 = 复刻音色 + 用自然语言指挥它怎么说话。
6.4 🎭 人声事件标记(Vocal Events)
在文本里直接插入事件标签,让合成语音"发出"对应的人声动作:
| 语言 | 写法 | 效果 |
|---|---|---|
| 英文 | (laugh) |
笑 |
| 英文 | (cough) |
咳嗽 |
| 英文 | (clears throat) |
清嗓子 |
| 英文 | (sigh) |
叹气 |
| 中文 | [笑] |
笑 |
| 中文 | [咳嗽] |
咳嗽 |
| 中文 | [清嗓子] |
清嗓子 |
| 中文 | [叹气] |
叹气 |
七、流式 API 部署与调用
7.1 启动流式 API 服务
默认单并发流式 API,走 PyTorch 运行时、Eager 执行:
python -m breeze_infer.api ../breeze-tts-2 --host 0.0.0.0 --port 7860
使用 HuggingFace 仓库 ID + 固定分支:
python -m breeze_infer.api BreezeBlue/breeze-tts-2 --revision main --host 0.0.0.0 --port 7860
开启 Fast 全加速:
python -m breeze_infer.api ../breeze-tts-2 --host 0.0.0.0 --port 7860 --fast-all
7.2 调用:声音指导 + CFG 4(含参考音频)
curl -X POST http://127.0.0.1:7860/v1/audio/speech \
  -F "cfg_scale=4" \
  -F "ref_audio=@reference.wav" \
  -F "ref_text=This is the exact transcript of the reference audio." \
  -F "text=(clears throat) We need to discuss what happened last night." \
  -F "instruction=Speak slowly with a restrained, serious tone." \
  -F "seed=42" \
  --output voice_direction.pcm
7.3 调用:纯声音设计(无参考音频)
curl -X POST http://127.0.0.1:7860/v1/audio/speech \
  -F "cfg_scale=4" \
  -F "text=[笑] 欢迎来到今晚的故事时间。" \
  -F "instruction=一位温柔自信的年轻女性,声音清晰,语气亲切。" \
  -F "seed=42" \
  --output voice_design.pcm
7.4 响应格式说明
- 响应体为流式输出的单声道 24kHz 16 位有符号小端 PCM(
s16le); - 后续播放/转码可用 ffmpeg:
ffmpeg -f s16le -ar 24000 -ac 1 -i voice_direction.pcm out.wav; - 服务端同时提供
GET /v1/model查看加载的模型信息与服务端限制(见 8.3)。
八、批量合成 API(Batch)
8.1 批量请求
一次请求可提交最多 128 条文本,服务端按顺序逐条解码合成。由于解码受显存带宽限制,批量一次合成比逐条请求快得多:
curl -X POST http://127.0.0.1:7860/v1/audio/speech/batch \
  -F 'texts=["The first sentence.", "The second sentence."]' \
  -F "instruction=A calm, clear narrator." \
  -F "cfg_scale=4" \
  -F "seed=42" \
  -F "max_new_tokens=600" \
  --dump-header headers.txt \
  --output batch.pcm
8.2 批量参数说明
texts:JSON 数组,最多 128 个非空字符串;instruction/cfg_scale/ref_audio+ref_text/seed:与单条接口行为一致,作用于每条文本;max_new_tokens:服务端上限 1500,超出会被钳制到上限;- 响应体 = 所有段落按请求顺序拼接的 PCM;响应头
X-Segment-Bytes以逗号分隔每段的字节数,用于切回独立段落。
8.3 批量注意事项
- 批量显存随批大小和序列长度增长,从最小批开始逐步加大,以适配你的显卡(官方 7.7GiB/12GB 建议针对单请求 Eager,不适用于 128 条批量);
- 批量支持把备份权重放在 CPU,不影响单请求推理的显存占用;
- CFG(
cfg_scale != 1)批量会用 CUDA Graph 加速深度解码;首个同批大小的请求包含一次图捕获开销;纯克隆cfg_scale=1不建批图; - 批量与流式请求共享单个推理槽:有其他请求运行时再发会返回
409; GET /v1/model返回:frame_rate(帧率,用于估max_new_tokens)、model_digest(权重 SHA-256 校验值)、max_new_tokens、max_batch_texts。
九、Fast 快速推理选项
CLI 与 API 默认都是 Eager 流式,跳过图预热。加 --fast-all 可一次性启用全部加速阶段(代价是启动预热更慢,适合常驻服务)。
各阶段可独立控制:
| 推理阶段 | 独立参数 | 关闭(默认) | 开启 |
|---|---|---|---|
| 文本编码器 | --[no-]fast-text-encoder |
原生 Eager 前向 | 按 CFG 形状与文本长度桶的静态 CUDA Graph |
| 骨干 Prefill | --[no-]fast-backbone-prefill |
原生 Eager prefill | 按 CFG 形状与提示长度桶的 CUDA Graph |
| 骨干解码 | --[no-]fast-backbone-decode |
原生 Eager token 步进 | StaticCache 支撑的图(按 CFG 形状) |
| 深度解码器 | --[no-]fast-depth-decoder |
原生 Eager 深度循环 | CFG 形状 CUDA Graphs 的全图编译 |
| 编解码器 | --[no-]fast-codec |
Eager 流式解码 | 单请求流式 CUDA Graph(一帧一块) |
单个阶段参数主要用于性能分析与调试;日常使用直接
--fast-all。
十、Docker 容器化部署
官方提供了现成 Docker 构建脚本(基于公共 PyTorch 2.9.1 + CUDA 12.8 开发镜像,从源码编译 FlashAttention 2.8.3)。
10.1 构建镜像
cd breeze-tts
bash docker/build.sh
- 默认 FlashAttention 目标为 H100/Hopper(sm90);
- A100 等 80 架构构建:
FLASH_ATTN_CUDA_ARCHS=80 bash docker/build.sh
10.2 运行容器(本地模型目录 + Fast 模式)
bash docker/run.sh /path/to/breeze-model --fast-all
- 模型目录以只读方式挂载进容器(
/models/breeze),不会复制进镜像; - 容器发布 7860 端口到宿主机;
- 构建过程会跑导入/版本冒烟检查与 CPU 安全单元测试;GPU 图捕获只在显式启用 fast 阶段且有 NVIDIA GPU 时发生。
十一、常见问题排查
| 问题 | 原因与处理 |
|---|---|
CUDA error: no kernel image is available |
显卡架构与编译目标不符:A100 等需 FLASH_ATTN_CUDA_ARCHS=80 重新构建 Docker,或确认本地 CUDA 版本(需 CUDA 12.8 兼容环境) |
| 显存不足 OOM | Eager 需约 7.7GiB,Fast 约 14.4GiB;批量合成显存随批大小增长,减小批量或关闭 --fast-all 部分阶段 |
| Windows 安装 torch/CUDA 报错 | 官方仅支持 Linux;Windows 请改用 WSL2 Ubuntu,不要尝试原生跑 CUDA 栈 |
| 克隆声音不像 / 不对 | 参考音频必须干净、非循环、噪声小;--ref-text 必须与音频逐字一致(含重复语句) |
| 指令不生效 | 声音设计/指导建议加 --cfg-scale 4 强化指令遵循;描述语言尽量与目标文本语言一致 |
| 输出是 .pcm 无法直接播放 | API 返回 24kHz 单声道 s16le PCM,用 ffmpeg 转 wav/mp3 |
| 模型下载慢/失败 | 换 huggingface-cli download BreezeBlue/breeze-tts-2 --local-dir ./breeze-tts-2 断点续传;或从网页手动下载 |
| 想商用 | 自托管输出受研究/非商用许可约束,不允许直接商用;商用请用 BreezeBlue 付费托管平台 API(见 12) |
十二、许可证与合规说明
- 推理源代码:Apache License 2.0;
- 音频分词器:基于阿里 Qwen 团队 Qwen3-TTS,Apache License 2.0;
- 模型权重 / 检查点 / 适配器 / 衍生模型 / 自托管输出:适用 BreezeBlue 研究与非商业许可证(https://huggingface.co/BreezeBlue/Breeze-TTS-2/blob/main/LICENSE)——仅供研究与个人非商用,Apache 2.0 不授予商业使用权;
- 商用途径:订阅 BreezeBlue 付费托管平台/API(https://breezeblue.ai/)生成的输出可按其服务条款商用;但付费订阅不授予开放权重模型或自托管输出的商业权利;
- 责任:禁止未经授权的语音克隆、冒充、欺诈及其他违法或有害用途;你对输入材料、参考音频、语音与输出内容的合规性负责。
十三、参考链接汇总
项目主链
官方文档细分
| 文档 | 链接 |
|---|---|
| SDK 快速上手 | https://docs.breezeblue.ai/quickstart |
| TTS 使用指南 | https://docs.breezeblue.ai/guides/text-to-speech |
| 实时 TTS 指南 | https://docs.breezeblue.ai/guides/realtime-text-to-speech |
| CLI 安装 | https://docs.breezeblue.ai/cli |
| CLI TTS 参考 | https://docs.breezeblue.ai/cli/reference/tts |
基准与社区
免责声明:本文所有命令、参数、数据均整理自官方 GitHub 仓库 README、Docker 文档与 BreezeBlue 官方文档,如官方更新请以仓库最新版本为准。模型权重许可为研究/非商用,请务必阅读并遵守上游许可证。