

GPT Researcher:开源深度研究 Agent,自动生成带引用的研究报告|部署与使用全指南
仓库:https://github.com/assafelovic/gpt-researcher 许可证:Apache 2.0 语言:Python 3.12+ / Next.js 容器化:Docker Compose 默认端口:后端 8000、前端 3000
1. 项目简介
GPT Researcher 是首个开源的深度研究 Agent,可在 Web 与本地文档上围绕任意任务自动检索、归纳并生成带引用的研究报告。它采用 planner / execution / publisher 多 Agent 协作:planner 把研究问题拆解为子问题,execution Agent 并行抓取网页与本地文档,publisher 汇总成 2000 字以上、带引用源的报告。项目在 Apache 2.0 下开源,官方定位为"实验性应用,仅供学术参考"。
1.1 核心信息一览
| 项目 | 说明 |
|---|---|
| 名称 | GPT Researcher |
| 仓库 | assafelovic/gpt-researcher |
| 定位 | 开源深度研究 Agent,自动检索并生成带引用的研究报告 |
| 许可证 | Apache 2.0 |
| 语言 / 框架 | Python 3.12+、FastAPI、Next.js + Tailwind |
| 部署方式 | 源码运行 / Docker Compose / pip 包 / Claude Skill |
| 默认端口 | Python 后端 8000,React 前端 3000 |
| 系统入口 | http://localhost:3000(前端)或
http://localhost:8000(轻量前端) |
1.2 适用场景
- 围绕一个主题自动做 Web 调研并产出客观报告,替代人工翻十几篇网页。
- 基于本地 PDF / Word / Markdown / Excel / PPT 文档做私有 RAG 研究。
- 作为 Python
库嵌入到自己的自动化研究流水线中(
pip install gpt-researcher)。 - 作为 Claude
Skill(
npx skills add assafelovic/gpt-researcher)在 Claude 对话中直接调用。
1.3 能力边界(官方口径)
- 官方自述为"实验性应用,按 AS-IS 提供",不构成学术建议,也不应直接作为论文引用来源。
- 报告质量依赖 LLM 模型与搜索 API(默认 Tavily),需要自备
OPENAI_API_KEY与TAVILY_API_KEY。 - Deep Research 模式单次约 5 分钟、官方估算约 0.4 美元(使用 o3-mini high reasoning)。
- 本地文档研究目前支持 PDF、纯文本、CSV、Excel、Markdown、PowerPoint、Word。
2. 功能特性
- 📝 基于 Web 与本地文档生成详细研究报告,单篇可超 2000 字。
- 🌐 自动聚合 20+ 来源,追求客观结论,而非只引用单一站点。
- 🎯 默认使用 TypeSafe Jev 做上下文过滤,无 API Key 时自动回退到本地 BM25 关键词排序。
- 🤝 多 Agent 协作:基于 LangGraph 与 AG2,从规划、检索、过滤到发布分工。
- 🌳 Deep Research:树状递归探索,可配置深度与广度,并发处理。
- 📂 维护研究过程中的记忆与上下文,支持 PDF / Word / Markdown 等多格式导出。
- 🖼️ 可选接 Google Gemini(Nano Banana)自动在报告中插入内联插图。
- 🔌 支持 MCP(Model Context Protocol),把 GitHub、数据库、自定义 API 作为研究数据源。
- 🖥️ 提供两套前端:FastAPI 自带轻量 HTML/CSS/JS 前端,以及生产级 Next.js + Tailwind 前端。
- 🔍 集成 LangSmith,用于复杂多 Agent 工作流的追踪与可观测性。
3. 官方界面预览
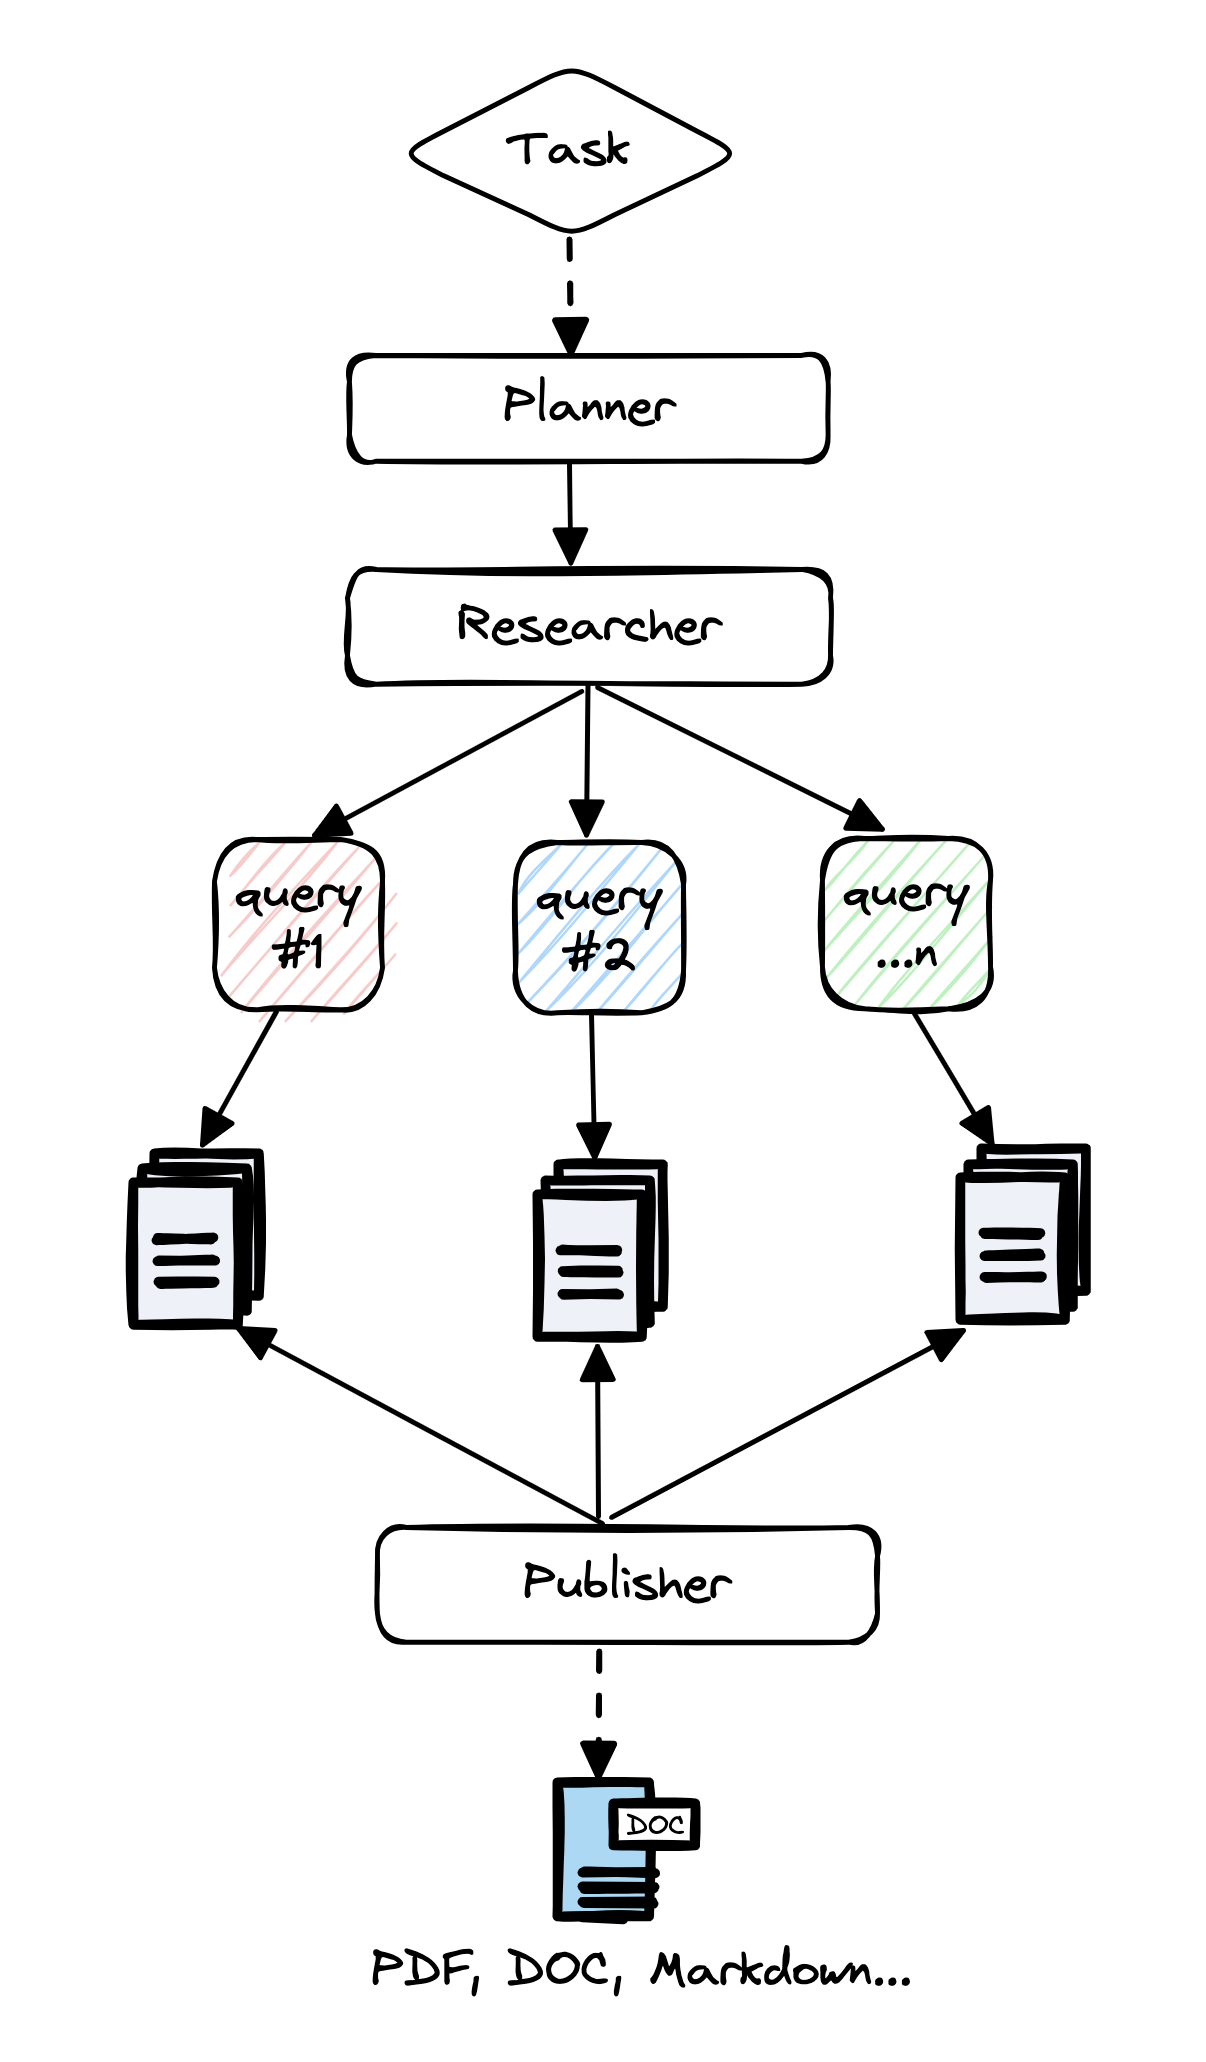
图为官方 README 给出的核心架构图:planner 基于研究 query 生成子问题,crawler Agent 逐题抓取并做来源追踪与摘要,最终汇总为研究报告。
4. 官方跳转链接汇总
- 仓库:https://github.com/assafelovic/gpt-researcher
- 官网:https://gptr.dev
- 文档:https://docs.gptr.dev
- Issues:https://github.com/assafelovic/gpt-researcher/issues
- Docker Hub:https://hub.docker.com/r/gptresearcher/gpt-researcher
- PyPI:https://pypi.org/project/gpt-researcher/
- Discord:https://discord.gg/QgZXvJAccX
- MCP 服务独立仓库:https://github.com/assafelovic/gptr-mcp
5. 前置要求与服务器配置
5.1 软件前提
- Python 3.12 或更高版本(源码 / pip 方式必须)。
- Docker 与 Docker Compose(容器方式推荐)。
- Node.js 18+(仅在跑 Next.js 前端源码时需要)。
- 至少一个 LLM API Key(默认 OpenAI 兼容,也可通过
OPENAI_BASE_URL指向本地模型)。 - 至少一个 Web 搜索 API Key(默认 Tavily)。
5.2 硬件与系统建议
- 本身不跑大模型,计算主要在 LLM API 与搜索 API,普通 1C2G 云主机即可启动服务。
- 若把
OPENAI_BASE_URL指向本机 Ollama / vLLM,则按所选模型的显存要求准备 GPU。
5.3 端口分配
| 端口 | 服务 | 说明 |
|---|---|---|
| 8000 | Python / FastAPI 后端 | 轻量前端与 API |
| 3000 | Next.js React 前端 | 容器默认启动时访问入口 |
5.4 磁盘与模型说明
- 项目代码本身很小;模型权重不下载到本地,由远端 LLM API 提供。
- 本地文档研究时,
DOC_PATH指向的目录会被读取,需预留对应磁盘空间。
6. 方式一:Docker / Compose 一键部署(推荐)
官方 README 给出的容器化流程如下。
第 1 步:安装 Docker(参见官方文档 getting-started-with-docker)。
第 2 步:克隆仓库并准备 .env:
git clone https://github.com/assafelovic/gpt-researcher.git
cd gpt-researcher
cp .env.example .env
编辑 .env,至少填入:
OPENAI_API_KEY=sk-你的OpenAI密钥
TAVILY_API_KEY=tvly-你的Tavily密钥
# 可选:指向本地或其他 OpenAI 兼容服务
# OPENAI_BASE_URL=http://localhost:8001/v1
第 3 步:按需在 docker-compose.yml
中注释掉不需要的服务,然后启动:
docker-compose up --build若系统只支持 Compose V2(短横杠形式),改用:
docker compose up --build第 4 步:访问。默认会同时启动两个进程:
- Python 后端:
http://localhost:8000 - React 前端:
http://localhost:3000
浏览器打开 http://localhost:3000 即可开始研究。
远程服务器部署时,请把 3000 与 8000 端口通过反向代理或安全组暴露,并按需配置鉴权;默认仅监听本机。
7. 方式二:源码 / 本地运行
7.1 源码运行
git clone https://github.com/assafelovic/gpt-researcher.git
cd gpt-researcher

# 导出 API Key(或写入 .env)
export OPENAI_API_KEY=你的OpenAI密钥
export TAVILY_API_KEY=你的Tavily密钥

# 安装依赖
pip install -r requirements.txt

# 启动 FastAPI 服务
python -m uvicorn main:app --reload
启动后访问 http://localhost:8000。
7.2 作为 pip 包嵌入代码
pip install gpt-researcherimport asyncio
from gpt_researcher import GPTResearcher
async def main():
query = "why is Nvidia stock going up?"
researcher = GPTResearcher(query=query)
await researcher.conduct_research()
report = await researcher.write_report()
print(report)
asyncio.run(main())7.3 作为 Claude Skill
npx skills add assafelovic/gpt-researcher安装后 Claude 可在对话中直接调用 GPT Researcher 的深度研究能力。
8. 配置项说明
下表整理自官方 README 与文档中提到的常用环境变量。
| 环境变量 | 用途 | 默认 / 示例 | 是否必填 |
|---|---|---|---|
OPENAI_API_KEY |
OpenAI 兼容 LLM 密钥 | sk-... |
必填(或改走其他 provider) |
OPENAI_BASE_URL |
自定义 OpenAI 兼容接口地址 | https://api.openai.com/v1 |
可选 |
TAVILY_API_KEY |
Tavily Web 搜索 API 密钥 | tvly-... |
推荐必填 |
RETRIEVER |
检索器组合,可挂 MCP | tavily,mcp |
可选 |
DOC_PATH |
本地文档研究目录 | ./my-docs |
本地文档模式时必填 |
TYPESAFE_API_KEY |
Jev 上下文过滤 API Key | 无则回退 BM25 | 可选 |
CONTEXT_FILTER |
上下文过滤策略 | auto / jev / keyword /
embeddings / none |
可选 |
IMAGE_GENERATION_ENABLED |
是否启用 Gemini 内联插图 | false |
可选 |
GOOGLE_API_KEY |
Gemini 插图密钥 | 无 | 启用插图时必填 |
IMAGE_GENERATION_MODEL |
插图模型 | models/gemini-2.5-flash-image |
可选 |
LANGCHAIN_TRACING_V2 |
开启 LangSmith 追踪 | true / false |
可选 |
LANGCHAIN_API_KEY |
LangSmith 密钥 | 无 | 开启追踪时必填 |
LANGCHAIN_PROJECT |
LangSmith 项目名 | gpt-researcher |
可选 |
.env.example
中还有更多检索器、模型、报告格式相关字段,部署时按官方仓库最新版本为准。
9. 常用运维命令
# 查看后端日志(docker-compose 方式)
docker compose logs -f

# 停止 / 重启
docker compose down
docker compose restart

# 拉取最新代码并重建
git pull
docker compose up --build -d

# 进入容器调试
docker compose exec backend bash

# 源码方式下查看 uvicorn 进程
ps -ef | grep uvicorn

# 更新 pip 包
pip install -U gpt-researcher
备份主要是 .env 与 DOC_PATH
目录下的本地文档;研究报告本身在运行时生成,可按需从前端导出 PDF / Word
/ Markdown。
10. 常见故障排查
http://localhost:3000打不开:确认docker compose ps中前端容器状态为Up;若只起了后端,说明在docker-compose.yml里把前端服务注释掉了。- 报告一直卡在"Researching":多为
TAVILY_API_KEY未配置或额度用尽;也可能是OPENAI_API_KEY失效。查看后端日志docker compose logs backend。 - 调用本地模型报错 401 / connection refused:检查
OPENAI_BASE_URL是否指向正确地址与端口;容器内localhost指向容器自身,需用宿主机内网 IP 或host.docker.internal。 - 本地文档研究读不到文件:确认
DOC_PATH指向的目录已挂载进容器,且进程有读权限。 - Jev 上下文过滤不生效:未配置
TYPESAFE_API_KEY时会自动回退到本地 BM25 关键词排序,这是预期行为,不是故障。 - Deep Research 成本超预期:Deep Research 单次约 5 分钟、官方估算约 0.4 美元(o3-mini high reasoning),频繁调用前先在小问题上试跑。
- 端口冲突:8000 或 3000 被占用时,改
docker-compose.yml中端口映射或停止占用进程。
11. 风险与合规说明
- 许可证:GPT Researcher 采用 Apache 2.0 许可证,可商用、可修改、可再分发,需保留版权与许可声明。
- 实验性定位:官方明确声明项目为实验性应用,"按 AS-IS 提供,不提供任何明示或暗示担保",报告"不构成学术建议,也不建议直接用于学术论文引用"。
- 数据隐私:研究过程会把问题与抓取到的网页内容发送给所配置的 LLM 与搜索 API;本地文档研究模式下,文档内容同样会发送给远端 LLM,涉密数据请确保走私有部署的 LLM。
- 第三方 API 成本:OpenAI / Tavily / Gemini / LangSmith 等均为第三方服务,调用费用与额度由对应平台计费,请自行在控制台设置用量告警。
- 模型版权:报告中引用的网页内容版权归原站点所有;对外发布报告时请遵守来源站点的 robots 与版权声明。
- 安全暴露:默认仅监听本机,生产环境请勿把 8000 / 3000 直接暴露公网,应放在反向代理之后并加鉴权。