

Firecrawl:面向 AI 智能体的网页检索/抓取/交互开源上下文 API|部署与使用全指南
Firecrawl 是 MendableAI(现组织名 firecrawl)开源的「把网页变成 LLM 可读上下文」的 API 服务,官方定位为 The context API for AI agents。它把搜索、单页抓取、整站爬取、URL 地图、批量抓取、浏览器内交互(点击/滚动/输入/等待)和 PDF/DOCX 解析统一在一套 HTTP 接口后面,自带代理轮换、反爬绕过、JS 渲染和 Markdown/JSON 结构化输出。除官方托管云外,核心服务按 AGPL-3.0 开源,可自托管。
1. 项目简介与定位
Firecrawl 解决的是「AI 智能体 / RAG 系统如何稳定、低 token 地拿到干净网页正文」这一问题。它不是一个给人看的爬虫框架,而是一个 HTTP API:你把 URL 交给它,它返回 Markdown、结构化 JSON、截图或提取字段。
1.1 核心信息一览
| 项目 | 内容 |
|---|---|
| 名称 | Firecrawl |
| 仓库 | https://github.com/firecrawl/firecrawl (原始入口 MendableAI/firecrawl 已重定向至 firecrawl 组织) |
| 定位 | AI 智能体上下文 API:搜索 / 抓取 / 整站爬取 / 浏览器交互 / 文档解析 |
| 许可证 | 核心服务 AGPL-3.0;各语言 SDK 与部分 UI 组件 MIT |
| 主要语言 | TypeScript(Node.js) |
| 部署方式 | 官方云 SaaS(api.firecrawl.dev)+ 源码自托管(Node.js + pnpm + Redis + PostgreSQL + RabbitMQ) |
| 默认云 API 端点 | https://api.firecrawl.dev |
| 在线 Playground | https://firecrawl.dev/playground |
1.2 适用场景
- 给 LLM / RAG 流水线喂「已经洗干净的 Markdown」,而不是让模型去读一坨 HTML。
- 让 Agent 在不知道具体 URL 的情况下,用一句 prompt 自动搜索、点进多个页面、抽取结构化字段。
- 批量把一个文档站或知识库整站爬成 Markdown,做向量库索引。
- 用
interact接口在无头浏览器里完成「搜索关键词 → 点第一个结果 → 抓价格」这类多步操作。
1.3 能力边界(官方口径)
- 官方宣称覆盖 96% 的 Web(含 JS 重度页面),P95 延迟 3.4s。
- 默认遵守
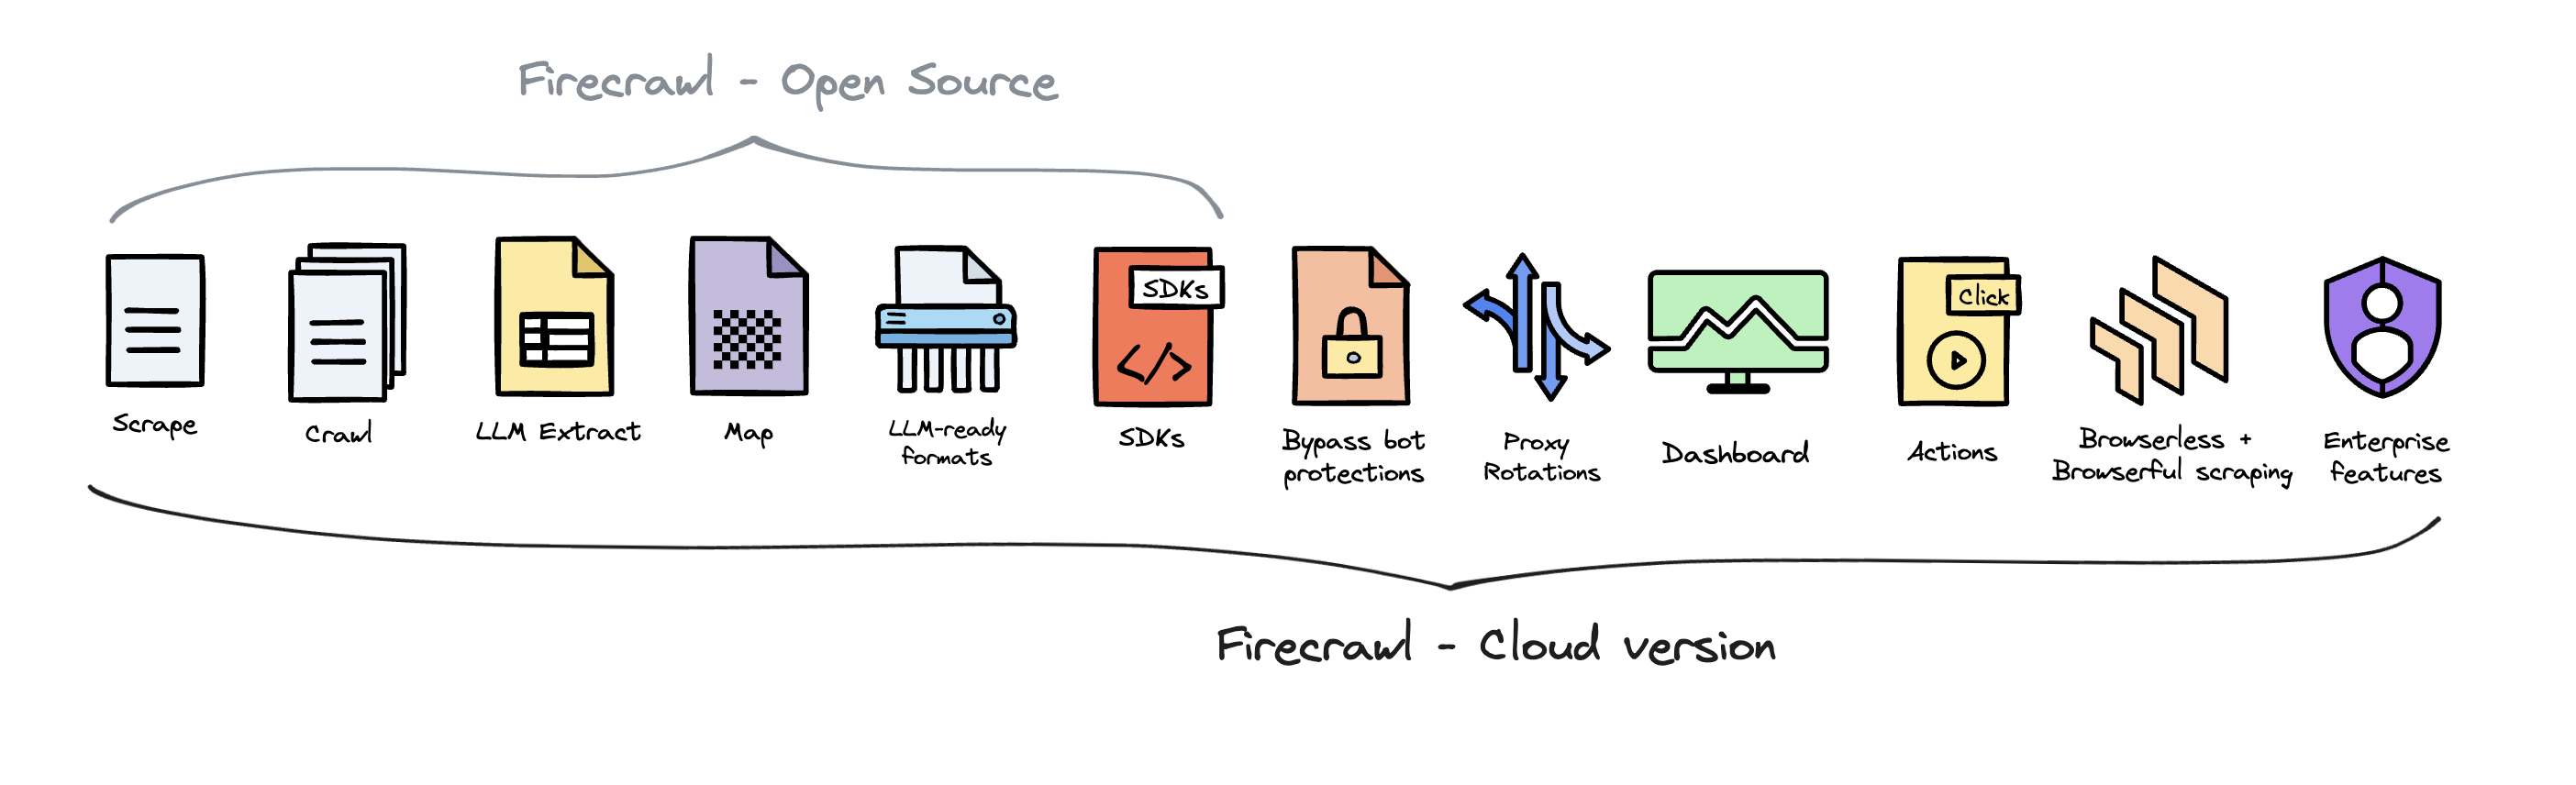
robots.txt;官方原文:By default, Firecrawl respects robots.txt directives. - 开源版与云版存在功能差异,下图来自官方 README:
2. 开源协议
核心服务采用 GNU Affero General Public License
v3.0(AGPL-3.0);仓库内的 SDK(Python / Node.js / Go / Java /
Rust / Ruby / .NET / PHP / Elixir)以及部分 UI 组件采用 MIT
License。具体子目录以该目录下 LICENSE
文件为准。
AGPL-3.0 意味着:如果你把 Firecrawl 核心服务作为网络服务对外提供,必须向你的用户公开修改后的源码。仅把它当成内部工具调用、不分发服务端,通常不触发开源义务;但商用 SaaS 对外暴露前,请法务确认。
3. 官方仓库与链接
- 仓库:https://github.com/firecrawl/firecrawl
- 文档站:https://docs.firecrawl.dev
- API Reference:https://docs.firecrawl.dev/api-reference/introduction
- Playground:https://firecrawl.dev/playground
- Self-Hosting 指南:https://docs.firecrawl.dev/contributing/self-host
- 本地开发指南:https://docs.firecrawl.dev/contributing/guide
- MCP Server:https://github.com/firecrawl/firecrawl-mcp-server
- Discord:https://discord.gg/firecrawl
4. 前置要求
4.1 仅使用官方云 API(推荐入门)
- 任意一台能访问外网的机器。
- 任意一种语言:Python ≥ 3.8 / Node.js ≥ 18 / Go / Java / Rust / Ruby / .NET / PHP / Elixir。
- 在 https://firecrawl.dev
注册账号拿到
fc-开头的 API Key。
4.2 源码自托管(来自官方 CONTRIBUTING.md)
- Node.js 22(官方本地开发指南指定版本)。
- pnpm 11.4.0。
- Redis:需要单独常驻运行。
- PostgreSQL 与 RabbitMQ:由 harness / Docker Compose 拉起,不需要手动安装。
- 操作系统:macOS / Linux(Windows 推荐 WSL2)。
- 磁盘:建议 ≥ 20GB,用于 Chromium 浏览器与缓存。
5. 安装部署
5.1 方式一:直接用官方云 API(零部署)
注册拿 Key 后,装任意一个 SDK 即可。以下命令原文抄自官方 README。
Python:
pip install firecrawlNode.js:
npm install firecrawlGo:
go get github.com/firecrawl/firecrawl/apps/go-sdkRuby:
gem install firecrawl-sdk.NET:
dotnet add package firecrawl-sdkPHP:
composer require firecrawl/firecrawl-sdk5.2 方式二:源码自托管(本地开发模式)
官方 CONTRIBUTING.md 给出的最小启动路径:
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl/apps/api
pnpm install
pnpm start
pnpm start 会构建 Firecrawl 并同时启动 API、worker
以及本地依赖容器;按官方文档另外单独把 Redis
跑起来。完整的自托管(不修改产品代码、直接部署到自己基础设施)流程见 https://docs.firecrawl.dev/contributing/self-host
,其中包含 Docker Compose 与环境变量清单。
官方明确提醒:本地开发使用
apps/api/.env,Docker Compose 自托管使用仓库根目录配置文件,两者的环境文件不要互相拷贝。
5.3 方式三:作为 MCP Server 挂到 Agent
npx -y firecrawl-cli@latest init --all --browser或者在 MCP 客户端配置里加:
{
  "mcpServers": {
    "firecrawl-mcp": {
      "command": "npx",
      "args": ["-y", "firecrawl-mcp"],
      "env": {
        "FIRECRAWL_API_KEY": "fc-YOUR_API_KEY"
      }
    }
  }
}
6. 最小示例代码
6.1 抓取单个 URL 为 Markdown(Python)
from firecrawl import Firecrawl

app = Firecrawl(api_key="fc-YOUR_API_KEY")

doc = app.scrape("https://firecrawl.dev", formats=["markdown"])
print(doc.markdown)
6.2 一句话让 Agent 自己去找数据(Python)
from firecrawl import Firecrawl

app = Firecrawl(api_key="fc-YOUR_API_KEY")

result = app.agent(prompt="Find the founders of Stripe")
print(result.data)
指定 effort 控制推理预算(原文表格):
| effort | 适用场景 |
|---|---|
low |
单站点简单查询 |
medium |
几个页面的多步任务 |
high |
深度研究、复杂导航、关键数据 |
所有 effort 等级底层都跑 spark-2 模型,effort
只改推理预算,不改模型。
6.3 整站爬取(cURL)
curl -X POST 'https://api.firecrawl.dev/v2/crawl' \
  -H 'Authorization: Bearer fc-YOUR_API_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "url": "https://docs.firecrawl.dev",
    "limit": 100,
    "scrapeOptions": { "formats": ["markdown"] }
  }'
返回一个 job id,再 GET 轮询
https://api.firecrawl.dev/v2/crawl/<id> 直到
status: completed。
6.4 CLI 一键抓取
npm install -g firecrawl-cli   # 或使用 npx
firecrawl scrape https://firecrawl.dev
firecrawl search "firecrawl" --limit 5
7. 配置项说明
7.1 SDK 客户端
| 配置 | 说明 |
|---|---|
api_key |
以 fc- 开头,必填;也可通过环境变量
FIRECRAWL_API_KEY 注入 |
| API 端点 | 默认
https://api.firecrawl.dev;自托管时改成自己的服务地址 |
7.2 Scrape 常用选项(README 列举)
| 选项 | 取值 | 含义 |
|---|---|---|
formats |
markdown / html / screenshot
/ json |
返回哪些格式,可多选 |
only_main_content |
bool | 只保留正文,去掉导航/页脚 |
actions |
数组 | 在抓内容前先执行点击/滚动/输入/等待等浏览器动作 |
7.3 Agent 选项
| 选项 | 含义 |
|---|---|
prompt |
自然语言描述你要找什么 |
urls |
可选,把 Agent 限定在指定几个页面内 |
schema |
用 Pydantic 模型约束输出为结构化 JSON |
effort |
low / medium / high |
7.4 自托管环境变量
完整变量表以官方 Self-Hosting 指南为准;CONTRIBUTING.md 明确提到
apps/api/.env 与根目录 Compose 配置是两套,不要混用。
8. 常见问题
Q1:免费额度多少?需要绑卡吗? 官方云在 https://firecrawl.dev 注册即送试用额度,具体配额以官网 Pricing 页为准。
Q2:抓不动的网站怎么办? 官方在 README
中列出的优先顺序:先看目标站点是不是要登录 / 付费墙;再用
actions
模拟用户操作;最后才考虑代理。自托管模式下反爬能力弱于云版(云版自带轮换代理池)。
Q3:可以拿来批量抓电商价格吗? 技术上可以,但官方 README 末尾声明:It is the sole responsibility of end users to respect websites' policies when scraping. 请先看目标站点 ToS 与 robots.txt。
Q4:本地起服务报缺 Redis? CONTRIBUTING.md 明确写:Redis 需要单独常驻运行,harness 只负责 PostgreSQL 与 RabbitMQ。
Q5:spark-1-pro / spark-1-mini
还能用吗? README
原文:旧名字为了向后兼容仍被接受,但已废弃,实际都会跑
spark-2。
9. 与同类工具对比
| 工具 | 形态 | 输出 | 反爬/代理 | 适合谁 |
|---|---|---|---|---|
| Firecrawl | HTTP API(云 + 自托管) | Markdown / JSON / 截图,Agent 模式 | 云版自带轮换代理与浏览器池 | AI 应用 / RAG 团队,想少写爬虫代码 |
| Crawlee(Python/TS) | 爬虫框架库 | 自定义存储(Dataset / Key-Value Store) | 自带会话与代理轮换,但要自己接 | 工程师想完全掌控抓取逻辑 |
| Browserless | 无头浏览器托管 | 原始 HTML / 截图 / PDF | 不直接做内容清洗 | 已经有 Puppeteer/Playwright 脚本,只想托管浏览器 |
Jina Reader (r.jina.ai) |
URL→Markdown 代理服务 | Markdown,带 frontmatter | 云版自带 | 给 LLM 喂单页正文,一行 URL 前缀搞定 |
| Trafilatura | Python 库 + CLI | 正文文本 / XML / JSON | 不带浏览器,纯 HTTP | 离线 HTML 批量清洗、语料构建 |
10. 许可
- 核心服务:AGPL-3.0。
- SDK 与部分 UI:MIT。
- 第三方组件(Chromium、Redis、PostgreSQL、RabbitMQ)遵循各自许可证。
- 使用官方云服务时,还需接受 firecrawl.dev 自身的服务条款。
11. 责任使用声明
使用 Firecrawl(无论云版还是自托管)抓取网页时,请务必遵守以下原则:
- 遵守目标网站的
robots.txt与服务条款(ToS),官方默认即按 robots.txt 工作,不要为了绕过而关闭。 - 控制并发、合理加延时,不要对小型站点造成流量压力。
- 不要绕过登录墙、付费墙或验证码去获取本应对付费用户开放的内容。
- 不要批量抓取个人隐私数据(手机号、邮箱、身份证、住址等)。
- 仅将公开数据用于合法的研究、产品功能与个人学习目的。
- 尊重原作者版权,二次发布抓取内容时遵守原站点的转载授权要求。