
DeepSeek-V3 是 DeepSeek 开源的高性能混合专家(MoE)语言模型,总参数 671B,每 token 激活 37B。它在 DeepSeek-V2 的 MLA(Multi-head Latent Attention)与 DeepSeekMoE 架构基础上,首次提出无辅助损失的负载均衡策略,并引入多 token 预测(MTP)训练目标,用仅 2.788M H800 GPU 小时完成全流程训练,性能对标顶尖闭源模型。
一、项目官方信息
| 项目 | 信息 |
|---|---|
| GitHub 仓库 | https://github.com/deepseek-ai/DeepSeek-V3 |
| 官方网站 | https://www.deepseek.com |
| 在线对话 | https://chat.deepseek.com |
| Hugging Face | https://huggingface.co/deepseek-ai |
| 论文 | https://arxiv.org/abs/2412.19437 |
| 开源协议 | 代码 MIT;模型遵循 Model License(支持商用) |
| 主要语言 | Python(约 100%) |
| Star 数 | 约 105k |
二、官方图片
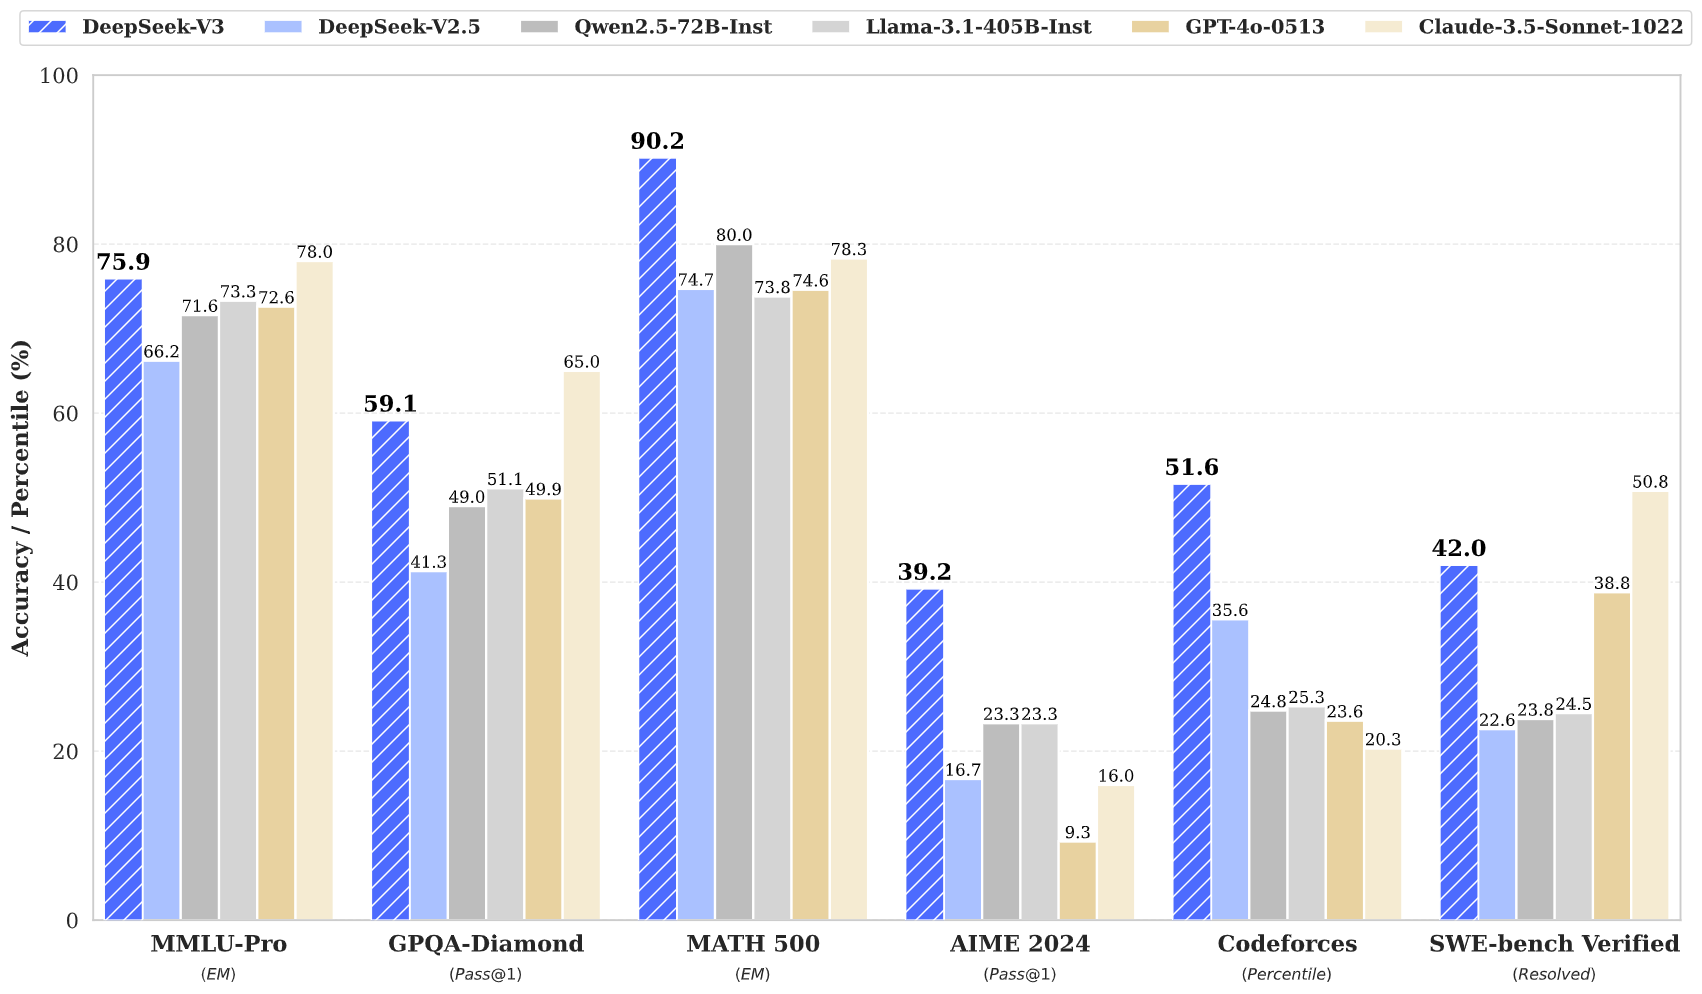
DeepSeek-V3 在各基准上与 GPT-4o、Claude-3.5-Sonnet 等闭源模型的对比:
三、环境要求
- 模型权重:HF 上总共 685B(主模型 671B + MTP 模块 14B),需 TB 级磁盘。
- 官方 Demo:Linux + Python 3.10;依赖 torch==2.4.1、triton==3.0.0、transformers==4.46.3、safetensors==0.4.5;不支持 Mac/Windows。
- 完整 671B 模型需多卡 H800/A100,BF16 约需 8×80GB 起。
- FP8 权重为默认;如需 BF16 权重,用仓库转换脚本。
四、完整部署步骤
1. 克隆仓库
git clone https://github.com/deepseek-ai/DeepSeek-V3.git
cd DeepSeek-V3/inference
2. 安装依赖
pip install -r requirements.txt
推荐用 conda 或 uv 建虚拟环境。
3. 下载权重
从 Hugging Face 下载:
- DeepSeek-V3-Base:https://huggingface.co/deepseek-ai/DeepSeek-V3-Base
- DeepSeek-V3:https://huggingface.co/deepseek-ai/DeepSeek-V3
放到 /path/to/DeepSeek-V3。
4. 权重格式转换(DeepSeek-Infer Demo)
python convert.py --hf-ckpt-path /path/to/DeepSeek-V3 \
  --save-path /path/to/DeepSeek-V3-Demo \
  --n-experts 256 --model-parallel 16
5. 转换 FP8 为 BF16(可选)
cd inference
python fp8_cast_bf16.py --input-fp8-hf-path /path/to/fp8_weights \
  --output-bf16-hf-path /path/to/bf16_weights
6. 启动 Demo(多节点)
交互式对话:
torchrun --nnodes 2 --nproc-per-node 8 --node-rank $RANK --master-addr $ADDR \
  generate.py --ckpt-path /path/to/DeepSeek-V3-Demo \
  --config configs/config_671B.json \
  --interactive --temperature 0.7 --max-new-tokens 200
批量推理:
torchrun --nnodes 2 --nproc-per-node 8 --node-rank $RANK --master-addr $ADDR \
  generate.py --ckpt-path /path/to/DeepSeek-V3-Demo \
  --config configs/config_671B.json --input-file $FILE
7. 用 SGLang 部署(推荐)
SGLang v0.4.1 起在 NVIDIA 与 AMD GPU 上完整支持 BF16/FP8、MLA 优化、DP Attention、FP8 KV Cache,多卡张量并行。启动命令见 SGLang 官方 DeepSeek-V3 指南:https://github.com/sgl-project/sglang/tree/main/benchmark/deepseek_v3
8. 用 vLLM 部署(推荐)
vLLM v0.6.6 起支持 FP8/BF16、张量并行与流水线并行,可跨多机:
from vllm import LLM, SamplingParams
llm = LLM(model="deepseek-ai/DeepSeek-V3", tensor_parallel_size=8, max_model_len=32768)
五、使用方法
官方支持的推理框架
README 列出以下官方推荐方式:
- DeepSeek-Infer Demo:FP8/BF16 轻量演示;
- SGLang:BF16/FP8 全支持,NVIDIA+AMD;
- LMDeploy:高效 FP8/BF16;
- TensorRT-LLM:BF16 与 INT4/8 量化;
- vLLM:FP8/BF16,张量/流水线并行;
- LightLLM:单机/多机;
- AMD GPU:通过 SGLang;
- 华为昇腾 NPU:MindIE 框架 BF16。
在线 API
DeepSeek 平台提供 OpenAI 兼容 API:https://platform.deepseek.com 。
关键性能
- 上下文:128K;
- 预训练:14.8T tokens;
- MMLU 87.1、MATH 61.6、HumanEval 65.2(Base);
- Chat 模型 MMLU-Pro 75.9、LiveCodeBench 40.5、AIME 2024 39.2。
六、常见问题 FAQ
1. 能用 HuggingFace Transformers 直接跑吗? README 明确说 Transformers 尚未直接支持,用上面的专用框架。
2. 为什么只给 FP8 权重?
官方原生 FP8 训练;需要 BF16 用 fp8_cast_bf16.py 转换。
3. 671B 一张卡够吗? 不够;BF16 需多卡多机,张量并行 + 流水线并行。
4. MTP 模块有什么用? 多 token 预测模块共 14B,可用于投机解码加速;社区支持在开发中。
5. 支持商用吗? 代码 MIT;模型遵循 Model License,支持商用。
6. 与 R1 关系? DeepSeek-V3 是基座;R1 基于 V3-Base 做大规模 RL 后训练。