

CosyVoice:多语言与中文方言实时语音合成,零样本声音克隆、情感指令与流式 TTS 部署指南|部署与使用全指南
项目仓库: https://github.com/FunAudioLLM/CosyVoice
开源协议:代码 Apache 2.0(模型权重协议以各 ModelScope / HuggingFace
模型卡为准) · 开发语言:Python(PyTorch) · 交付形态:Python
SDK、Gradio WebUI、gRPC 服务、FastAPI 服务、vLLM 加速推理、Triton +
TensorRT-LLM 加速方案 · 服务端口:WebUI 源码默认
8000(README 示例显式 50000),gRPC / FastAPI
默认 50000 · 官方演示站:Fun-CosyVoice 3.0 ·
CosyVoice 2.0 ·
CosyVoice 1.0
非官方声明:本文依据官方 README、
requirements.txt、example.py、webui.py、runtime/python/grpc与runtime/python/fastapi服务端 / 客户端源码、vllm_example.py及runtime/triton_trtllm文档整理部署步骤,属于第三方学习部署指南,不是阿里巴巴 / FunAudioLLM 官方发布的运维文档。CosyVoice 是 FunAudioLLM 语音 AI 工具家族的开源组件;项目名称、模型名称与第三方商标归各自权利人所有。API Key、模型下载账号与平台服务条款由对应提供者约束,使用者须自行确认合规边界。
1 项目简介
CosyVoice 是阿里巴巴 FunAudioLLM
团队基于**大语言模型(LLM)**构建的开源语音合成(Text-to-Speech,
TTS)系统,仓库当前同时维护三代模型:Fun-CosyVoice
3.0(Fun-CosyVoice3-0.5B-2512,最新版)、CosyVoice
2.0(CosyVoice2-0.5B,流式)与 CosyVoice
1.0(CosyVoice-300M 系列,含 SFT 与 Instruct
版本)。官方 README 将 Fun-CosyVoice 3.0 定位为面向"野生(in the
wild)"场景的零样本多语言语音合成系统,在前代基础上提升了内容一致性、说话人相似度与韵律自然度。
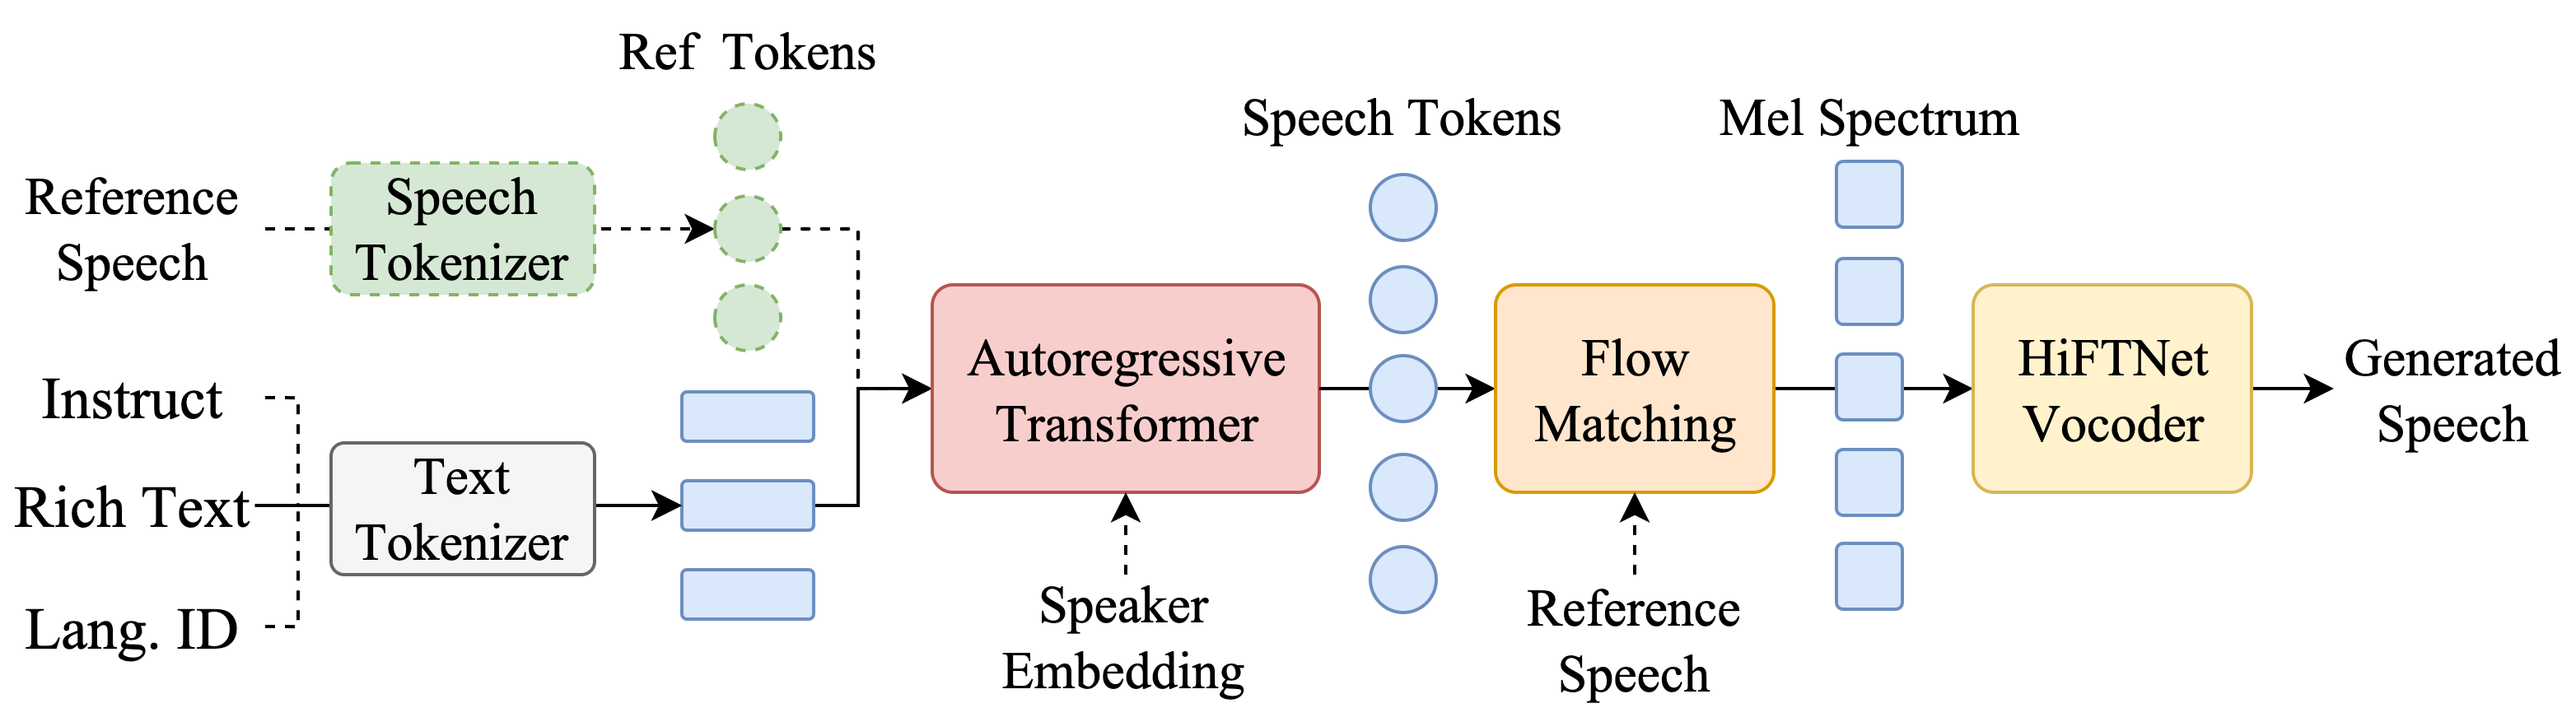
官方推理链路可以概括为:参考语音与指令分别经过语音 Tokenizer / 文本 Tokenizer,送入自回归 Transformer 得到 Speech Tokens,再由 Flow Matching 生成 Mel 频谱,最后经 HiFTNet 声码器(Vocoder)输出合成语音;说话人嵌入参与自回归阶段,参考语音参与 Flow Matching 阶段(即图1 官方架构示意)。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | CosyVoice(最新模型线 Fun-CosyVoice 3.0) |
| 仓库地址 | github.com/FunAudioLLM/CosyVoice |
| 项目定位 | 基于大语言模型的多语言、零样本、流式开源语音合成系统 |
| 开源协议 | 代码 Apache 2.0;模型权重协议以对应 ModelScope / HuggingFace 模型卡为准 |
| 论文 | v1 arXiv:2407.05407;v2 arXiv:2412.10117;v3 arXiv:2505.17589;ICASSP 2025 工程论文 |
| 开发语言 / 框架 | Python 3.10、PyTorch 2.3.1、torchaudio 2.3.1、transformers 4.51.3、Gradio 5.4.0、FastAPI 0.115.6、gRPC 1.57.0 |
| 模型清单 | Fun-CosyVoice3-0.5B-2512、CosyVoice2-0.5B、CosyVoice-300M、CosyVoice-300M-SFT、CosyVoice-300M-Instruct、CosyVoice-ttsfrd
文本前端资源 |
| 推理模式 | SFT 预训练音色、零样本复刻、跨语种复刻、指令控制(Instruct / Instruct2)、语音转换(VC) |
| 部署方式 | Conda 源码环境 + Python SDK;Gradio WebUI;gRPC 服务;FastAPI 服务;vLLM 加速;Triton + TensorRT-LLM 加速 |
| WebUI 端口 | webui.py 源码默认 8000;README
示例命令显式 --port 50000 |
| gRPC / FastAPI 端口 | 服务端默认 50000(--port
可改),客户端默认连接 0.0.0.0:50000 |
| 模型目录 | pretrained_models/<模型名>/(本地路径或
ModelScope 仓库 ID 均可作为 --model_dir) |
| 官方演示站 | funaudiollm.github.io/cosyvoice3、funaudiollm.github.io/cosyvoice2、fun-audio-llm.github.io |
1.2 适用场景
- 多语言 / 方言配音:在中文、英语、日语、韩语、德语、西班牙语、法语、意大利语、俄语之间合成自然语音,并用中文方言口音(粤语、闽南语、四川话、东北话、陕西、山西、上海话、天津话、山东话、宁夏话、甘肃话等)改变朗读风格。
- 零样本声音克隆:仅凭一段参考音频与其对应文本,复刻说话人音色进行新文本合成;可把克隆音色登记为命名 spk 后复用,避免每次重复上传参考音频。
- 产品级可控合成:用自然语言指令指定语言、方言、情绪、语速、音量;用拼音
/ CMU 音素修复多音字、专有名词与外语词的发音;用
[laughter]、[breath]等标记做细粒度韵律控制。 - 实时流式对话:文本边输入、音频边输出的双向流式(Bi-Streaming)模式,官方口径延迟可低至 150ms,适合接入大模型对话链路、智能客服与语音机器人。
- 服务化集成:通过 gRPC 或 FastAPI 把合成能力封装为独立在线服务,被前端、业务后端或流媒体编排系统调用。
- 高性能推理与二次开发:在 vLLM 或 NVIDIA Triton +
TensorRT-LLM 加速方案下提升并发吞吐;
examples/libritts目录提供训练与进阶推理脚本供研究者复现与扩展。
1.3 能力边界(官方口径)
- 语言与方言以 README 清单为准:Fun-CosyVoice 3.0 覆盖 9 种常用语言与 18 种以上中文方言 / 口音;具体可稳定合成的语种、方言与发音词表以对应模型卡与源码 tokenizer 实现为准,不在清单内的语种 / 方言不保证效果。
- 参考音频要求:WebUI 提示参考音频不超过 30 秒、采样率不低于 16kHz;跨语种与零样本模式需要参考音频与其文本一致,官方 WebUI 注明暂不支持自动识别参考文本。
- 日语输入需先转假名:
example.py对日语给出明确说明——使用日语时必须把原文翻译为片假名(katakana)后再送入模型,源码注释给出了平假名 / 汉字转片假名的对照示例。 - 文本归一化可关闭:SDK 推理参数
text_frontend=True时走文本前端做数字、符号与格式归一化;复现在线 Demo 站结果时,example.py注释要求text_frontend=False。不安装ttsfrd包时,前端默认使用 wetext。 - 硬件加速开关依赖
CUDA:
load_jit、load_trt、load_vllm、fp16仅在检测到 CUDA 设备时生效;源码在无 CUDA 环境下会自动把这些开关置为False并输出警告。 - 未公布硬性显存下限:README 与
requirements.txt未逐模型公布最低显存、内存与 CPU 核数指标;本节不补充臆造数值,硬件余量以实际加载日志为准,以官方仓库最新说明为准。 - 学术演示用途声明:README Disclaimer 注明演示内容仅用于学术目的以展示技术能力,部分示例取自互联网;如素材侵权可联系官方移除。
2 功能特性
2.1 多语言与中文方言覆盖
- Fun-CosyVoice 3.0 覆盖中文、英语、日语、韩语、德语、西班牙语、法语、意大利语、俄语 9 种常用语言,并支持 18 种以上中文方言 / 口音;同时支持多语言合成与跨语言零样本声音克隆。
- 跨语种模式在文本前使用语言标签(
<|zh|>、<|en|>、<|ja|>、<|yue|>、<|ko|>等,以源码 tokenizer 实现为准)指定目标语种,用一段参考音色合成另一种语言的语音。
2.2 零样本与跨语言声音克隆
- 零样本复刻(zero_shot):传入目标文本、参考文本与参考音频,即可复刻参考音色;
example.py演示中参考音频为./asset/zero_shot_prompt.wav。 - 命名复用:CosyVoice2 提供
add_zero_shot_spk(prompt_text, prompt_wav, zero_shot_spk_id)把克隆音色登记为命名 spk,之后用zero_shot_spk_id直接调用;save_spkinfo()可把音色信息持久化保存。 - 语音转换(VC):
inference_vc(source_wav, prompt_wav)在两个音频之间转换音色,保留源音频的内容与节奏、采用目标参考音色。
2.3 发音修复与文本归一化
- 发音修复(Pronunciation
Inpainting):支持中文拼音与英语 CMU
音素的发音修复,用于纠正多音字、专有名词、字母词与外语缩写;
example.py的 hotfix 示例用[j][ǐ]形式对"给予"等易读错词做拼音标注。 - 免传统前端的文本归一化:官方口径模型可直接朗读数字、特殊符号与多种文本格式,不依赖传统前端模块;未安装
ttsfrd时默认使用 wetext 完成归一化。
2.4 双向流式合成
- 同时支持文本输入流式(text-in streaming)与音频输出流式(audio-out streaming),官方口径在保持高质量音频的前提下延迟可低至 150ms。
- SDK 的
stream参数控制是否分块流式返回;示例中传入文本生成器(generator)作为输入,便于直接对接文本大模型的流式输出。源码同时备注:上游仍需做基本的句子切分,模型无法处理任意长度的整段文本。
2.5 自然语言指令与细粒度控制
- 指令合成(instruct /
instruct2):用指令文本指定语言、方言、情绪、语速、音量等风格;CosyVoice
1.0 的
inference_instruct与 2.0 / 3.0 的inference_instruct2对应不同接口形态。 - 细粒度标记:支持
[laughter]、[breath]以及<laughter></laughter>、<strong></strong>等标签(受支持标记清单以cosyvoice/tokenizer/tokenizer.py与cosyvoice/utils/common.py源码为准)。 - 语速调节:WebUI 提供速度滑块(非流式推理可用,范围
0.5–2.0,步进0.1);SDK 方法参数speed与之对应。
2.6 SFT 预训练音色与情绪基准模型
CosyVoice-300M-SFT提供内置预训练音色(如"中文女""中文男"),list_available_spks()列出可用音色 ID,直接以spk_id合成。CosyVoice-300M-Instruct面向指令推理;example.py分别演示了 SFT、零样本、跨语种、VC 与指令五种调用方式。
2.7 高性能推理与服务化
- vLLM 引擎:CosyVoice2 / 3 支持 vLLM 0.11.x+(V1 engine)与 vLLM 0.9.0(legacy)两个版本线;低于 0.9.0 的 vLLM 不支持,0.10.x 版本未经测试。
- Triton + TensorRT-LLM:由 NVIDIA 贡献的加速方案用
TensorRT-LLM 加速 LLM 部分、用 Triton Inference Server 编排
audio_tokenizer、speaker_embedding、token2wav、vocoder模块;官方 README 称相比 HuggingFace Transformers 实现可获得约 4 倍加速。 - gRPC / FastAPI 服务:仓库
runtime/python目录提供两套在线服务端与配套客户端,FastAPI 同时开放 GET 与 POST 接口并默认放行跨域(CORS)。
2.8 训练与进阶研究
- 官方在
examples/libritts目录提供训练与推理脚本;Roadmap 记录了 Flow Matching 训练、重复感知采样(RAS)推理、KV Cache 与 SDPA 加速、25Hz 模型发布、GRPO 训练等演进节点,供研究者跟踪模型能力边界。
3 官方界面预览
3.1 本地 Gradio WebUI 控件布局
仓库 webui.py 启动后的本地 Gradio 界面(默认地址
http://127.0.0.1:8000,README 示例改用
--port 50000)包含以下控件,布局以本地启动版本为准:
- 输入合成文本:多行文本框,默认示例为"我是通义实验室语音团队全新推出的生成式语音大模型,提供舒适自然的语音合成能力。"
- 推理模式:单选列表,取值为
预训练音色、3s极速复刻、跨语种复刻、自然语言控制;切换模式时右侧"操作步骤"说明文本随动更新。 - 预训练音色:下拉框,内容来自
list_available_spks();模型未提供 SFT 音色时回退为空选项。 - 是否流式推理:
否 / 是开关。 - 速度调节:数值框,范围
0.5–2.0、步进0.1,仅非流式推理生效,默认1。 - 随机种子:数值框,旁边骰子按钮随机生成种子号。
- 参考音频:支持上传音频文件或麦克风录制;同时提供时优先使用上传文件;要求采样率不低于 16kHz、时长不超过 30 秒。
- 参考文本:与参考音频内容一致的文本框,暂不支持自动识别。
- 指令文本:自然语言控制模式下填写的 instruct 文本。
- 生成音频:点击"生成音频"后输出到播放器,支持自动播放与流式播放;服务端队列
max_size=4、默认并发限制2。
官方在线 Demo 站提供三代模型的浏览器试听与效果对比,地址见第 4 章;本地界面截图未随仓库提供静态 PNG,本章不另行配第三方图片。
4 官方跳转链接汇总
下表列出项目相关的官方入口,均可直接点击访问。
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库主页 | https://github.com/FunAudioLLM/CosyVoice | 源码、example.py、webui.py、runtime
服务与训练脚本 |
| Fun-CosyVoice 3.0 演示站 | funaudiollm.github.io/cosyvoice3 | 最新模型在线试听与效果对比 |
| Fun-CosyVoice 3.0 论文 | arXiv:2505.17589 | CosyVoice 3 技术论文 PDF |
| Fun-CosyVoice3 ModelScope | FunAudioLLM/Fun-CosyVoice3-0.5B-2512 | 模型权重与模型卡(协议以模型卡为准) |
| Fun-CosyVoice3 HuggingFace | FunAudioLLM/Fun-CosyVoice3-0.5B-2512 | 海外模型渠道 |
| CosyVoice 2.0 演示站 | funaudiollm.github.io/cosyvoice2 | 流式模型在线试听 |
| CosyVoice 2.0 论文 | arXiv:2412.10117 | CosyVoice 2 技术论文 PDF |
| CosyVoice2 ModelScope | iic/CosyVoice2-0.5B | 0.5B 流式模型权重与模型卡 |
| CosyVoice2 HuggingFace | FunAudioLLM/CosyVoice2-0.5B | 海外模型渠道 |
| CosyVoice 1.0 演示站 | fun-audio-llm.github.io | 初代模型在线试听 |
| CosyVoice 1.0 论文 | CosyVoice_v1.pdf | 初代技术论文 |
| CosyVoice-300M ModelScope | iic/CosyVoice-300M | 基础零样本模型 |
| CosyVoice-300M-SFT ModelScope | iic/CosyVoice-300M-SFT | 预训练音色 SFT 模型 |
| CosyVoice-300M-Instruct ModelScope | iic/CosyVoice-300M-Instruct | 指令模型 |
| CosyVoice-300M HuggingFace | FunAudioLLM/CosyVoice-300M | 海外基础模型渠道 |
| CV3-Eval 评测集 | github.com/FunAudioLLM/CV3-Eval | Fun-CosyVoice 3.0 评测集 |
| Triton 加速运行时 | runtime/triton_trtllm | Triton + TensorRT-LLM 三方案说明 |
| Issues 反馈 | github.com/FunAudioLLM/CosyVoice/issues | Bug 反馈与功能讨论 |
| 生态:FunASR | github.com/modelscope/FunASR | 工业级语音识别,50+ 语言、说话人分离、流式 |
| 生态:SenseVoice | github.com/FunAudioLLM/SenseVoice | 超快速 ASR + 情感 + 音频事件检测 |
| 生态:FunClip | github.com/modelscope/FunClip | 基于语音识别的 AI 视频剪辑 |
README 还提供官方钉钉交流群二维码(
asset/dingding.png),入口为仓库内图片,未提供公开网页链接;问题反馈优先走 GitHub Issues。
5 前置要求与服务器配置
5.1 软件前提
- Git 与 Git
LFS:克隆仓库含子模块(
third_party/Matcha-TTS),需要git;Dockerfile 内执行git lfs install,模型权重走 ModelScope / HuggingFace SDK 下载。 - Conda:按官方 README 安装 Miniconda(见 docs.conda.io),在独立 conda 环境中创建 `python=3.10`。
- Python 与 PyTorch:
requirements.txt锁定torch==2.3.1、torchaudio==2.3.1,并以--extra-index-url https://download.pytorch.org/whl/cu121索引提供 CUDA 12.1 轮子;其余关键依赖包括transformers==4.51.3、numpy==1.26.4、gradio==5.4.0、fastapi==0.115.6、uvicorn==0.30.0、grpcio==1.57.0、modelscope==1.20.0、wetext==0.0.4、librosa==0.10.2、soundfile==0.12.1、openai-whisper==20231117等。 - sox / 音频工具:README 提示遇到 sox
兼容性问题时,Ubuntu 执行
sudo apt-get install sox libsox-dev,CentOS 执行sudo yum install sox sox-devel;音频读写另由librosa、soundfile、torchaudio承担。 - NVIDIA 运行时(容器加速):Docker 方式运行 gRPC /
FastAPI 或 Triton 方案时需要 NVIDIA Container Toolkit,命令中使用
--runtime=nvidia。 - 可选
ttsfrd资源包:pretrained_models/CosyVoice-ttsfrd解压后可安装ttsfrd轮子以获得更好的文本归一化效果;不安装时默认使用 wetext,不影响核心推理。注意ttsfrd-0.4.2-cp310-cp310-linux_x86_64.whl为 Linux x86_64 + cp310 专用轮子。
5.2 硬件与系统建议
| 项目 | 说明 |
|---|---|
| 操作系统 | Linux 为官方主要测试环境(gRPC / FastAPI 服务、Docker、Triton
方案均面向 Linux);Windows / macOS 可跑源码推理,GPU 加速与部分 CUDA
专用依赖(onnxruntime-gpu、tensorrt-cu12、deepspeed)在源码中按
sys_platform 条件安装 |
| GPU | 官方 Docker 基础镜像为 CUDA 11.7
运行时,requirements.txt 指向 cu121 索引;有 NVIDIA
显卡可显著加速,无 CUDA 时源码自动关闭
load_jit / load_trt / load_vllm / fp16 并回退 CPU |
| 显存 / 内存 | README 未公布逐模型硬性显存下限;0.5B 量级模型需预留模型加载、Flow Matching 中间缓存与并发请求空间,以官方仓库最新说明与实际加载日志为准 |
| 磁盘 | 需容纳三代模型检查点、ttsfrd
资源、参考音频与合成产物;模型大小以 ModelScope / HuggingFace
实际下载为准 |
| 网络 | 安装依赖可走阿里云镜像;模型下载在国内推荐 ModelScope,海外用户使用 HuggingFace;Triton 方案需要拉取 NVIDIA 相关基础镜像 |
说明:本节未补充 README 之外的显存数字与跑分指标;先按第 7 章完成环境,再用示例音频与文本实测资源占用。
5.3 端口分配
| 端口 | 服务 | 默认绑定 | 用途 |
|---|---|---|---|
8000 |
Gradio WebUI | webui.py 源码默认
server_name='0.0.0.0'、server_port=8000 |
浏览器访问本地 Demo;README 示例显式 --port 50000 |
50000 |
gRPC 服务 | 0.0.0.0:50000,--max_conc 4 |
内部 / 服务间 gRPC 调用 |
50000 |
FastAPI 服务 | host="0.0.0.0"、port=50000 |
HTTP 调用 /inference_sft 等端点 |
远程服务器运行 WebUI 或 FastAPI 时,建议通过 SSH 隧道或带认证的反向代理访问,不要把未鉴权的合成界面直接暴露到不可信公网;gRPC 服务仅在可信内网使用。
6 方式一:官方 Docker 镜像与 Triton 加速部署(服务化推荐路径)
容器化现状(如实说明):仓库在
runtime/python目录随附官方Dockerfile,可直接构建 gRPC / FastAPI 服务镜像;runtime/triton_trtllm目录随附官方 Docker Compose 加速方案。本章命令均来自官方 README 与对应目录源码,未自行编造 Compose 文件。
6.1 构建官方运行时镜像
git clone --recursive https://github.com/FunAudioLLM/CosyVoice.git
cd CosyVoice/runtime/python
docker build -t cosyvoice:v1.0 .
runtime/python/Dockerfile
的主要动作(以仓库最新文件为准):
- 基础镜像
pytorch/pytorch:2.0.1-cuda11.7-cudnn8-runtime,设置DEBIAN_FRONTEND=noninteractive; - 更换 Ubuntu 源为阿里云镜像,安装
git、unzip、git-lfs并执行git lfs install; - 递归克隆仓库到
/opt/CosyVoice/CosyVoice; - 在仓库内
pip3 install -r requirements.txt(阿里云镜像、--no-cache-dir);Dockerfile 备注因找不到同时内置 Python 3.8 与 torch 2.0.1-cu118 的镜像,这里使用 Python 3.10; - 在
runtime/python/grpc下用grpcio-tools由cosyvoice.proto生成 Python gRPC 桩代码。
6.2 启动 gRPC 服务容器
docker run -d --runtime=nvidia -p 50000:50000 cosyvoice:v1.0 /bin/bash -c \
  "cd /opt/CosyVoice/CosyVoice/runtime/python/grpc && \
   python3 server.py --port 50000 --max_conc 4 --model_dir iic/CosyVoice-300M && \
sleep infinity"- 想使用指令推理时,把
--model_dir iic/CosyVoice-300M换成iic/CosyVoice-300M-Instruct;也可填本地已下载模型目录路径。 --max_conc对应 gRPC 线程池最大并发与maximum_concurrent_rpcs,默认4。
另开终端进入仓库 runtime/python/grpc
目录,用官方客户端调用:
cd runtime/python/grpc

# SFT 预训练音色
python3 client.py --port 50000 --mode sft \
  --spk_id 中文女 \
  --tts_text "你好,我是通义千问语音合成大模型,请问有什么可以帮您的吗?"

# 零样本复刻
python3 client.py --port 50000 --mode zero_shot \
  --tts_text "收到好友从远方寄来的生日礼物,那份意外的惊喜与深深的祝福让我心中充满了甜蜜的快乐。" \
  --prompt_text "希望你以后能够做的比我还好呦。" \
  --prompt_wav ../../../asset/zero_shot_prompt.wav

# 跨语种复刻
python3 client.py --port 50000 --mode cross_lingual \
  --tts_text "<|en|>And then later on, fully acquiring that company." \
  --prompt_wav ../../../asset/cross_lingual_prompt.wav

# 指令控制
python3 client.py --port 50000 --mode instruct \
  --spk_id 中文男 \
  --tts_text "在面对挑战时,他展现了非凡的勇气与智慧。" \
  --instruct_text "Theo 'Crimson', is a fiery, passionate rebel leader. Fights with fervor for justice, but struggles with impulsiveness."
客户端默认输出 demo.wav(--tts_wav
可改);参考音频采样率 prompt_sr=16000、目标采样率
target_sr=22050。
6.3 启动 FastAPI 服务容器
docker run -d --runtime=nvidia -p 50000:50000 cosyvoice:v1.0 /bin/bash -c \
  "cd /opt/CosyVoice/CosyVoice/runtime/python/fastapi && \
   python3 server.py --port 50000 --model_dir iic/CosyVoice-300M && \
   sleep infinity"
FastAPI 服务同时注册 GET 与 POST 端点(CORS 默认
allow_origins=["*"]、放行全部方法与头):
| 端点 | 表单 / 文件参数 | 对应 SDK 方法 |
|---|---|---|
/inference_sft |
tts_text、spk_id |
inference_sft |
/inference_zero_shot |
tts_text、prompt_text、prompt_wav(文件) |
inference_zero_shot |
/inference_cross_lingual |
tts_text、prompt_wav(文件) |
inference_cross_lingual |
/inference_instruct |
tts_text、spk_id、instruct_text |
inference_instruct |
/inference_instruct2 |
tts_text、instruct_text、prompt_wav(文件) |
inference_instruct2 |
用官方客户端调用:
cd runtime/python/fastapi
python3 client.py --port 50000 --mode sft \
  --spk_id 中文女 \
  --tts_text "你好,我是通义千问语音合成大模型,请问有什么可以帮您的吗?"
客户端把 URL 拼为
http://<host>:<port>/inference_<mode>,--host
默认 0.0.0.0、--port 默认
50000,输出仍为 demo.wav。
6.4 Triton + TensorRT-LLM 高性能方案(可选)
runtime/triton_trtllm/README.md
提供三套加速方案:CosyVoice3 方案、CosyVoice2 + UNet Token2Wav
方案、CosyVoice2 + DiT Token2Wav 方案(DiT 方案来自 Step-Audio2,支持
LLM 与 Token2Wav 拆分到不同 GPU 部署)。每套方案由 Triton 编排
audio_tokenizer、speaker_embedding、token2wav、vocoder
模块,LLM 由 trtllm-serve 提供。
cd runtime/triton_trtllm

# README 主目录旧入口:一键 Compose 启动默认方案
docker compose up -d

# README 最新三方案分别启动(以目录内实际 compose 文件为准):
docker compose -f docker-compose.cosyvoice3.yml up
docker compose -f docker-compose.cosyvoice2.unet.yml up
docker compose -f docker-compose.cosyvoice2.dit.yml up
该方案对 GPU 型号、CUDA 版本与 TensorRT-LLM 兼容性要求较高;模块编排细节、端口与环境变量以
runtime/triton_trtllm各方案 README(README.Cosyvoice3.md、README.Cosyvoice2.Unet.md、README.Cosyvoice2.DiT.md)最新说明为准。
7 方式二:源码 / Conda 环境本地运行
7.1 克隆仓库与子模块
git clone --recursive https://github.com/FunAudioLLM/CosyVoice.git
cd CosyVoice

# 子模块(third_party/Matcha-TTS)因网络失败时,反复执行直到成功
git submodule update --init --recursive
7.2 创建 Conda 环境并安装依赖
conda create -n cosyvoice -y python=3.10
conda activate cosyvoice

pip install -r requirements.txt \
  -i https://mirrors.aliyun.com/pypi/simple/ \
  --trusted-host=mirrors.aliyun.com

# sox 兼容性问题按系统处理:
# Ubuntu
sudo apt-get install sox libsox-dev
# CentOS
# sudo yum install sox sox-devel
7.3 下载预训练模型权重
国内用户使用 ModelScope SDK:
# 在 Python 交互式环境或脚本中执行
from modelscope import snapshot_download

snapshot_download('FunAudioLLM/Fun-CosyVoice3-0.5B-2512', local_dir='pretrained_models/Fun-CosyVoice3-0.5B')
snapshot_download('iic/CosyVoice2-0.5B', local_dir='pretrained_models/CosyVoice2-0.5B')
snapshot_download('iic/CosyVoice-300M', local_dir='pretrained_models/CosyVoice-300M')
snapshot_download('iic/CosyVoice-300M-SFT', local_dir='pretrained_models/CosyVoice-300M-SFT')
snapshot_download('iic/CosyVoice-300M-Instruct', local_dir='pretrained_models/CosyVoice-300M-Instruct')
snapshot_download('iic/CosyVoice-ttsfrd', local_dir='pretrained_models/CosyVoice-ttsfrd')
海外用户改用 HuggingFace SDK:
from huggingface_hub import snapshot_download

snapshot_download('FunAudioLLM/Fun-CosyVoice3-0.5B-2512', local_dir='pretrained_models/Fun-CosyVoice3-0.5B')
snapshot_download('FunAudioLLM/CosyVoice2-0.5B', local_dir='pretrained_models/CosyVoice2-0.5B')
snapshot_download('FunAudioLLM/CosyVoice-300M', local_dir='pretrained_models/CosyVoice-300M')
snapshot_download('FunAudioLLM/CosyVoice-300M-SFT', local_dir='pretrained_models/CosyVoice-300M-SFT')
snapshot_download('FunAudioLLM/CosyVoice-300M-Instruct', local_dir='pretrained_models/CosyVoice-300M-Instruct')
snapshot_download('FunAudioLLM/CosyVoice-ttsfrd', local_dir='pretrained_models/CosyVoice-ttsfrd')
可选安装 ttsfrd 文本前端(不装则默认 wetext):
cd pretrained_models/CosyVoice-ttsfrd/
unzip resource.zip -d .
pip install ttsfrd_dependency-0.1-py3-none-any.whl
pip install ttsfrd-0.4.2-cp310-cp310-linux_x86_64.whl
cd ../../
7.4 运行官方示例
python example.pyexample.py 的 main() 当前默认调用
cosyvoice3_example();切换演示时注释 /
放开对应函数即可。以下为各模型线的核心调用形态(来自
example.py)。
CosyVoice 1.0:SFT 预训练音色
import sys
sys.path.append('third_party/Matcha-TTS')
from cosyvoice.cli.cosyvoice import AutoModel
import torchaudio

cosyvoice = AutoModel(model_dir='pretrained_models/CosyVoice-300M-SFT')
print(cosyvoice.list_available_spks())

# stream=False 关闭分块流式;逐块保存 wav
for i, j in enumerate(cosyvoice.inference_sft(
        '你好,我是通义生成式语音大模型,请问有什么可以帮您的吗?', '中文女', stream=False)):
    torchaudio.save('sft_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)
CosyVoice 1.0:零样本、跨语种与语音转换
cosyvoice = AutoModel(model_dir='pretrained_models/CosyVoice-300M')

# 零样本复刻:目标文本 + 参考文本 + 参考音频
for i, j in enumerate(cosyvoice.inference_zero_shot(
        '收到好友从远方寄来的生日礼物,那份意外的惊喜与深深的祝福让我心中充满了甜蜜的快乐,笑容如花儿般绽放。',
        '希望你以后能够做的比我还好呦。', './asset/zero_shot_prompt.wav')):
    torchaudio.save('zero_shot_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)

# 跨语种复刻:语言标签 <|zh|><|en|><|ja|><|yue|><|ko|>
for i, j in enumerate(cosyvoice.inference_cross_lingual(
        '<|en|>And then later on, fully acquiring that company.',
        './asset/cross_lingual_prompt.wav')):
    torchaudio.save('cross_lingual_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)

# 语音转换:源音频 + 目标参考音色音频
for i, j in enumerate(cosyvoice.inference_vc(
        './asset/cross_lingual_prompt.wav', './asset/zero_shot_prompt.wav')):
    torchaudio.save('vc_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)
CosyVoice 1.0:指令推理
cosyvoice = AutoModel(model_dir='pretrained_models/CosyVoice-300M-Instruct')

# 支持 <laughter></laughter>、<strong></strong>、[laughter]、[breath] 等标记
for i, j in enumerate(cosyvoice.inference_instruct(
        '在面对挑战时,他展现了非凡的<strong>勇气</strong>与<strong>智慧</strong>。', '中文男',
        "Theo 'Crimson', is a fiery, passionate rebel leader. Fights with fervor for justice, "
        "but struggles with impulsiveness.<|endofprompt|>")):
    torchaudio.save('instruct_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)
CosyVoice 2.0:命名克隆音色与细粒度控制
cosyvoice = AutoModel(model_dir='pretrained_models/CosyVoice2-0.5B')

# 零样本复刻;复现在线 Demo 站结果时按需传 text_frontend=False
for i, j in enumerate(cosyvoice.inference_zero_shot(
        '收到好友从远方寄来的生日礼物,那份意外的惊喜与深深的祝福让我心中充满了甜蜜的快乐,笑容如花儿般绽放。',
        '希望你以后能够做的比我还好呦。', './asset/zero_shot_prompt.wav')):
    torchaudio.save('zero_shot_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)

# 把克隆音色登记为命名 spk,后续直接复用
assert cosyvoice.add_zero_shot_spk('希望你以后能够做的比我还好呦。',
                                    './asset/zero_shot_prompt.wav', 'my_zero_shot_spk') is True
for i, j in enumerate(cosyvoice.inference_zero_shot(
        '收到好友从远方寄来的生日礼物。', '', '', zero_shot_spk_id='my_zero_shot_spk')):
    torchaudio.save('zero_shot_spk_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)
cosyvoice.save_spkinfo()

# 细粒度控制:[laughter] 等标记(受支持标记见 tokenizer 源码)
for i, j in enumerate(cosyvoice.inference_cross_lingual(
        '在他讲述那个荒诞故事的过程中,他突然[laughter]停下来,因为他自己也被逗笑了[laughter]。',
        './asset/zero_shot_prompt.wav')):
    torchaudio.save('fine_grained_control_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)

# Instruct2:自然语言指令 + 参考音色
for i, j in enumerate(cosyvoice.inference_instruct2(
        '收到好友从远方寄来的生日礼物,那份意外的惊喜与深深的祝福让我心中充满了甜蜜的快乐。',
        '用四川话说这句话<|endofprompt|>', './asset/zero_shot_prompt.wav')):
    torchaudio.save('instruct_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)
CosyVoice 2.0:双向流式(文本生成器输入)
def text_generator():
    yield '收到好友从远方寄来的生日礼物,'
    yield '那份意外的惊喜与深深的祝福'
    yield '让我心中充满了甜蜜的快乐,'
    yield '笑容如花儿般绽放。'

for i, j in enumerate(cosyvoice.inference_zero_shot(
        text_generator(), '希望你以后能够做的比我还好呦。',
        './asset/zero_shot_prompt.wav', stream=False)):
    torchaudio.save('zero_shot_bistream_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)
Fun-CosyVoice 3.0:指令、呼吸标记、拼音修复与日语假名
cosyvoice = AutoModel(model_dir='pretrained_models/Fun-CosyVoice3-0.5B')

# 零样本复刻(3.0 参考文本前可带 "You are a helpful assistant.<|endofprompt|>" 前缀)
for i, j in enumerate(cosyvoice.inference_zero_shot(
        '八百标兵奔北坡,北坡炮兵并排跑,炮兵怕把标兵碰,标兵怕碰炮兵炮。',
        'You are a helpful assistant.<|endofprompt|>希望你以后能够做的比我还好呦。',
        './asset/zero_shot_prompt.wav', stream=False)):
    torchaudio.save('zero_shot_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)

# 呼吸标记细粒度控制
for i, j in enumerate(cosyvoice.inference_cross_lingual(
        'You are a helpful assistant.<|endofprompt|>[breath]因为他们那一辈人[breath]在乡里面住的要习惯一点,[breath]邻居都很活络,[breath]嗯,都很熟悉。[breath]',
        './asset/zero_shot_prompt.wav', stream=False)):
    torchaudio.save('fine_grained_control_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)

# 方言 / 语速指令
for i, j in enumerate(cosyvoice.inference_instruct2(
        '好少咯,一般系放嗰啲国庆啊,中秋嗰啲可能会咯。',
        'You are a helpful assistant. 请用广东话表达。<|endofprompt|>',
        './asset/zero_shot_prompt.wav', stream=False)):
    torchaudio.save('instruct_cantonese_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)

for i, j in enumerate(cosyvoice.inference_instruct2(
        '收到好友从远方寄来的生日礼物,那份意外的惊喜与深深的祝福让我心中充满了甜蜜的快乐。',
        'You are a helpful assistant. 请用尽可能快地语速说一句话。<|endofprompt|>',
        './asset/zero_shot_prompt.wav', stream=False)):
    torchaudio.save('instruct_speed_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)

# 拼音发音修复:[j][ǐ] 标注"予"的读音
for i, j in enumerate(cosyvoice.inference_zero_shot(
        '高管也通过电话、短信、微信等方式对报道[j][ǐ]予好评。',
        'You are a helpful assistant.<|endofprompt|>希望你以后能够做的比我还好呦。',
        './asset/zero_shot_prompt.wav', stream=False)):
    torchaudio.save('hotfix_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)

# 日语必须先转片假名(示例为平假名 / 汉字 -> 片假名对照)
for i, j in enumerate(cosyvoice.inference_cross_lingual(
        'You are a helpful assistant.<|endofprompt|>レキシ テキ セカイ ニ オイ テ ワ、カコ ワ タンニ スギサッ タ モノ デ ワ ナイ、プラトン ノ イウ ゴトク ヒ ユー ガ ユー デ アル。',
        './asset/zero_shot_prompt.wav', stream=False)):
    torchaudio.save('japanese_{}.wav'.format(i), j['tts_speech'], cosyvoice.sample_rate)
7.5 启动本地 Gradio WebUI
# README 示例:显式指定端口与模型目录
python3 webui.py --port 50000 --model_dir pretrained_models/CosyVoice-300M

# 不传参数时:--port 默认 8000,--model_dir 默认 pretrained_models/CosyVoice2-0.5B
python3 webui.py
浏览器打开 http://127.0.0.1:<port>,按第 3.1
节控件说明选择模式、上传或录制参考音频后生成音频。
7.6 vLLM 加速推理环境(可选)
README 提示 vLLM 对依赖版本有较多特定要求;硬件不支持 vLLM 或旧环境已损坏时,建议克隆新环境而不是原地覆盖:
conda create -n cosyvoice_vllm --clone cosyvoice
conda activate cosyvoice_vllm

# vllm==0.9.0(legacy)
pip install vllm==v0.9.0 transformers==4.51.3 numpy==1.26.4 \
  -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com

# 或 vllm>=0.11.0(V1 engine)
pip install vllm==v0.11.0 transformers==4.57.1 numpy==1.26.4 \
  -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com

python vllm_example.py
vllm_example.py 先用
ModelRegistry.register_model("CosyVoice2ForCausalLM", CosyVoice2ForCausalLM)
注册模型,再以 AutoModel(..., load_vllm=True)
加载;CosyVoice2 示例另带
load_jit=True, load_trt=True, fp16=True,CosyVoice3
示例使用
load_trt=True, load_vllm=True, fp16=False(源码备注 DiT
TensorRT fp16 引擎存在性能问题,需谨慎开启)。
8 配置项说明
8.1
AutoModel 构造参数(来自
cosyvoice/cli/cosyvoice.py)
| 参数 | 默认值 | 说明 |
|---|---|---|
model_dir |
必填 | 本地模型目录路径,或 ModelScope / HuggingFace 仓库
ID;WebUI、gRPC、FastAPI 的 --model_dir 同源 |
load_jit |
False |
加载 TorchScript 编译的 LLM / Flow 编码器 ZIP;无 CUDA 时自动置
False |
load_trt |
False |
加载 TensorRT flow 解码器 plan;无 CUDA 时自动置
False |
load_vllm |
False(2.0 / 3.0 模型) |
以 vLLM 引擎加载 LLM 部分;无 CUDA 时自动置 False |
fp16 |
False |
半精度推理;无 CUDA 时自动置 False;3.0 模型源码备注
DiT TRT fp16 性能问题需谨慎 |
trt_concurrent |
1 |
TensorRT 并发配置 |
8.2 推理方法参数(来自 CLI 源码)
| 方法 | 主要参数 | 说明 |
|---|---|---|
inference_sft |
tts_text, spk_id, stream=False, speed=1.0, text_frontend=True |
内置预训练音色合成 |
inference_zero_shot |
tts_text, prompt_text, prompt_wav, zero_shot_spk_id='', stream=False, speed=1.0, text_frontend=True |
零样本复刻;可复用命名克隆音色 |
inference_cross_lingual |
tts_text, prompt_wav, zero_shot_spk_id='', stream=False, speed=1.0, text_frontend=True |
跨语种 / 方言复刻,文本前可带语言标签 |
inference_instruct |
tts_text, spk_id, instruct_text, stream=False, speed=1.0, text_frontend=True |
1.0 指令推理(绑定 spk_id) |
inference_instruct2 |
tts_text, instruct_text, prompt_wav, zero_shot_spk_id='', stream=False, speed=1.0, text_frontend=True |
2.0 / 3.0 指令推理(基于参考音色) |
inference_vc |
source_wav, prompt_wav, stream=False, speed=1.0 |
语音转换 |
add_zero_shot_spk |
prompt_text, prompt_wav, zero_shot_spk_id |
登记命名克隆音色;zero_shot_spk_id 不能为空 |
save_spkinfo |
— | 持久化已登记音色信息 |
list_available_spks |
— | 返回当前模型可用 SFT 音色 ID 列表 |
通用参数口径:
stream:True分块流式返回,便于边生成边播放;False一次性返回。speed:语速倍率,WebUI 滑块范围0.5–2.0,仅非流式推理生效。text_frontend:是否启用文本前端归一化;复现在线 Demo 站效果时按示例注释设为False。
8.3 webui.py 命令行参数
| 参数 | 默认值 | 说明 |
|---|---|---|
--port |
8000 |
Gradio 监听端口;README 示例传 50000 |
--model_dir |
pretrained_models/CosyVoice2-0.5B |
本地路径或 ModelScope 仓库 ID |
WebUI
队列:demo.queue(max_size=4, default_concurrency_limit=2);demo.launch(server_name='0.0.0.0', server_port=args.port)。
8.4 gRPC / FastAPI 服务端参数
| 服务 | 参数 | 默认值 | 说明 |
|---|---|---|---|
gRPC server.py |
--port |
50000 |
监听端口,绑定 0.0.0.0 |
gRPC server.py |
--max_conc |
4 |
线程池最大并发与 maximum_concurrent_rpcs |
gRPC server.py |
--model_dir |
iic/CosyVoice2-0.5B |
本地路径或 ModelScope 仓库 ID |
FastAPI server.py |
--port |
50000 |
uvicorn 端口,host="0.0.0.0" |
FastAPI server.py |
--model_dir |
iic/CosyVoice2-0.5B |
本地路径或 ModelScope 仓库 ID |
8.5 gRPC / FastAPI 客户端参数
| 参数 | 默认值 | 说明 |
|---|---|---|
--host |
0.0.0.0 |
服务端主机地址 |
--port |
50000 |
服务端端口 |
--mode |
sft |
可选
sft、zero_shot、cross_lingual、instruct |
--tts_text |
内置中文问候示例 | 待合成文本 |
--spk_id |
中文女 |
SFT / instruct 模式音色 ID |
--prompt_text |
"希望你以后能够做的比我还好呦。" | 零样本模式参考文本 |
--prompt_wav |
../../../asset/zero_shot_prompt.wav |
参考音频路径 |
--instruct_text |
英文角色描述示例 | 指令模式 instruct 文本 |
--tts_wav |
demo.wav |
输出音频路径 |
客户端内部采样率常量:prompt_sr=16000、target_sr=22050;FastAPI
客户端把端点拼为 /inference_<mode>,请求方式为
GET + 表单(零样本 / 跨语种 / instruct2 同时上传
prompt_wav 文件)。
8.6 模型目录与权重清单
| 目录 / 仓库 ID | 说明 |
|---|---|
pretrained_models/Fun-CosyVoice3-0.5B |
Fun-CosyVoice3-0.5B-2512 基础模型与 RL 模型 |
pretrained_models/CosyVoice2-0.5B |
CosyVoice2 流式 0.5B 模型 |
pretrained_models/CosyVoice-300M |
1.0 基础零样本模型 |
pretrained_models/CosyVoice-300M-SFT |
1.0 预训练音色模型 |
pretrained_models/CosyVoice-300M-Instruct |
1.0 指令模型 |
pretrained_models/CosyVoice-ttsfrd |
ttsfrd 文本前端资源(含 resource.zip
与两个 wheel) |
8.7 关键依赖版本(来自
requirements.txt)
| 依赖 | 版本 / 说明 |
|---|---|
torch / torchaudio |
2.3.1 / 2.3.1,cu121 索引 |
transformers |
4.51.3(vLLM 0.9.0 线);vLLM 0.11.0 线示例使用
4.57.1 |
numpy |
1.26.4(vLLM 环境同样锁定该版本) |
gradio |
5.4.0 |
fastapi / uvicorn |
0.115.6 / 0.30.0 |
grpcio / grpcio-tools |
1.57.0 / 1.57.0 |
modelscope |
1.20.0 |
wetext |
0.0.4(未装 ttsfrd 时默认文本前端) |
deepspeed |
0.15.1,仅 Linux |
onnxruntime-gpu |
1.18.0,Linux;macOS / Windows 使用
onnxruntime==1.18.0 |
tensorrt-cu12 系列 |
10.13.3.9,仅 Linux |
9 常用运维命令
# ---- Conda 环境 ----
conda activate cosyvoice          # 进入主环境
conda activate cosyvoice_vllm     # 进入 vLLM 环境
conda deactivate                  # 退出当前环境

# ---- 依赖与代码 ----
git pull                          # 更新仓库代码
git submodule update --init --recursive   # 同步子模块
pip install -r requirements.txt \
  -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com

# ---- 模型下载(Python 内执行,见 7.3 节)----
python -c "from modelscope import snapshot_download; \
  snapshot_download('iic/CosyVoice2-0.5B', local_dir='pretrained_models/CosyVoice2-0.5B')"

# ---- 本地推理 ----
python example.py                 # 官方示例
python3 webui.py --port 50000 --model_dir pretrained_models/CosyVoice-300M

# ---- gRPC / FastAPI 本地服务(非容器方式)----
cd runtime/python/grpc && python3 server.py --port 50000 --max_conc 4 --model_dir iic/CosyVoice2-0.5B
cd runtime/python/fastapi && python3 server.py --port 50000 --model_dir iic/CosyVoice2-0.5B

# ---- Docker 容器 ----
docker ps --filter ancestor=cosyvoice:v1.0          # 查看运行中的服务容器
docker stop <container_id>                          # 停止服务
docker logs <container_id>                          # 查看服务日志
docker restart <container_id>                       # 重启服务

# ---- 本地产物与备份 ----
ls *.wav                                            # 查看示例合成音频
ls pretrained_models/                               # 查看已下载模型
更新代码后按 Releases / README
说明核对模型目录是否需要同步升级;备份时保留
pretrained_models/
与自己的参考音频、合成产物;下载的模型权重与参考语音不要提交到公开仓库。容器内服务用
sleep infinity 保持常驻,停止容器即终止进程。
10 常见故障排查
10.1 子模块克隆失败
现象:git clone --recursive 中断,或
third_party/Matcha-TTS 目录为空,导入时报
ModuleNotFoundError: Matcha-TTS。
处理:在仓库根目录反复执行以下命令直到成功:
git submodule update --init --recursive确认 sys.path.append('third_party/Matcha-TTS')(SDK
与各入口脚本均已处理)后再启动推理。
10.2 sox / 音频工具兼容性问题
现象:音频读取或 sox 后端报兼容性错误。
处理:按系统安装 sox 开发库:
# Ubuntu
sudo apt-get install sox libsox-dev
# CentOS
sudo yum install sox sox-devel
合成链路主要由
librosa、soundfile、torchaudio
完成读写,sox 仅在特定后端调用时需要。
10.3 模型下载失败或目录不完整
现象:snapshot_download
中断、pretrained_models/<模型名>/ 缺少
llm、flow、hift
等配置与权重文件,加载时报配置缺失或权重不匹配。
处理:
- 国内网络优先 ModelScope,海外网络改用 HuggingFace;按 7.3 节清单逐个核对模型目录。
- 删除损坏的局部目录后重新执行
snapshot_download,不要用半截缓存继续加载。 --model_dir既支持本地相对路径,也支持直接填 ModelScope 仓库 ID;服务端拉取模型时需要容器内网络可访问对应渠道。
10.4 ttsfrd
轮子安装失败
现象:安装
ttsfrd-0.4.2-cp310-cp310-linux_x86_64.whl 时报平台 / Python
版本不匹配。
处理:该轮子为 Linux x86_64 + CPython 3.10
专用;Windows / macOS 或其他 Python 版本不要强装。跳过
ttsfrd 后系统默认使用 wetext
完成文本归一化,核心合成不受影响。
10.5 CUDA out of memory 或显存不足
处理:
# Linux 下设置 PyTorch CUDA 内存分配切分大小后重试
export PYTORCH_CUDA_ALLOC_CONF=max_split_size_mb:128
python example.py- 降低并发:gRPC 服务端调小
--max_conc;WebUI 队列默认max_size=4, default_concurrency_limit=2,不要在低显存机器上调大。 - 关闭半精度与编译 /
加速开关:
AutoModel(..., fp16=False, load_jit=False, load_trt=False, load_vllm=False)。 - 无 CUDA 环境下源码会自动把这些开关置
False并打印警告,此时为 CPU 推理,速度较慢属预期现象。
10.6 vLLM 版本与依赖冲突
现象:pip install vllm 后
PyTorch、transformers、numpy
版本被覆盖,主环境无法加载模型。
处理:README 明确建议
conda create -n cosyvoice_vllm --clone cosyvoice
后在新环境安装;版本按二选一对照:
vllm==v0.9.0配transformers==4.51.3、numpy==1.26.4(legacy);vllm==v0.11.0配transformers==4.57.1、numpy==1.26.4(V1 engine)。
README 说明:低于 0.9.0 的 vLLM 不支持 CosyVoice 推理,0.10.x
版本未经测试;出现环境损坏时删除 cosyvoice_vllm
环境重新克隆。
10.7 端口被占用
现象:WebUI 或服务启动时报
address already in use。
处理:
# 查看占用进程
ss -lntp | grep -E '8000|50000'
# 改用其他端口启动
python3 webui.py --port 50001 --model_dir pretrained_models/CosyVoice2-0.5B
Docker 发布端口同步调整 -p <新端口>:50000,客户端
--port 指向新端口。
10.8 日语合成乱码 / 发音错误
现象:直接输入日语平假名、汉字文本后发音异常。
处理:按 example.py
注释要求,先把日语翻译为片假名(katakana)再送入
inference_cross_lingual;示例已给出一句日语到片假名序列的完整对照。
10.9 流式输出中断或长文本卡顿
现象:直接把整段长文本作为流式输入时生成卡住或句子被截断。
处理:源码备注上游仍需做基本句子切分;对接文本大模型时按句子 / 子句 yield 文本片段传入生成器,不要一次性喂入超长段落。
10.10 跨域或反向代理访问 FastAPI 失败
现象:浏览器前端直连 FastAPI 被跨域拦截,或经 Nginx 后长连接 / 流式音频中断。
处理:
- FastAPI 源码已默认配置
CORSMiddleware(allow_origins=["*"], allow_credentials=True, allow_methods=["*"], allow_headers=["*"]);生产环境应按实际域名收敛allow_origins,不要长期保留全放行。 - 反向代理需要允许流式响应(关闭缓冲、配置合理超时);gRPC 走 HTTP/2,代理层需显式支持,不要用普通 HTTP 反向代理替代 gRPC 端口。
10.11 中文多音字 / 专有名词读错
处理:用发音修复能力标注读音——中文拼音形式(如
[j][ǐ])或英语 CMU 音素,具体可用标注语法以
cosyvoice/tokenizer/tokenizer.py 与 example.py
hotfix
示例为准;仍不理想时在指令中补充上下文,或切换更匹配的参考音色。
11 风险与合规说明
以下条款整理自官方 README、Apache 2.0 许可证与官方免责口径;如与官方原文不一致,以仓库
LICENSE、README 与各模型卡为准。
11.1 代码许可证范围
- 仓库代码采用 Apache 2.0
许可证发布,允许自由使用、修改与再分发,修改文件需保留版权声明与许可证副本;
runtime/python/Dockerfile、runtime/triton_trtllm等官方脚本同属该许可范围。 - 实现中借用了 FunASR、FunCodec、Matcha-TTS、AcademiCodec、WeNet 等第三方开源项目的大量代码(见 README Acknowledge),集成分发时需同时核对各组件许可证与第三方模型条款。
11.2 模型权重与数据协议
- 各模型权重(
Fun-CosyVoice3-0.5B-2512、CosyVoice2-0.5B、CosyVoice-300M系列、CosyVoice-ttsfrd)的适用条款、商用限制与署名要求,以对应 ModelScope 或 HuggingFace 模型卡为准;代码 Apache 2.0 不代表权重同样允许商用,部署前必须逐模型确认。 ttsfrd文本前端资源包随附其独立许可与使用限制,安装与分发前阅读资源包内声明。
11.3 声音克隆授权与肖像 / 声音权
- 零样本克隆与指令合成基于参考音频复刻音色:只能使用本人声音,或已取得声音权人明确书面授权的参考音频;不得克隆公众人物、陌生人或被授权方未覆盖的音色。
- 合成语音用于配音、数字人、短视频、客服外呼等场景时,应按当地法规在交付物中标注 AI 合成属性;禁止用于冒充他人身份、电信诈骗、虚假宣传、伪造新闻、恶意诋毁或深度伪造欺骗。
- 语音与参考音频属于敏感个人信息,本地保存、上传服务端与日志留存均应限制访问权限,不要把参考音频、合成产物与授权记录提交到公开仓库或不可信服务器。
11.4 平台风控与第三方服务条款
- 项目本身不绑定任何云端模型或付费 API;若将 CosyVoice 合成能力接入第三方平台(智能客服、短视频平台、直播、语音机器人),须同时遵守对应平台的内容规范与风控规则。
- 通过 ModelScope / HuggingFace 下载模型受对应平台服务条款约束;vLLM、TensorRT-LLM、Triton 等加速组件的许可与 NVIDIA 技术条款由各自权利人规定。
11.5 数据隐私与服务化责任
- 本地推理与官方 gRPC / FastAPI 服务默认不上传用户文本与音频;若部署方在服务端增加日志、转录、人工试听或云端转写环节,须自行依法发布隐私政策、取得用户同意并落实数据安全措施。
- FastAPI 默认 CORS 全放行仅适合本地开发联调;对外服务前应收敛域名白名单、增加鉴权与限流,避免合成接口被滥用生成违规语音。
11.6 免责声明
- README Disclaimer 注明:演示内容仅用于学术目的以展示技术能力,部分示例取自互联网;如认为素材侵权,可联系官方仓库移除。
- 本指南依据官方公开文档与源码整理,命令、参数、端口、依赖版本与模型渠道均来自仓库
README、
requirements.txt、example.py、webui.py、runtime 服务端 / 客户端源码、vllm_example.py与runtime/triton_trtllm文档;官方后续版本可能调整依赖版本、模型渠道、接口形态与加速方案,部署时以仓库最新说明为准。 - 项目按现状(AS-IS)提供,不保证合成语音在所有语种 / 方言、参考素材与硬件环境下达到演示效果;使用者自行承担内容合规、声音授权、服务中断与业务损失风险,法律不得排除或限制的责任除外。